

Die meiste KI, die Sie nutzen, lebt auf einem Bildschirm: Sie tippen eine Frage, und ein Sprachmodell schreibt eine Antwort. Physical AI verlässt den Bildschirm. Gemeint ist KI, die die reale Welt über Kameras, Mikrofone oder Elektroden wahrnimmt und in ihr handelt — über Räder, Motoren oder einen Mauszeiger. Ein Robotaxi ohne Fahrer, ein Roboterarm, der Teile greift, die er nie gesehen hat, und ein Implantat, das Hirnsignale in Wörter übersetzt, sind Physical AI.
Dies ist Teil 1 von Level 0 in unserem Lernpfad Physical AI. Sie erfahren, was Physical AI ist, welchen Kreislauf jedes solche System durchläuft, welche Felder dieser Lernpfad abdeckt und warum die physische Welt für KI so viel schwieriger ist als ein Chatfenster. Vorwissen brauchen Sie nicht.
Der Kreislauf: wahrnehmen, entscheiden, handeln
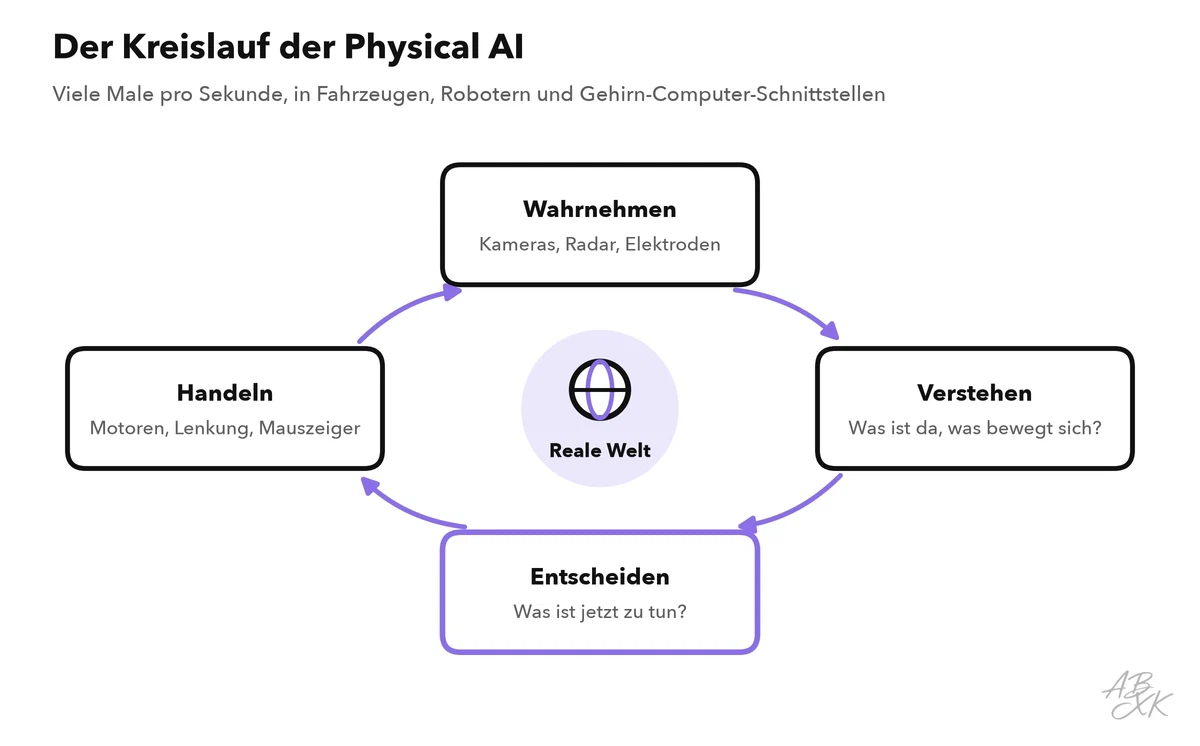
Jedes System der Physical AI durchläuft denselben Kreislauf, viele Male pro Sekunde. Es nimmt die Welt über Sensoren wahr, versteht, was es sieht — etwa „ein Radfahrer, zwei Meter voraus, zieht nach links“ —, entscheidet, was zu tun ist, und handelt über Motoren oder andere Aktoren. Die Handlung verändert die Welt, und der Kreislauf beginnt mit frischen Sensordaten von vorn.
Ein Sprachmodell arbeitet anders: Es bekommt eine Eingabe, schreibt eine Ausgabe und wartet. Ist die Antwort falsch, fragen Sie einfach noch einmal. Ein selbstfahrendes Auto kann die Straße nicht anhalten. Es muss in Sekundenbruchteilen entscheiden und kann eine falsche Entscheidung nicht zurücknehmen.
Die vier Felder dieses Lernpfads
Physical AI umfasst viele Maschinen, vom Saugroboter bis zur Drohne. Dieser Lernpfad folgt vier Feldern, in denen KI schon echte Arbeit leistet, dazu der Infrastruktur dahinter — und zu jedem gibt es öffentliche Daten, die Sie selbst prüfen können.
| Feld | Nimmt wahr | Entscheidet | Handelt | Öffentliche Daten auf ABXK.AI |
|---|---|---|---|---|
| Selbstfahrende Fahrzeuge | Kameras, Radar, Lidar | Wohin und wie schnell | Lenkung, Bremsen, Motor | Unfallmeldungen an die US-Verkehrssicherheitsbehörde |
| Roboter | Kameras, Kraft- und Tastsensoren | Wie greifen, wohin treten | Motoren in Gelenken und Greifern | Bemerkenswerte KI-Modelle für Roboter |
| Gehirn-Computer-Schnittstellen | Elektroden auf oder im Gehirn | Welche Bewegung oder welches Wort gemeint war | Mauszeiger, Roboterarm, synthetische Stimme | Klinische Studien im US-Studienregister |
| Chips und Rechenzentren | — | — | Liefern die Rechenleistung | Chips, Rechenzentren und Stromverbrauch |
Die letzte Zeile ist keine Maschine, die selbst handelt. Sie ist das physische Fundament jeder KI: Jedes Modell, auch das in Robotern und Autos, wird in Rechenzentren voller Chips trainiert, die viel Strom ziehen.
Warum die physische Welt schwerer ist als ein Chat
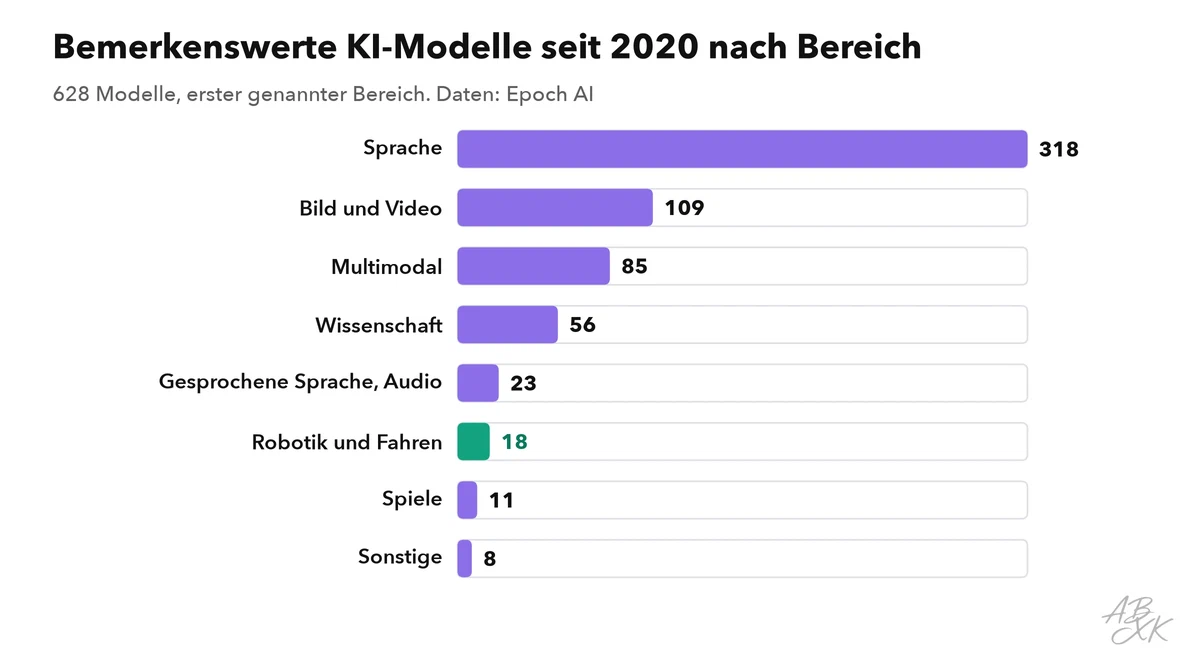
Physical AI ist noch ein kleiner Teil der KI-Forschung. Von den 628 bemerkenswerten KI-Modellen, die das Forschungsinstitut Epoch AI seit 2020 erfasst hat, wurden nur 2,9 % für Roboter oder Fahrzeuge gebaut; die meisten sind Sprach- und Bildmodelle.
Dafür gibt es vier Hauptgründe:
- Fehler kosten mehr. Ein falsches Wort im Chat ist ärgerlich. Eine falsche Lenkentscheidung kann Menschen verletzen. Physical AI muss auch in seltenen Situationen sicher sein, nicht nur in typischen.
- Es gibt wenig Daten. Sprachmodelle lernen aus Texten aus dem Internet. Ein Internet der Roboterbewegungen gibt es nicht: Jedes Beispiel, wie ein Roboter eine Tasse greift, muss mit echter Hardware aufgezeichnet oder in einer Simulation erzeugt werden.
- Die Zeit ist knapp. Ein Auto mit 50 km/h legt fast 14 Meter pro Sekunde zurück. Wahrnehmen, Verstehen und Entscheiden müssen in Sekundenbruchteile passen, auf einem Computer im Fahrzeug.
- Die Welt ist offen. Auf der Straße gibt es unzählige seltene Situationen, sogenannte Edge Cases: eine Matratze auf der Autobahn, ein Polizist, der den Verkehr bei Rot durchwinkt. Kein Modell kann sie alle gesehen haben.
Wie Physical AI lernt
Weil echte Daten knapp sind, kombiniert Physical AI mehrere Lernwege. Ingenieure programmieren Regeln, wo die Aufgabe fest ist, etwa bei einem Schweißroboter am Fließband. Roboter lernen aus Vorführungen, wenn ein Mensch den Roboter führt oder fernsteuert und das Modell die Bewegung nachahmt. Sie üben in der Simulation, Millionen Versuche in einer virtuellen Welt vor dem ersten Versuch in der echten. Seit 2023 kommen Foundation Models für Roboter hinzu: große Modelle, die Bilder, Sprache und Bewegung verbinden, sodass ein Roboter einer Anweisung wie „Stell die rote Tasse in die Spüle“ folgen kann. 19 der 31 bemerkenswerten Robotik-Modelle in den Daten von Epoch AI erschienen 2022 oder später.
| Modell | Organisation | Veröffentlicht | Aufgabe |
|---|---|---|---|
| GEN-1.5 | Generalist | 19.08.2026 | Greifen und Bewegen von Objekten |
| MolmoAct 2 | Allen Institute for AI | 05.04.2026 | Greifen und Bewegen von Objekten |
| π0.6 (pi-0.6) | Physical Intelligence | 17.11.2025 | Greifen und Bewegen von Objekten |
| Eagle 2 | Nvidia | 20.01.2025 | – |
| RDT-1B | Tsinghua University | 10.10.2024 | Greifen und Bewegen von Objekten |
| GR-2 | ByteDance | 08.10.2024 | Video |
| Table Tennis Agent | Google DeepMind | 07.08.2024 | Sport |
| OpenVLA | Stanford University | 13.06.2024 | Greifen und Bewegen von Objekten |
| Octo-Base | University of California (UC) Berkeley | 20.05.2024 | Greifen und Bewegen von Objekten |
| ManiGaussian | Tsinghua University | 13.03.2024 | Greifen und Bewegen von Objekten |
| RT-Trajectory | Google DeepMind | 03.11.2023 | Greifen und Bewegen von Objekten |
| RT-2-X | Google DeepMind | 13.10.2023 | Greifen und Bewegen von Objekten |
| Robot Parkour | Shanghai Qi Zhi institute | 12.09.2023 | Bewegungen nachahmen |
| Swift | Intel Labs | 30.08.2023 | Drohnenflug |
| RT-2 | Google DeepMind | 28.07.2023 | Greifen und Bewegen von Objekten |
| Agile Soccer Robot | Google DeepMind | 26.04.2023 | Bewegungen nachahmen |
| PaLM-E | 06.03.2023 | Fragen zu Bildern | |
| RT-1 | 13.12.2022 | Greifen und Bewegen von Objekten | |
| Gato | DeepMind | 12.05.2022 | Atari-Spiele |
| 6-Act Tether | Facebook AI Research | 03.08.2021 | Objekterkennung |
| SemExp | Carnegie Mellon University (CMU) | 02.07.2020 | Objekterkennung |
| DD-PPO | Georgia Institute of Technology | 19.12.2019 | Objekterkennung |
| Walking Minotaur robot | University of California (UC) Berkeley | 19.06.2019 | Bewegungen nachahmen |
| MetaMimic | 11.10.2018 | Greifen und Bewegen von Objekten | |
| Deep Deterministic Policy Gradients | Google DeepMind | 09.09.2015 | Greifen und Bewegen von Objekten |
| Truck backer-upper | Stanford University | 18.06.1989 | Autonomes Fahren |
| Q-learning | University of London | 01.01.1989 | Wegfindung |
| ASE+ACE | University of Massachusetts Amherst | 01.09.1983 | Stab balancieren |
| Heuristic Reinforcement Learning | Purdue University | 01.10.1965 | Steuerung |
| SNARC | Harvard University | 08.01.1952 | Labyrinth lösen |
| Theseus | Bell Laboratories | 02.07.1950 | Labyrinth lösen |
Daten: Epoch AI, Data on AI models (1078 bemerkenswerte Modelle), abgerufen am 18.10.2026, Lizenz CC BY 4.0; unsere Auswertung.
Worauf Sie bei Nachrichten über Physical AI achten sollten
Physical AI zieht kühne Behauptungen an. Diese Fragen helfen, Vorführungen von echtem Einsatz zu unterscheiden:
- Vorführung oder Dienst? Ein Video eines Roboters, der Wäsche faltet, zeigt einen Erfolg. Fragen Sie, wie oft es klappt und in wie vielen Haushalten er läuft.
- Wer steuert? Viele Roboter und manche Fahrzeuge werden in schwierigen Momenten von Menschen ferngesteuert. Das ist legitim, aber es ändert, was die KI allein kann.
- Wie viel echter Einsatz? Fahrerlos gefahrene Kilometer, Betriebsstunden oder behandelte Patienten sagen mehr als jede Ankündigung.
- Was sagen die öffentlichen Aufzeichnungen? Für selbstfahrende Autos und Hirnimplantate veröffentlichen Behörden Unfallmeldungen und Studieneinträge. Dieser Lernpfad nutzt sie.
Die nächsten Teile von Level 0 nehmen sich jedes Feld einzeln vor, beginnend damit, wie selbstfahrende Autos die Straße sehen. Die Daten hinter diesem Lernpfad finden Sie in der Übersicht zu Physical AI.