

Roboter, die durch Versuch und Irrtum lernen, brauchen viele Versuche, oft Millionen. In der echten Welt würde das Jahre dauern, die Hardware verschleißen und unterwegs einiges zerbrechen. Deshalb findet das meiste Roboterlernen heute in der Simulation statt, wo ein Computer Tausende Übungsversuche pro Minute schafft. Das Problem: Keine Simulation trifft die Wirklichkeit genau. Motoren sind etwas schwächer, Sensoren etwas verrauschter, Signale etwas später. Eine Strategie, die im Simulator perfekt funktioniert, kann am echten Roboter scheitern. Das heißt Sim-to-Real-Lücke.
Dies ist Teil 4 von Level 2 in unserem Lernpfad Physical AI. Wir haben die klassische Balancieraufgabe gebaut, einen Stab auf einem fahrenden Wagen, und zwei Strategien sie mit demselben Verfahren lernen lassen: eine in einer einzigen, festen Simulation, die andere in Simulationen, deren Massen, Längen, Verzögerungen und Sensorrauschen sich von Versuch zu Versuch zufällig änderten. Danach haben wir beide in je 100 verschiedenen „echten“ Welten pro Bedingung getestet. Sie erfahren, was diese Domain Randomization bewirkt und warum sie funktioniert.
Die Aufgabe: einen Stab aufrecht halten
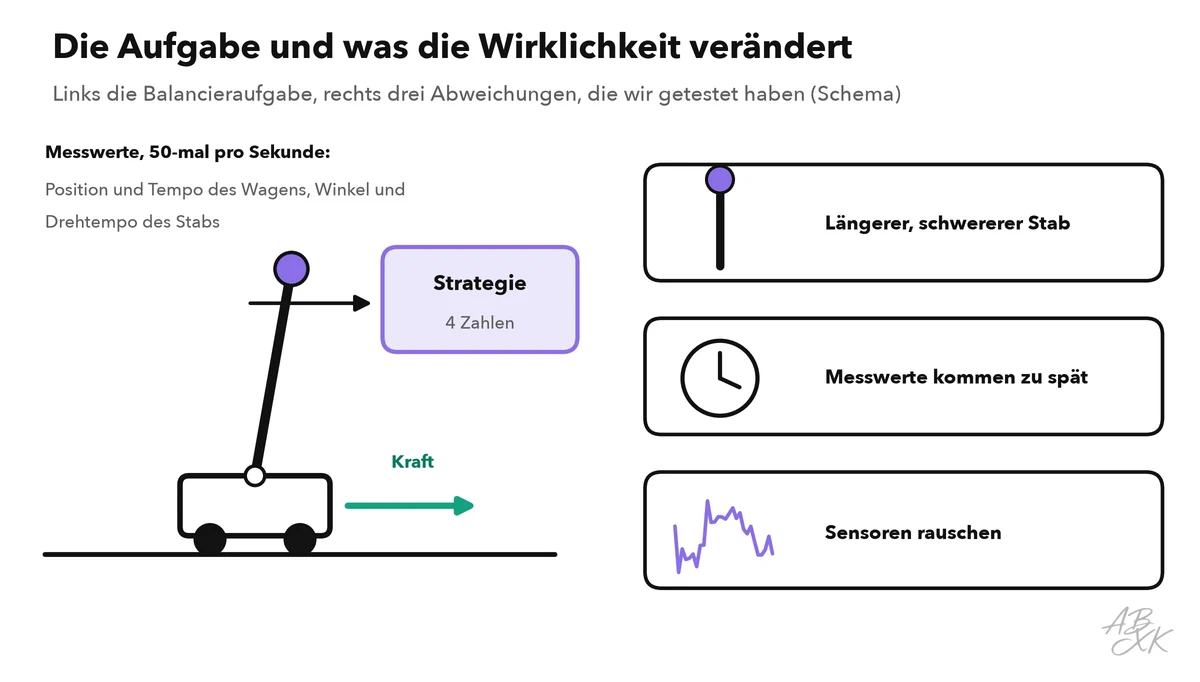
Ein Wagen kann auf einer Schiene nach links und rechts fahren, darauf steht ein Stab, nur von einem Gelenk gehalten. Wie beim Balancieren eines Besens auf der Hand muss der Wagen unter den Stab fahren, sobald dieser zu kippen beginnt. Fünfzigmal pro Sekunde bekommt die Strategie vier Messwerte — Position und Tempo des Wagens, Winkel und Drehtempo des Stabs — und entscheidet, wie stark sie schiebt. Ein Versuch gilt als Erfolg, wenn der Stab zehn Sekunden aufrecht bleibt, ohne dass der Wagen die Schiene verlässt.
| Was sich ändert | Feste Simulation | Zufällige Übungswelten |
|---|---|---|
| Masse des Wagens | Immer 1 kg | 0,5 bis 2 kg |
| Masse des Stabs | Immer 0,1 kg | 0,05 bis 0,4 kg |
| Länge des Stabs | Immer gleich | Von etwas kürzer bis doppelt so lang |
| Verzögerung der Messwerte | Keine | Bis zu 40 Millisekunden |
| Sensorrauschen | Keins | Von keinem bis stark |
Wie die Strategien lernten
Beide Strategien sind einfach: vier Zahlen, die sagen, wie stark auf jeden Messwert zu reagieren ist. Sie lernten mit der Cross-Entropy-Methode: 48 zufällige Strategien ausprobieren, die besten acht behalten, neue ausprobieren, die diesen ähneln, und wiederholen. Nach 25 Runden hielten beide den Stab in ihren eigenen Trainingswelten die vollen zehn Sekunden aufrecht. Im Training waren sie nicht zu unterscheiden.
Der Test in der „echten Welt“
Der Unterschied zeigte sich im Test. Solange die Testwelt der festen Simulation glich, gelangen beiden Strategien alle Versuche. Ein längerer oder schwererer Stab machte kaum Probleme. Doch als die Messwerte 60 Millisekunden zu spät kamen, gelang der Strategie aus der festen Simulation 0 von 100 Versuchen, der Strategie aus den Zufallswelten 100. Bei starkem Sensorrauschen stand es 57 zu 100. In einer zufälligen Mischung aller Abweichungen, die einem echten Roboter am nächsten kommt, gelang der Strategie aus der festen Simulation der Versuch in 51 von 100 Welten, der aus den Zufallswelten in 97.
| Testbedingung | Trainiert in einer festen Simulation | Trainiert mit Zufallsvarianten |
|---|---|---|
| Wie in der Simulation | 100 | 100 |
| Doppelt so langer Stab | 97 | 100 |
| Viermal so schwerer Stab | 100 | 100 |
| Messung 40 ms verzögert | 20 | 100 |
| Messung 60 ms verzögert | 0 | 100 |
| Starkes Messrauschen | 57 | 100 |
| Zufällige Mischung aller Abweichungen | 51 | 97 |
Eigene Simulation: Stab auf einem Wagen (Wagen 1,0 kg, Stab 0,1 kg, halbe Länge 0,5 m, Kraft höchstens 10 N, Schritt 0,02 s). Lineare Strategie, trainiert mit der Cross-Entropy-Methode (25 Runden, je 48 Kandidaten); erfolgreich = 10 s im Gleichgewicht. Zufallsvarianten beim Training: Wagen 0,5–2,0 kg, Stab 0,05–0,4 kg, halbe Länge 0,3–1,0 m, Verzögerung bis 2 Schritte, Messrauschen. Je Testbedingung 100 Versuche, fester Startwert.
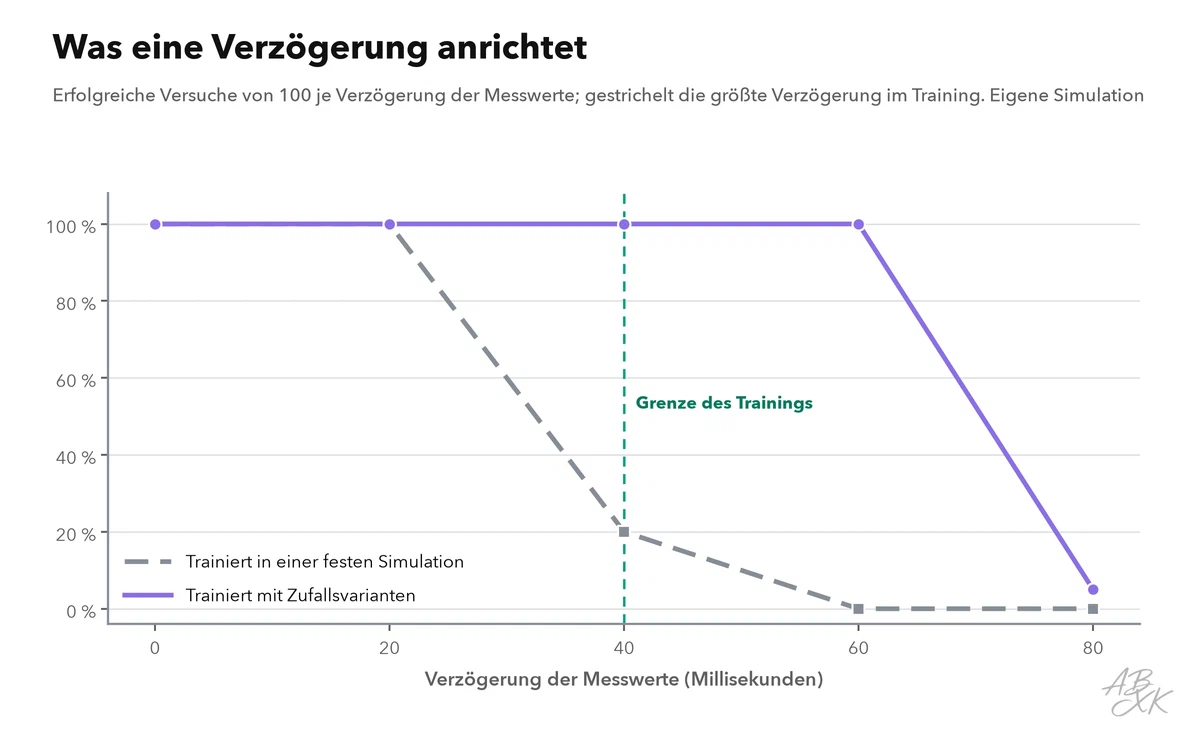
Warum? Die Strategie aus der festen Simulation lernte, sich auf perfekte, sofortige Messwerte zu verlassen, und reagiert scharf. Jede scharfe Reaktion auf einen verspäteten Messwert kommt zu spät, und wie beim Regelkreis aus Level 1 beginnen die Korrekturen zu schwingen. Die Strategie aus den Zufallswelten hatte diesen Luxus nie. Sie lernte, ruhiger zu reagieren — das kostet nichts, wenn die Welt perfekt ist, und rettet sie, wenn sie es nicht ist.
Die Grenzen der Zufallsvarianten
Das Diagramm zeigt auch die Grenze. Bei 80 Millisekunden Verzögerung, doppelt so lang wie alles in den Übungswelten, scheiterte auch die Strategie aus den Zufallswelten. Zufallsvarianten machen eine Strategie robust innerhalb des geübten Bereichs, nicht darüber hinaus. Sie haben auch Kosten: Das Training braucht mehr Versuche, und eine Strategie, die überall funktionieren muss, ist womöglich langsamer oder vorsichtiger als eine, die auf einen einzigen, gut bekannten Roboter abgestimmt ist.
In der Praxis verbinden Roboterbauer deshalb mehrere Werkzeuge:
- Den echten Roboter vermessen, um die Bereiche der Simulation sinnvoll zu setzen, etwa indem man die echten Verzögerungen misst.
- Variieren, worauf es ankommt, etwa Reibung, Massen, Verzögerungen, Licht und Kamerapositionen bei Robotern, die sehen.
- Am echten Roboter nachtrainieren mit wenigen echten Versuchen nach dem Training in der Simulation.
- Von vielen Robotern zugleich lernen — eine Idee hinter den Foundation Models für Roboter, die dieser Lernpfad in Level 0 behandelt.
So haben wir das Experiment durchgeführt
Wir haben die klassischen Gleichungen von Wagen und Stab in Python mit numpy umgesetzt, mit Zeitschritten von 20 Millisekunden und höchstens 10 Newton Kraft. Jede Strategie ist eine lineare Regel mit vier Zahlen. Das Training lief 25 Runden mit je 48 Kandidaten und fünf Versuchen pro Kandidat. Für jede Testbedingung liefen 100 Versuche mit leicht verschiedenen Startlagen und festem Zufallsstartwert. Der nächste Teil kehrt zum Gehirn zurück: Was einen Decoder für Hirnsignale besser oder schlechter macht.