

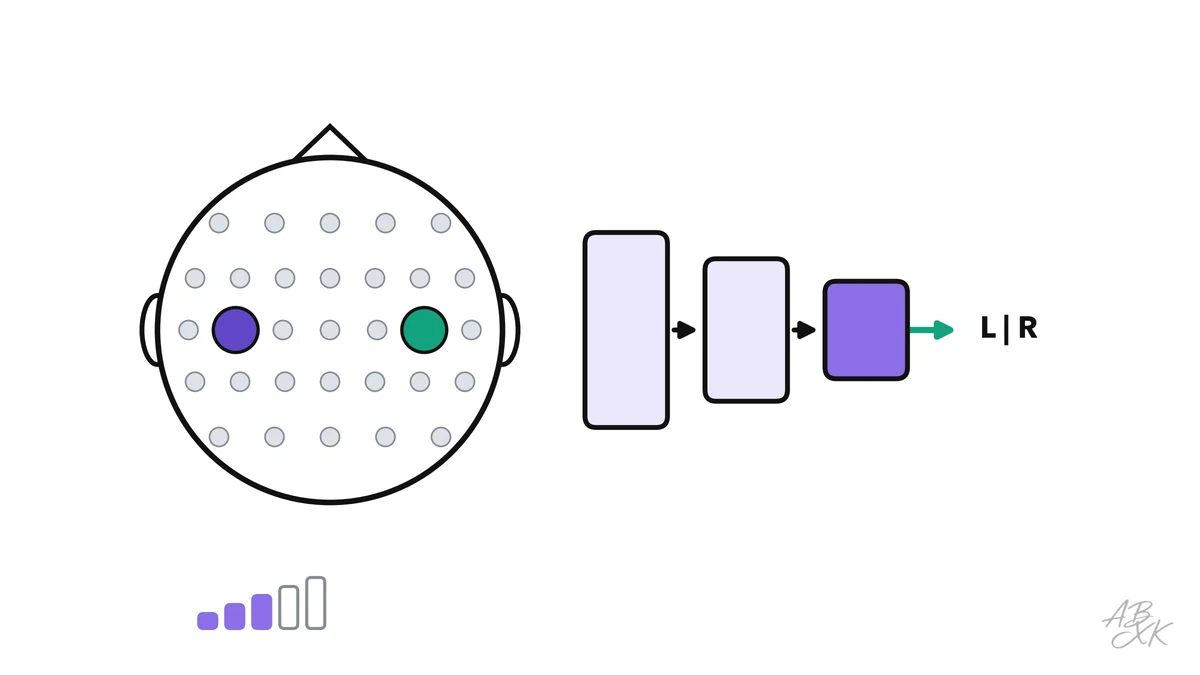
In Level 1 dieses Lernpfads haben wir getestet, ob ein Computer im EEG erkennt, welche Hand sich ein Mensch zu bewegen vorstellt. Die Antwort war ernüchternd: Bei der mittleren Person lag der Decoder in 58,9 % der Fälle richtig, wo Raten 50 % ergibt, und nur 31 von 106 Personen erreichten die 70 %, die die BCI-Forschung oft als Minimum für eine brauchbare Steuerung nennt. Was würde einen solchen Decoder also besser machen?
Dies ist Teil 5 von Level 2 in unserem Lernpfad Physical AI. Wir haben vier weitere Experimente mit denselben öffentlichen Aufnahmen durchgeführt: Wir haben die Zahl der Elektroden, die Menge der Trainingsdaten und deren Herkunft verändert und vorgestellte mit echten Bewegungen verglichen. Sie erfahren, wie ein Decoder aus einfachen Schritten aufgebaut ist, warum mehr Elektroden nicht automatisch helfen und warum ein Decoder, der an Fremden trainiert wurde, einen mit den eigenen Daten der Person schlug.
Wie der Decoder arbeitet
Ein Decoder für Hirnsignale ist eine Kette einfacher Schritte. Jeder Schritt wirft weg, was nicht hilft, und behält, was hilft:
| Schritt | Was er tut | In unserem Decoder |
|---|---|---|
| Filter | Behält die Frequenzen, die zählen | Mu- und Beta-Rhythmus, 8 bis 30 Wellen pro Sekunde |
| Fenster | Schneidet den Moment der Aufgabe aus | 0,5 bis 2,5 Sekunden nach dem Hinweis |
| Räumliche Filter | Verbinden Elektroden zu wenigen starken Signalen | Common Spatial Patterns, vier Signale |
| Merkmale | Machen aus jedem Signal eine Zahl | Die Stärke jedes Signals |
| Klassifikator | Entscheidet links oder rechts | Lineare Diskriminanzanalyse |
| Test | Misst die Trefferquote an ungesehenen Versuchen | Fünffache Kreuzvalidierung |
Mehr Elektroden sind nicht automatisch besser
Wir haben dem Decoder 2, 3, 21 oder alle 64 Elektroden gegeben. Mit nur den beiden Elektroden über den Handbereichen, C3 und C4, erreichte die mittlere Person 57,8 %. Die Elektrode in der Mitte hob das auf 59,9 %, die 21 Elektroden über der Bewegungsrinde erreichten 60 %. Alle 64 Elektroden schnitten dagegen nicht besser ab: 58,9 %.
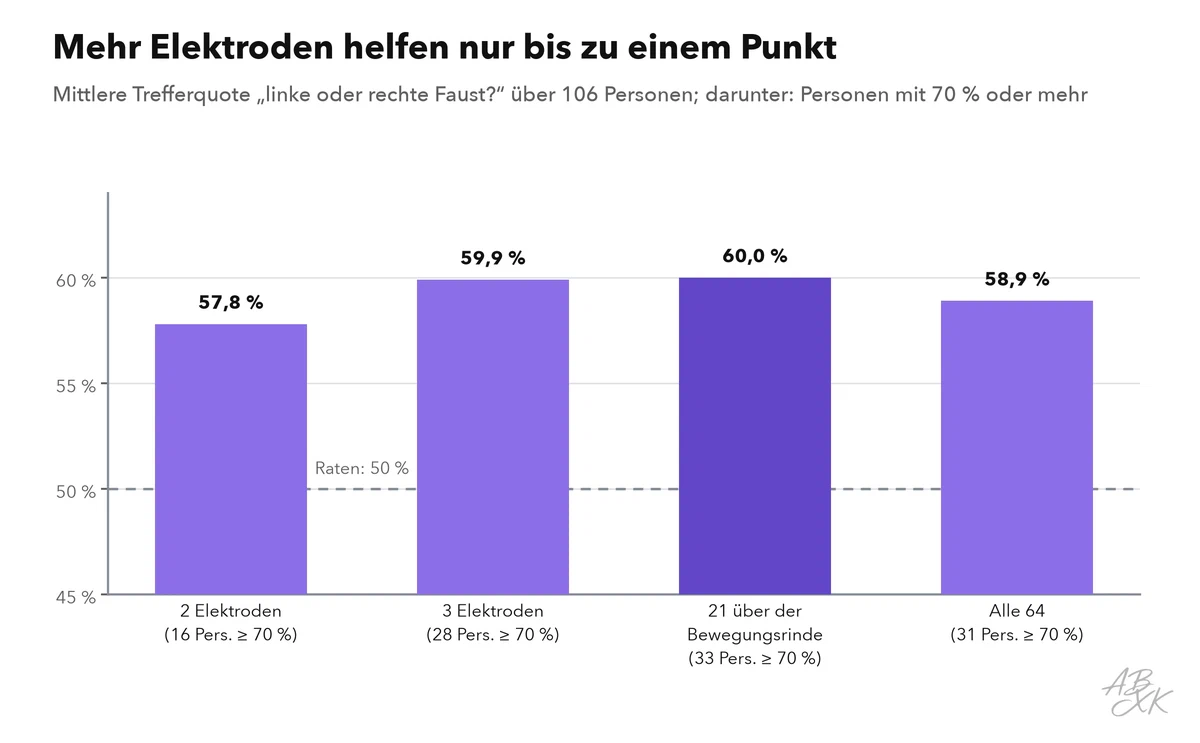
Der Grund ist die kleine Datenmenge. Jede zusätzliche Elektrode bringt Zahlen, die der Decoder aus denselben wenigen Dutzend Versuchen lernen muss — und je mehr Zahlen er aus wenig Daten lernt, desto mehr passt er sich an das Rauschen an statt an das echte Muster. Die Elektroden über der Bewegungsrinde tragen das nützliche Signal, die übrigen bringen vor allem Rauschen.
Trainingsdaten zählen
Wir haben dem Decoder auch weniger eigene Versuche der Person zum Lernen gegeben. Mit nur 10 Versuchen lag die mittlere Trefferquote bei 52,4 %, kaum besser als Raten. Mit 20 Versuchen waren es 53,6 %, mit 30 Versuchen 55,3 %. Jede zusätzliche Minute Kalibrierung hilft, und ein paar Dutzend Versuche reichen für die meisten Menschen klar nicht aus.
Von fremden Gehirnen lernen
Daraus folgt eine naheliegende Frage: Warum nicht von anderen Menschen lernen? Für jede Person haben wir den Decoder an allen Versuchen der anderen 105 Personen trainiert, mehrere Tausend insgesamt, und an der Person getestet, die er nie gesehen hatte. Das Ergebnis hat uns überrascht: Die mittlere Trefferquote lag bei 62,2 %, höher als mit den eigenen Daten der Person. Bei 54 von 106 Personen schnitt der an Fremden trainierte Decoder besser ab als der mit den eigenen Versuchen, und 32 Personen erreichten 70 % oder mehr.
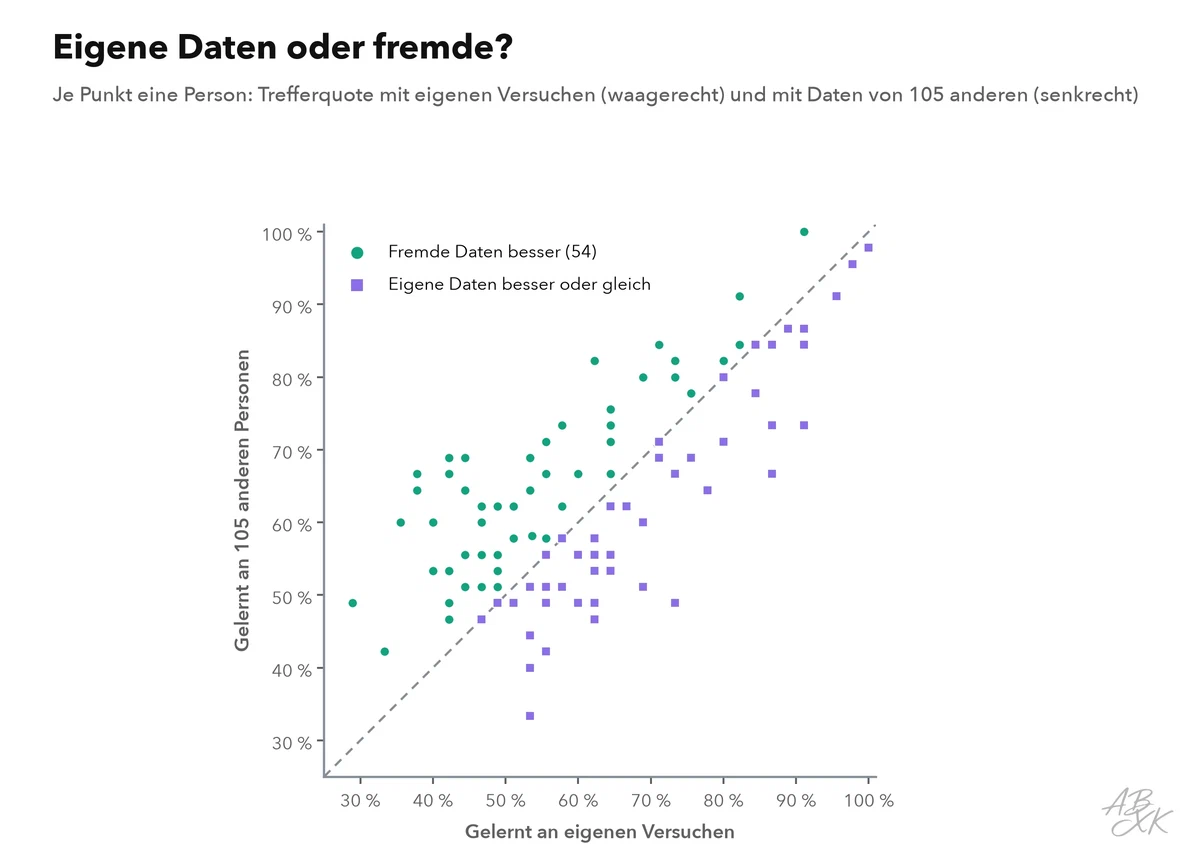
Viele Versuche vieler Menschen ergeben ein stabiles Bild des typischen Musters, das ein paar Dutzend eigene Versuche nicht liefern. Doch Gehirne unterscheiden sich: Für etwa die Hälfte der Menschen waren die eigenen Daten trotzdem besser. Die Forschung verbindet deshalb beides — sie beginnt mit einem Modell, das an vielen Menschen trainiert wurde, und passt es mit wenigen Minuten eigener Daten an den neuen Nutzer an.
Echte Bewegung statt Vorstellung
Die Aufnahmen enthalten auch Läufe, in denen dieselben Menschen ihre Fäuste wirklich öffneten und schlossen. Damit lag die mittlere Trefferquote bei 60 %, nur wenig höher als bei vorgestellten Bewegungen, und 58 von 106 Personen wurden beim echten Bewegen besser erkannt. Für diesen Decoder lagen Vorstellen und Ausführen einer Bewegung überraschend nah beieinander. Das ist eine gute Nachricht für Menschen mit Lähmung, denen nur die Vorstellung bleibt.
| Variante | Richtig erkannt (Median) | Personen mit 70 % oder mehr |
|---|---|---|
| 2 Elektroden (C3, C4) | 57,8 % | 16 |
| 3 Elektroden (C3, Cz, C4) | 59,9 % | 28 |
| 21 Elektroden über der Bewegungsrinde | 60,0 % | 33 |
| Alle 64 Elektroden | 58,9 % | 31 |
| Nur 10 eigene Versuche zum Lernen | 52,4 % | 10 |
| 20 eigene Versuche zum Lernen | 53,6 % | 16 |
| 30 eigene Versuche zum Lernen | 55,3 % | 23 |
| Gelernt an 105 anderen Personen | 62,2 % | 32 |
| Echte Bewegung statt Vorstellung | 60,0 % | 28 |
Eigenes Experiment mit dem EEG Motor Movement/Imagery Dataset (G. Schalk u. a., BCI2000; PhysioNet, Lizenz ODC-By 1.0), abgerufen am 18.10.2026: 106 Probanden; Vorstellung aus den Läufen 4, 8, 12, echte Bewegung aus den Läufen 3, 7, 11. Bandpass 8–30 Hz, Fenster 0,5–2,5 s nach dem Hinweis, Common Spatial Patterns und lineare Diskriminanzanalyse. Je Person fünffache Kreuzvalidierung; Lernmenge: 10 zufällige Aufteilungen; fremde Personen: Training an allen anderen, Test an der ausgelassenen Person. Fester Startwert.
Was das für Gehirn-Computer-Schnittstellen bedeutet
- Die Kalibrierung ist der Engpass. Jeder neue Nutzer braucht Trainingsdaten, und unsere Ergebnisse zeigen, dass ein paar Dutzend Versuche zu wenig sind. Modelle, die an vielen Menschen trainiert wurden, können die Einrichtung verkürzen.
- Der richtige Ort schlägt viele Elektroden. Eine kleine Kappe über der Bewegungsrinde kann so gut sein wie eine volle — und ist schneller angelegt.
- Übung hilft beiden Seiten. Der Decoder lernt vom Nutzer, und mit Rückmeldung lernt der Nutzer, deutlichere Muster zu erzeugen.
- Die Physik bleibt. Keine Datenmenge beseitigt die Unschärfe durch den Schädel — deshalb liegen Implantate bei komplexen Aufgaben weit vorn.
So haben wir das Experiment durchgeführt
Wir haben das EEG Motor Movement/Imagery Dataset aus dem Projekt BCI2000 auf PhysioNet genutzt, dieselben 106 Personen wie in Level 1, mit je drei Läufen vorgestellter und drei Läufen echter Faustbewegungen. Alle Varianten nutzen dieselbe Kette von Schritten; die Elektrodensätze unterscheiden sich nur in den genutzten Kanälen. Für die Menge der Trainingsdaten haben wir je Person und Größe 10 zufällige Aufteilungen gezogen; für fremde Daten haben wir an allen anderen Personen trainiert und an der ausgelassenen getestet. Alle Zufallsentscheidungen nutzen einen festen Startwert.