

Jahrzehntelang waren Roboter schnell und präzise, aber blind für Veränderungen. Ein Schweißroboter am Fließband wiederholt denselben Weg millionenfach; verschiebt man die Karosserie um zwei Zentimeter, schweißt er in die Luft. Roboter, die unter Menschen arbeiten, in Lagern, Küchen oder Krankenhäusern, brauchen etwas anderes: Sie müssen mit Gegenständen zurechtkommen, die sie nie gesehen haben, an Orten, die sich jeden Tag ändern. Hier kommt KI ins Spiel.
Dies ist Teil 3 von Level 0 in unserem Lernpfad Physical AI. Sie erfahren, auf welchen vier Wegen Roboter heute ihre Fähigkeiten bekommen, warum das Üben in der Simulation so wichtig ist, was die neuen Foundation Models für Roboter leisten und wie Sie die Daten zu den bemerkenswerten Robotermodellen der letzten Jahre lesen.
Vier Wege, einem Roboter etwas beizubringen
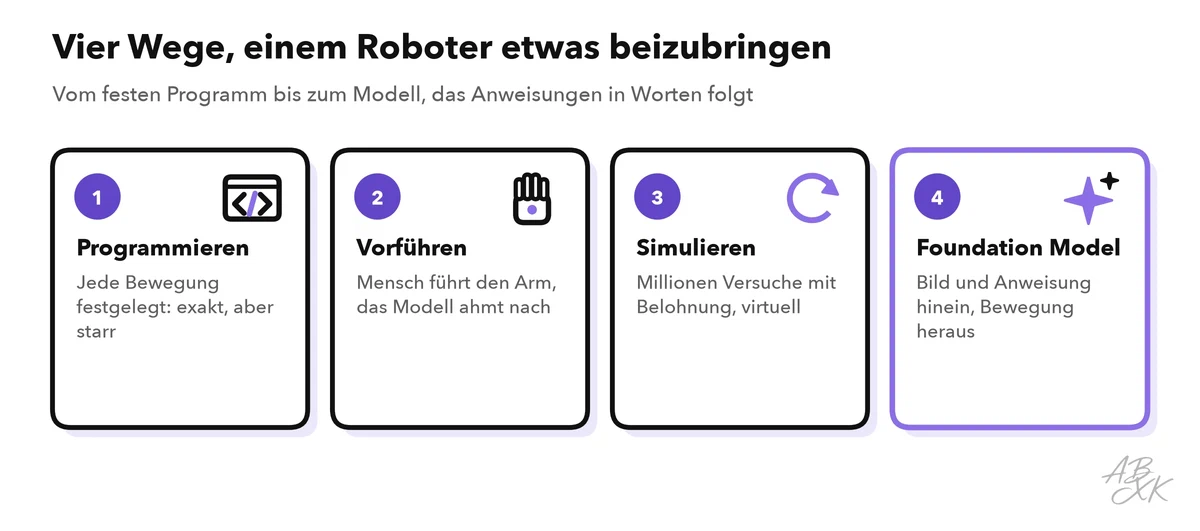
Programmieren ist der klassische Weg. Ein Ingenieur legt jeden Punkt der Bewegung fest, oft mit einem Handbediengerät. Das Ergebnis ist exakt und wiederholbar — und scheitert, sobald etwas nicht dort liegt, wo es sein sollte.
Lernen aus Vorführungen, auch Imitationslernen genannt, zeigt dem Roboter, was er tun soll. Ein Mensch bewegt den Roboterarm von Hand oder steuert ihn fern, der Roboter zeichnet Kamerabilder und Gelenkstellungen auf, und ein Modell lernt, die Bewegung aus den Bildern nachzuahmen. Ein paar Dutzend bis einige Hundert Vorführungen können für eine Aufgabe reichen, etwa um Geschirr in einen Korb zu stellen.
Üben in der Simulation nutzt bestärkendes Lernen (Reinforcement Learning): Der Roboter probiert in einer virtuellen Welt Handlungen aus und bekommt für Erfolg eine Belohnung, zum Beispiel für jeden Schritt, den er geht, ohne zu fallen. Über Millionen Versuche lernt ein Modell eine Strategie, die kein Ingenieur aufgeschrieben hat. Laufroboter mit Beinen lernen ihren Gang auf diese Weise.
Foundation Models für Roboter sind der neueste Weg. Es sind große Modelle, die Bilder, Sprache und Handlungen verbinden. Weil Teile davon mit Bildern und Texten aus dem Internet trainiert wurden, bringen sie Allgemeinwissen mit: Ein Roboter kann der Anweisung „Heb das Spielzeug auf, das ein ausgestorbenes Tier ist“ folgen und den Spielzeug-Dinosaurier greifen, obwohl ihm niemand genau diese Aufgabe vorgeführt hat.
| Weg | Wie die Fähigkeit hineinkommt | Stärke | Grenze |
|---|---|---|---|
| Programmieren | Ingenieur legt jede Bewegung fest | Exakt, schnell, vorhersehbar | Versagt, sobald sich etwas ändert |
| Vorführungen | Roboter ahmt aufgezeichnete menschliche Bewegungen nach | Lernt Aufgaben, die schwer zu beschreiben sind | Braucht viele Vorführungen je Aufgabe |
| Simulation | Roboter übt mit Belohnungen in einer virtuellen Welt | Millionen sichere, günstige Versuche | Die virtuelle Welt gleicht nie genau der echten |
| Foundation Model | Großes Modell verbindet Bilder, Worte und Handlungen | Folgt neuen Anweisungen, hat Allgemeinwissen | Braucht viele Daten und Rechenleistung; noch fehleranfällig |
Warum die Simulation so wichtig ist
Ein echter Roboter kann nur so schnell üben, wie die reale Welt es zulässt, und jeder Sturz kann Hardware zerstören. In einer Simulation üben Tausende virtuelle Roboter parallel, schneller als in Echtzeit. Der Haken ist die Sim-to-Real-Lücke: Reibung, Licht, Gewicht und Sensorrauschen stimmen in einer Simulation nie genau mit der Wirklichkeit überein. Ein verbreiteter Trick ist, diese Eigenschaften beim Üben zufällig zu verändern — hier etwas rutschiger, dort etwas dunkler —, damit das Modell eine Strategie lernt, die unter vielen Bedingungen funktioniert, und die echte Welt nur eine weitere Variante ist.
Foundation Models für Roboter
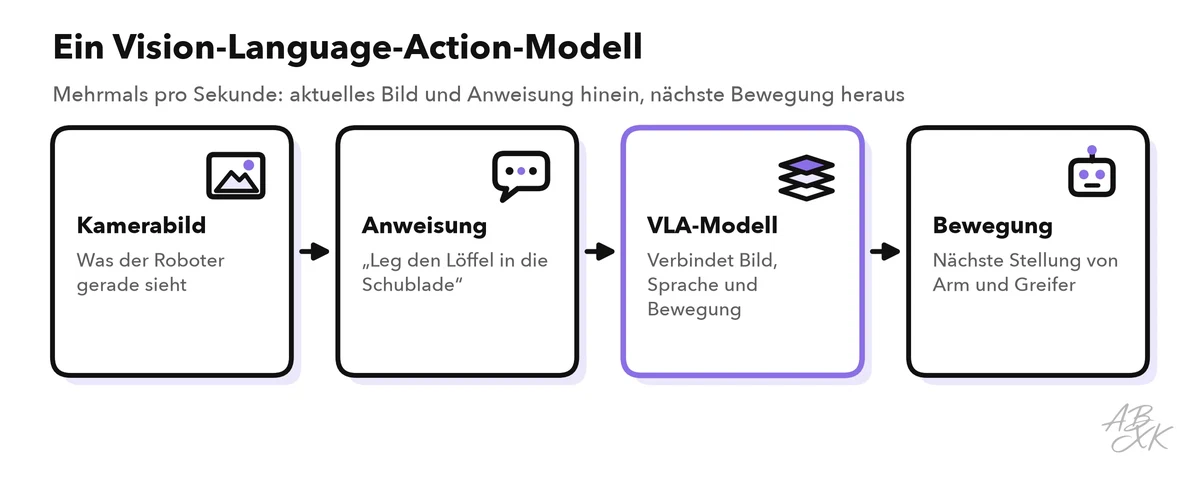
Die wichtigste Veränderung der letzten Jahre ist das Vision-Language-Action-Modell (VLA). Es nimmt ein Kamerabild und eine Anweisung in Worten entgegen und gibt Handlungen aus, etwa die nächsten Stellungen der Armgelenke, mehrmals pro Sekunde.
Epoch AI, ein Forschungsinstitut, das bemerkenswerte KI-Modelle erfasst, führt 31 Modelle für Roboter und Fahrzeuge, seit der ersten Robotermaus, die 1950 ein Labyrinth löste. 19 davon erschienen 2022 oder später, die meisten für die Manipulation, also das Greifen und Bewegen von Gegenständen. Die neuesten in der Tabelle sind Foundation Models dieser Art.
| Modell | Organisation | Veröffentlicht | Aufgabe |
|---|---|---|---|
| GEN-1.5 | Generalist | 19.08.2026 | Greifen und Bewegen von Objekten |
| MolmoAct 2 | Allen Institute for AI | 05.04.2026 | Greifen und Bewegen von Objekten |
| π0.6 (pi-0.6) | Physical Intelligence | 17.11.2025 | Greifen und Bewegen von Objekten |
| Eagle 2 | Nvidia | 20.01.2025 | – |
| RDT-1B | Tsinghua University | 10.10.2024 | Greifen und Bewegen von Objekten |
| GR-2 | ByteDance | 08.10.2024 | Video |
| Table Tennis Agent | Google DeepMind | 07.08.2024 | Sport |
| OpenVLA | Stanford University | 13.06.2024 | Greifen und Bewegen von Objekten |
| Octo-Base | University of California (UC) Berkeley | 20.05.2024 | Greifen und Bewegen von Objekten |
| ManiGaussian | Tsinghua University | 13.03.2024 | Greifen und Bewegen von Objekten |
| RT-Trajectory | Google DeepMind | 03.11.2023 | Greifen und Bewegen von Objekten |
| RT-2-X | Google DeepMind | 13.10.2023 | Greifen und Bewegen von Objekten |
| Robot Parkour | Shanghai Qi Zhi institute | 12.09.2023 | Bewegungen nachahmen |
| Swift | Intel Labs | 30.08.2023 | Drohnenflug |
| RT-2 | Google DeepMind | 28.07.2023 | Greifen und Bewegen von Objekten |
| Agile Soccer Robot | Google DeepMind | 26.04.2023 | Bewegungen nachahmen |
| PaLM-E | 06.03.2023 | Fragen zu Bildern | |
| RT-1 | 13.12.2022 | Greifen und Bewegen von Objekten | |
| Gato | DeepMind | 12.05.2022 | Atari-Spiele |
| 6-Act Tether | Facebook AI Research | 03.08.2021 | Objekterkennung |
| SemExp | Carnegie Mellon University (CMU) | 02.07.2020 | Objekterkennung |
| DD-PPO | Georgia Institute of Technology | 19.12.2019 | Objekterkennung |
| Walking Minotaur robot | University of California (UC) Berkeley | 19.06.2019 | Bewegungen nachahmen |
| MetaMimic | 11.10.2018 | Greifen und Bewegen von Objekten | |
| Deep Deterministic Policy Gradients | Google DeepMind | 09.09.2015 | Greifen und Bewegen von Objekten |
| Truck backer-upper | Stanford University | 18.06.1989 | Autonomes Fahren |
| Q-learning | University of London | 01.01.1989 | Wegfindung |
| ASE+ACE | University of Massachusetts Amherst | 01.09.1983 | Stab balancieren |
| Heuristic Reinforcement Learning | Purdue University | 01.10.1965 | Steuerung |
| SNARC | Harvard University | 08.01.1952 | Labyrinth lösen |
| Theseus | Bell Laboratories | 02.07.1950 | Labyrinth lösen |
Daten: Epoch AI, Data on AI models (1078 bemerkenswerte Modelle), abgerufen am 18.10.2026, Lizenz CC BY 4.0; unsere Auswertung.
Warum so viele neue Roboter wie Menschen aussehen
Viele der Roboter, die in den letzten Jahren vorgestellt wurden, sind Humanoide: zwei Beine, zwei Arme, Hände. Der Grund ist praktisch: Unsere Welt ist für menschliche Körper gebaut, mit Treppen, Türklinken, Regalen auf Armhöhe und Werkzeugen für Hände. Ein Roboter in Menschengestalt kann im Prinzip überall arbeiten, wo ein Mensch arbeitet, und er kann aus Aufzeichnungen von Menschen lernen, die dieselben Aufgaben erledigen. Doch Humanoide sind auch die am schwersten zu bauenden Roboter: Gehen auf zwei Beinen kostet Energie, und eine menschliche Hand hat mehr Bewegungsfreiheit als die meisten Greifer. Die meisten Roboter im echten Einsatz sind deshalb heute keine Humanoiden, sondern Arme auf festen Sockeln und fahrende Maschinen, die Waren durch Lager tragen.
Was Robotern noch schwerfällt
Foundation Models für Roboter stehen dort, wo Sprachmodelle vor ein paar Jahren standen: beeindruckend in Vorführungen, unzuverlässig im Alltag. Aufgaben, die ein Kind ohne Nachdenken erledigt, bleiben schwierig: ein zerknittertes Hemd falten, eine unbekannte Tür öffnen, mit weichen oder durchsichtigen Gegenständen umgehen. Der größte Engpass sind die Daten. Ein Sprachmodell lernt aus Texten eines großen Teils des Internets; Roboterdaten müssen mit echten Robotern aufgezeichnet oder in Simulationen erzeugt werden. Teams auf der ganzen Welt teilen ihre Aufzeichnungen deshalb in offenen Datensätzen, und Unternehmen sammeln Aufzeichnungen von Robotern im Einsatz, um das nächste Modell zu trainieren.
Wenn Sie ein Video eines Roboters bei der Hausarbeit sehen, achten Sie auf drei Dinge: ob es beschleunigt ist, ob ein Mensch den Roboter fernsteuert und wie oft die Aufgabe bei Wiederholung gelingt. Der nächste Teil von Level 0 widmet sich einer ganz anderen Art von Physical AI: Schnittstellen, die das Gehirn direkt mit einem Computer verbinden.