

Jedes Robotergehirn, jedes selbstfahrende Auto und jeder Chatbot läuft auf Chips. Wird ein neuer KI-Chip vorgestellt, macht eine Zahl die Schlagzeilen: wie viele Rechenschritte er pro Sekunde schafft. Doch diese Zahl allein sagt erstaunlich wenig darüber, wie schnell ein Chip KI in der Praxis ausführt. Die eigentliche Grenze liegt oft woanders: wie schnell der Chip Daten aus seinem Speicher holen kann.
Dies ist Teil 5 von Level 1 in unserem Lernpfad Physical AI. Mit Daten von Epoch AI, einem Forschungsinstitut, das KI-Hardware erfasst, vergleichen wir die Spitzen-Chips jedes Jahres seit 2017. Sie erfahren, welche drei Kennzahlen einen KI-Chip beschreiben, warum die Rechenleistung mehr als doppelt so schnell gewachsen ist wie die Speichergeschwindigkeit und was diese Speicherwand für das Tempo von KI-Antworten bedeutet.
Drei Kennzahlen eines KI-Chips
| Kennzahl | Bedeutung | Einheit | Warum sie zählt |
|---|---|---|---|
| Rechenleistung | Rechenschritte pro Sekunde, hier mit 16-Bit-Zahlen | TFLOP/s (Billionen pro Sekunde) | Grenze für große, gleichmäßige Rechnungen wie das Training |
| Speicher | Wie viele Daten direkt neben dem Chip Platz haben | GB | Entscheidet, ob ein Modell auf einen Chip passt oder geteilt werden muss |
| Speicherbandbreite | Wie schnell Daten zwischen Speicher und Chip fließen | TB/s (Terabyte pro Sekunde) | Grenze immer dann, wenn der Chip viele Daten für wenig Rechnung lesen muss |
Heutige KI-Chips sind meist Grafikprozessoren (GPUs) oder reine KI-Chips wie Googles TPUs. Beide enthalten Tausende kleine Recheneinheiten, die parallel arbeiten — passend für die Matrizenrechnung neuronaler Netze. Bei den Chip-Verkäufen, die Epoch AI seit Anfang 2024 erfasst, entfallen 65,1 % der verkauften Rechenleistung auf NVIDIA.
Die Rechenleistung wuchs schneller als die Speichergeschwindigkeit
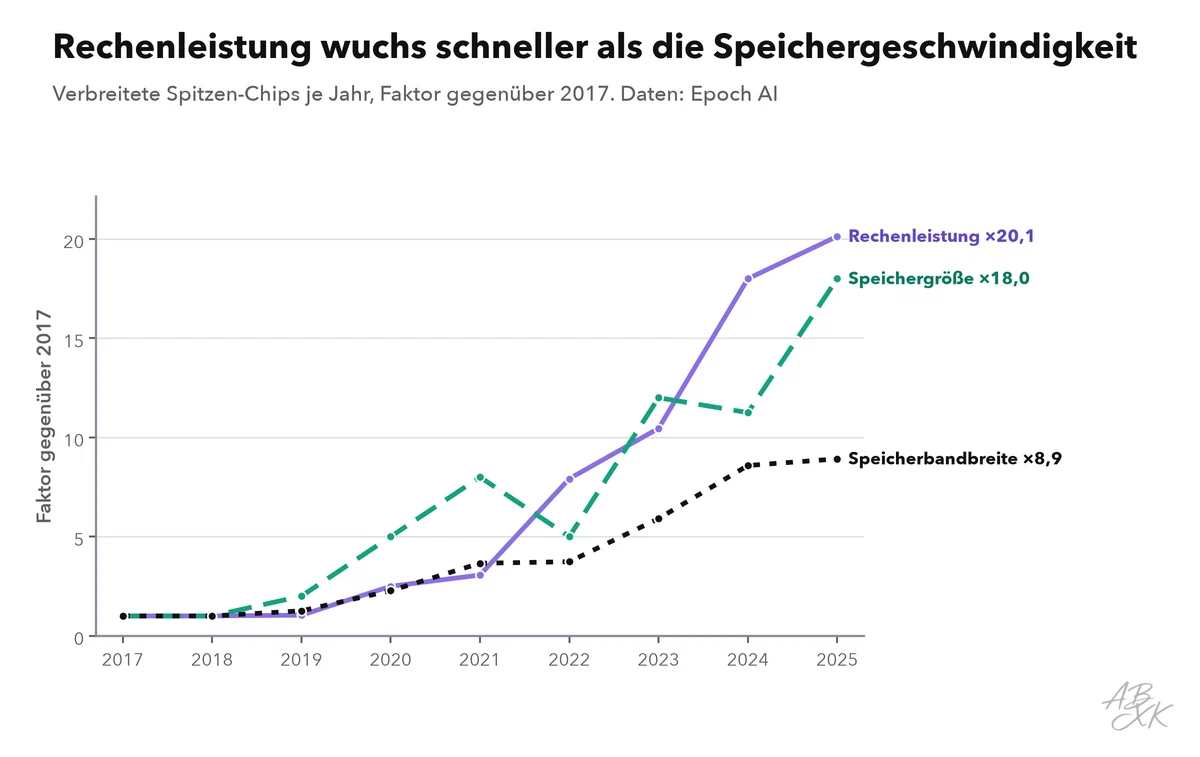
Wir haben für jedes Jahr den leistungsstärksten verbreiteten KI-Chip von NVIDIA, AMD oder Google genommen und mit dem Spitzen-Chip von 2017 verglichen. Die Rechenleistung wuchs auf das 20,1-Fache, die Speichergröße auf das 18-Fache. Die Speicherbandbreite dagegen wuchs nur auf das 8,9-Fache, von 0,9 auf 8 Terabyte pro Sekunde.
| Jahr | Chip | TFLOP/s | Speicherbandbreite (TB/s) | Speicher (GB) | Rechenschritte je gelesenem Byte |
|---|---|---|---|---|---|
| 2017 | NVIDIA V100 SXM2 | 125 | 0,9 | 16 | 139 |
| 2018 | NVIDIA V100 DGXS 16 GB | 125 | 0,9 | 16 | 139 |
| 2019 | NVIDIA V100S PCIe 32 GB | 130 | 1,1 | 32 | 115 |
| 2020 | NVIDIA A100 SXM4 80 GB | 312 | 2,0 | 80 | 153 |
| 2021 | AMD Radeon Instinct MI250X | 383 | 3,3 | 128 | 117 |
| 2022 | NVIDIA H100 SXM5 80GB | 989 | 3,4 | 80 | 295 |
| 2023 | AMD Instinct MI300X | 1.307 | 5,3 | 192 | 247 |
| 2024 | NVIDIA B200 | 2.250 | 7,7 | 180 | 292 |
| 2025 | AMD Instinct MI355X | 2.517 | 8,0 | 288 | 315 |
Daten: Epoch AI, Data on machine learning hardware, abgerufen am 18.10.2026, Lizenz CC BY 4.0. Je Jahr der leistungsstärkste GPU- oder TPU-Chip von NVIDIA, AMD oder Google mit Angaben zu Rechenleistung (16 Bit), Bandbreite und Speicher; Rechenschritte je Byte: unsere Berechnung.
Die letzte Spalte der Tabelle zeigt die Folge. Der Spitzen-Chip von 2017 schaffte 139 Rechenschritte in der Zeit, in der er ein Byte aus dem Speicher las. Der schnellste Chip der Tabelle schafft 315. Ein Programm, das weniger Rechenschritte je Byte ausführt, lässt einen Teil des Chips ungenutzt warten. Fachleute nennen das die Speicherwand (Memory Wall).
Warum ein einzelner Nutzer den Chip kaum auslastet
Schreibt ein Sprachmodell eine Antwort, erzeugt es ein Wortstück (Token) nach dem anderen. Für jedes Token muss der Chip alle Gewichte des Modells einmal aus dem Speicher lesen und rechnet etwa zwei Schritte je Gewicht. Mit 16-Bit-Zahlen belegt jedes Gewicht zwei Byte, der Chip rechnet also etwa einen Schritt je gelesenem Byte. Das liegt weit unter den 315, die der Chip schaffen könnte: Bedient er einen einzelnen Nutzer, nutzt er höchstens 0,3 % seiner Rechenleistung.
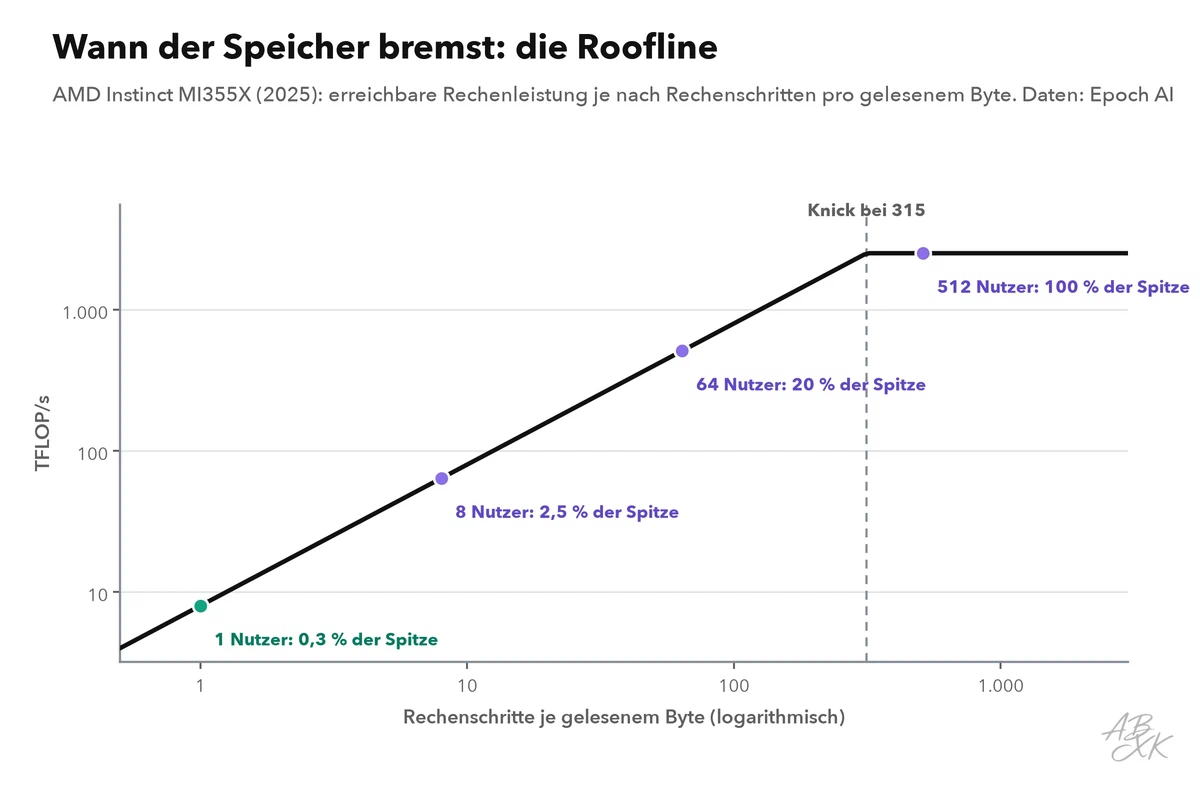
Der Trick besteht darin, viele Nutzer gleichzeitig zu bedienen. Erzeugt ein Chip das nächste Token für 64 Unterhaltungen auf einmal, liest er die Gewichte einmal, nutzt sie aber 64-mal: etwa 64 Rechenschritte je Byte. Das heißt Batching, und es ist der Hauptgrund, warum KI-Anbieter Millionen Nutzer mit einer begrenzten Zahl von Chips bedienen können. Es erklärt auch, warum das Tempo einer einzelnen Antwort so stark von der Speicherbandbreite abhängt und nicht nur von der Rechenleistung.
Ein Rechenbeispiel mit unserer eigenen Annahme: Ein Sprachmodell mit 70 Milliarden Parametern braucht für seine Gewichte in 16-Bit-Form 140 GB. 2017 hätte es mindestens 9 Spitzen-Chips gebraucht, nur um es zu speichern; heute passt es auf 1. Für einen einzelnen Nutzer begrenzt die Speicherbandbreite das Tempo auf höchstens etwa 57 Token pro Sekunde auf dem schnellsten Chip der Tabelle, verglichen mit etwa 6 auf dem Chip von 2017, hätte das Modell darauf gepasst. Echte Systeme erreichen weniger, weil kein Chip seine volle Bandbreite ständig nutzt.
Was Chip-Entwickler dagegen tun
Die Speicherwand prägt fast jedes neue Design:
- Schnellerer Speicher direkt neben dem Chip. High-Bandwidth Memory (HBM) sitzt in Stapeln unmittelbar neben dem Prozessor und gehört zu den teuersten Teilen eines KI-Chips.
- Kleinere Zahlen. Gewichte mit 8 oder 4 Bit statt 16 zu speichern halbiert oder viertelt die Bytes je Gewicht und erhöht so die Rechenschritte je Byte. Der Preis ist ein kleiner Verlust an Genauigkeit, der für jedes Modell geprüft werden muss.
- Mehr Speicher auf dem Chip selbst. Manche Chips, die fürs Antworten statt fürs Training gebaut sind, halten große Teile eines Modells im schnellen Speicher auf dem Chip.
- Arbeit aufteilen. Große Modelle werden über viele Chips mit schnellen Verbindungen verteilt, sodass jeder Chip nur einen Teil der Gewichte liest.
In der Physical AI zeigt sich dieselbe Abwägung im Kleinen. Ein Roboter oder ein Auto muss seine Modelle an Bord ausführen, mit einem Strombudget von einigen Dutzend bis Hunderten Watt statt der Kilowatt eines Server-Racks im Rechenzentrum. Jedes bewegte Byte kostet Zeit und Energie — deshalb sind Modelle für Roboter und Fahrzeuge oft kleiner, nutzen weniger Bits und sind eng auf ihren Chip abgestimmt.
So haben wir die Daten ausgewertet
Die Chip-Daten stammen aus der Datenbank von Epoch AI zu Hardware für maschinelles Lernen. Für jedes Jahr haben wir die leistungsstärkste GPU oder TPU von NVIDIA, AMD oder Google mit Angaben zu 16-Bit-Rechenleistung, Speicher und Bandbreite genommen. Rechenschritte je Byte sind Rechenleistung geteilt durch Bandbreite. Das Rechenbeispiel nutzt unsere eigenen, vereinfachten Annahmen: zwei Rechenschritte je Parameter und Token, 16-Bit-Gewichte und kein weiterer Speicherverkehr. Echte Werte hängen von Software, Modell und tatsächlicher Bandbreite des Chips ab.