

KI-Tools sind aus modernen Arbeitsabläufen kaum noch wegzudenken, doch diese leistungsfähigen Systeme schaffen neue Risiken für personenbezogene Daten. Jedes Mal, wenn Sie mit ChatGPT arbeiten, Dokumente in einen KI-Assistenten hochladen oder automatische Analysewerkzeuge nutzen, geben Sie womöglich sensible Informationen preis, die gespeichert, verarbeitet oder sogar geleakt werden könnten. Wer persönliche Daten beim Einsatz von KI schützen will, braucht technisches Wissen und sorgfältige Arbeitsweisen.
Bei ABXK.AI teilen wir unsere Erfahrungen mit KI und zeigen praktische Wege, sicher zu bleiben. Unsere Arbeit zur KI-Sicherheit dreht sich darum, KI-generierte Inhalte zu verstehen und zu erkennen. In diesem Beitrag geht es darum, wie Sie Ihre persönlichen Daten beim Arbeiten mit KI-Tools schützen.
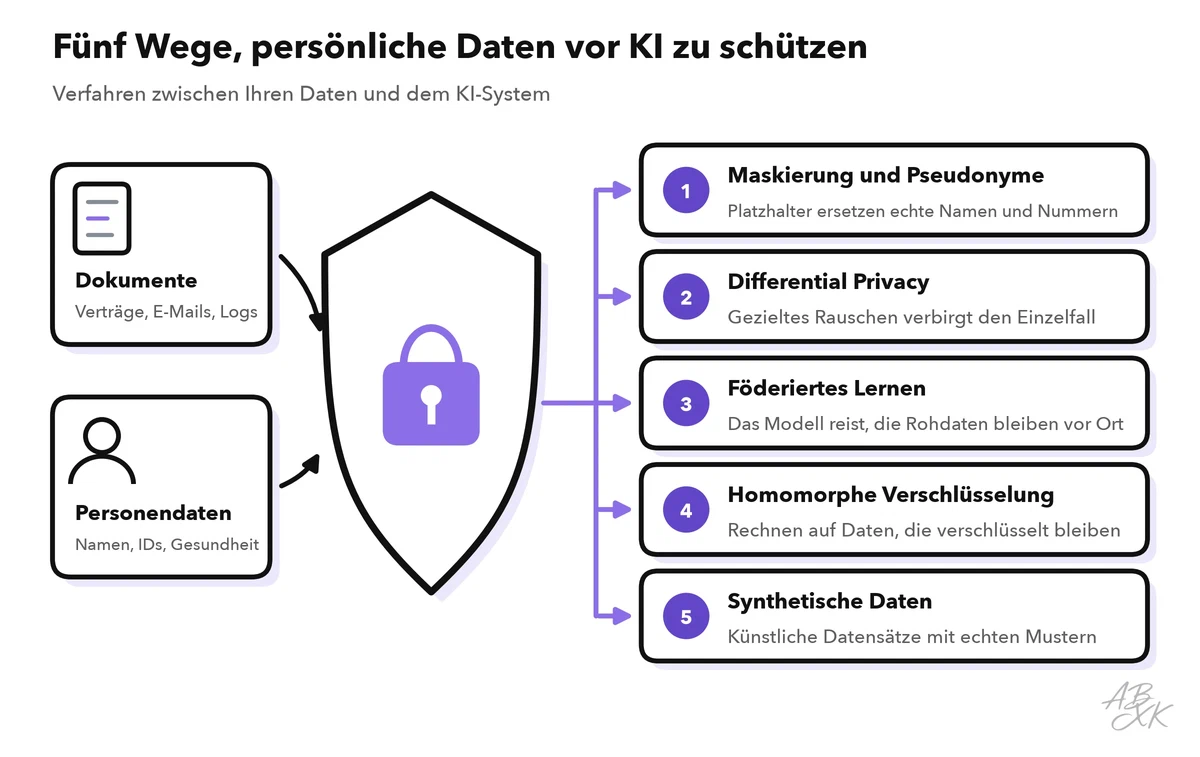
Fünf Verfahren, die zwischen persönlichen Daten und einem KI-System stehen.
Die Datenschutzrisiken verstehen
Was mit Ihren Daten passiert
Bei kommerziellen KI-Diensten werden Ihre Eingaben in der Regel an entfernte Server geschickt. Dort können sie zum Training von Modellen, zur Verbesserung der Systeme oder zur Speicherung in Datenbanken verwendet werden. Viele KI-Anbieter halten in ihren Nutzungsbedingungen fest, dass Gespräche von menschlichen Trainern gesichtet oder für künftige Modelle verwendet werden dürfen. Daraus entstehen mehrere Risiken: Vertrauliche Geschäftsinformationen könnten versehentlich in Modelle einfließen, auf die auch Wettbewerber zugreifen, persönliche Gesundheitsdaten könnten in öffentlichen Datensätzen landen, oder sensibler Quellcode taucht in KI-Vorschlägen für andere Nutzer auf.
Noch komplexer wird es bei großen Sprachmodellen, die sich einzelne Trainingsbeispiele merken können. Gelangen personenbezogene Daten ins Training, kann das Modell genau diese Informationen wiedergeben, wenn andere passende Fragen stellen. Aktuelle Forschung zeigt, dass KI-Systeme personenbezogene Daten über verschiedene Angriffsmethoden preisgeben können, etwa über Membership-Inference-Angriffe, die feststellen, ob bestimmte Daten im Training verwendet wurden.
Leitlinien für den ethischen KI-Einsatz
Klare Richtlinien aufstellen
Organisationen brauchen verbindliche Leitlinien für den KI-Einsatz, bevor Beschäftigte zu experimentieren beginnen. Diese Richtlinien sollten Datenarten klar einteilen: öffentliche Informationen, die unbedenklich geteilt werden dürfen, interne Daten, die eine Freigabe brauchen, und vertrauliche Daten, die nie in externe KI-Systeme gelangen dürfen. Sie sollten konkrete Fragen beantworten: Dürfen Kunden-E-Mails zum Zusammenfassen in ChatGPT eingefügt werden? Ist es zulässig, Finanztabellen in KI-Analysetools hochzuladen? Welche Dokumente müssen vor der KI-Verarbeitung bereinigt werden?
Zwei Grundsätze gehören in jede Richtlinie. Datensparsamkeit: Erheben und verarbeiten Sie nur, was unbedingt nötig ist. Und Privacy by Design: Schutzmaßnahmen werden von Anfang an in Systeme eingebaut statt nachträglich ergänzt.
Gute Richtlinien halten Innovation und Schutz im Gleichgewicht, indem sie Zugriffsstufen festlegen. Berufseinsteiger nutzen KI-Tools vielleicht nur für öffentliche Daten, während Datenschutzbeauftragte bestimmte Anwendungen mit bereinigten internen Daten freigeben. So vermeidet man sowohl übermäßige Einschränkung, die die Produktivität bremst, als auch zu viel Freiheit, die zu Datenpannen führt. Das Ziel ist nicht, jedes Risiko auszuschließen — dann müsste man auf nützliche KI-Tools ganz verzichten —, sondern Risiken durch eine durchdachte Umsetzung auf ein vertretbares Maß zu begrenzen.
Schulung und Bewusstsein
Technische Schutzmaßnahmen versagen, wenn die Nutzer sie nicht verstehen. Regelmäßige Schulungen sollten reale Vorfälle zeigen — etwa, wie sich ein einziges hochgeladenes Dokument mit Kundenadressen über KI-Systeme verbreiten kann. Beschäftigte müssen erkennen, was alles personenbezogene Daten sind: nicht nur offensichtliche Kennungen wie Sozialversicherungsnummern, sondern auch IP-Adressen, Geräte-Fingerprints, Standortdaten und sogar Schreibmuster, über die sich Personen identifizieren lassen.
Vertrauliche Daten nie direkt verwenden
Sensible Informationen erkennen
Personenbezogene Daten sind alle Informationen, die sich auf eine identifizierte oder identifizierbare Person beziehen. Dazu gehören Namen, E-Mail-Adressen, Telefonnummern, Ausweisnummern, biometrische Daten, Gesundheitsdaten, Finanzinformationen und sogar indirekte Merkmale wie eine Berufsbezeichnung in Verbindung mit dem Firmennamen. Genetische Daten, religiöse Überzeugungen, sexuelle Orientierung und politische Meinungen sind nach den meisten Regelwerken besonders geschützt. Solche Daten gehören ohne eindeutige Einwilligung und Sicherheitsvorkehrungen nie in ein KI-System.
Die Schwierigkeit liegt darin, versteckte personenbezogene Daten zu erkennen. Ein harmlos wirkendes Kundenservice-Protokoll kann Bestellnummern enthalten, die zu personenbezogenen Daten führen. Logdateien enthalten mitunter IP-Adressen und Zeitstempel, die Nutzer eindeutig identifizieren. Selbst zusammengeführte Datensätze lassen sich mit fortgeschrittenen Analyseverfahren teils wieder de-anonymisieren.
Zugriffsrechte festlegen
Beschränken Sie, wer KI-Tools nutzen darf, die mehr als rein öffentliche Daten verarbeiten. Setzen Sie auf rollenbasierte Zugriffskontrolle: Data Scientists, die mit Kundendaten arbeiten, erhalten andere KI-Berechtigungen als das Marketing. Richten Sie eine Authentifizierung ein, die protokolliert, wer welche KI-Dienste wann und mit welchen Datenarten nutzt. Dieser Prüfpfad ist entscheidend für Vorgaben wie die DSGVO, nach denen Organisationen einen ordnungsgemäßen Umgang mit Daten nachweisen müssen.
Datenmaskierung und Pseudonymisierung
Was diese Verfahren leisten
Datenmaskierung ersetzt sensible Informationen durch realistische, aber erfundene Werte. Statt „Max Mustermann von der Beispiel GmbH hat Produkt X gekauft“ steht in der maskierten Fassung „Kunde_ID_1847 von Firma_ID_293 hat Produkt X gekauft“. Pseudonymisierung geht weiter und nutzt gleichbleibende Ersatzwerte: Dieselbe Person erhält immer dasselbe Pseudonym, sodass Zusammenhänge in den Daten erhalten bleiben, direkte Kennungen aber verschwinden. Wie ein Team Daten vor jedem Prompt maskiert, zusammen mit DLP und Zugriffsrechten, zeigt unser Lernpfad.
Mit diesen Verfahren lassen sich Struktur und Muster der Daten per KI analysieren, ohne echte Personen offenzulegen. Sie können Stimmungsanalysen mit Kundenfeedback trainieren, Betrugsmuster in Transaktionsdaten erkennen oder die Logistik mit Lieferdaten optimieren — und dabei die Privatsphäre wahren.
Umsetzung
Moderne Werkzeuge zur Datenmaskierung nutzen je nach Datenart unterschiedliche Verfahren. Bei Namen kommt etwa formaterhaltende Verschlüsselung zum Einsatz, die die Struktur (Vorname, Nachname) beibehält, die Werte aber vollständig ändert. Bei numerischen Kennungen wie Kreditkartennummern bleiben die ersten und letzten Ziffern erhalten (sie geben den Kartentyp an und bestehen die Prüfung), während die mittleren Ziffern zufällig ersetzt werden.
Maskierung auf Zeichenebene ersetzt bestimmte Muster per regulärem Ausdruck. So lassen sich E-Mail-Adressen, Telefonnummern oder Ausweisnummern automatisch erkennen und ersetzen, bevor die Daten ein KI-System erreichen. Fortgeschrittene Ansätze nutzen selbst KI: Modelle zur Erkennung benannter Entitäten finden personenbezogene Daten im Text, anschließend setzen Ersetzungsalgorithmen passende Platzhalter ein. Aus „Dr. Sarah Johnson behandelte den Patienten Michael Lee wegen Diabetes“ wird dann „Dr. [NAME_1] behandelte den Patienten [NAME_2] wegen [ERKRANKUNG_1]“.
Für die Pseudonymisierung braucht es sicher verwahrte Zuordnungstabellen, die echte Identitäten mit den Pseudonymen verknüpfen. Diese Tabellen müssen getrennt von den pseudonymisierten Daten, verschlüsselt und nur für Berechtigte zugänglich gespeichert werden. Wer nur den pseudonymisierten Datensatz erbeutet, kann die Pseudonyme ohne Zugriff auf die Zuordnungstabelle nicht auflösen.
Fortgeschrittene datenschutzfreundliche Technologien
Differential Privacy
Differential Privacy bietet eine mathematische Garantie, dass einzelne Datenpunkte in Analyseergebnissen nicht identifiziert werden können. Das Verfahren fügt Abfrageergebnissen oder Modellausgaben gezielt bemessenes Zufallsrauschen hinzu. Fragt man „Wie viele Kunden sind zwischen 30 und 40 Jahre alt?“, liefert das System vielleicht 1.247 statt des wahren Werts 1.250 — dieses Rauschen begrenzt nachweisbar, wie sicher sich feststellen lässt, ob die Daten einer bestimmten Person enthalten sind.
Gesteuert wird das über ein Datenschutzbudget, den Parameter Epsilon. Kleinere Epsilon-Werte bieten stärkeren Schutz, verringern aber die Genauigkeit. Typische Einstellungen liegen zwischen 0,1 und 10 und wägen Schutz gegen Nutzen ab. Der Kern: Selbst wenn Angreifer alle Datensätze bis auf einen genau kennen, können sie nicht verlässlich feststellen, ob dieser letzte Datensatz in die Analyse eingeflossen ist.
Beim Training von KI-Modellen wird Differential Privacy bei der Gradientenberechnung angewandt. Statt exakter Gradienten aus den Trainingsdaten begrenzt das System die Gradientenwerte, um die Empfindlichkeit zu beschränken, und fügt dann je nach Budget Gauß- oder Laplace-Rauschen hinzu. So merkt sich das trainierte Modell keine einzelnen Trainingsbeispiele. Unternehmen wie Apple und Google setzen das Verfahren in großem Maßstab ein, um Nutzungsstatistiken zu erheben und dabei die Privatsphäre zu schützen.
Föderiertes Lernen
Föderiertes Lernen trainiert KI-Modelle, ohne Daten zentral zu sammeln. Statt dass Sie Ihre Daten in die Cloud hochladen, kommt das Modell zu Ihrem Gerät oder Server. Es trainiert lokal mit Ihren Daten und schickt nur die Modell-Updates (die gelernten Parameter) an eine zentrale Koordinationsstelle. Diese führt die Updates vieler Teilnehmer zu einem verbesserten globalen Modell zusammen, das für die nächste Trainingsrunde zurückgeschickt wird.
Diese Architektur löst grundlegende Datenschutzprobleme. Ihre Rohdaten verlassen nie Ihren Einflussbereich. Ein Krankenhaus kann am Training einer KI für medizinische Diagnosen mitwirken, ohne Patientenakten weiterzugeben. Eine Bank kann zu Betrugserkennungsmodellen beitragen, ohne Transaktionsdetails offenzulegen. Mehrere Organisationen mit sensiblen Daten können gemeinsam KI entwickeln und trotzdem vertraulich bleiben.
Grundlage ist meist der FedAvg-Algorithmus. Jeder Teilnehmer lädt das aktuelle globale Modell herunter, trainiert es lokal über mehrere Durchläufe und lädt dann die Parameteränderungen hoch. Der zentrale Server sammelt die Änderungen aller Teilnehmer und bildet einen Mittelwert, gewichtet nach der jeweiligen Datenmenge. Dieses gemittelte Update verbessert das globale Modell und schließt eine Föderationsrunde ab. Anspruchsvolle Setups durchlaufen 50 bis 200 Runden, bis die Ergebnisse gut sind.
Besonders wirksam ist föderiertes Lernen in Kombination mit Differential Privacy. Vor dem Hochladen fügt jeder Teilnehmer seinen Änderungen bemessenes Rauschen hinzu. Das schützt vor Angriffen, bei denen eine unredliche Koordinationsstelle versucht, aus den Modell-Updates Trainingsdaten zu rekonstruieren. Zusammen ergibt sich architektonischer Schutz (Daten werden nie zentral gesammelt) und kryptografischer Schutz (die Updates selbst verraten kaum etwas).
Homomorphe Verschlüsselung
Homomorphe Verschlüsselung erlaubt Berechnungen auf verschlüsselten Daten, ohne sie zu entschlüsseln. Sie verschlüsseln Ihren sensiblen Datensatz und schicken ihn an einen KI-Dienst, der die verschlüsselten Daten verarbeitet und verschlüsselte Ergebnisse zurückgibt — ohne die eigentlichen Informationen je zu sehen. Entschlüsseln Sie die Ergebnisse lokal, sind sie identisch mit dem, was auf unverschlüsselten Daten herausgekommen wäre.
Möglich machen das besondere mathematische Eigenschaften. Herkömmliche Verschlüsselung verwürfelt Daten so gründlich, dass jede Berechnung Unsinn ergibt. Homomorphe Verfahren sind so aufgebaut, dass Rechenoperationen auf dem Geheimtext Operationen auf dem Klartext entsprechen. Multipliziert man zwei verschlüsselte Zahlen, erhält man ein verschlüsseltes Ergebnis, das entschlüsselt dem Produkt der Ausgangszahlen entspricht.
Es gibt zwei Arten: Teilweise homomorphe Verschlüsselung unterstützt nur bestimmte Operationen (Addition oder Multiplikation, aber nicht beides), vollständig homomorphe Verschlüsselung beliebige Berechnungen. Moderne KI-Anwendungen setzen vor allem auf die vollständig homomorphe Variante, trotz ihres hohen Rechenaufwands — Operationen auf verschlüsselten Daten laufen noch immer um ein Vielfaches langsamer als auf Klartext, oft um mehrere Größenordnungen. Für kleine, sensible Aufgaben wie verschlüsselte medizinische Diagnosen oder vertrauliche Finanzanalysen ist das praktikabel, für das Training großer neuronaler Netze bleibt es schwierig.
Synthetische Daten
Bei synthetischen Daten entstehen künstliche Datensätze, die die statistischen Eigenschaften echter Daten bewahren. KI-Modelle lernen Muster, Verteilungen und Zusammenhänge in den echten Daten und erzeugen daraus neue Datensätze, die realistisch wirken. Die Einträge sind neu — gelernt hat das Modell sie aber von echten Menschen.
Meist kommen dafür Generative Adversarial Networks oder Variational Autoencoder zum Einsatz. Diese Modelle lernen mit echten Daten deren Struktur: wie das Alter mit dem Einkommen zusammenhängt, wie sich Kaufmuster bündeln, welche Textmuster in Kundenfeedback auftauchen. Danach erzeugt der Generator neue synthetische Datensätze aus den gelernten Verteilungen. Eine synthetische Kundendatenbank kann 100.000 Einträge enthalten, die dieselben demografischen Verteilungen, Kaufgewohnheiten und saisonalen Muster zeigen wie echte Kunden, ohne dass ein Eintrag einen echten Kunden kopieren soll.
Für Entwicklungs- und Testumgebungen eignet sich das gut. Entwickler können KI-Anwendungen mit synthetischen Daten bauen, die der Produktion entsprechen, ohne echte Kundendaten anzufassen.
Synthetische Daten weiterzugeben ist weniger sicher, als es aussieht. Der Generator lernt aus echten Datensätzen und kann sie nachbilden, vor allem ungewöhnliche — etwa einen Kunden mit einer seltenen Kombination aus Alter, Wohnort und Produkt. Eine Studie von 2022 fand, dass synthetische Daten kein besseres Verhältnis von Datenschutz und Nutzen bieten als klassische Anonymisierung und dass ihr Datenschutzgewinn schwer vorherzusagen ist (Quelle: Stadler, Oprisanu und Troncoso, „Synthetic Data — Anonymisation Groundhog Day“, USENIX Security 2022). Wer eine echte Datenschutzgarantie braucht, trainiert den Generator mit Differential Privacy und prüft die Ausgabe vor der Weitergabe auf kopierte Datensätze. Außerdem können synthetische Daten seltene Sonderfälle verfehlen und Verzerrungen aus dem Ausgangsdatensatz übernehmen.
Welche Technik für welche Aufgabe
| Technik | Was sie schützt | Was riskant bleibt | Aufwand | Typischer Einsatz |
|---|---|---|---|---|
| Datenmaskierung und Pseudonymisierung | Namen, E-Mail-Adressen und Kennungen in Prompts und Dateien | Der Kontext kann eine Person verraten; pseudonymisierte Daten bleiben personenbezogen | Gering | Prompts, Support-Tickets, Testdaten |
| Differential Privacy | Einzelne Personen in Statistiken und trainierten Modellen | Ergebnisse werden ungenauer, je kleiner das Datenschutzbudget | Mittel | Nutzungsstatistik, Modelltraining |
| Föderiertes Lernen | Rohdaten bleiben auf dem Gerät oder am Standort | Modell-Updates können ohne zugesetztes Rauschen Details verraten | Hoch | Smartphone-Tastaturen, gemeinsames Training von Kliniken |
| Homomorphe Verschlüsselung | Daten bleiben auch bei der Verarbeitung verschlüsselt | Sehr langsam, daher nur kleine Aufgaben | Sehr hoch | Einzelne sensible Berechnungen |
| Synthetische Daten | Kein echter Datensatz wird direkt weitergegeben | Ungewöhnliche Datensätze können nachgebildet werden; Datenschutzgewinn schwer vorherzusagen | Mittel | Tests, Entwicklung, Vorführungen |
Keine Technik reicht allein. In der Praxis ist Maskierung der erste Schritt für den alltäglichen KI-Einsatz, die übrigen sind etwas für Teams, die Modelle trainieren oder Daten teilen.
DSGVO-Konformität beim Einsatz von KI-Tools
Die Datenschutz-Grundverordnung (DSGVO) gilt, sobald personenbezogene Daten in ein KI-Tool gelangen — ob Sie sie in ein LLM tippen oder über eine API senden. Für die DSGVO-Konformität mit KI-Tools zählen vor allem diese Regeln (Quelle: Verordnung (EU) 2016/679, eur-lex.europa.eu):
| DSGVO-Regel | Was sie für KI-Tools bedeutet |
|---|---|
| Rechtsgrundlage (Art. 6) | Bevor personenbezogene Daten in ein KI-Tool gehen, brauchen Sie eine Rechtsgrundlage, etwa einen Vertrag, eine Einwilligung oder ein abgewogenes und dokumentiertes berechtigtes Interesse. |
| Datenminimierung (Art. 5 Abs. 1 lit. c) | Senden Sie nur die Felder, die die Aufgabe braucht; den Rest vor dem Prompt maskieren oder entfernen. |
| Auftragsverarbeitung (Art. 28) | Ein externer KI-Dienst, der personenbezogene Daten in Ihrem Auftrag verarbeitet, braucht einen Auftragsverarbeitungsvertrag. |
| Folgenabschätzung (Art. 35) | KI-Verarbeitung mit voraussichtlich hohem Risiko für Menschen, etwa Profiling oder viele sensible Daten, braucht vorher eine Datenschutz-Folgenabschätzung. |
| Übermittlung außerhalb der EU (Kapitel V) | Ein Anbieter, der Daten außerhalb von EU oder EWR verarbeitet, braucht eine Grundlage für die Übermittlung, etwa einen Angemessenheitsbeschluss oder Standardvertragsklauseln. |
| Rechte der Betroffenen (Art. 15–17) | Menschen können erfragen, was Sie über sie speichern, und es berichtigen oder löschen lassen — auch Kopien in KI-Protokollen und Vektordatenbanken. |
| Automatisierte Entscheidungen (Art. 22) | Entscheidungen mit rechtlicher oder ähnlich erheblicher Wirkung dürfen nicht allein auf automatisierter Verarbeitung beruhen, von engen Ausnahmen abgesehen. |
Ein Punkt wird oft missverstanden: Pseudonymisierte Daten bleiben nach der DSGVO personenbezogen (Art. 4 Nr. 5 und Erwägungsgrund 26). Anonym und damit außerhalb der Verordnung sind nur Daten, die sich mit allen Mitteln, die vernünftigerweise eingesetzt würden, keiner Person mehr zuordnen lassen. Maskierung senkt das Risiko eines KI-Prompts, beendet aber Ihre Pflichten nicht.
Häufige kritische Fehler
API-Schlüssel und Zugangsdaten offenlegen
Zu den häufigsten und gefährlichsten Fehlern gehört es, API-Schlüssel, Passwörter oder Zugriffstoken versehentlich in öffentliche Repositories hochzuladen. Entwickler schreiben Zugangsdaten beim Testen oft direkt in den Quellcode und pushen ihn dann zu GitHub oder GitLab, ohne zu merken, dass die Geheimnisse mitgehen. Automatische Scanner durchsuchen öffentliche Repositories ständig nach offengelegten Zugangsdaten — kompromittierte Schlüssel werden oft innerhalb von Minuten missbraucht.
Dagegen helfen mehrere Schutzschichten. Schreiben Sie Zugangsdaten nie direkt in den Quellcode, sondern nutzen Sie Umgebungsvariablen oder ein eigenes Secret-Management. Legen Sie vor dem ersten Commit eine .gitignore-Datei an, die Konfigurationsdateien mit Geheimnissen ausschließt. Setzen Sie Pre-Commit-Hooks ein, die nach Mustern von Zugangsdaten suchen und solche Commits blockieren. Nutzen Sie Secret-Scanning-Tools wie GitGuardian oder das in GitHub eingebaute Secret Scanning, die Sie bei versehentlichen Veröffentlichungen warnen.
Ist es passiert, gehen Sie sofort von einer Kompromittierung aus. Tauschen Sie alle offengelegten Zugangsdaten innerhalb von Minuten aus, nicht erst nach Stunden. Prüfen Sie die Zugriffsprotokolle auf unbefugte Nutzung. Viele Datenpannen entstehen, weil Entwickler offengelegte Schlüssel erst Tage später bemerken und annehmen, niemand habe es gesehen — da haben Angreifer die Daten längst abgegriffen.
Ausgaben nicht ausreichend prüfen
KI-Tools geben mitunter Bruchstücke von Trainingsdaten oder sensible Informationen aus. Eine Code-Vervollständigung schlägt womöglich echte Kunden-E-Mail-Adressen vor, die sie im Training gesehen hat. Ein Zusammenfassungsdienst übernimmt vertrauliche Details in seine Zusammenfassungen. Wer KI-Ausgaben vor der Verwendung nicht prüft, riskiert Datenabflüsse.
Prüfen Sie KI-generierte Inhalte automatisch, bevor sie in die Produktion gelangen. Erkennen Sie mit regulären Ausdrücken Muster personenbezogener Daten wie E-Mail-Adressen, Telefonnummern oder Ausweisformate. Wenden Sie dieselben Werkzeuge zur Verhinderung von Datenabflüssen auf KI-Ausgaben an wie auf von Menschen erstellte Inhalte. Für sensible Fälle bietet sich eine „Human-in-the-Loop“-Prüfung an, bei der jeder KI-generierte Inhalt freigegeben werden muss.
Den Standard-Datenschutzeinstellungen vertrauen
Die meisten KI-Dienste sind standardmäßig auf Datenerhebung und -speicherung ausgelegt, die ihrem Training dient, nicht Ihrer Privatsphäre. Die Einstellungen erlauben oft das Speichern von Gesprächen, die Sichtung durch Menschen und die Verwendung Ihrer Daten zur Modellverbesserung. Organisationen führen KI-Tools häufig ein, ohne die Datenschutzeinstellungen zu prüfen, und verlassen sich auf vermeintlich vernünftige Voreinstellungen.
Prüfen Sie die Datenschutzeinstellungen vor dem Einsatz systematisch. Deaktivieren Sie, wo möglich, die Datenspeicherung, widersprechen Sie der Nutzung für das Training und wählen Sie die strengsten verfügbaren Optionen. Für kritische Anwendungen sollten Sie eigene Auftragsverarbeitungsverträge aushandeln, die den Anbieter rechtlich an bestimmte Datenschutzzusagen binden. Dokumentieren Sie Ihre Einstellungen für Compliance-Prüfungen. Prüfen Sie regelmäßig sowohl Ihre eigenen Abläufe als auch die Datenschutzzusagen Ihrer KI-Anbieter.
Transparenz und Vertraulichkeit abwägen
Erklärbare KI einrichten
Datenschutz und Transparenz von KI können sich widersprechen. Um Modellentscheidungen zu erklären, muss man mitunter Muster aus den Trainingsdaten offenlegen, die personenbezogene Informationen preisgeben. Eine KI für Kreditentscheidungen, die erklärt „abgelehnt, weil Sie in Postleitzahlgebiet X wohnen und dort die Ausfallquote Y beträgt“, verrät demografische Muster.
Setzen Sie auf datenschutzbewusste Erklärverfahren. Statt konkrete Trainingsbeispiele zu zeigen, nutzen Sie kontrafaktische Erklärungen — „Läge Ihr Einkommen 5.000 € höher, stiege die Zusagewahrscheinlichkeit auf 85 %.“ Fassen Sie Erklärungen über viele Vorhersagen zusammen, statt Einzelentscheidungen zu begründen. Nutzen Sie Aufmerksamkeitsmechanismen, die relevante Eingabemerkmale hervorheben, ohne sensible Muster aus den Trainingsdaten offenzulegen.
Dokumentationspflichten
Regelwerke wie die DSGVO verlangen, dass Sie dokumentieren, wie Sie personenbezogene Daten mit KI-Systemen verarbeiten. Dazu gehören Datenschutz-Folgenabschätzungen, die Risiken, Gegenmaßnahmen und die Notwendigkeit der Verarbeitung beschreiben. Diese Transparenzpflicht kollidiert mit der Vertraulichkeit, wenn die Dokumentation selbst sensible Geschäftslogik oder Sicherheitsmaßnahmen offenlegt.
Arbeiten Sie mit gestufter Dokumentation. Öffentliche Datenschutzhinweise erklären, welche Daten Sie erheben und zu welchen allgemeinen Zwecken Sie sie verarbeiten. Interne technische Dokumentation beschreibt konkrete KI-Architekturen und Sicherheitskontrollen und ist nur Berechtigten zugänglich. Unterlagen für Behörden enthalten die nötigen Details, verbunden mit der Bitte um vertrauliche Behandlung sensibler Informationen. So erfüllen Sie die Transparenzpflichten, ohne die betriebliche Sicherheit zu gefährden.
Bei ABXK.AI beschäftigen wir uns weiter mit KI-Sicherheit und teilen praktische Hinweise. Probieren Sie unseren KI-Text-Detektor und die weiteren Tools aus, oder lesen Sie weitere Artikel dazu, wie Sie sich beim Einsatz von KI-Tools schützen.