

Jeder KI-Ablauf in diesem Lernpfad hat dieselbe Schwachstelle: Die KI liegt manchmal falsch, und sie merkt es nicht immer. Human in the Loop (HITL) ist die Antwort darauf: Menschen prüfen, geben frei oder übernehmen an festgelegten Stellen. Schlecht umgesetzt heißt das, alles zu prüfen, was die Zeit kostet, die die KI sparen soll, oder nichts zu prüfen, sodass Fehler bei Kunden landen. Gut umgesetzt schauen Menschen genau dort hin, wo ihr Urteil einen Unterschied macht.
Dieser Artikel ist Teil 5 von Level 3 unseres Lernpfads AI Work, und er verbindet die vorigen Teile. Der Pilot misst die Qualität, die Anbindung begrenzt, was die KI schreiben darf, und Finanzen und Prüfung haben gezeigt, warum die Freigabe zählt. Sie lernen, wo Sie menschliche Prüfungen platzieren, wie Sie Konfidenzschwellen festlegen, wie Stichproben funktionieren, wie Sie Eskalationswege und Feedbackschleifen gestalten und wer verantwortlich ist.
Drei Stufen menschlicher Kontrolle
Die von der Europäischen Kommission eingesetzte Hochrangige Expertengruppe für KI unterscheidet drei Stufen der Aufsicht (Quelle: Ethik-Leitlinien für eine vertrauenswürdige KI, 2019):
- Human in the Loop: Ein Mensch kann bei jeder Entscheidung eingreifen, etwa indem er jede Antwort freigibt, bevor sie hinausgeht.
- Human on the Loop: Die KI handelt selbstständig, Menschen gestalten den Ablauf, überwachen ihn und können eingreifen.
- Human in Command: Menschen beaufsichtigen das ganze System, entscheiden, ob und wann KI überhaupt eingesetzt wird, und können sie übersteuern.
Die meisten echten Abläufe mischen die drei Stufen. Ein Supportteam gibt Erstattungen vielleicht Fall für Fall frei, überwacht die Routineantworten seines KI-Agenten und entscheidet gemeinsam, welche Themen der Agent überhaupt bearbeiten darf.
Welche Stufe Sie auch wählen: Der menschliche Teil wirkt nur, wenn Menschen weiter mitdenken. In einer Umfrage von Microsoft Research und der Carnegie Mellon University unter 319 Wissensarbeitenden von 2025 ging größeres Vertrauen in generative KI nach eigenen Angaben der Befragten mit weniger kritischem Denken einher, größeres Vertrauen in die eigenen Fähigkeiten dagegen mit mehr. Kritisches Denken verlagerte sich zudem vom Erledigen der Aufgabe zum Prüfen von Informationen, zum Einfügen der KI-Antworten in die Arbeit und zur Verantwortung für das Ergebnis (Quelle: Lee et al., CHI 2025). Prüfungen, die Menschen ungelesen abnicken, sind keine Aufsicht. Geben Sie Prüfenden die Zeit und die Kriterien, um Nein zu sagen.
Prüfungen dort platzieren, wo das Risiko liegt
Nicht jedes Ergebnis braucht dieselbe Prüfung. Level 2 hat mit einer ähnlichen Matrix entschieden, wo Freigaben in einem Ablauf hingehören. Hier bestimmt dieselbe Idee die Art der Prüfung für jede Art von Ergebnis. Zwei Fragen entscheiden: Wie viel Schaden kann ein Fehler anrichten, und wie leicht lässt er sich rückgängig machen? Ein falsches Schlagwort an einem Ticket kostet einen Klick. Eine falsche Erstattung oder eine falsche Aussage zu einem Vertrag kostet Geld, Vertrauen oder einen Rechtsstreit, und sie lässt sich nicht zurückholen, wenn sie einmal verschickt ist.
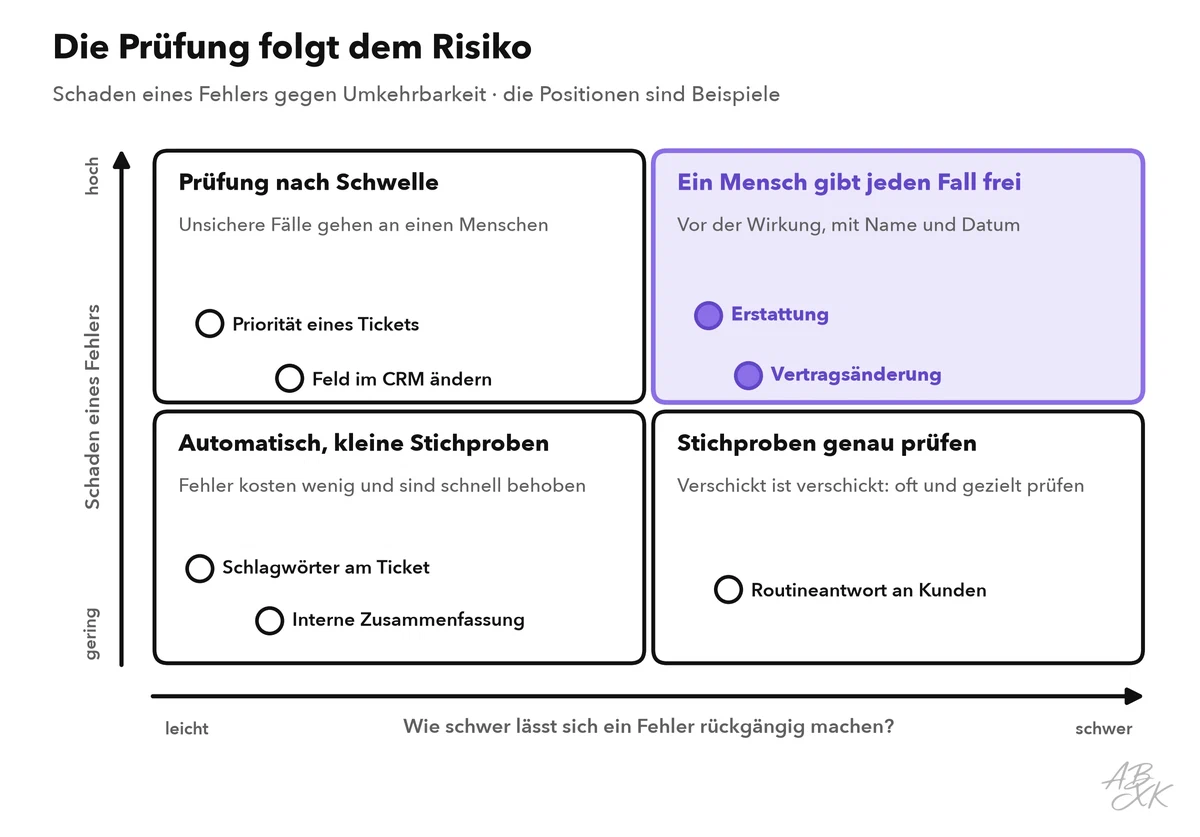
Halten Sie Ihre Einordnung für jede Art von Ergebnis schriftlich fest. Diese Liste wird zum Kern Ihres Qualitätsplans, und sie ändert sich, während Sie lernen. Ein Ergebnis, das sich über Monate als verlässlich erweist, kann von der Freigabe zur Stichprobe wechseln. Die Tabelle zeigt die fünf üblichen Prüfarten:
| Prüfart | Wann sie stattfindet | Typischer Einsatz |
|---|---|---|
| Freigabe vor Verwendung | Bevor das Ergebnis wirkt | Erstattungen, Vertragsänderungen, erste Wochen eines neuen KI-Agenten |
| Prüfung nach Schwelle | Nur wenn die KI unsicher ist | Ticket-Sortierung, Antwortentwürfe, Belegerfassung |
| Zufallsstichprobe | Im Nachhinein, an einem Teil aller Ergebnisse | Routineantworten, die die KI allein verschickt hat |
| Eskalation | Wenn ein Fall den Rahmen der KI verlässt | Beschwerden, rechtliche Drohungen, ein Kunde, der einen Menschen verlangt |
| Audit | Regelmäßig, am ganzen Ablauf | Regeln, Schwellen, Protokolle und Fehlertrends |
Konfidenzschwellen: wann die KI abgibt
Eine Konfidenzschwelle ist ein Grenzwert. Liegt ein Ergebnis darüber, geht es durch; liegt es darunter, prüft ein Mensch das Ergebnis oder übernimmt den Fall. Viele Teams arbeiten mit zwei Schwellen, wie im Beispiel unten. Der Wert stammt aus einem Signal dafür, wie sicher ein Ergebnis ist. Gute Signale sind der Wert eines Klassifikators für eine Kategorie, wie gut eine Frage zu einem Artikel der Wissensdatenbank passt, ob Regelprüfungen bestanden wurden oder ob zwei Durchläufe derselben Anfrage übereinstimmen. Ein schlechtes Signal ist die eigene Aussage des Modells, etwa „Ich bin mir zu 95 % sicher“: Sprachmodelle klingen oft sicher, wenn sie falschliegen.
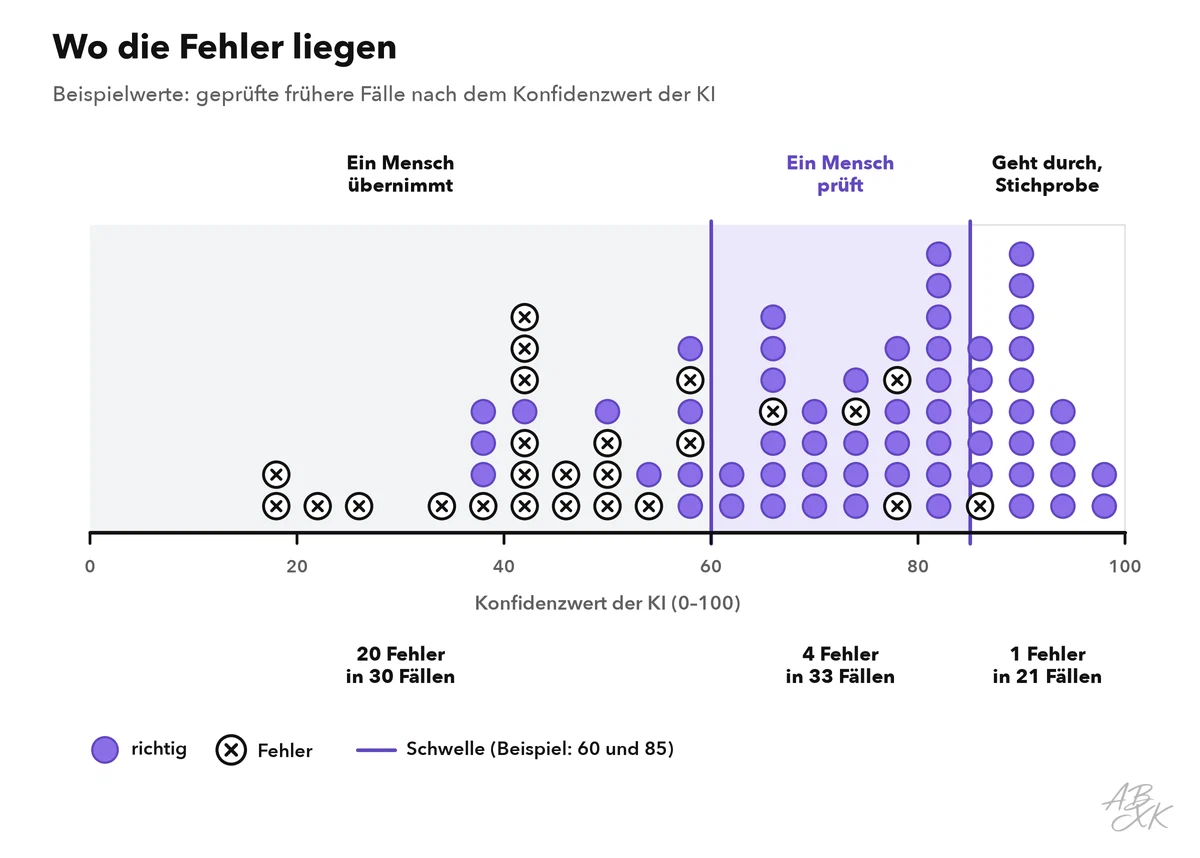
Legen Sie Schwellen mit Daten fest, nicht nach Gefühl. Nehmen Sie einige Hundert frühere Fälle, die Menschen geprüft haben, sortieren Sie sie nach dem Signal und schauen Sie, wo sich die Fehler häufen. Beginnen Sie vorsichtig, sodass mehr Fälle zu Menschen gehen, und senken Sie die Schwelle erst, wenn Ihre Stichproben zeigen, dass die Ergebnisse darüber verlässlich sind.
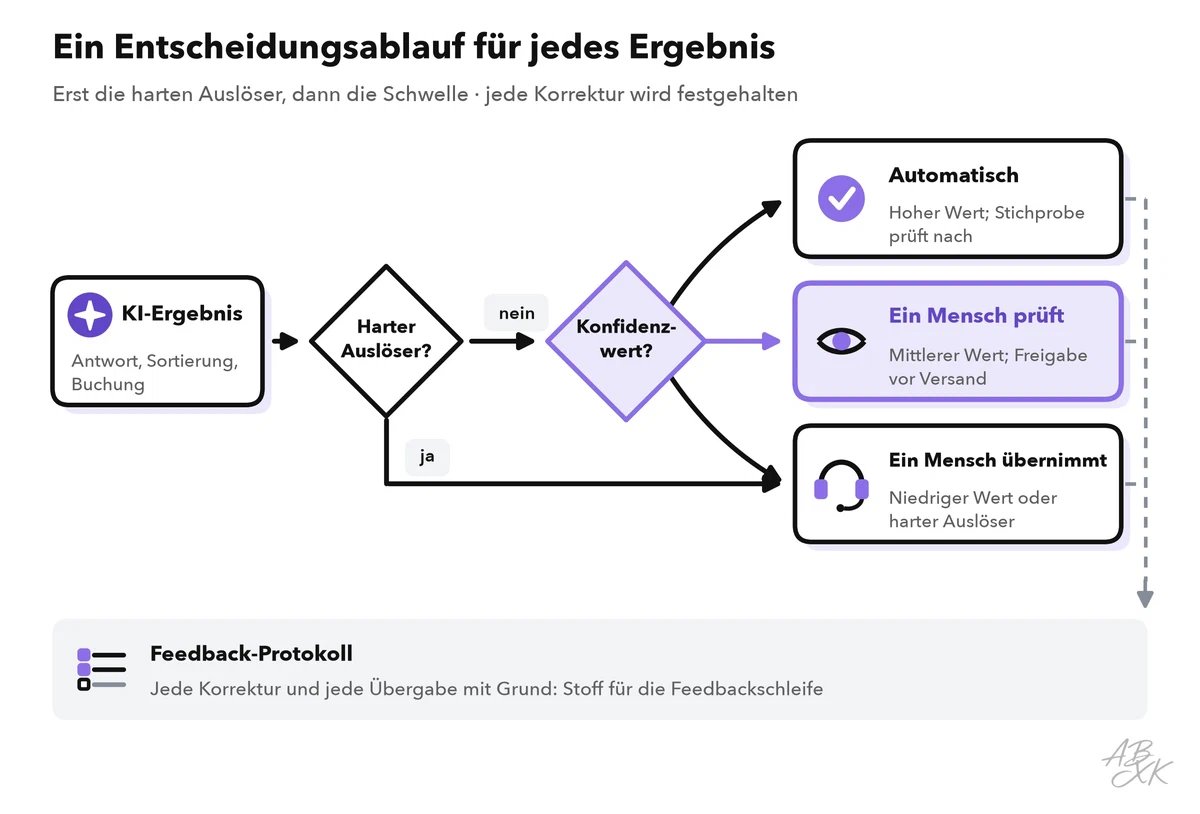
Manche Fälle gehen unabhängig vom Wert an einen Menschen. Legen Sie diese harten Auslöser schriftlich fest: eine rechtliche Drohung, ein Sicherheitsproblem, eine schutzbedürftige Kundin, ein hoher Betrag oder einfach der Wunsch, mit einem Menschen zu sprechen.
Stichproben: prüfen, was die KI allein erledigt hat
Für Ergebnisse über der Schwelle zeigt eine Zufallsstichprobe, ob die Schwelle hält. Ziehen Sie jede Woche eine feste Zahl automatisch erledigter Fälle, zum Beispiel 50, und prüfen Sie sie mit einer kurzen Checkliste: richtige Fakten, vollständige Antwort, passender Ton, richtige Aktion. Ergänzen Sie gezielte Stichproben für neue Themen und für Kategorien mit früheren Fehlern.
Eine Stichprobe sagt weniger, als es scheint. Prüfen Sie 100 Fälle und finden keinen Fehler, kann die wahre Fehlerquote trotzdem bei bis zu etwa 3 Prozent liegen. In der Statistik heißt das Dreierregel (Rule of Three): Gibt es in n geprüften Fällen keinen Fehler, liegt die Obergrenze des 95-Prozent-Konfidenzintervalls bei etwa 3 geteilt durch n. Um eine Fehlerquote unter 1 Prozent zu belegen, brauchen Sie also etwa 300 geprüfte Fälle ohne Fehler.
Lassen Sie ab und zu zwei Prüfende dieselben 20 Fälle prüfen. Sind sie oft unterschiedlicher Meinung, ist die Checkliste unklar, und Ihre Fehlerquote misst die Prüfenden, nicht die KI.
Eskalationswege, die funktionieren
Ein Eskalationsweg legt fest, wer einen Fall übernimmt, wann und mit welchen Informationen. Schwache Eskalation endet in einer Sackgasse: Der Kunde wiederholt alles, oder der Fall wartet in einer Warteschlange, für die niemand zuständig ist. Fünf Regeln verhindern das:
- Benannte Stufen, etwa KI-Agent, dann Serviceteam, dann Fachspezialistin oder Teamleitung.
- Fristen für jede Stufe, etwa eine Arbeitsstunde für dringende Fälle.
- Eine vollständige Übergabe: Die KI gibt eine Zusammenfassung weiter, was sie getan hat und warum sie abgibt.
- Ein Ausweg für Kunden: Wer nach einem Menschen fragt, bekommt einen.
- Kein Pingpong: Ein Fall, den ein Mensch übernommen hat, geht nicht ohne Entscheidung zur KI zurück.
Kundenservice-Plattformen haben Übergabefunktionen meist eingebaut. Nach Angaben der Anbieter verbindet Tidio einen KI-Agenten mit Live-Chat und Ticketsystem, Typewise bietet KI-Agenten, die Anfragen über mehrere Kanäle für größere Supportteams bearbeiten, und mit Landbot bauen Teams Chatbot-Abläufe für Websites und WhatsApp ohne Code. Testen Sie die Übergabe selbst, bevor Sie live gehen: Starten Sie ein Gespräch, verlangen Sie einen Menschen und sehen Sie nach, was auf der anderen Seite ankommt.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Alle 10 Tools für den Kundenservice finden Sie in unserem Tool-Vergleich für AI Work.
Den Kreis schließen: aus Korrekturen Verbesserungen machen
Jede Korrektur eines Menschen ist eine Information. Geht sie im Alltag verloren, kommt derselbe Fehler morgen wieder. Eine Feedbackschleife sammelt Korrekturen, findet ihre Ursache und behebt sie an der Wurzel:
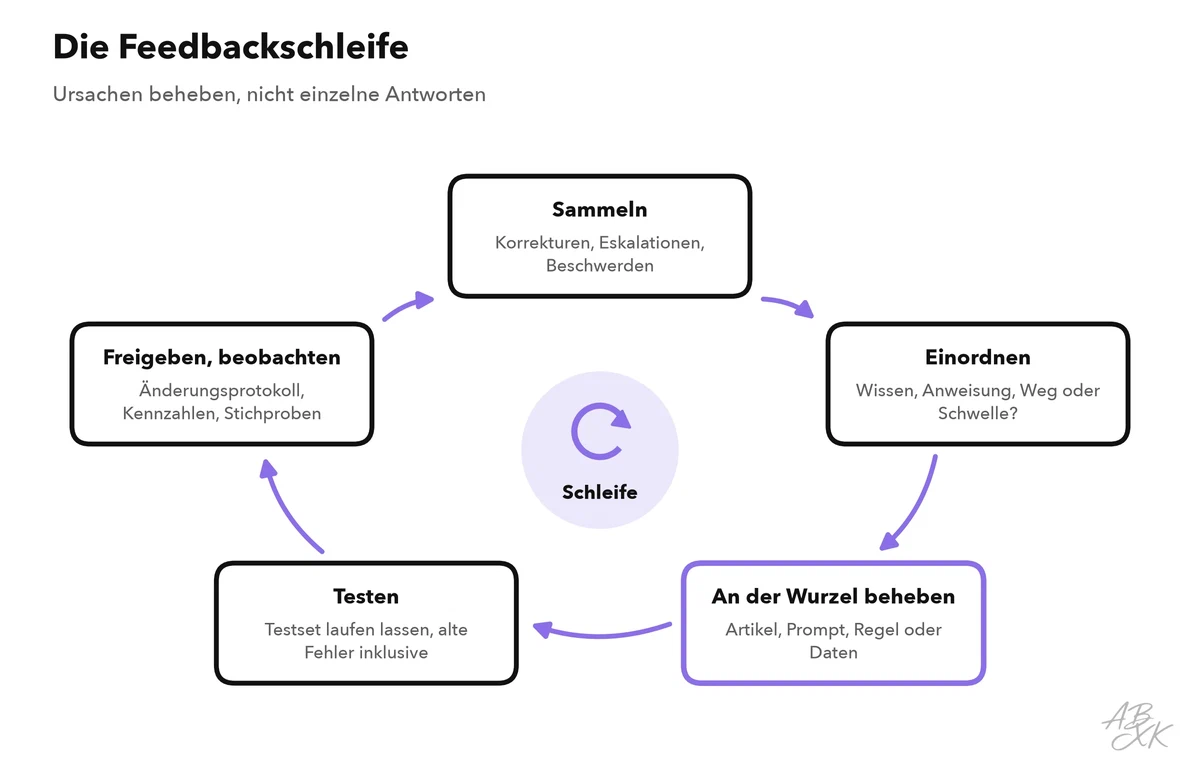
Ordnen Sie jeden Fehler nach seiner Ursache ein, denn jede Ursache braucht eine andere Lösung. Eine Lücke in der Wissensdatenbank braucht einen Artikel, eine unklare Anweisung einen besseren Prompt, eine falsche Weiterleitung eine Regel und eine falsche Schwelle neue Daten. Bevor Sie eine Änderung freigeben, lassen Sie sie gegen ein Testset laufen: eine feste Sammlung früherer Fälle mit bekannten richtigen Antworten, einschließlich der Fehler, die Sie schon behoben haben. Kommt ein alter Fehler zurück, ist die Änderung nicht fertig.
Wer verantwortlich ist
Eine KI kann keine Verantwortung tragen, Menschen schon. Benennen Sie für jeden KI-Ablauf die Rollen in einer einfachen Tabelle, zum Beispiel nach der RACI-Methode: Responsible (führt aus), Accountable (verantwortet das Ergebnis), Consulted (wird beteiligt) und Informed (wird informiert). Jede Aufgabe hat genau ein A.
| Aufgabe | Prozessverantwortliche | Prüfende | Technische Betreuung | Teamleitung |
|---|---|---|---|---|
| Regeln, Schwellen und harte Auslöser festlegen | A | C | R | C |
| Ergebnisse freigeben oder korrigieren | I | R | – | A |
| Stichproben ziehen und prüfen | A | R | I | I |
| Eskalationen bearbeiten | I | R | – | A |
| Wissen, Prompts und Regeln korrigieren | A | C | R | I |
| Den Ablauf selbst ändern | A, R | C | C | I |
Wie Sie solche Rollen für alle KI-Tools im Unternehmen festlegen, zeigt Level 4: KI-Governance für Fachbereiche.
Achten Sie auf den Automation Bias, den Level 2 bei Freigaben in Abläufen vorgestellt hat: Wer am Tag Hunderte gute Entwürfe freigibt, liest irgendwann nicht mehr genau. Die KI-Verordnung der EU benennt dieses Risiko: Bei Hochrisiko-KI-Systemen müssen sich die Menschen, die sie beaufsichtigen, der Neigung bewusst bleiben, sich zu sehr auf die Ausgabe zu verlassen (Art. 14). Zusätzlich zu den Gegenmitteln aus Level 2 helfen zwei Gewohnheiten, wenn viele Menschen prüfen. Begrenzen Sie die Zahl der Prüfungen pro Person und Tag. Und mischen Sie ab und zu bekannte Fehler in die Prüfwarteschlange: Wer sie übersieht, braucht eine Pause oder eine klarere Checkliste, nicht mehr Fälle.
Auch das Recht setzt Grenzen, wenn KI über Menschen entscheidet. Nach Art. 22 DSGVO haben Personen das Recht, keiner ausschließlich automatisierten Entscheidung unterworfen zu werden, die ihnen gegenüber rechtliche Wirkung entfaltet oder sie in ähnlicher Weise erheblich beeinträchtigt. Die Ausnahmen sind eng, und sie verlangen Schutzmaßnahmen wie das Recht auf das Eingreifen einer Person.