

Ein Team im operativen Betrieb bearbeitet jeden Tag Hunderte kleiner Fälle. Eine Lieferung ist verspätet, eine Rechnung passt nicht zur Bestellung, ein Kunde will einen Termin verschieben. Die Fälle folgen einem Muster, aber jeder unterscheidet sich im Detail. Feste Automatisierungen scheitern an den Details, und Menschen verbringen ihre Tage mit Routine. KI-Agenten versprechen, diese Lücke zu schließen: Sie lesen den Fall, entscheiden über die nächsten Schritte und lösen ihn mit Werkzeugen. Die eigentlichen Fragen lauten: welche Prozesse, mit welchen Leitplanken und mit wie viel Autonomie?
Dieser Artikel ist Teil 5 von Level 4 und damit der letzte Teil unseres Lernpfads AI Work. Level 0 hat Assistenten, Automatisierungen und Agenten vorgestellt, Level 2 gezeigt, wie Sie Geschäftsabläufe automatisieren — mit Auslösern und Freigaben —, und Level 3 hat menschliche Prüfungen dort platziert, wo das Risiko liegt. Hier setzen Sie diese Teile für den Betrieb zusammen: Muster für Abläufe, wie lange Aufgaben Agenten heute schaffen, passende Prozesse, Werkzeugzugriff, Leitplanken, Überwachung und einen Weg zur Autonomie in Stufen.
Von festen Abläufen zu agentischen Abläufen
Anthropic, das Unternehmen hinter den Claude-Modellen, zieht eine nützliche Grenze. In einem Workflow folgen Sprachmodelle und Werkzeuge vorab festgelegten Pfaden im Code. Ein Agent steuert seinen Ablauf und seinen Werkzeugeinsatz selbst (Quelle: Anthropic, „Building Effective Agents“, 2024, anthropic.com). Dazwischen liegt ein Mittelweg, der zu vielen Aufgaben im Betrieb passt: der agentische Ablauf. Prozess und erlaubte Aktionen sind festgelegt, aber innerhalb dieses Rahmens entscheidet die KI, welcher Schritt als Nächstes kommt.
Dieselbe Quelle beschreibt fünf verbreitete Muster:
- Prompt Chaining (Verkettung): Eine Aufgabe läuft als feste Folge von KI-Schritten, und jeder Schritt lässt sich prüfen, bevor der nächste beginnt.
- Routing (Weiterleitung): Die KI ordnet einen Fall ein und schickt ihn auf den passenden Weg.
- Parallelisierung: Mehrere KI-Aufrufe bearbeiten gleichzeitig Teile einer Aufgabe oder stimmen über eine Antwort ab.
- Orchestrator und Worker: Eine KI zerlegt eine Aufgabe in Teilaufgaben und verteilt sie an andere.
- Evaluator und Optimierer: Eine KI erzeugt ein Ergebnis, eine andere prüft es anhand von Kriterien und verlangt eine Überarbeitung.
Ihr wichtigster Rat für die Gestaltung ist einfach: Suchen Sie die einfachste Lösung, die funktioniert, und fügen Sie Komplexität nur hinzu, wenn sie klar hilft. Ein Agent kostet mehr Zeit und Geld als ein Workflow, und er ist schwerer vorherzusagen. Die Tabelle vergleicht die drei Möglichkeiten an einem Fall, einer verspäteten Lieferung:
| Fester Workflow | Agentischer Ablauf | Autonomer Agent | |
|---|---|---|---|
| Weg | Vorab festgelegt | Die KI wählt unter erlaubten Schritten | Die KI plant ihre Schritte selbst |
| Verspätete Lieferung | Jede Beschwerde bekommt dieselbe Vorlage | Die KI liest die E-Mail, prüft den Paketdienst und antwortet dann mit neuem Termin, bucht um oder eskaliert | Die KI bekommt das Ziel „Lieferverzögerungen lösen“ und entscheidet, welche Systeme sie nutzt und was sie anbietet |
| Stärke | Berechenbar und günstig | Bewältigt Vielfalt in Grenzen | Bewältigt offene Aufgaben |
| Hauptrisiko | Scheitert an Ausnahmen | Eine falsche Wahl unter erlaubten Aktionen | Unerwartete Aktionen, schwer nachzuvollziehen |
| Eignung im Betrieb | Stabile, regelbasierte Schritte | Die meisten Routinefälle mit Vielfalt | Selten und nur mit starken Kontrollen |
Wie lange Aufgaben Agenten heute schaffen
Mehrstufige Arbeit ist aus einem einfachen Grund schwierig: Fehler summieren sich. Gelingt jeder Schritt mit 95 Prozent Wahrscheinlichkeit und sind die Schritte unabhängig, gelingt eine Aufgabe mit zehn Schritten nur in etwa 60 Prozent der Fälle (0,95 hoch 10). Bei 99 Prozent je Schritt sind es etwa 90 Prozent. Gute Agenten bemerken und beheben einen Teil ihrer Fehler selbst, deshalb können echte Ergebnisse besser ausfallen als diese einfache Rechnung. Die Richtung aber bleibt: Längere Aufgaben scheitern öfter.
Die Forschungsorganisation METR misst das mit dem Zeithorizont: der Länge von Aufgaben, gemessen an der Zeit, die eine erfahrene Fachkraft dafür braucht, die ein Modell in etwa der Hälfte der Fälle erfolgreich erledigt. Das sind die aktuellen Spitzenreiter in unserer LLM-Datenbank:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Claude Mythos Preview (Early) Anthropic | 07.04.2026 | 17 Std. 25 min |
| 2 | Claude Opus 4.6 (unknown thinking) Anthropic | 05.02.2026 | 11 Std. 59 min |
| 3 | Gemini 3.1 Pro Preview Google DeepMind | 19.02.2026 | 6 Std. 24 min |
| 4 | GPT-5.2 (high) OpenAI | 11.12.2025 | 5 Std. 52 min |
| 5 | GPT-5.3 Codex OpenAI | 05.02.2026 | 5 Std. 50 min |



Die Länge der Aufgaben, die ein Modell in etwa der Hälfte der Fälle richtig löst — gemessen daran, wie lange ein menschlicher Experte dafür braucht. Die Zahl ist eine Dauer, kein Punktwert: Ein längerer Horizont heißt, das Modell kann länger selbstständig arbeiten. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
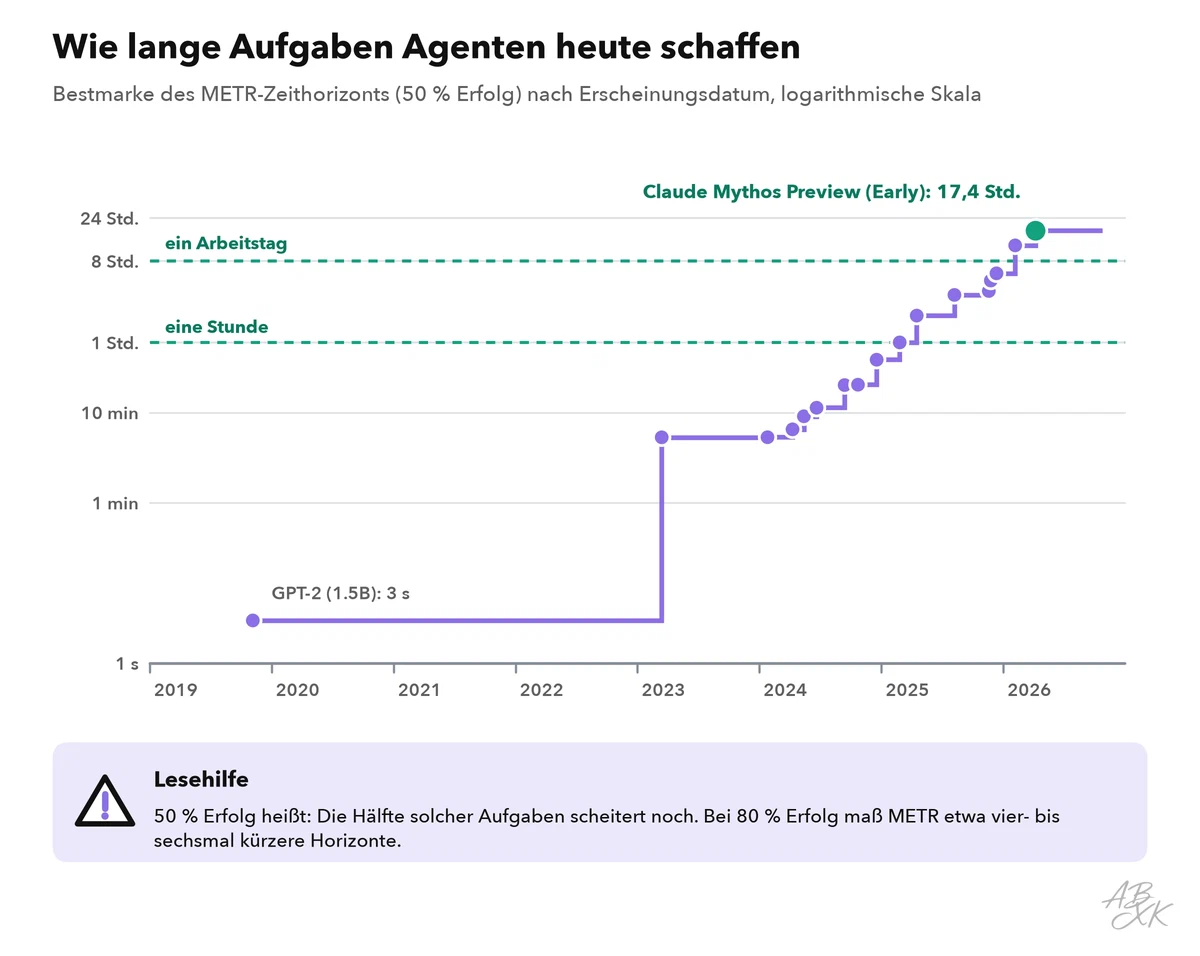
In seiner Studie von 2025 kam METR zu dem Ergebnis, dass sich dieser Horizont seit 2019 etwa alle sieben Monate verdoppelt hat (Quelle: METR, „Measuring AI Ability to Complete Long Tasks“, 2025, metr.org). Drei Punkte zählen für den Betrieb:
- Fünfzig Prozent sind nicht verlässlich genug. Bei einer Erfolgsquote von 80 Prozent maß METR vier- bis sechsmal kürzere Horizonte als bei 50 Prozent. Ein Modell, das Aufgaben von einer Stunde in der Hälfte der Fälle löst, erreicht 80 Prozent Erfolg also nur bei Aufgaben von rund 10 bis 15 Minuten.
- Die Aufgaben sind Software- und Denkaufgaben mit klaren Erfolgskriterien. Echte Arbeit im Betrieb ist unordentlicher: unvollständige Daten, unklare Anfragen, Ausnahmen. Rechnen Sie dort mit kürzeren verlässlichen Aufgabenlängen als in einem Benchmark.
- Weit unter dem Horizont planen. Zerlegen Sie Arbeit in Schritte, die deutlich kürzer sind als der Horizont, mit einer Prüfung nach jedem Schritt. Modelle und ihre Ergebnisse vergleichen Sie in unserer LLM-Datenbank.
Welche Prozesse zu einem Agenten passen
Zwei Fragen ordnen die meisten Prozesse: Wie verschieden sind die Fälle — ihre Eingaben, Wege und Ausnahmen? Und wie leicht lässt sich ein Fehler beheben?
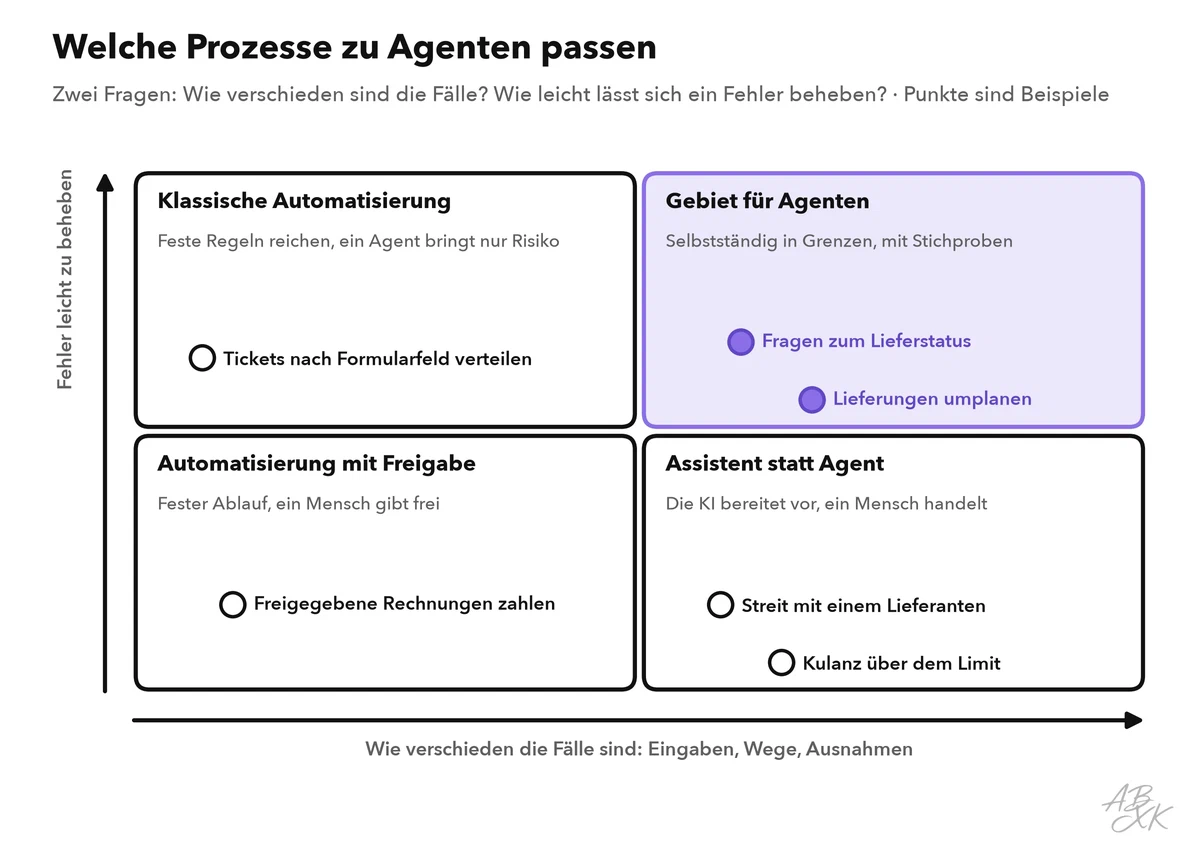
Gleichförmige Fälle erledigen feste Regeln am besten, ein Agent bringt dort nur Kosten und Risiko. Agenten verdienen ihren Platz, wo Fälle variieren, Fehler sich aber leicht beheben lassen: Fragen zur Lieferung beantworten, Termine umplanen, Tickets sortieren und anreichern. Wo Fehler teuer oder endgültig sind, bereitet die KI vor, und ein Mensch handelt. Gute Kandidaten haben sechs Merkmale gemeinsam:
- Eine große Zahl ähnlicher, aber nicht gleicher Fälle.
- Ein klares Ziel und eine Möglichkeit, das Ergebnis zu prüfen.
- Aktionen, die sich rückgängig machen lassen, oder eine Freigabe für die, bei denen das nicht geht.
- Daten und Werkzeuge, die der Agent über Schnittstellen erreicht.
- Eine Rückfallebene: eine Warteschlange, in der Menschen übernehmen.
- Eine verantwortliche Person für die Ergebnisse.
Schlechte Kandidaten sind seltene Entscheidungen mit hohem Einsatz, Entscheidungen über Menschen wie Einstellungen oder Kredite — Hochrisiko-Nutzungen nach der KI-Verordnung der EU — und Prozesse, bei denen niemand sagen kann, was ein gutes Ergebnis ist. Teil 3 erklärt, wie solche Nutzungen eingestuft werden: KI-Governance für Fachbereiche.
Dem Agenten Werkzeuge geben, keine Schlüssel
Ein Agent handelt über Werkzeuge (Tools): Funktionen, die er aufrufen kann, etwa „Bestellung nachschlagen“, „Lieferung umbuchen“ oder „E-Mail senden“. Wie diese Werkzeuge gebaut sind, entscheidet über den größten Teil des Risikos:
- Enge Werkzeuge schlagen breite. „Die Lieferung für diese Bestellung umbuchen“ ist sicherer als „ein beliebiges Feld in der Datenbank ändern“.
- Lesen und Schreiben trennen. Die meisten Schritte müssen nur lesen. Werkzeuge, die schreiben, bekommen zusätzliche Prüfungen.
- Minimale Rechte. Der Agent bekommt ein eigenes Dienstkonto mit genau den Rechten, die seine Aufgabe braucht.
- Grenzen im Werkzeug selbst: Höchstbeträge, eine Tageszahl an Aktionen, Zeitfenster. Eine Grenze im Code hält auch dann, wenn die KI einen Fehler macht.
- Wiederholbare Aktionen. Läuft ein Schritt nach einem Fehler zweimal, darf er nicht doppelt buchen. Das ist die Regel der Idempotenz aus Level 2.
- Ein Testmodus: eine Sandbox oder ein Probelauf, der zeigt, was der Agent tun würde, ohne es zu tun.
Die OWASP Top 10 für LLM-Anwendungen nennen das Hauptrisiko hier Excessive Agency (übermäßige Handlungsmacht) und benennen drei Ursachen: zu viele Funktionen, zu viele Rechte und zu viel Autonomie (Quelle: OWASP Top 10 for LLM Applications 2025, LLM06, owasp.org). Ein verwandtes Risiko ist Prompt Injection: Anweisungen, die in einer E-Mail, einem Dokument oder einer Webseite versteckt sind, die der Agent liest. Behandeln Sie jeden fremden Text als Daten, nie als Anweisung, und lassen Sie nie zu, dass Inhalte verändern, was der Agent darf. Unser Bereich AI Security erklärt diese Angriffe und die Abwehr dagegen.
Leitplanken in fünf Schichten
Keine einzelne Kontrolle reicht. Legen Sie Leitplanken in Schichten an, damit eine Schicht auffängt, was einer anderen entgeht:
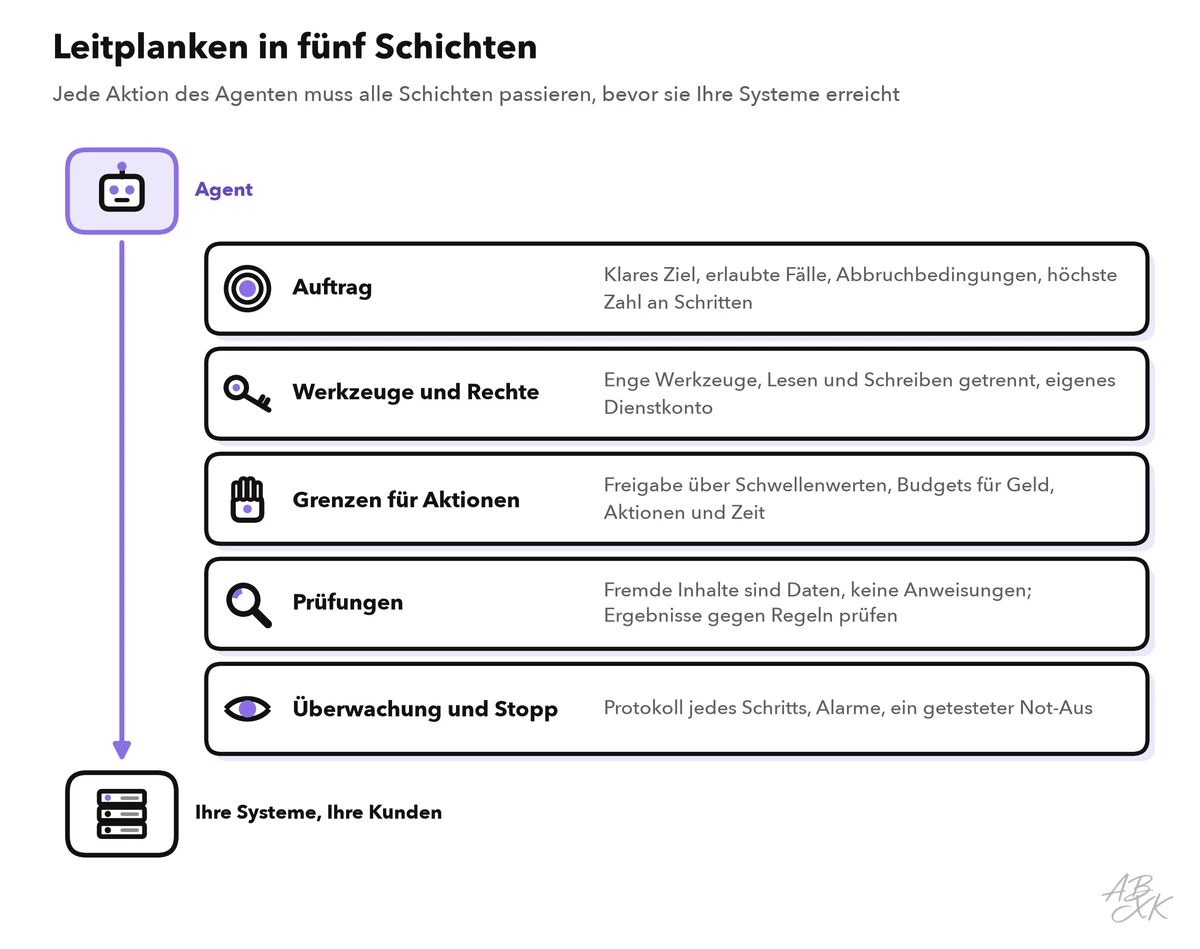
- Auftrag: ein klares Ziel, die Fälle, die der Agent bearbeiten darf, Abbruchbedingungen und eine Höchstzahl an Schritten.
- Werkzeuge und Rechte: enge Werkzeuge, getrennter Lese- und Schreibzugriff, ein eigenes Dienstkonto.
- Grenzen für Aktionen: Freigabe über Schwellenwerten, etwa für Erstattungen über einem festgelegten Betrag, und Budgets für Geld, Aktionen und Zeit.
- Prüfungen: Eingaben und Ergebnisse werden gegen Regeln geprüft, etwa dass ein neuer Liefertermin in der Zukunft liegt und dass es den Kunden gibt.
- Überwachung und Stopp: ein Protokoll jedes Schritts, Alarme bei ungewöhnlichen Mustern und ein Not-Aus.
Agenten überwachen wie eine neue Kollegin
Beobachten Sie einen Agenten so, wie Sie eine neue Kollegin in den ersten Monaten begleiten würden: anfangs eng, dann mit regelmäßigen Prüfungen. Diese Kennzahlen zeigen, ob es funktioniert:
| Kennzahl | Was sie zeigt | Warnzeichen |
|---|---|---|
| Erfolgsquote | Anteil korrekt gelöster Fälle, geprüft per Stichprobe | Sinkt nach einem Wechsel von Modell oder Prompt |
| Eskalationsquote | Anteil der Fälle, die an Menschen gehen | Steigt plötzlich oder fällt auf null |
| Korrekturquote | Wie oft Menschen eine Aktion rückgängig machen | Jeder Anstieg bei Fällen mit hohem Wert |
| Blockierte Aktionen | Aktionen, die Grenzen oder Prüfungen gestoppt haben | Ein plötzlicher Anstieg deutet auf ein neues Muster oder einen Angriff |
| Kosten je Fall | Modellnutzung und Werkzeugaufrufe je gelöstem Fall | Schleifen, die Kosten hochtreiben |
| Bearbeitungsdauer | Vom eingehenden Fall bis zum Abschluss | Fälle hängen zwischen Agent und Menschen fest |
Eine Eskalationsquote von null ist ein Warnzeichen, kein Erfolg: Entweder ist der Agent zu selbstsicher, oder die Übergabe ist kaputt. Protokollieren Sie jeden Schritt — Eingabe, Werkzeugaufruf, Ergebnis und Entscheidung —, damit Sie jeden Fall im Nachhinein nachvollziehen können. Prüfen Sie jede Woche eine Stichprobe. Lassen Sie Ihre Testfälle nach jedem Modell-Update und jeder Änderung am Prompt erneut laufen, denn derselbe Agent kann sich mit einem neuen Modell anders verhalten.
Autonomie Schritt für Schritt verdienen
Schalten Sie einen Agenten nicht gleich mit voller Autonomie ein. Lassen Sie ihn jede Stufe verdienen:
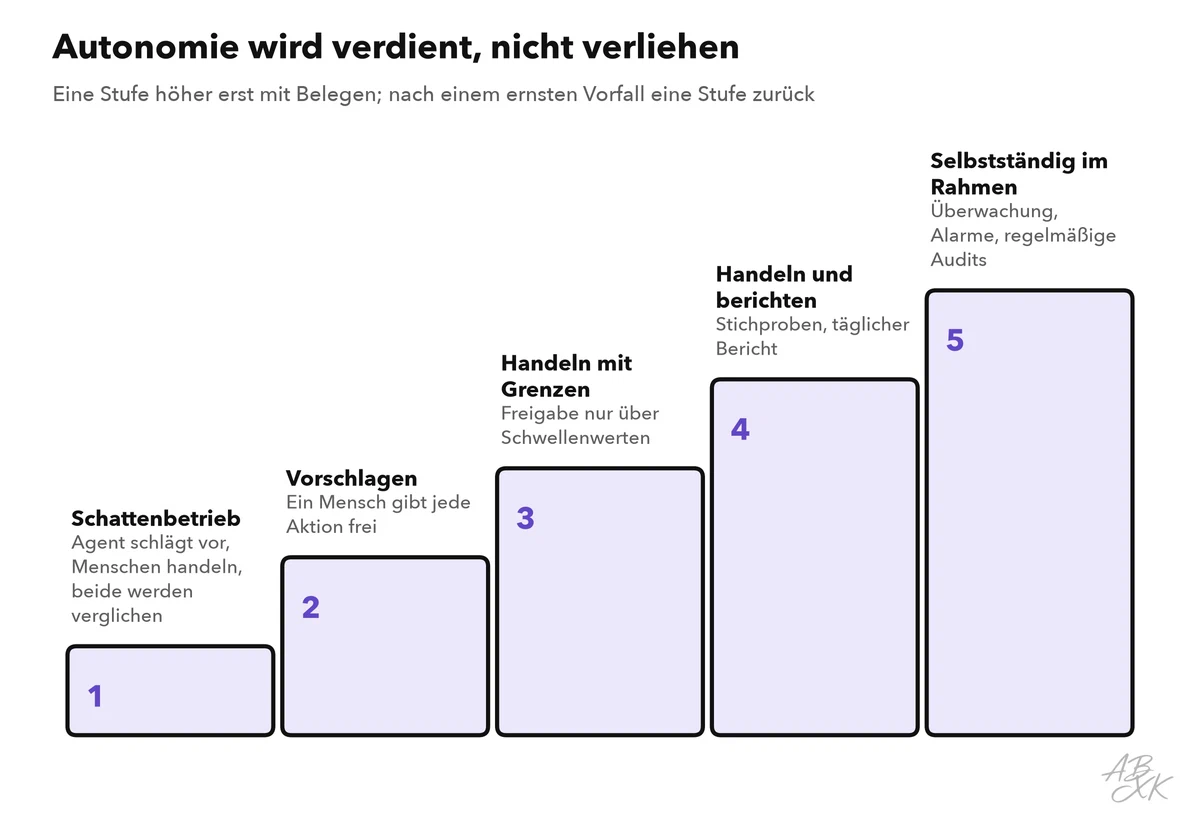
Am Anfang steht der Schattenbetrieb: Der Agent schlägt für echte Fälle Aktionen vor, die Menschen handeln wie bisher, und Sie vergleichen beides. So sehen Sie die Qualität des Agenten ohne jedes Risiko für Kunden. Danach gibt ein Mensch jede Aktion frei, dann nur noch Aktionen über Schwellenwerten, dann prüfen Menschen Stichproben und lesen einen täglichen Bericht. Selbst auf der obersten Stufe bleiben Überwachung, Alarme und regelmäßige Audits. Vereinbaren Sie vor jedem Schritt nach oben Kriterien: genug Fälle, Übereinstimmung mit menschlichen Entscheidungen über einem vorab festgelegten Wert, keine ernsten Vorfälle und stabile Kosten. Nach einem ernsten Vorfall geht es eine Stufe zurück.
Produkte aus unserem Vergleich zeigen die Spanne von festen Abläufen bis zu Agenten. Nach Angaben der Anbieter verbindet Ignition Angebote, Verträge und Abrechnung in einem Ablauf, Typewise betreibt KI-Agenten, die Kundenanfragen über mehrere Kanäle bearbeiten und in CRM- und ERP-Systemen arbeiten, die KI-Telefonagenten von Vida nehmen Anrufe an und vereinbaren Termine, und AiSDR ist ein KI-Vertriebsagent, der die Erstansprache übernimmt und auf Antworten reagiert:
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.