

Rechnungen, Lieferscheine, Verträge, Formulare: Viele Geschäftsdaten kommen noch auf Papier oder als gescanntes PDF an. OCR (Optical Character Recognition, Texterkennung) macht aus diesen Bildern Text, mit dem Software arbeiten kann. Mit KI kann OCR weit mehr als Buchstaben lesen. Sie findet die Rechnungsnummer, zerlegt eine Tabelle in Zeilen und füllt einen Buchungssatz aus. Das spart Stunden an Abtipparbeit — bringt aber eine neue Art Fehler mit: eine, die vollkommen plausibel aussieht.
Dieser Leitfaden erklärt die drei Arten von OCR, was die aktuellen OCR-Benchmarks zeigen, wo OCR mit KI danebenliegt und welche Prüfungen die Fehler abfangen. Am Ende steht ein Fall, in dem Sie gar keine OCR brauchen.
Drei Arten von OCR
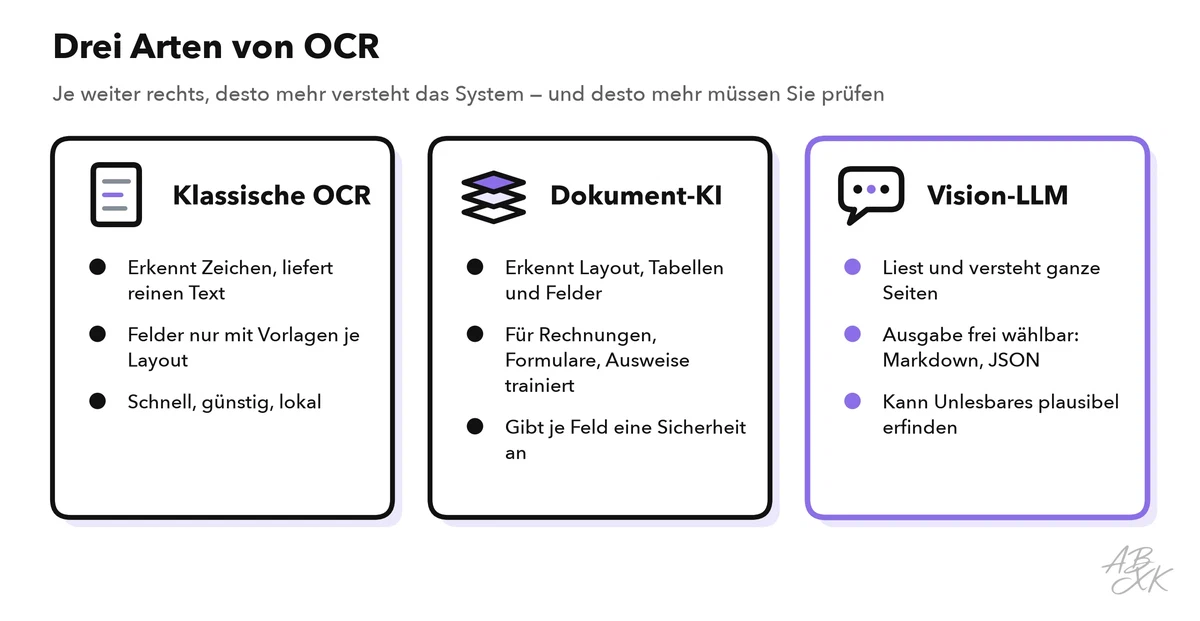
Klassische OCR erkennt Zeichen an ihrer Form und liefert reinen Text. Tesseract, eine Open-Source-Engine, die bei HP entstand und später von Google gefördert wurde, ist das bekannteste Beispiel; die meisten Scanner und PDF-Programme haben eine OCR-Funktion eingebaut. Klassische OCR ist schnell und läuft auf jedem Rechner, weiß aber nicht, was sie liest: Um einen Betrag aus einer Rechnung zu ziehen, muss jemand festlegen, wo dieser Betrag auf jedem Layout steht.
Dokument-KI-Dienste ergänzen eine Layout-Analyse und vortrainierte Modelle für gängige Dokumenttypen. Google Document AI, Azure AI Document Intelligence von Microsoft und Amazon Textract erkennen Rechnungen, Belege oder Ausweise, liefern benannte Felder wie „Rechnungsdatum“ oder „Gesamtbetrag“ und geben für jedes Feld eine Sicherheit an. Auf den Dokumenttypen, für die sie trainiert sind, arbeiten sie zuverlässig.
Vision-Sprachmodelle (Vision-LLMs) lesen eine Seite als Bild und verstehen sie im Zusammenhang. Sie können Markdown verlangen, JSON mit genau den Feldern, die Sie brauchen, oder eine Antwort auf eine Frage zum Dokument. Zu dieser Gruppe gehören allgemeine Modelle wie Gemini, GPT oder Qwen-VL und spezialisierte Dokument-Parser wie PaddleOCR-VL von Baidu, MinerU vom Shanghai AI Laboratory und olmOCR vom Allen Institute for AI — klein genug für den eigenen Server.
| Klassische OCR | Dokument-KI | Vision-LLM | |
|---|---|---|---|
| Ausgabe | Reiner Text, oft mit Position | Benannte Felder und Tabellen, mit Sicherheit | Text, Markdown oder JSON in beliebiger Struktur |
| Stärken | Schnell, günstig, läuft lokal | Zuverlässig bei Standarddokumenten | Neue Layouts ohne Einrichtung |
| Schwächen | Für Felder eine Vorlage je Layout nötig | Schwächer bei untrainierten Dokumenttypen | Kann Text erfinden, der nicht auf der Seite steht |
| Typischer Einsatz | Durchsuchbare Archive, einfache Scans | Rechnungen, Belege, Ausweise in Menge | Gemischte Dokumente, Eingabe für KI-Abläufe |
Wie KI-OCR aus einem Scan Daten macht
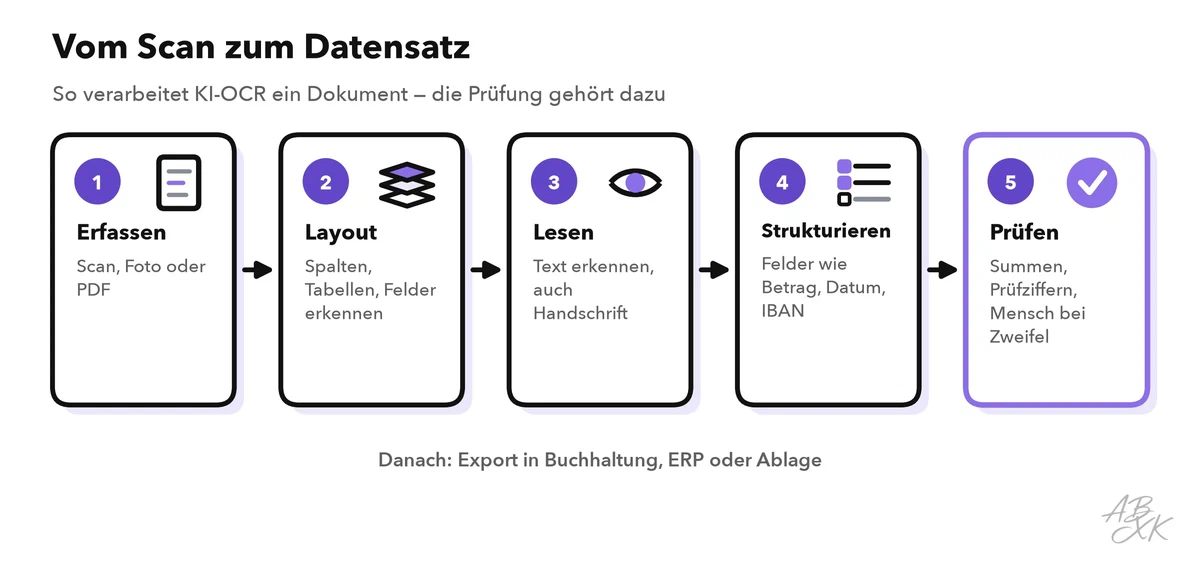
Jeder OCR-Ablauf durchläuft dieselben Schritte. Die Qualität des ersten begrenzt alle weiteren: Ein schiefes Handyfoto oder eine Faxkopie erzeugt in jedem späteren Schritt mehr Fehler — scannen Sie daher in guter Auflösung und richten Sie Seiten vor der Verarbeitung gerade aus. Danach findet das System das Layout (Spalten, Tabellen, Stempel), liest den Text, ordnet ihn Feldern wie Betrag, Datum und Bankverbindung zu und prüft das Ergebnis, bevor es in die Buchhaltung, ein ERP-System oder die Ablage geht. Der letzte Schritt entscheidet, ob OCR Zeit spart oder die Arbeit nur zu der Person verschiebt, die später die Fehler korrigiert.
Was die OCR-Benchmarks 2026 zeigen
Anbieter veröffentlichen Genauigkeitswerte auf eigenen Testdokumenten, das erschwert einen OCR-Vergleich. Zwei offene Benchmarks prüfen viele Systeme auf denselben Seiten.
OmniDocBench vom Shanghai AI Laboratory (vorgestellt auf der CVPR 2025) umfasst 1.651 PDF-Seiten aus 10 Dokumenttypen, darunter Fachartikel, Lehrbücher, Folien, Finanzberichte, Zeitungen und handschriftliche Notizen. Bewertet werden Text, Formeln, Tabellen und Lesereihenfolge zusammen. Ausgewählte Ergebnisse der Rangliste mit Stand 11. September 2026 (Quelle: github.com/opendatalab/OmniDocBench):
| System | Art | Gesamtwert |
|---|---|---|
| TeleOCR | Spezialisierter Dokument-Parser | 96,91 |
| PaddleOCR-VL-1.6 | Spezialisierter Dokument-Parser | 96,34 |
| GLM-OCR | Spezialisierter Dokument-Parser | 95,22 |
| Gemini 3 Pro | Allgemeines Vision-Sprachmodell | 92,91 |
| Qwen3-VL-235B | Allgemeines Vision-Sprachmodell | 89,78 |
| GPT-5.2 | Allgemeines Vision-Sprachmodell | 86,59 |
| MinerU-Pipeline | Kette klassischer Werkzeuge | 86,47 |
Die ersten elf Plätze gehen ausnahmslos an spezialisierte Dokument-Parser. Allgemeine LLMs lesen Dokumente gut, aber nicht am besten — und viele der führenden Parser sind offene Modelle, die Sie selbst betreiben können.
olmOCR-Bench vom Allen Institute for AI prüft über 7.000 einfache Fakten auf 1.400 Dokumenten: Steht ein Satz da, stimmt die Lesereihenfolge, steht eine Tabellenzelle unter der richtigen Überschrift? Die besten veröffentlichten Systeme erreichen rund 83 von 100 Punkten; alte Scans mit Formeln, Tabellen und lange Passagen in winziger Schrift sind die schwersten Kategorien (Quelle: github.com/allenai/olmocr). Auch die besten Systeme machen auf schwierigen Seiten noch Fehler — eine Prüfung nach der OCR bleibt also nötig.
Wo OCR mit KI danebenliegt
Klassische OCR scheitert sichtbar: Aus einem verschmierten Wort wird ein Zeichensalat, der jedem auffällt. Vision-LLMs scheitern leise. Ist eine Stelle unlesbar, schreiben sie mitunter etwas, das zum Zusammenhang passt — ein plausibles Datum, einen gerundeten Betrag. Das Allen Institute musste sein eigenes Modell olmOCR korrigieren, weil es auf leeren Seiten Text erfand (Quelle: github.com/allenai/olmocr). Achten Sie besonders auf diese Stellen:
- Zahlen. Eine falsche Ziffer in Betrag, IBAN oder Rechnungsnummer genügt für eine falsche Zahlung.
- Tabellen. Zellen rutschen in die Nachbarspalte, vor allem wenn eine Tabelle über zwei Seiten läuft.
- Handschrift, Stempel und Vermerke. Ein handschriftliches „bezahlt am“ neben dem Gesamtbetrag ändert die Bedeutung des ganzen Dokuments.
- Personenbezogene Daten. Rechnungen und Formulare enthalten Namen, Anschriften und Bankdaten. Sie an einen Cloud-OCR-Dienst zu senden, ist nach der DSGVO eine Auftragsverarbeitung und braucht einen Vertrag; was Sie vorher klären sollten, steht unter AI Security.
Diese Prüfungen fangen die meisten Fehler ab, bevor sie die Buchhaltung erreichen:
| Prüfung | Was sie abfängt | So funktioniert sie |
|---|---|---|
| Sicherheitsschwelle | Felder, bei denen das System unsicher ist | Felder unter einer festen Sicherheit gehen an eine Person |
| Rechenprüfung | Falsche Beträge | Netto plus Steuer ergibt brutto; die Positionen ergeben die Summe |
| Prüfziffern | Falsche IBANs und Steuernummern | IBANs tragen Prüfziffern, die die meisten Einzelziffer-Fehler verraten |
| Stammdaten | Falscher Lieferant oder Kunde | Namen und Bankdaten mit den eigenen Stammdaten abgleichen |
| Dubletten | Doppelte Zahlungen | Gleiche Rechnungsnummer, gleicher Lieferant, gleicher Betrag schon gesehen |
| Stichprobe | Fehler, die sich mit der Zeit einschleichen | Eine Person prüft jede Woche eine Zufallsstichprobe |
Saubere Stammdaten machen den Stammdatenabgleich erst möglich. Warum Datenqualität mit KI noch wichtiger wird und wie Sie sie steuern, steht in unserem Leitfaden zum Datenqualitätsmanagement.
E-Rechnungen: wann Sie gar keine OCR brauchen
Die beste OCR ist die, die Sie sich sparen. Eine strukturierte E-Rechnung enthält ihre Daten bereits als Felder; ein Bild davon zu lesen, würde nur Fehler hinzufügen. In Deutschland müssen alle Unternehmen seit dem 1. Januar 2025 strukturierte E-Rechnungen in Formaten wie XRechnung oder ZUGFeRD empfangen können; die Pflicht zum Ausstellen folgt in zwei Stufen 2027 und 2028 (Quelle: Bundesministerium der Finanzen, bundesfinanzministerium.de). Das EU-Paket „Mehrwertsteuer im digitalen Zeitalter“ macht E-Rechnungen ab Juli 2030 auch für grenzüberschreitende Geschäfte zwischen Unternehmen zur Pflicht (Quelle: Rat der EU, consilium.europa.eu). Verarbeiten Sie E-Rechnungen direkt und behalten Sie OCR für Papier, Bild-PDFs und Dokumente von Partnern, die keine strukturierten Daten schicken.
So wählen Sie den passenden OCR-Ansatz
Beginnen Sie bei Ihren Dokumenten, nicht bei der Technik:
| Frage | Wenn ja |
|---|---|
| Brauchen Sie nur durchsuchbaren Text, etwa für ein Archiv? | Klassische OCR genügt, oft schon im Scanner oder PDF-Programm eingebaut |
| Sind die meisten Dokumente Standardtypen wie Rechnungen und Belege? | Ein Dokument-KI-Dienst mit vortrainierten Modellen |
| Wechseln die Layouts stark, oder brauchen Sie Markdown oder JSON für einen KI-Ablauf? | Ein Vision-LLM oder ein spezialisierter Dokument-Parser |
| Müssen die Dokumente auf eigenen Servern bleiben? | Ein offenes Modell wie PaddleOCR-VL oder olmOCR auf eigener Hardware |
| Verarbeiten Sie Tausende Seiten am Tag? | Tempo und Kosten pro Seite mit eigenen Dokumenten vergleichen, bevor Sie entscheiden |
Was auch immer Sie wählen: Testen Sie es an 50 eigenen Dokumenten, schlechte Scans und handschriftliche Vermerke eingeschlossen, und zählen Sie Fehler je Feld, nicht je Seite. Unser Vergleich führt 8 Tools für Analyse & Betrieb, darunter DataSnipper, das Dokumente in Prüfung und Finanzwesen ausliest und abgleicht:
 DataSnipperAutomatisiert Prüfung und Abgleich von Belegen in Wirtschaftsprüfung und Finanzabteilung.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK.AI getestet.