

Die meisten Sicherheitsprobleme in KI-Anwendungen sind keine raffinierten neuen Angriffe. Es sind Lücken im Design, nach denen niemand gesucht hat: ein Assistent, der E-Mails von Fremden liest und zugleich Erstattungen auslösen kann, oder ein Suchindex, der Dokumente liefert, die der Nutzer nie sehen durfte. Threat Modeling (Bedrohungsmodellierung) ist ein strukturierter Weg, solche Lücken auf dem Papier zu finden — bevor ein Angreifer oder eine unglückliche Kundin sie im laufenden Betrieb findet.
Dies ist Teil 1 von Level 3 (Profi) im Lernpfad AI Security. Sie beschreiben eine LLM-App als Datenflussdiagramm, markieren ihre Vertrauensgrenzen, wenden die Methode STRIDE auf KI an, erfassen die Angriffsflächen und entscheiden, welche Risiken Sie zuerst angehen. Der Teil baut auf den OWASP Top 10 für LLM-Anwendungen aus Level 2 auf. Alle fünf Teile dieses Levels nutzen ein Beispiel: den Support-Assistenten des Onlineshops aus Level 2, der jetzt auch Kunden-E-Mails liest.
Vier Fragen hinter jedem Threat Model
Threat Modeling klingt nach einem schwerfälligen Verfahren, doch der Kern passt in vier Fragen. Der Sicherheitsexperte Adam Shostack hat sie bekannt gemacht, und das Threat Modeling Manifesto baut auf ihnen auf (Quelle: Threat Modeling Manifesto, 2020, threatmodelingmanifesto.org):
- Woran arbeiten wir? Sie zeichnen das System: seine Teile, seine Daten und wie sie zusammenhängen.
- Was kann schiefgehen? Sie sammeln Bedrohungen, etwa mit der Methode STRIDE.
- Was tun wir dagegen? Für jede Bedrohung entscheiden Sie: beheben, verringern, vermeiden oder akzeptieren.
- Haben wir gut genug gearbeitet? Sie prüfen das Diagramm und testen, ob die Maßnahmen wirken.
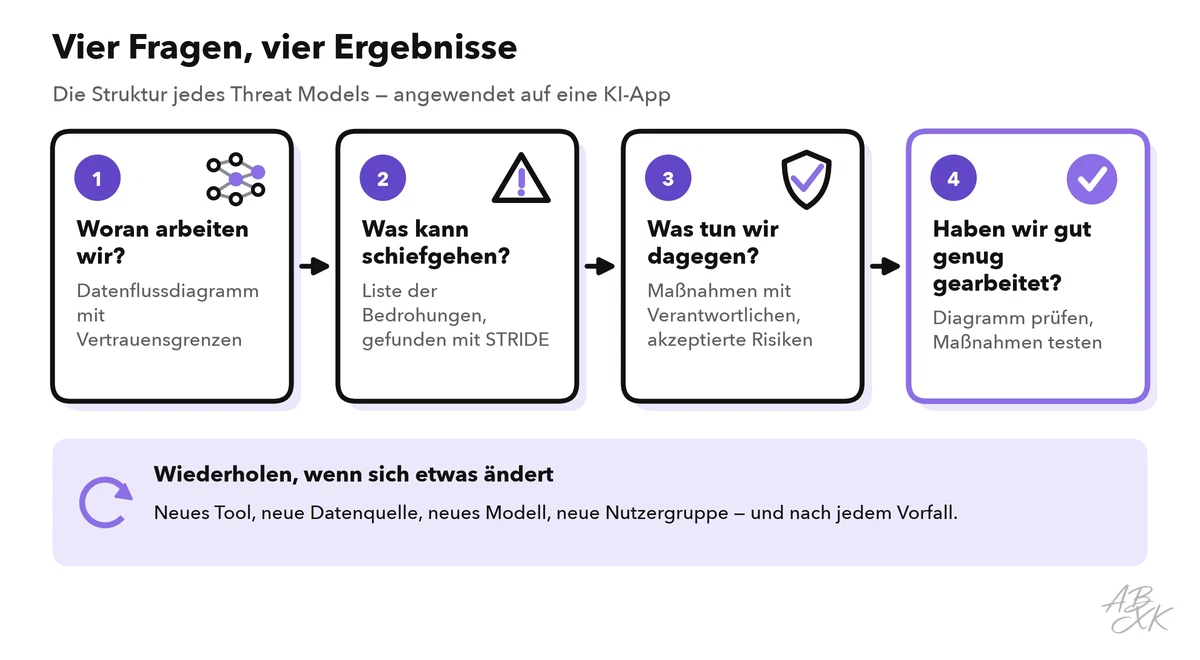
Der beste Zeitpunkt ist die Entwurfsphase, solange eine Änderung nur ein paar Zeilen in einem Dokument kostet. Wiederholen Sie die Übung, sobald sich das System spürbar ändert: ein neues Tool, eine neue Datenquelle, ein neues Modell oder eine neue Nutzergruppe. Eine kleine Runde genügt: jemand, der die App baut, jemand aus der IT-Sicherheit und die Person, die für die Daten verantwortlich ist.
Schritt 1: Das System und seine Vertrauensgrenzen zeichnen
Beginnen Sie mit einem Datenflussdiagramm. Es zeigt vier Arten von Elementen: Personen und externe Systeme, die Daten senden oder empfangen, Prozesse, die Daten verarbeiten, Datenspeicher und die Datenflüsse dazwischen. Unser Beispiel-Assistent arbeitet so: Kundinnen und Kunden schreiben im Chat oder per E-Mail. Die App durchsucht Hilfeartikel und interne Notizen in einer Vektordatenbank — das ist Retrieval-Augmented Generation (RAG). Sie schickt die Frage und die gefundenen Texte über eine API an ein LLM und kann über Tools Bestellungen nachschlagen, Tickets anlegen und Erstattungen vorbereiten.
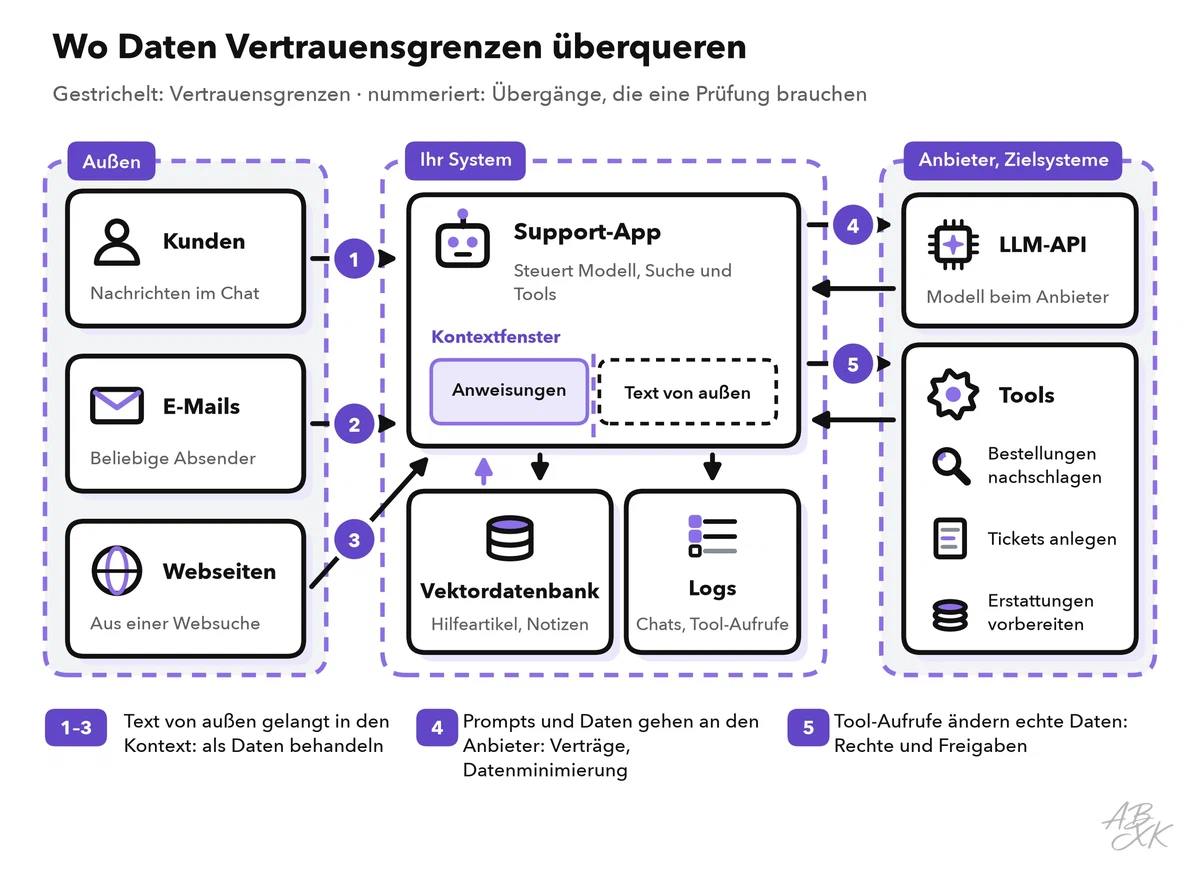
Markieren Sie dann die Vertrauensgrenzen (Trust Boundaries). Eine Vertrauensgrenze ist eine Linie, an der Daten von einer Vertrauensstufe in eine andere wechseln: aus dem Internet in Ihre App, aus Ihrer App zu einem externen Anbieter oder von einem Teil, der nur liest, zu einem Teil, der etwas verändern kann. An jedem Übergang brauchen Sie eine Prüfung: Wer schickt das? Was darf es enthalten? Was darf es auslösen?
Listen Sie danach die Assets auf, also die schützenswerten Werte — das, was ein Angreifer haben möchte oder was Schaden anrichtet, wenn es ausfällt:
- Kunden- und Bestelldaten, interne Notizen und Dokumente,
- Geheimnisse wie API-Schlüssel sowie der System-Prompt,
- die Aktionen der Tools, etwa Erstattungen und E-Mails,
- das Modell und seine Einstellungen, bei eigenem Betrieb auch die Modelldateien,
- Logs und Chatverläufe, das Nutzungsbudget und der Ruf Ihres Unternehmens.
Jede Komponente, die Sie hinzufügen, wird zu einem Kasten im Diagramm, mit eigenen Daten und eigenen Zugriffsrechten — zum Beispiel eine Vektordatenbank wie Pinecone oder eine Plattform zum Bauen von Agenten wie Devs.ai oder MindStudio. Plattformen wie Airia legen nach Angaben des Anbieters eine gemeinsame Kontrollschicht über Agenten, Modelle, Tools und Datenzugriffe. Eine solche Plattform ersetzt das Threat Model nicht; sie ist ein weiterer Kasten im Diagramm.


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Eine Grenze ist bei KI-Systemen besonders: Sie verläuft mitten durch den Prompt. Das Kontextfenster des Modells — alles, was es auf einmal sieht — mischt Ihre vertrauenswürdigen Anweisungen mit nicht vertrauenswürdigem Text: einer Kundennachricht, einer E-Mail, einer Webseite, einem gefundenen Dokument. Das Modell kann Anweisungen und Daten nicht zuverlässig auseinanderhalten; deshalb funktioniert Prompt Injection. Behandeln Sie alles, was von außen in den Kontext gelangt, als nicht vertrauenswürdig — und ebenso alles, was das Modell ausgibt.
Schritt 2: Bedrohungen mit STRIDE finden
STRIDE ist eine Checkliste mit sechs Bedrohungsarten, die Ingenieure bei Microsoft Ende der 1990er-Jahre entwickelt haben. Sie funktioniert auch für KI-Systeme, weil sie nach Eigenschaften fragt — Identität, Integrität, Nachweisbarkeit, Vertraulichkeit, Verfügbarkeit und Berechtigungen — und nicht nach einer bestimmten Technik. Gehen Sie jedes Element und jeden Übergang Ihres Diagramms durch und stellen Sie die sechs Fragen:
| Bedrohung | Klassische Frage | In einer LLM-App | Typische Maßnahme |
|---|---|---|---|
| Spoofing (Identität vortäuschen) | Kann sich jemand als jemand anderes ausgeben? | Eingeschleuster Text gibt sich als Anweisung des Admins oder des Systems aus | Nutzer in der App authentifizieren, nie im Prompt; Inhalte von außen als Daten kennzeichnen |
| Tampering (Manipulation) | Kann jemand Daten oder Code verändern? | Vergiftete Hilfeartikel, manipulierte Trainingsdaten, eine ausgetauschte Modelldatei | Schreibrechte auf Quellen begrenzen, Hashes und Signaturen |
| Repudiation (Abstreitbarkeit) | Kann jemand eine Aktion abstreiten? | Niemand kann sagen, welche Eingabe den Agenten zu einer Erstattung gebracht hat | Logs mit Nutzer, Prompt-Version, gefundenen Dokumenten und Tool-Aufrufen |
| Information Disclosure (Datenabfluss) | Können Daten nach außen gelangen? | Der Assistent verrät die Bestellung eines anderen Kunden, interne Notizen oder den System-Prompt | Rechtefilter bei der Suche, keine Geheimnisse im Prompt, Prüfung der Ausgaben |
| Denial of Service (Ausfall) | Kann jemand das System lahmlegen? | Riesige Eingaben oder endlose Agenten-Schleifen verbrennen das Token-Budget | Ratenlimits, Token-Budgets, Schrittlimits |
| Elevation of Privilege (Rechteausweitung) | Kann jemand Rechte erlangen, die ihm nicht zustehen? | Eine in einer E-Mail versteckte Anweisung bringt den Agenten dazu, das Erstattungs-Tool für einen Fremden zu nutzen | Minimale Rechte, die Rechte des Nutzers selbst, menschliche Freigabe |
Zwei weitere Quellen helfen zu prüfen, ob Ihre Liste vollständig ist. Die OWASP Top 10 für LLM-Anwendungen nennen die häufigsten Risikoklassen, von Prompt Injection bis zum unbegrenzten Ressourcenverbrauch. MITRE ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems) ist eine öffentliche Wissensdatenbank mit Taktiken und Techniken von Angreifern gegen KI-Systeme, samt echten Fallstudien. Sie ist nach dem Vorbild des bekannten Frameworks MITRE ATT&CK aufgebaut (Quelle: MITRE ATLAS, atlas.mitre.org).
STRIDE hat außerdem einen blinden Fleck: Ein KI-System kann Schaden anrichten, ganz ohne Angreifer. Erfundene Fakten, unfaire Antworten und schädliche Inhalte gehören auf dieselbe Liste, auch wenn niemand „angreift“.
Schritt 3: Die Angriffsflächen erfassen
Eine Angriffsfläche ist jede Stelle, an der jemand von außen Daten oder Anweisungen in Ihr System bringen kann. Bei einer LLM-App zählen vor allem sechs:
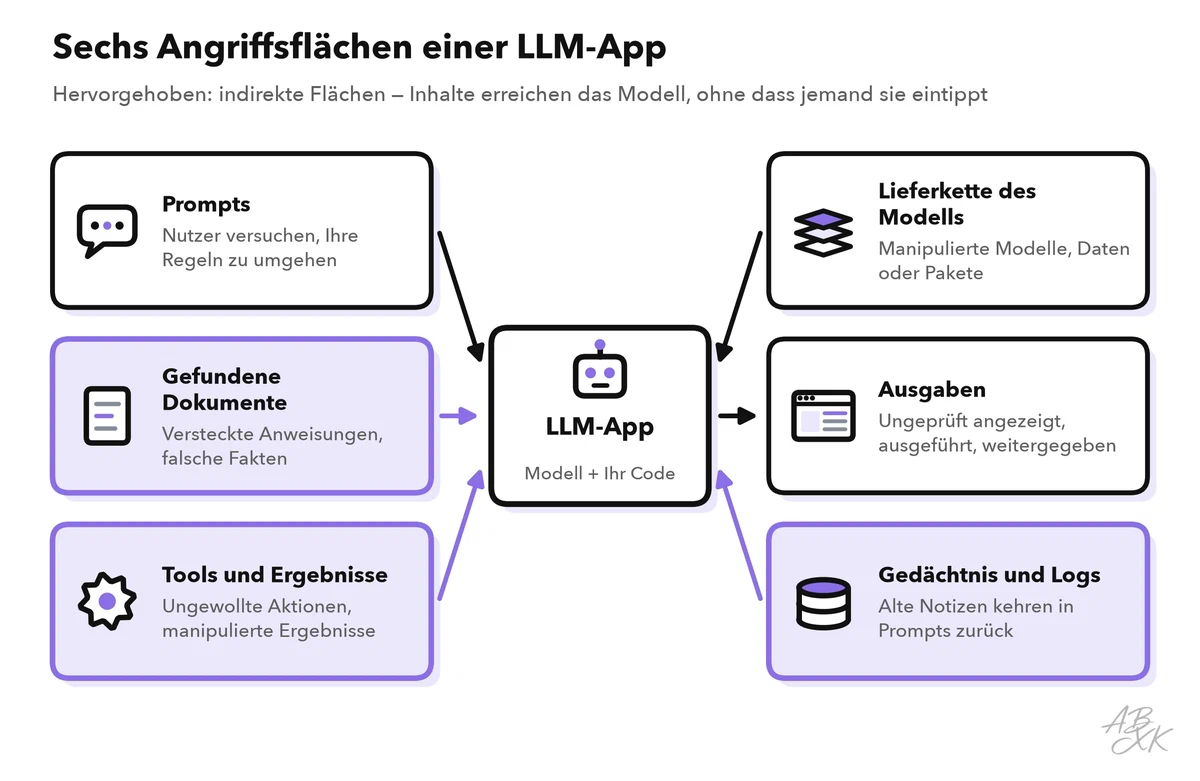
- Prompts: direkte Eingaben der Nutzer, auch Versuche, Ihre Regeln zu umgehen.
- Gefundene Dokumente: Inhalte in der Wissensbasis oder im Web können versteckte Anweisungen oder falsche Fakten enthalten. Wer in eine Quelle schreiben kann, schreibt auch in Ihren Prompt.
- Tools und ihre Ergebnisse: Jedes Tool ist eine Aktion, die das Modell auslösen kann, und jedes Tool-Ergebnis ist eine neue, nicht vertrauenswürdige Eingabe.
- Die Lieferkette des Modells: Modelldateien, Datensätze, Pakete und Plugins von außen. Teil 4 dieses Levels behandelt die Sicherheit der KI-Lieferkette.
- Ausgaben: Text, den Ihre App als Webseite anzeigt, als Code ausführt oder an ein anderes System weitergibt.
- Gedächtnis und Logs: gespeicherte Gespräche und Notizen, die in spätere Prompts zurückfließen.
Die indirekten Flächen vergessen Teams am häufigsten. Ein Kunde kann nur in den Chat tippen. Ein Angreifer dagegen kann eine E-Mail schicken, die der Assistent später liest, oder eine öffentliche Webseite ändern, die der Assistent bei einer Suche findet.
Schritt 4: Risiken bewerten und ordnen
Sie werden mehr Bedrohungen finden, als Sie auf einmal beheben können. Ordnen Sie sie deshalb. Eine einfache Skala reicht: Bewerten Sie die Wahrscheinlichkeit (Wie leicht ist der Angriff? Kommen Außenstehende an diese Fläche heran?) und die Auswirkung (Welche Daten, welches Geld, welche Sicherheit stehen auf dem Spiel? Lässt sich der Schaden rückgängig machen?) jeweils als niedrig, mittel oder hoch.
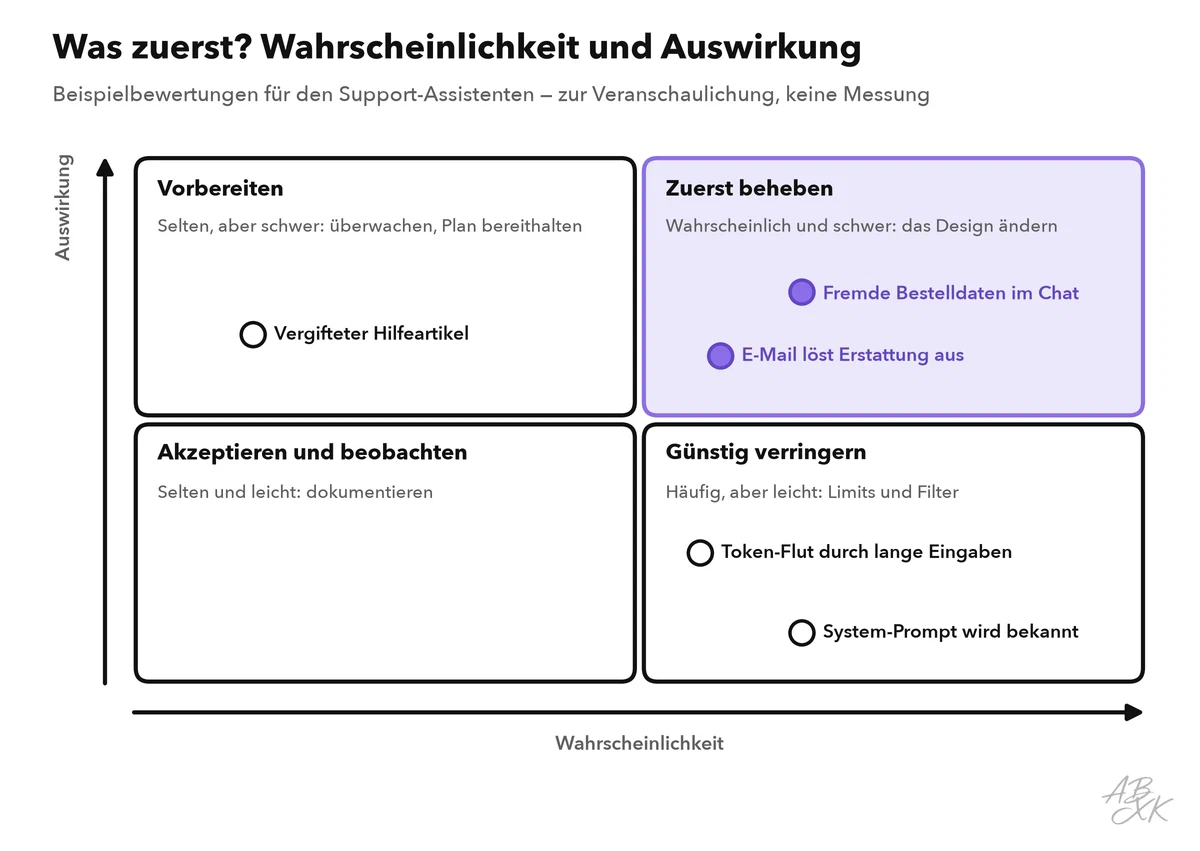
Drei Regeln machen die Reihenfolge nützlich:
- Beheben Sie zuerst, was wahrscheinlich und folgenreich ist. Bei unserem Assistenten ist das eine in einer E-Mail versteckte Anweisung, die zu einer Erstattung führt.
- Ändern Sie lieber das Design, als Filter zu stapeln. Eine Fähigkeit wegzunehmen wirkt besser als jeder Filter, der schädliche Anweisungen erkennen soll. Kann der Assistent eine Erstattung nur vorbereiten und ein Mensch gibt sie frei, verliert eine versteckte Anweisung den größten Teil ihrer Wirkung.
- Halten Sie fest, was Sie akzeptieren. Ein bekannt gewordener System-Prompt kann ein vertretbares Risiko sein, wenn er keine Geheimnisse enthält. Jedes akzeptierte Risiko braucht eine verantwortliche Person und einen Termin für die nächste Prüfung.
Das Ergebnis ist ein kleines Risikoregister: eine Zeile pro Bedrohung mit Bewertung, gewählter Maßnahme, verantwortlicher Person und Test. Teil 2 dieses Levels macht aus den obersten Zeilen Maßnahmen für RAG und KI-Agenten, und Teil 3 zeigt, wie Red Teaming prüft, ob diese Maßnahmen halten.
Typische Fehler in Threat Models für KI
Schwache Threat Models scheitern meist auf dieselben wenigen Arten. Prüfen Sie Ihres anhand dieser Liste; die Sicherheits-Tools unseres Vergleichs finden Sie im Bereich AI Security.
| Fehler | Warum er schadet | Besser |
|---|---|---|
| Das Modell als vertrauenswürdige Komponente behandeln | Eingeschleuster Text kann es steuern, und seine Ausgabe kann einen Angriff transportieren | Ein- und Ausgaben des Modells als nicht vertrauenswürdige Daten behandeln |
| Nur das Chatfenster modellieren | E-Mails, Dokumente, Webseiten und Tool-Ergebnisse bleiben ungeprüft | Jede Quelle einbeziehen, die ins Kontextfenster gelangt |
| Sich für die Sicherheit auf den System-Prompt verlassen | „Verrate niemals X“ ist eine Bitte an das Modell, keine Kontrolle | Regeln im Code durchsetzen: Rechte, Filter, Freigaben |
| Kosten und Verfügbarkeit vergessen | Eine Schleife oder eine Flut langer Eingaben kann das Budget aufbrauchen | Token-Budgets, Ratenlimits und Schrittlimits |
| Ein Workshop und dann nie wieder | Neue Tools und neue Modelle verändern die Risiken | Das Threat Model nach jeder relevanten Änderung und nach Vorfällen aktualisieren |
| Niemand ist für ein Risiko verantwortlich | Bekannte Probleme bleiben offen | Ein Name und ein Prüftermin pro Zeile |