

In Teil 1 dieses Levels hat das Threat Model unseres Support-Assistenten zwei Risiken nach oben gesetzt: eine in einer E-Mail versteckte Anweisung, die eine Erstattung auslöst, und eine Antwort, die die Bestellung eines anderen Kunden zeigt. Beide entstehen aus demselben Design. Der Assistent liest Inhalte, denen er nicht trauen kann, er sieht private Daten, und er kann handeln. Dieser Teil zeigt, wie Sie diese Fähigkeiten so bauen, dass aus einem Fehler des Modells kein Vorfall wird.
Dies ist Teil 2 von Level 3 (Profi) im Lernpfad AI Security. Sie lernen, wie Sie Rechte auf Dokumentebene bei der Suche durchsetzen, Tools nur minimale Rechte geben, Code in Sandboxen isolieren, Freigaben gestalten, Ausgaben prüfen und Audit-Logs führen. Der Teil baut auf Threat Modeling für KI-Systeme aus Teil 1 auf. Wie RAG und Agenten grundsätzlich funktionieren, erklärt unser Bereich AI Development.
Das Modell ist keine Sicherheitsgrenze
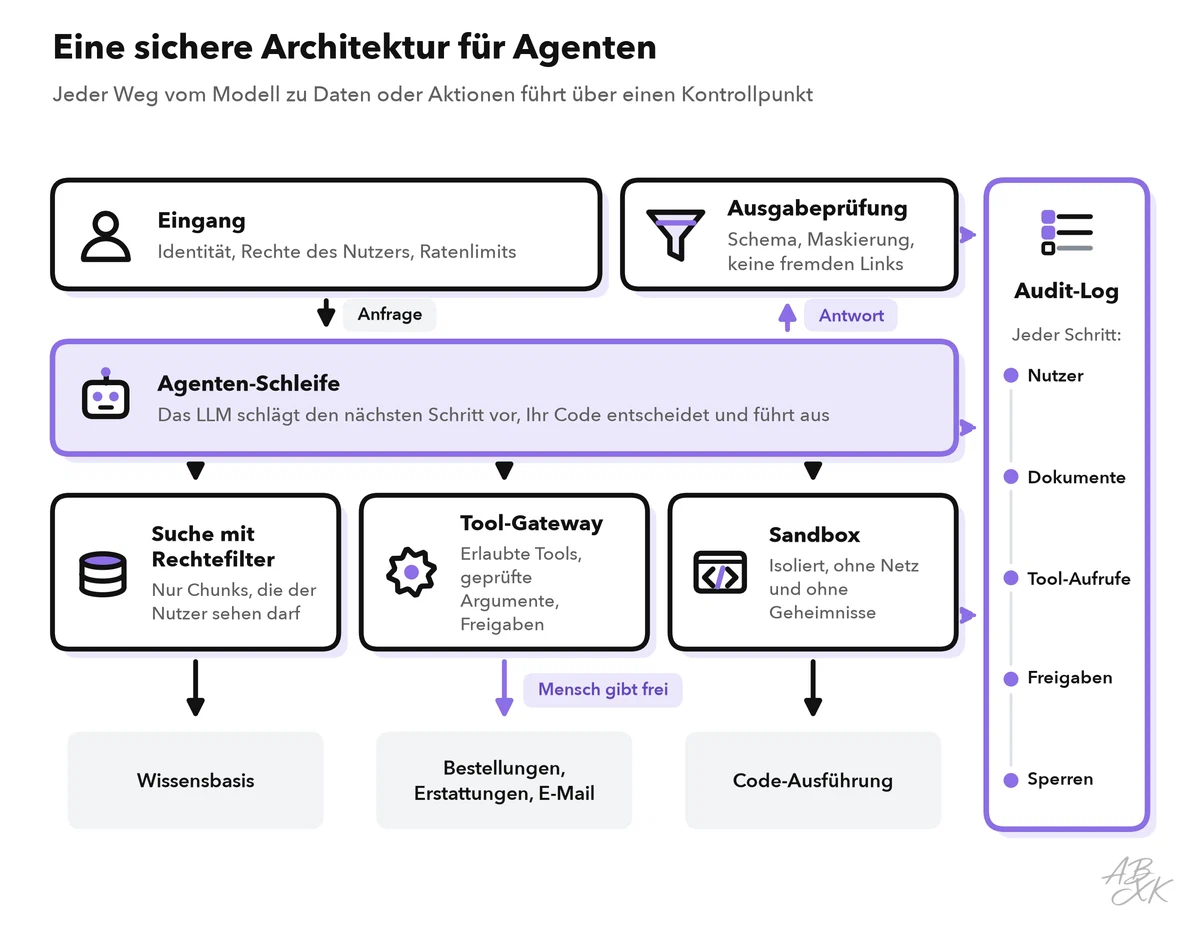
Die wichtigste Regel steht am Anfang: Verlassen Sie sich für die Sicherheit nie auf das Modell. Ein Modell folgt den Anweisungen in seinem Kontext, und es kann Ihre Anweisungen nicht zuverlässig von Anweisungen unterscheiden, die ein Angreifer in einem Dokument versteckt hat. Das ist der Kern von Prompt Injection. Jede Sicherheitsentscheidung muss deshalb in Ihrem Code fallen, außerhalb des Modells: welche Daten das Modell sehen darf, welche Tools es aufrufen darf und welche Aktionen einen Menschen brauchen.
Das Sicherheitsteam von Meta hat daraus eine einfache Designregel gemacht, die Agents Rule of Two. Teil 1 von Level 2 hat sie als Schnelltest aus der OWASP-Liste genutzt; hier bestimmt sie das Design. Innerhalb einer Sitzung soll ein Agent höchstens zwei von drei Eigenschaften haben: (A) Er verarbeitet nicht vertrauenswürdige Eingaben, (B) er hat Zugriff auf sensible Systeme oder private Daten, (C) er kann Zustände ändern oder nach außen kommunizieren. Braucht eine Aufgabe alle drei, soll der Agent nicht allein handeln. Er braucht mindestens eine Aufsicht: eine menschliche Freigabe oder eine andere verlässliche Prüfung (Quelle: Meta, „Agents Rule of Two: A Practical Approach to AI Agent Security“, 2025, ai.meta.com).
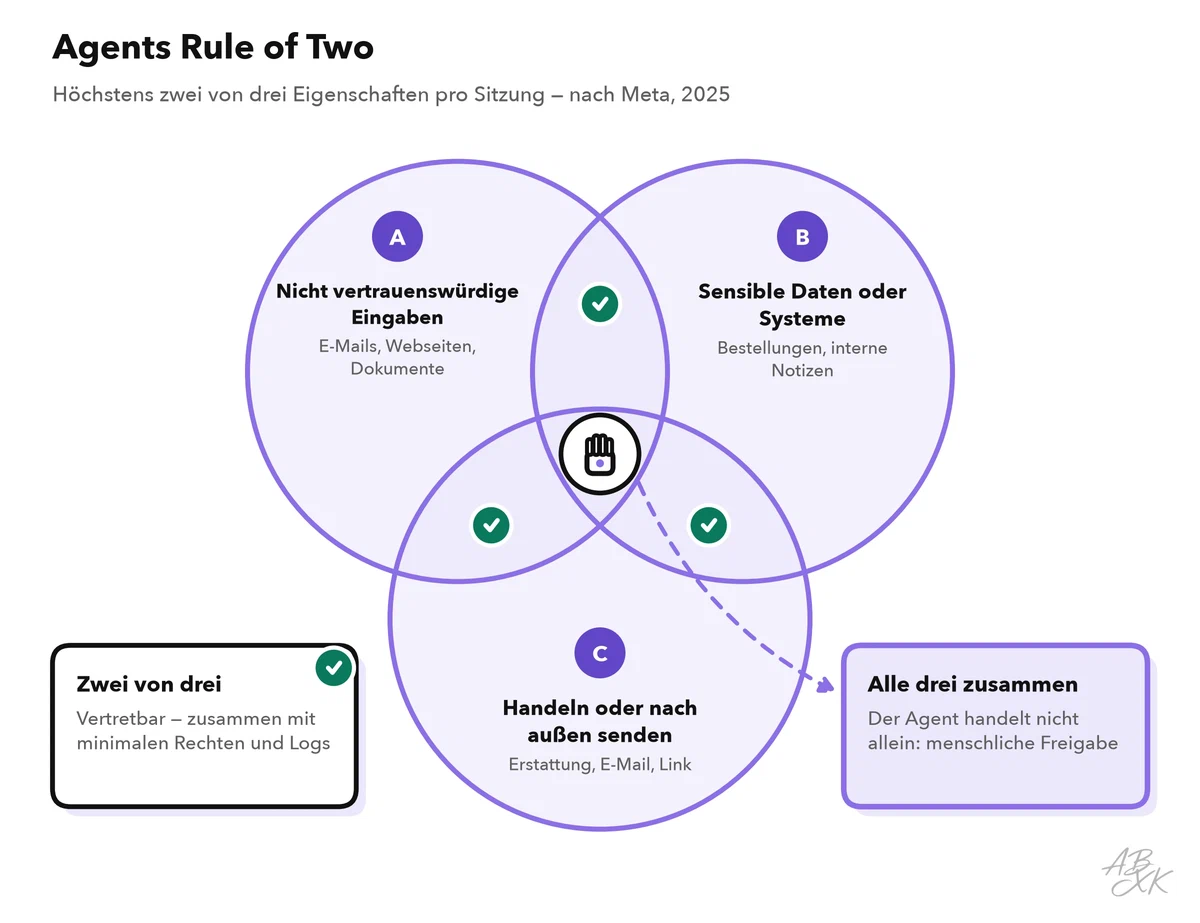
Unser Support-Assistent hat alle drei: Er liest Kunden-E-Mails (A), er sieht Bestellungen und interne Notizen (B), und er kann Erstattungen vorbereiten (C). Der Rest dieses Teils zeigt die Maßnahmen, die diese Kombination beherrschbar machen. Meta betont selbst, dass die Regel Grundprinzipien wie minimale Rechte nicht ersetzt, sondern ergänzt.
Rechte auf Dokumentebene bei der Suche
In einem RAG-System durchsucht ein Retriever die Wissensbasis und setzt die am besten passenden Textstücke, die Chunks, in den Prompt. Die Gefahr: Teilen sich alle Dokumente einen Index, liefert die Suche, was am besten passt — auch Chunks, die der Nutzer nicht sehen darf. Das Modell fasst sie dann höflich zusammen. Die OWASP Top 10 für LLM-Anwendungen führen dieses Risiko unter „Vector and Embedding Weaknesses“, Schwachstellen bei Vektoren und Embeddings (Quelle: OWASP Top 10 for LLM Applications 2026, genai.owasp.org).
Die Lösung: Setzen Sie die Rechte der Originaldokumente bei der Suche durch.
- Speichern Sie Zugriffsdaten mit jedem Chunk. Übernehmen Sie beim Indexieren die Zugriffsregeln des Dokuments: Eigentümer, Gruppen, Kunden- oder Mandanten-ID, Einstufung.
- Filtern Sie, bevor die Suche etwas zurückgibt. Ihr Code setzt die Identität des angemeldeten Nutzers als Filter in jede Abfrage. Das Modell sieht nie Chunks außerhalb dieses Filters und kann sie deshalb auch nicht verraten.
- Trennen Sie, was sich nie mischen darf. Nutzen Sie einen eigenen Index oder Namespace pro Kunde oder Mandant, wenn Daten strikt getrennt bleiben müssen.
- Halten Sie Rechte synchron. Verliert jemand den Zugriff auf ein Dokument oder wird es gelöscht, muss der Index schnell folgen — nicht erst beim nächsten monatlichen Neuaufbau.
- Kontrollieren Sie, wer schreiben darf. Wer ein Dokument in die Wissensbasis legen kann, kann Text in Ihren Prompt bringen. Prüfen Sie neue Quellen, und halten Sie eingehende E-Mails aus dem gemeinsamen Index heraus.
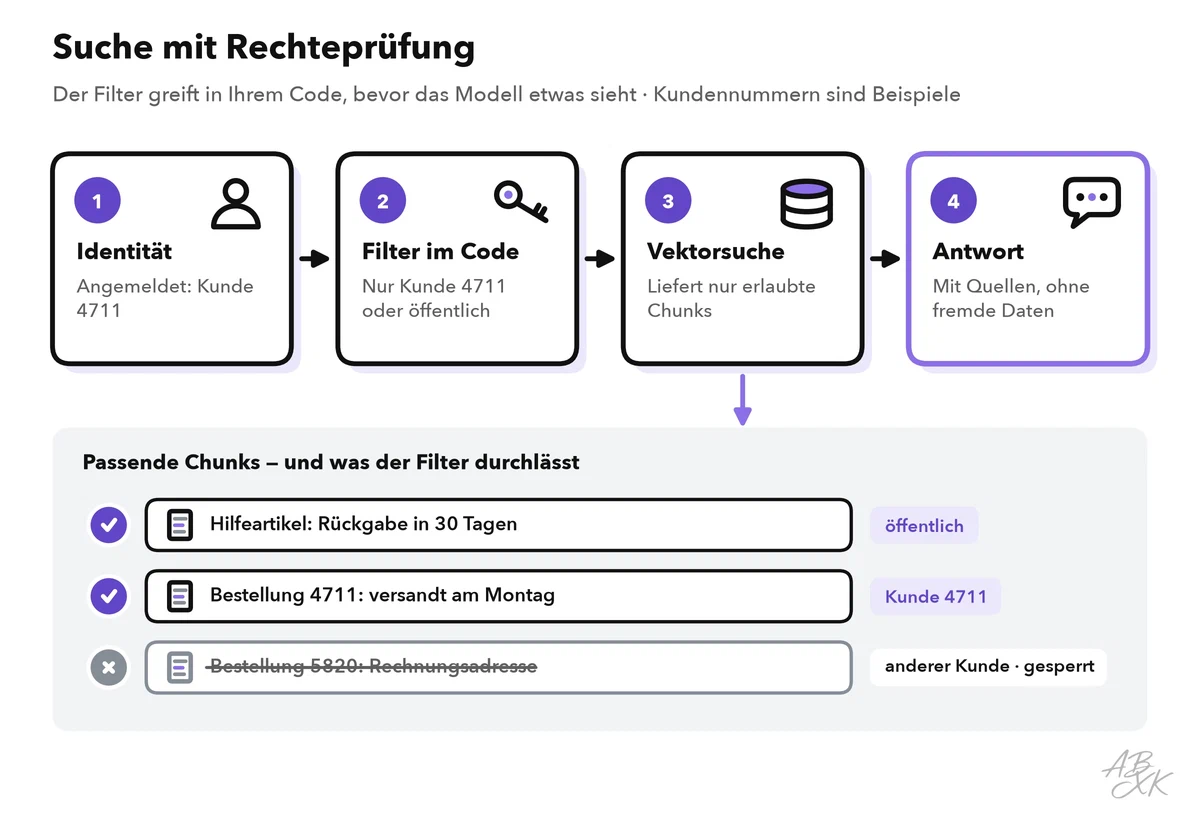
Nutzen Sie nicht das Modell als Filter. Eine Anweisung wie „nutze nur Dokumente, die dieser Nutzer sehen darf“ ist eine Bitte, keine Kontrolle — die Daten stehen dann schon im Kontext. Derselbe Gedanke gilt für die KI-Tools, die Ihre Beschäftigten täglich nutzen; Level 2 behandelt Schutz vor Datenabfluss bei KI-Tools.
Minimale Rechte für Tools
Jedes Tool macht aus Text eine Aktion. Teil 1 von Level 2 hat das daraus entstehende Risiko vorgestellt, Excessive Agency (übermäßige Handlungsmacht), samt seinen drei Ursachen: zu viele Funktionen, zu viele Rechte und zu viel Eigenständigkeit. Die Tabelle ordnet jeder Ursache eine Maßnahme zu und ergänzt zwei weitere Grenzen, die häufige Lücken schließen:
| Ursache | Beispiel beim Support-Assistenten | Maßnahme |
|---|---|---|
| Zu viele Funktionen | Das Ticket-Tool kann Tickets auch löschen | Nur die Funktionen anbieten, die die Aufgabe braucht: anlegen, nicht löschen |
| Zu viele Rechte | Das Bestell-Tool läuft mit einem Admin-Konto | Mit den Rechten des angemeldeten Nutzers oder einem eng begrenzten Schlüssel arbeiten |
| Zu viel Eigenständigkeit | Erstattungen gehen raus, ohne dass jemand hinsieht | Menschliche Freigabe für Aktionen mit Wirkung nach außen |
| Keine Grenzen für Argumente | Eine Erstattung über dem Bestellwert | Argumente im Code prüfen: höchstens der Bestellwert, nur die ursprüngliche Zahlungsart |
| Keine Grenzen für die Menge | Eine Schleife legt Hunderte Tickets an | Ratenlimits und ein Budget pro Sitzung |
Zwei Gewohnheiten helfen viel. Erstens: Geben Sie Tools eine enge, konkrete Form. prepare_refund(order_id) ist viel sicherer als ein allgemeines call_api(url, body). Zweitens: Verbieten Sie standardmäßig. Ein Tool, das der Agent nicht hat, kann er auch nicht missbrauchen.
Sandboxen für Code und Browsing
Manche Agenten schreiben und starten Code, nutzen eine Kommandozeile oder surfen im Web. Behandeln Sie diesen Code als nicht vertrauenswürdig, denn eine Prompt Injection kann ihn geformt haben. Führen Sie ihn in einer Sandbox aus — einer isolierten Umgebung, die begrenzt, was der Code erreichen kann:
- ein Container oder eine kleine virtuelle Maschine, die für die Aufgabe entsteht und danach gelöscht wird,
- standardmäßig kein Netzwerkzugriff oder nur zu einer Liste erlaubter Adressen,
- keine Geheimnisse, Tokens oder Zugangsdaten für Produktivsysteme in der Sandbox,
- ein schreibgeschütztes Dateisystem bis auf einen Arbeitsordner,
- Grenzen für Laufzeit, Speicher und Rechenleistung.
Führen Sie Code, den ein Modell geschrieben hat, nie direkt auf einem Entwickler-Laptop oder einem Produktivserver aus. Beim Browsing gilt die Rule of Two: Ein Agent, der beliebige Webseiten liest, sollte nicht zugleich private Daten halten und sie irgendwohin senden können.
Freigaben und Prüfung der Ausgaben
Die menschliche Freigabe ist die stärkste Kontrolle für Aktionen, die sich schwer rückgängig machen lassen. Sie wirkt aber nur, wenn sie gut gestaltet ist:
- Zeigen Sie die genaue Aktion: Empfänger, Betrag, vollständiger Text. Zeigen Sie nicht nur die Zusammenfassung des Modells, was es vorhat.
- Fragen Sie nur bei Aktionen, die zählen. Wer fünfzig Routineaktionen am Tag freigibt, liest irgendwann nicht mehr hin. Das nennt man Freigabemüdigkeit (Approval Fatigue).
- Lassen Sie die Freigabe außerhalb des Chats stattfinden, über eine Schaltfläche oder ein eigenes System, das das Modell nicht nachahmen kann.
Die Prüfung der Ausgaben ist die andere Hälfte. Die Ausgabe des Modells ist eine nicht vertrauenswürdige Eingabe für das nächste System. OWASP nennt dieses Risiko „Improper Output Handling“, also unsachgemäßen Umgang mit Ausgaben:
- Fordern Sie strukturierte Ausgaben an und prüfen Sie sie gegen ein Schema, bevor Sie danach handeln.
- Maskieren Sie Ausgaben des Modells, bevor Sie sie auf einer Webseite anzeigen, und geben Sie sie nie direkt an eine Datenbankabfrage, eine Shell oder eine
eval-Funktion weiter. - Blockieren Sie in Chat-Antworten Links und Bilder zu unbekannten Domains. Eine eingeschleuste Anweisung kann Daten in einer Linkadresse verstecken, und die Daten fließen ab, sobald der Browser das Bild lädt.
Audit-Logs: jeder Schritt nachvollziehbar
Wenn etwas schiefgeht, müssen Sie rekonstruieren können, was der Agent gesehen und getan hat. Protokollieren Sie jeden Schritt:
- wer die Sitzung gestartet hat (Nutzer-ID, möglichst pseudonymisiert) und wann,
- die Version von Modell und Prompt,
- die IDs der gefundenen Dokumente,
- jeden Tool-Aufruf mit Argumenten und Ergebnis,
- jede Freigabe mit dem Namen der Person, die freigegeben hat,
- jede Sperre durch einen Filter oder eine Guardrail.
Speichern Sie Logs zentral, schützen Sie sie vor Änderungen und stellen Sie sicher, dass der Agent selbst sie weder schreiben noch löschen kann. Logs enthalten personenbezogene Daten; begrenzen Sie daher den Zugriff und legen Sie eine Aufbewahrungsfrist fest. Teil 5 dieses Levels zeigt, wie diese Logs in die Incident Response für KI einfließen.
Plattformen können Teile dieser Arbeit übernehmen. Nach Angaben des Anbieters bietet Airia eine Kontrollschicht für Agenten, Modelle, Tools und Datenzugriffe, mit Richtlinien und Prüfnachweisen. Wenn Sie eine Vektordatenbank, einen Agenten-Baukasten oder eine Automatisierungsplattform auswählen — etwa Pinecone, MindStudio oder Turbotic aus unserem Vergleich —, prüfen Sie, ob das Produkt die Kontrollen aus diesem Teil unterstützt: Filter nach Nutzer oder Mandant, enge Tool-Rechte, Freigaben und exportierbare Logs. Unsere Tool-Beschreibungen stammen von den Anbietern; wir haben die Tools nicht getestet.


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Checkliste, bevor ein Agent live geht
Gehen Sie diese Liste vor dem Start durch und erneut nach jeder Änderung an Tools, Datenquellen oder Modell:
| Bereich | Prüfung | Erledigt, wenn |
|---|---|---|
| Rule of Two | Welche von A, B und C vereint der Agent? | Alle drei nur mit menschlicher Freigabe |
| Suche | Greifen die Rechte, bevor das Modell Daten sieht? | Ein Testnutzer findet keine Dokumente eines anderen Testkunden |
| Schreibzugriff | Wer kann Inhalte in die Wissensbasis legen? | Quellen sind geprüft; eingehende Mails liegen nicht im gemeinsamen Index |
| Tools | Bietet jedes Tool nur, was die Aufgabe braucht, mit den Rechten des Nutzers? | Keine Admin-Schlüssel; Argumente werden im Code geprüft |
| Sandbox | Läuft Code des Modells isoliert? | Standardmäßig kein Netzwerk, keine Geheimnisse, Zeitlimits |
| Freigaben | Welche Aktionen brauchen einen Menschen, und was sieht diese Person? | Die genaue Aktion wird gezeigt; Routineaktionen brauchen keinen Klick |
| Ausgaben | Wird die Ausgabe geprüft, bevor sie angezeigt oder weitergegeben wird? | Schema-Prüfung; keine Links oder Bilder zu unbekannten Domains |
| Logs | Lässt sich eine Sitzung rekonstruieren? | Dokumente, Tool-Aufrufe und Freigaben sind protokolliert und geschützt |