

Ein Red Team greift die Systeme der eigenen Organisation an — mit Erlaubnis und unter Kontrolle —, um Schwachstellen zu finden, bevor echte Angreifer oder unglückliche Nutzer darauf stoßen. Bei KI-Systemen ist die Idee dieselbe, nur die Ziele sind neu: ein Chatbot, den man zum Verraten von Daten überreden kann, ein Agent, der versteckten Anweisungen folgt, ein Modell, das schädliche oder unfaire Antworten gibt. Um solche Probleme zu testen, braucht es eigene Methoden, denn ein Sprachmodell verhält sich anders als gewöhnliche Software.
Dies ist Teil 3 von Level 3 (Profi) im Lernpfad AI Security. Sie lernen, wie Sie Ziele, Umfang und Regeln für eine Red-Team-Übung festlegen, welche Testkategorien Sie abdecken, wie manuelle und automatisierte Tests zusammenspielen und wie aus Befunden Korrekturen und Nachtests werden. Wir bleiben bei Methoden und Organisation; dieser Artikel enthält keine Angriffsanleitungen. Der Teil baut auf Jailbreaks und Guardrails aus Level 2 auf.
Was Red Teaming bei LLMs anders macht
Ein klassischer Penetrationstest sucht nach Fehlern, die es entweder gibt oder nicht. LLM-Anwendungen verhalten sich in vier Punkten anders:
- Die Ausgaben schwanken. Dieselbe Eingabe kann neunmal eine harmlose und beim zehnten Mal eine schädliche Antwort liefern. Ein einzelner bestandener Test beweist wenig.
- Die Angriffsfläche ist Sprache. Wer tippen kann, kann es versuchen, und kleine Änderungen im Wortlaut können das Ergebnis verändern.
- Der Schaden geht über Sicherheit hinaus. Neben Datenabfluss testen Sie auf schädliche Inhalte, unfaire Behandlung und erfundene Fakten.
- Es zählt das ganze System. Dasselbe Modell kann in einer App sicher und in einer anderen unsicher sein — je nach System-Prompt, gelesenen Dokumenten und verfügbaren Tools.
Deshalb verteilt der OWASP GenAI Red Teaming Guide, erschienen im Januar 2025, Red Teaming auf vier Bereiche: Model Evaluation (das Modell selbst), Implementation Testing (Prompts, Guardrails, Suche), Infrastructure Assessment (APIs, Schlüssel, Hosting) und Runtime Behavior Analysis (wie sich das laufende System mit echten Nutzern und Tools verhält) (Quelle: OWASP GenAI Red Teaming Guide, 2025, genai.owasp.org).
Ziele, Umfang und Spielregeln
Eine Red-Team-Übung beginnt mit Papierarbeit, nicht mit Prompts. Drei Entscheidungen schützen sowohl die Testenden als auch das Unternehmen.
Ziele. Welche Schäden sind für dieses Produkt am wichtigsten? Übernehmen Sie sie aus dem Threat Model. Für unseren Support-Assistenten lauten die Ziele: keine Daten anderer Kunden, keine Erstattungen durch Text von außen, keine schädlichen oder beleidigenden Antworten und keine erfundenen Regeln.
Umfang. Welches System, welche Version, welche Umgebung? Testen Sie in einer Staging-Umgebung mit synthetischen Kundendaten, nicht im Live-Betrieb mit echten Kunden. Behalten Sie die echten Tools, aber verbinden Sie sie mit Testsystemen: Das Erstattungs-Tool legt Erstattungen in einem Testshop an, nicht in Ihrem Zahlungssystem.
Spielregeln (Rules of Engagement). Das sind die schriftlichen Regeln für den Test:
- wer testen darf, in welchem Zeitraum und mit wessen schriftlicher Zustimmung,
- niemals echte personenbezogene Daten und niemals echte Zahlungen,
- wann abgebrochen wird: Tauchen echte Daten auf oder passiert eine echte Aktion, sofort stoppen und melden,
- wie Befunde gespeichert werden: Schädliche Ausgaben und funktionierende Testfälle sind heikel und brauchen einen beschränkten Zugriff,
- wie die Testenden geschützt werden: Schädliche Inhalte zu sichten belastet, also Aufgaben wechseln und Unterstützung anbieten.
Testkategorien
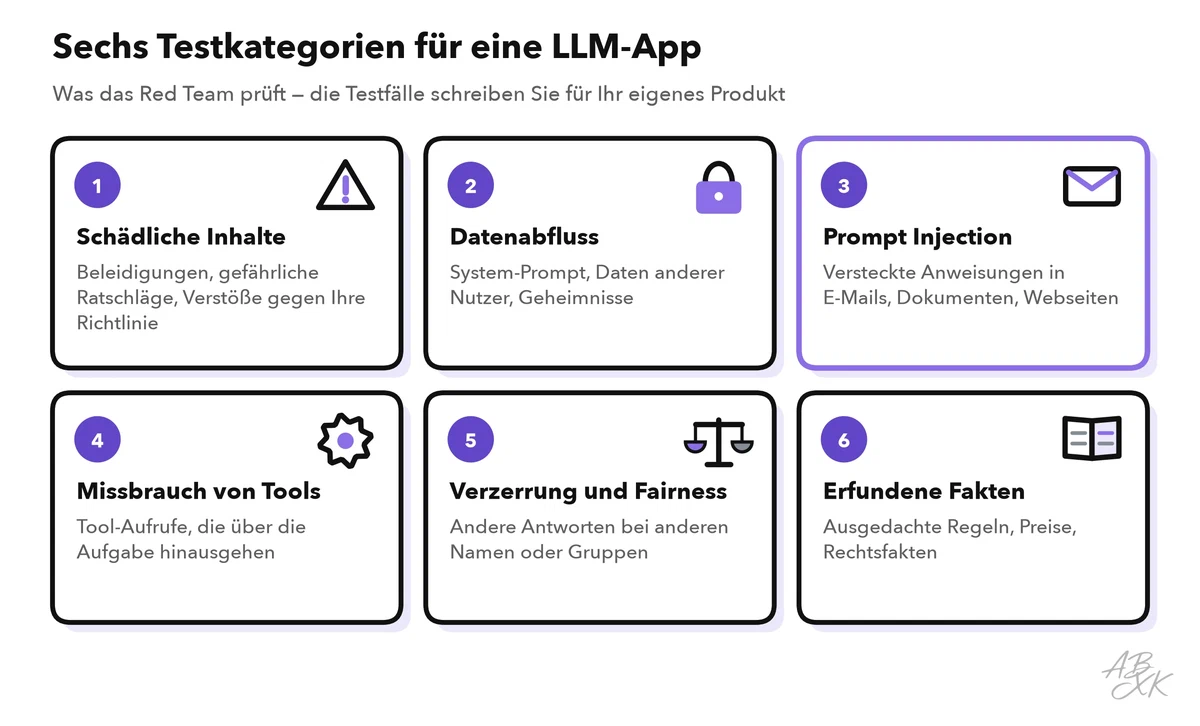
Die sechs Kategorien unten decken die wichtigsten Risiken einer typischen LLM-App ab. Jede braucht eigene Testfälle, geschrieben für Ihr Produkt:
| Kategorie | Was Sie testen | Beispiel für einen Befund | Typische Korrektur |
|---|---|---|---|
| Schädliche Inhalte | Erzeugt die App Inhalte gegen Ihre Richtlinie, etwa Beleidigungen oder gefährliche Ratschläge? | Eine umformulierte Anfrage bekommt eine Antwort, die die Richtlinie verbietet | Ausgabefilter, klarere Richtlinie, ein anderes Modell |
| Datenabfluss | Kommen Testende an den System-Prompt, an Daten anderer Nutzer oder an Geheimnisse? | Der Assistent zitiert eine interne Notiz | Rechtefilter, keine Geheimnisse im Prompt |
| Prompt Injection | Folgt die App Anweisungen, die in E-Mails, Dokumenten oder Webseiten versteckt sind? | Eine harmlose Testanweisung in einer Test-E-Mail verändert die Antwort | Inhalte als Daten behandeln, minimale Rechte, Freigaben |
| Missbrauch von Tools | Lässt sich das Modell zu Tool-Aufrufen über seine Aufgabe hinaus bringen? | Eine Erstattung wird ohne passende Bestellung vorbereitet | Argumente im Code prüfen, Freigaben |
| Verzerrung und Fairness | Ändern sich Antworten mit Namen, Geschlecht oder Herkunft? | Ein anderer Ton bei derselben Beschwerde | Testsätze mit getauschten Namen, menschliche Prüfung |
| Erfundene Fakten | Erfindet die App Regeln, Preise oder Rechtsfakten? | Eine Rückgabefrist, die es nicht gibt | Nur aus Quellen antworten, sie nennen, „weiß ich nicht“ zulassen |
Testen Sie außerdem Verfügbarkeit und Kosten: sehr lange Eingaben und Anfragen, die lange Agenten-Schleifen anstoßen. Solche Probleme machen selten Schlagzeilen, können aber Ihr Budget aufbrauchen.
Manuelle und automatisierte Tests
Beide Arten von Tests werden gebraucht, und sie erfüllen unterschiedliche Aufgaben:
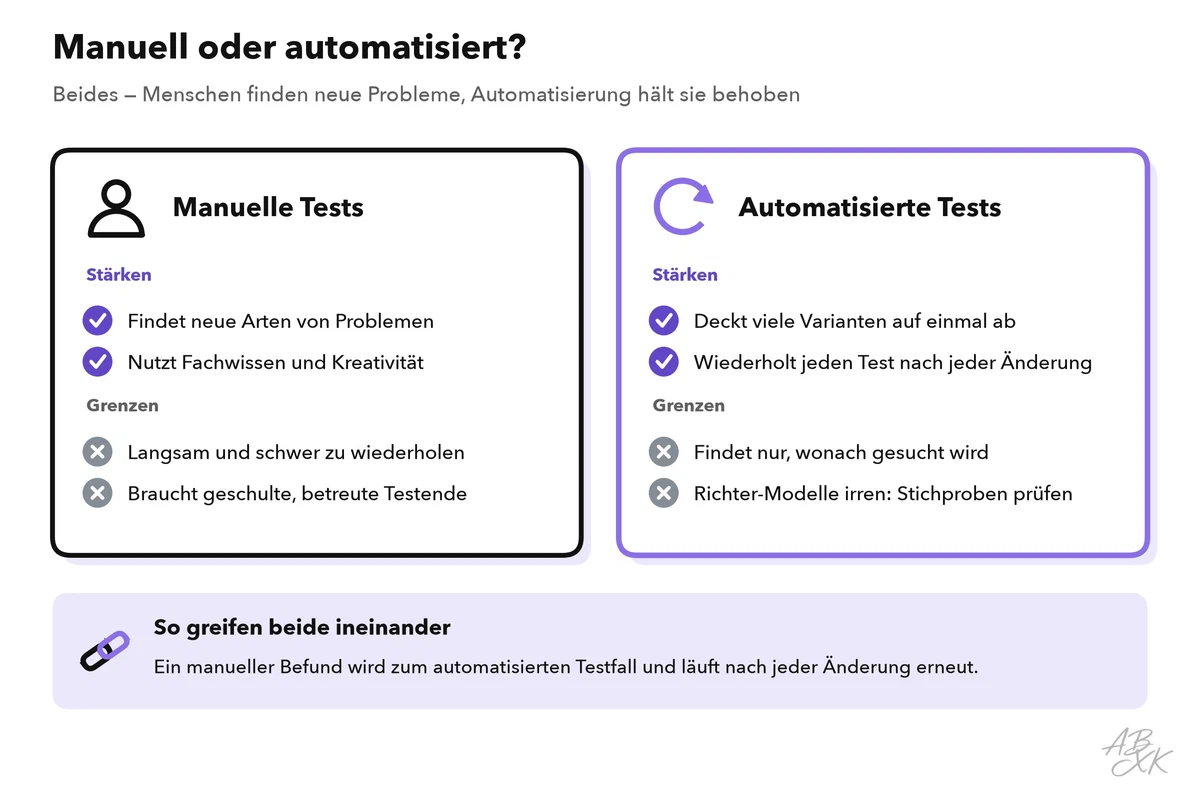
Manuelle Tests durch Menschen mit Sicherheitswissen und Fachkenntnis finden neue Arten von Problemen. Eine Support-Mitarbeiterin weiß, welche Fragen Kunden wirklich stellen; ein Sicherheitsingenieur weiß, wie Angreifer denken. Manuelle Tests sind kreativ, aber langsam und schwer zu wiederholen.
Automatisierte Tests schicken große Sätze von Testfällen an die App und bewerten die Antworten. Open-Source-Frameworks wie PyRIT von Microsoft und garak von NVIDIA helfen dabei. Oft bewertet ein zweites Modell als „Richter“ jede Antwort. Auch Richter irren sich; deshalb sollte ein Mensch eine Stichprobe ihrer Bewertungen prüfen.
Weil die Ausgaben schwanken, führen Sie jeden Testfall mehrmals aus und berichten eine Quote wie die Erfolgsquote von Angriffen aus Level 2 — etwa „der Assistent folgte der versteckten Testanweisung in 3 von 20 Versuchen“ — statt eines einfachen Ja oder Nein. Am besten kombinieren Sie beides: Menschen finden ein neues Problem, und das Team macht daraus automatisierte Testfälle, die nach jeder Änderung an Prompt, Modell, Tools oder Wissensbasis erneut laufen.
Vom Befund zur Korrektur: berichten, beheben, nachtesten
Ein Befund nützt nur, wenn jemand ihn nachstellen und beheben kann. Ein guter Befundbericht enthält:
- eine ID, die Testkategorie und eine Einstufung des Schweregrads,
- das betroffene System und die Version,
- die Schritte zum Nachstellen, mit beschränktem Zugriff gespeichert,
- das beobachtete und das erwartete Verhalten,
- wie oft der Fehler auftrat, zum Beispiel in 3 von 20 Versuchen,
- einen Korrekturvorschlag und eine verantwortliche Person.
Bewerten Sie den Schweregrad nach Auswirkung und Erreichbarkeit: Was kann ein Angreifer erreichen? Kommen Außenstehende an diesen Weg heran? Beheben Sie dann auf der richtigen Ebene. Eine Designänderung, etwa ein Tool zu entfernen oder eine Freigabe einzuführen, schlägt eine Rechteänderung. Eine Rechteänderung schlägt einen Filter, und ein Filter schlägt das Umformulieren des System-Prompts.
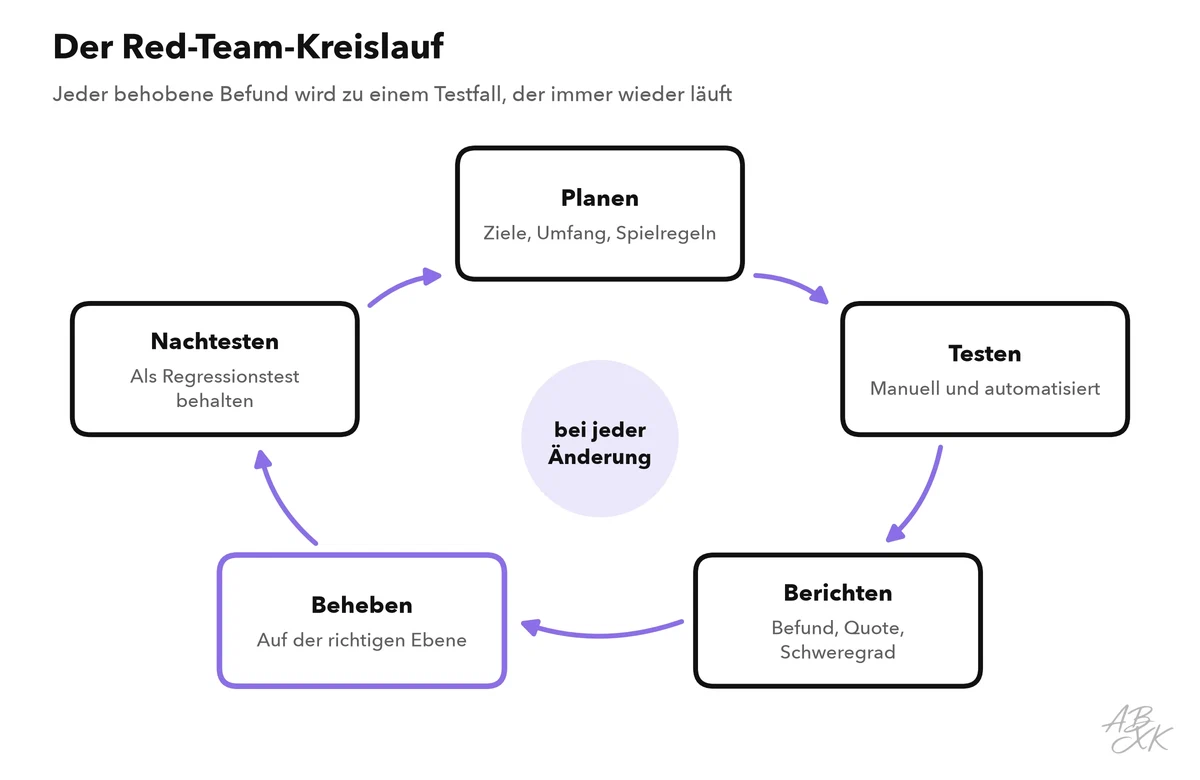
Testen Sie nach der Korrektur erneut: den ursprünglichen Testfall, Varianten davon und die ganze automatisierte Testsammlung, denn eine Korrektur an einer Stelle kann anderswo etwas kaputt machen. Testen Sie auch nach, wenn sich das Modell ändert. Eine neue Modellversion kann sich anders verhalten, selbst mit demselben Prompt.
Benchmarks wählen das Modell, Red Teaming prüft Ihr System
Öffentliche Benchmarks messen, was Modelle allgemein können. Level 1 hat einen davon in Halluzinationen als Sicherheitsrisiko vorgestellt: SimpleQA Verified, kurze Faktenfragen mit genau einer richtigen Antwort, beantwortet ohne Hilfsmittel. Sein Verlauf zeigt, warum erfundene Fakten in jeden Testplan gehören. Das beste Ergebnis in unseren LLM-Daten ist seit den ersten gemessenen Modellen gestiegen, hat die volle Punktzahl aber nicht erreicht:
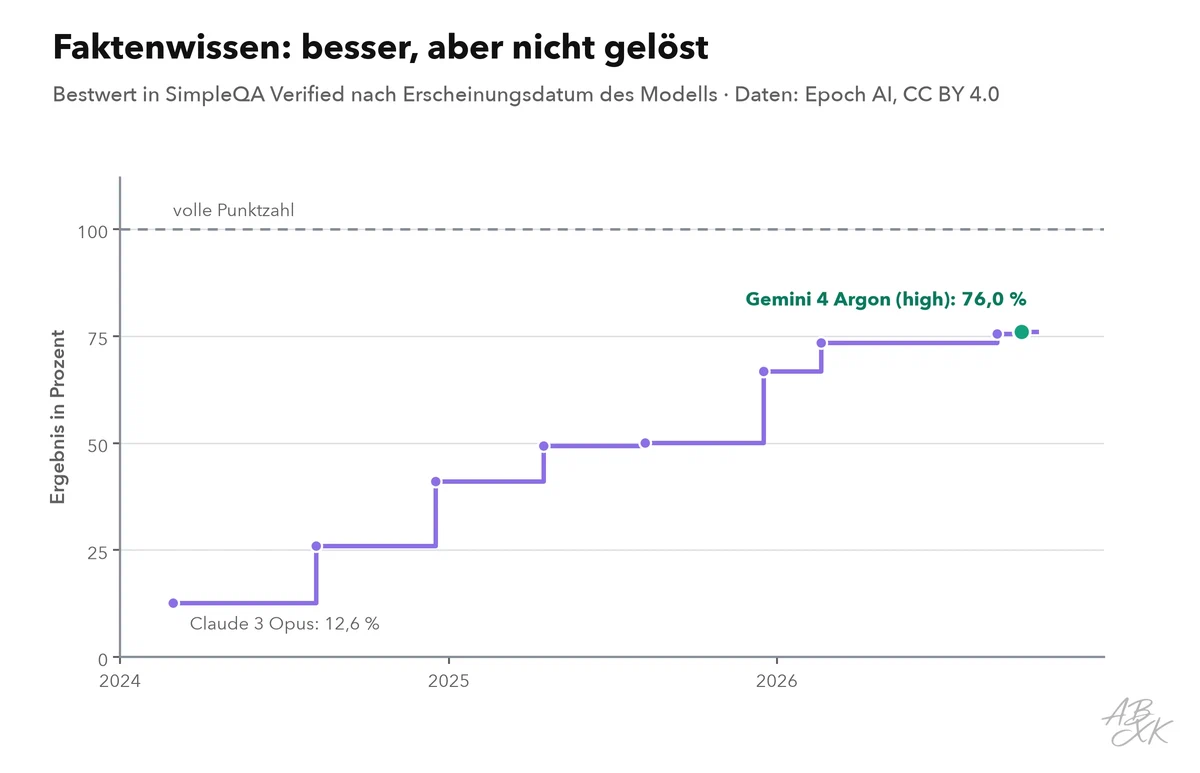
Ein Benchmark testet das Modell, nicht Ihr System. Er sagt nichts über Ihren System-Prompt, Ihre Dokumente, Ihre Tools oder Ihre Nutzer. Nutzen Sie Benchmarks, um ein Modell auszuwählen — alle Modelle stehen in unserer LLM-Datenbank —, und nutzen Sie Red Teaming, um zu testen, was Sie gebaut haben. Level 4 zeigt ausführlich, wie Sie Sicherheit und Zuverlässigkeit von Modellen bewerten.
Manche Plattformen bündeln Sicherheitstests mit anderen Kontrollen. Nach Angaben des Anbieters umfasst die Plattform von Airia Red Teaming neben Richtlinien und Prüfnachweisen. TestDriver.ai führt laut Anbieter Pull Requests in einer Sandbox aus und baut Regressionstests. Es testet Benutzeroberflächen, keine Angriffe auf LLMs, zeigt aber die Gewohnheit, auf die es ankommt: Jede Änderung wird getestet, bevor sie live geht. Keines der Tools wurde von uns getestet.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Eine erste Red-Team-Übung in einer Woche
Hat Ihr Team das noch nie gemacht, fangen Sie klein an. Dieser Plan passt für eine KI-Funktion in eine Woche:
| Tag | Aufgabe | Ergebnis |
|---|---|---|
| Montag | Ziele, Umfang und Spielregeln vereinbaren; Testumgebung mit synthetischen Daten aufsetzen | Unterschriebene Regeln, funktionierende Testumgebung |
| Dienstag | 20 bis 40 Testfälle aus dem Threat Model schreiben, alle sechs Kategorien abdecken | Testplan |
| Mittwoch | Manuell in Paaren testen: Eine Person testet, eine protokolliert | Rohbefunde |
| Donnerstag | Jeden Testfall mehrmals ausführen, wo möglich automatisiert; Befunde bewerten | Befunde mit Quoten und Schweregrad |
| Freitag | Ergebnisse vorstellen, Korrekturen und Verantwortliche festlegen, Testfälle in die Regressionstests aufnehmen | Korrekturliste, Regressionstests |
Planen Sie den Nachtest für die Woche nach den Korrekturen ein. Wiederholen Sie die Übung danach vor jedem größeren Release und immer dann, wenn Sie auf ein neues Modell wechseln.