

Teil 2 dieses Levels hat gezeigt, dass ein trainiertes Modell seine Trainingsdaten preisgeben kann: durch Membership Inference, Inversion oder wörtliche Extraktion. Namen aus einem Prompt zu entfernen — die Grundlagen aus unserem Ratgeber Persönliche Daten mit KI-Tools schützen — hilft dagegen nicht. Sie brauchen Techniken, die begrenzen, was ein Modell über eine einzelne Person lernen kann, oder die Daten selbst während der Verarbeitung verborgen halten. Zusammen heißen sie datenschutzfördernde Technologien (Privacy-Enhancing Technologies, PETs).
Dies ist Teil 3 von Level 4 (Experte) im Lernpfad AI Security. Sie erfahren, was Epsilon und ein Privacy-Budget bedeuten und was Federated Learning schützt und was nicht. Außerdem sehen Sie, wo sichere Enklaven und homomorphe Verschlüsselung passen und warum synthetische Daten nicht automatisch anonym sind. Der Onlineshop dieses Levels will ein besseres Betrugsmodell mit Kundendaten trainieren und mit Partnershops zusammenarbeiten. Am Ende wählen Sie für jedes seiner Ziele eine Technik.
Warum Namen entfernen nicht genügt
Auch Daten ohne Namen können auf eine Person zeigen. Eine klassische Studie schätzte, dass 87 % der US-Bevölkerung allein über Postleitzahl, Geschlecht und Geburtsdatum eindeutig zu erkennen waren (Quelle: Sweeney, „Simple Demographics Often Identify People Uniquely“, Carnegie Mellon University, 2000). 2008 identifizierten Forschende Personen in einem anonymisierten Datensatz mit Filmbewertungen, den Netflix veröffentlicht hatte, indem sie ihn mit öffentlichen Rezensionen abglichen (Quelle: Narayanan und Shmatikov, IEEE S&P 2008).
Das Recht trägt dem Rechnung. Wie Level 2 gezeigt hat, bleiben pseudonymisierte Daten — Namen durch Codes ersetzt — nach der DSGVO personenbezogen für alle, die die Codes wieder Personen zuordnen können. Nur wirklich anonyme Daten fallen nicht unter die Verordnung. Der Europäische Datenschutzausschuss wendet dieselbe Logik auf KI-Modelle an. Ein mit personenbezogenen Daten trainiertes Modell gilt nur dann als anonym, wenn die Wahrscheinlichkeit, personenbezogene Daten daraus zu gewinnen — direkt oder über Anfragen —, unerheblich ist. Das muss im Einzelfall nachgewiesen werden (Quelle: EDSA-Stellungnahme 28/2024, Dezember 2024, edpb.europa.eu).
Damit ändert sich die Frage. Sie lautet nicht mehr „Haben wir die Kennungen entfernt?“, sondern „Was kann jemand über eine einzelne Person aus unseren Daten, unserem Modell oder seinen Ausgaben erfahren?“ Differential Privacy beantwortet genau diese Frage mit einer Zahl.
Differential Privacy: eine Grenze für den Einfluss einer Person
Ein Verfahren ist differenziell privat (differentially private), wenn seine Ergebnisse fast gleich aussehen, ob die Daten einer einzelnen Person enthalten sind oder nicht (Quelle: Dwork, McSherry, Nissim und Smith, 2006). Der Parameter Epsilon (ε) legt fest, was „fast“ heißt: Für jedes mögliche Ergebnis darf die Wahrscheinlichkeit mit den Daten einer Person höchstens e^ε-mal so groß sein wie ohne sie. Ein kleineres ε bedeutet stärkeren Schutz.
Das älteste Beispiel zeigt die Idee. Bei Randomized Response, einer Umfragemethode aus den 1960er-Jahren, wirft jede befragte Person eine Münze, bevor sie eine heikle Frage beantwortet:
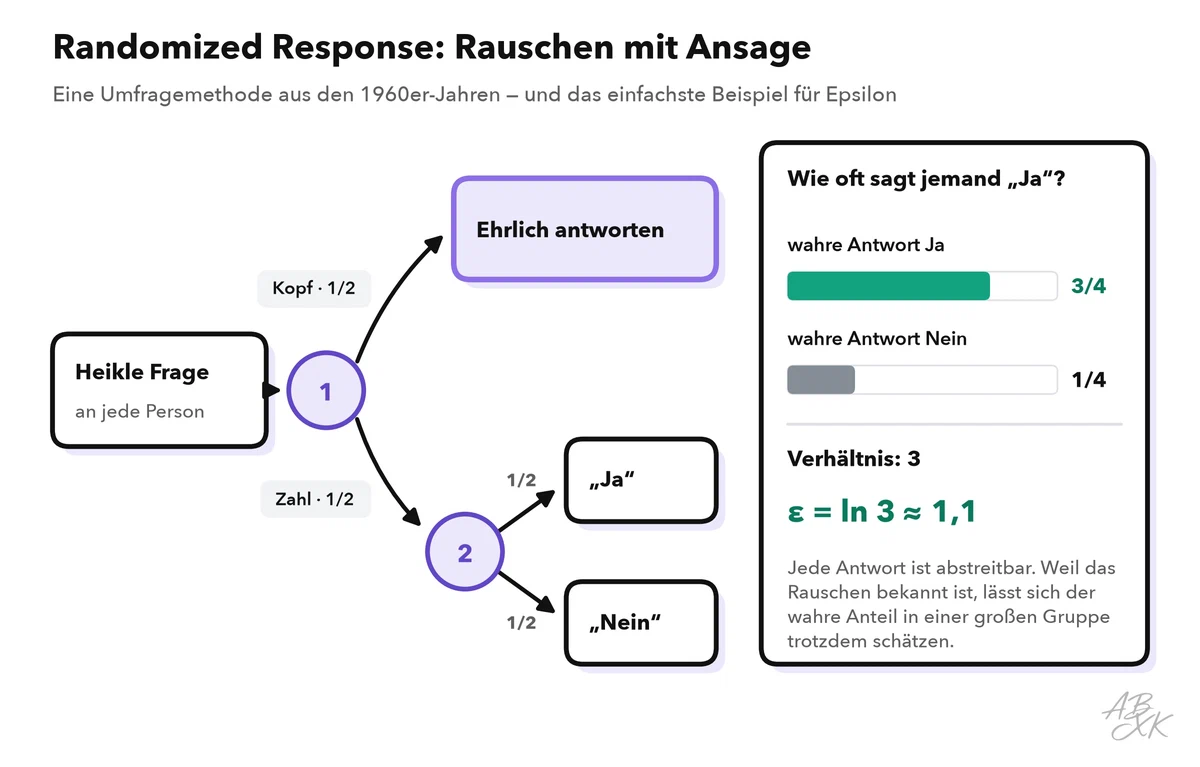
Mit fairen Münzen sagt eine Person, deren wahre Antwort „Ja“ ist, mit einer Wahrscheinlichkeit von 3/4 „Ja“. Eine Person, deren wahre Antwort „Nein“ ist, sagt mit einer Wahrscheinlichkeit von 1/4 „Ja“. Das Verhältnis ist 3, also ε = ln 3, etwa 1,1. Jede Person kann ihre Antwort abstreiten, aber das Rauschen ist bekannt, sodass sich der Anteil echter „Ja“-Antworten in einer großen Gruppe trotzdem schätzen lässt.
Daraus folgen drei Regeln für die Praxis:
- e^ε wächst schnell. Bei ε = 1 kann eine Person die Chancen eines Ergebnisses etwa um den Faktor 2,7 verschieben. Bei ε = 10 liegt der Faktor über 20.000 — die formale Garantie ist dann schwach.
- Jede Nutzung verbraucht Budget. Jede Abfrage und jeder Trainingslauf verbraucht einen Teil des Privacy-Budgets. In der einfachsten Rechnung addieren sich die Budgets: Zwei Abfragen mit je ε = 0,5 kosten zusammen ε = 1. Ist das Budget verbraucht, hören Sie auf oder akzeptieren eine schwächere Garantie.
- Die Einheit zählt. Schützt ε einen Datensatz oder eine Person mit vielen Datensätzen? NIST erklärt, wie man solche Zusagen bewertet, auch die Schutzeinheit und typische Fehler in Implementierungen (Quelle: NIST SP 800-226, Guidelines for Evaluating Differential Privacy Guarantees, März 2025, nist.gov).
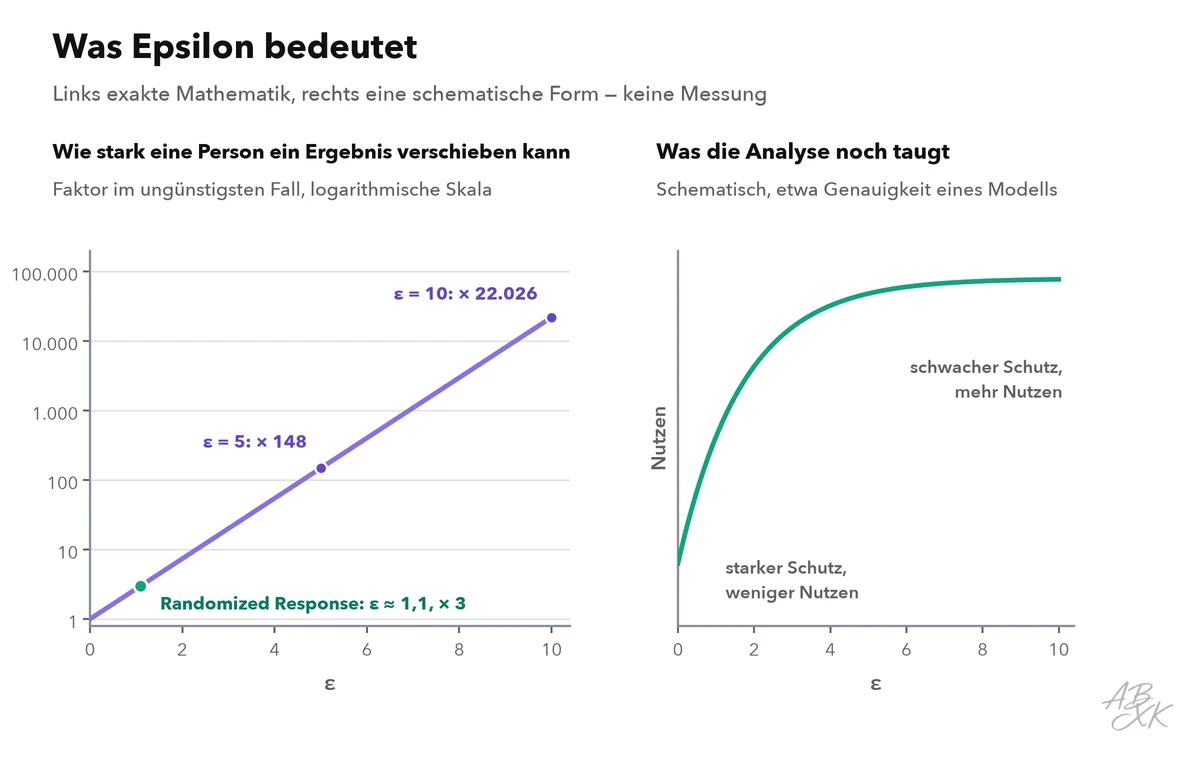
Für maschinelles Lernen begrenzt DP-SGD den Einfluss jedes Trainingsbeispiels und fügt beim Training Rauschen hinzu, sodass das fertige Modell differenziell privat ist (Quelle: Abadi et al., CCS 2016). Der Preis ist Genauigkeit, und er wird nicht gleichmäßig bezahlt: Seltene Gruppen und seltene Muster verlieren am meisten (Quelle: Bagdasaryan, Poursaeed und Shmatikov, NeurIPS 2019). Große Datenmengen mildern die Kosten. Differential Privacy ist im echten Einsatz: Das US Census Bureau hat sie auf die Ergebnisse des Zensus 2020 angewendet, und Apple und Google sammeln damit Nutzungsstatistiken von Geräten.
Federated Learning: trainieren, ohne die Daten einzusammeln
Federated Learning schickt das Modell zu den Daten statt die Daten zum Modell. Geräte oder Organisationen trainieren lokal eine Kopie und schicken nur Modell-Updates zurück; ein Server fasst sie zu einem neuen Modell zusammen (Quelle: McMahan et al., AISTATS 2017). Google nutzte diesen Ansatz, um die Wortvorschläge seiner Tastatur Gboard zu verbessern (Quelle: Hard et al., 2018).
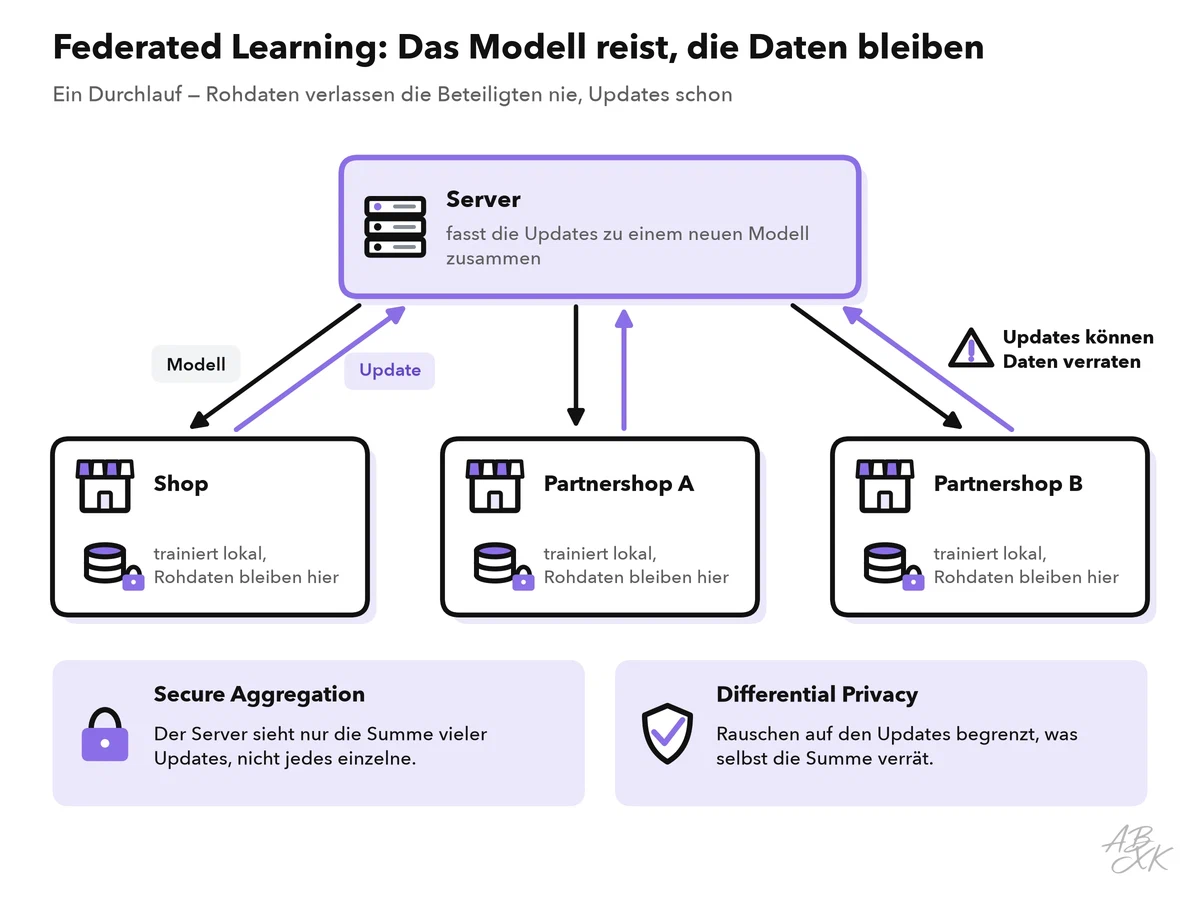
Federated Learning hält Rohdaten aus einem zentralen Speicher heraus. Das hilft, wenn Daten ein Gerät, ein Krankenhaus oder ein Land nicht verlassen dürfen. Privat wird das Ergebnis dadurch allein nicht:
- Updates verraten Daten. Forschende rekonstruierten Trainingsbilder und Texte aus geteilten Gradienten (Quelle: Zhu, Liu und Han, „Deep Leakage from Gradients“, NeurIPS 2019).
- Beteiligte können vergiften: Sie können das gemeinsame Modell manipulieren, wie in Teil 2 beschrieben.
- Die Daten der Beteiligten unterscheiden sich. Das Training wird langsamer, und das gemeinsame Modell passt zu manchen Beteiligten schlechter als zu anderen.
Zwei Ergänzungen schließen einen Teil der Lücke. Secure Aggregation sorgt dafür, dass der Server nur die Summe vieler Updates sieht, nicht jedes einzelne (Quelle: Bonawitz et al., CCS 2017). Differential Privacy auf den Updates begrenzt, was selbst die Summe verraten kann.
Daten in Verarbeitung schützen: Enklaven und homomorphe Verschlüsselung
Verschlüsselung schützt Daten meist im Ruhezustand und bei der Übertragung. Während der Verarbeitung liegen die Daten jedoch entschlüsselt im Speicher. Zwei Technologien setzen an dieser Lücke an.
Ein Trusted Execution Environment (TEE), auch sichere Enklave genannt, führt Code in hardwareseitig isoliertem Speicher aus, den selbst der Cloud-Betreiber nicht lesen kann. Remote Attestation belegt, welcher Code darin läuft. Dieser Ansatz heißt Confidential Computing. CPU-Technologien von Intel und AMD unterstützen ihn, ebenso aktuelle Rechenzentrums-GPUs von NVIDIA wie die H100. Apples Private Cloud Compute, 2024 vorgestellt, baut für KI-Anfragen auf ähnlichen Ideen auf. Die Grenzen: Sie vertrauen dem Hardwarehersteller, die Attestierung hilft nur, wenn Sie sie tatsächlich prüfen, und Seitenkanalangriffe haben Enklaven schon gebrochen (Quelle: Van Bulck et al., „Foreshadow“, USENIX Security 2018).
Homomorphe Verschlüsselung (HE) erlaubt Berechnungen direkt auf verschlüsselten Daten; nur wer den Schlüssel hat, kann das Ergebnis lesen. Vollständig homomorphe Verschlüsselung ist seit 2009 möglich (Quelle: Gentry, STOC 2009). Sie ist aber weiterhin weit langsamer als Rechnen auf Klartext, und viele Operationen in neuronalen Netzen lassen sich nur annähern. Heute passt sie zu eng umrissenen Aufgaben wie dem Scoring mit einem kleinen Modell — nicht zum Betrieb eines großen Sprachmodells in brauchbarer Geschwindigkeit. Mit sicherer Mehrparteienberechnung (Secure Multi-Party Computation) berechnen mehrere Parteien ein gemeinsames Ergebnis, ohne einander ihre Eingaben zu zeigen; auch sie verursacht hohen Rechen- und Kommunikationsaufwand.
Synthetische Daten: nützlich, aber nicht von selbst anonym
Synthetische Daten sind erzeugte Datensätze, die die Statistik echter Daten nachbilden. Sie sind nützlich für Tests, Entwicklung und Weitergabe. Der Generator lernt aber aus echten Datensätzen und kann sie wiedergeben, besonders ungewöhnliche. Eine Studie von 2022 kam zu dem Ergebnis, dass synthetische Daten keinen besseren Kompromiss zwischen Datenschutz und Nutzen bieten als klassische Anonymisierung und dass ihr Datenschutzgewinn schwer vorherzusagen ist (Quelle: Stadler, Oprisanu und Troncoso, USENIX Security 2022). Wenn Sie eine Datenschutzgarantie brauchen, trainieren Sie den Generator mit Differential Privacy und prüfen Sie seine Ausgaben auf kopierte Datensätze.
Eine Technik wählen: die Entscheidungen des Shops
Beginnen Sie beim Ziel, nicht bei der Technologie:
| Ziel | Technik | Schützt vor | Wichtigste Kosten |
|---|---|---|---|
| Statistiken über Kunden veröffentlichen | Differential Privacy für Abfragen | Re-Identifizierung aus Ergebnissen | Rauschen, Budgetverwaltung |
| Ein Modell trainieren, das keine Einzelpersonen auswendig lernen darf | DP-SGD | Membership Inference, Extraktion | Genauigkeit, besonders bei seltenen Fällen |
| Daten müssen bei ihren Eigentümern bleiben | Federated Learning mit Secure Aggregation | Zentrales Einsammeln der Daten | Updates verraten Daten, aufwendiger Betrieb |
| Die Cloud darf Daten bei der Verarbeitung nicht sehen | Confidential Computing (TEE) | Zugriff durch den Betreiber | Vertrauen in Hardware, Seitenkanäle |
| Rechnen, ohne je zu entschlüsseln | Homomorphe Verschlüsselung, Mehrparteienberechnung | Alle ohne Schlüssel | Sehr langsam, enge Aufgaben |
| Daten ohne echte Datensätze testen und teilen | Synthetische Daten, erzeugt mit DP | Offenlegung echter Datensätze | Weniger realistisch, Prüfung auf Kopien |
| Prompts im Haus behalten | Selbst betriebenes Modell mit offenen Gewichten | Zugriff durch den Modellanbieter | Eigene Sicherheit und eigener Betrieb |
Für den Shop ergeben sich daraus vier Entscheidungen. Für das Betrugsmodell passt DP-SGD schlecht: Betrug ist selten, und Rauschen schadet seltenen Mustern am meisten. Der Shop schützt es stattdessen mit strenger Zugriffskontrolle, sparsamen API-Ausgaben und regelmäßigen Tests auf Membership Inference. Die gemeinsamen Betrugssignale mit zwei Partnershops entstehen per Federated Learning mit Secure Aggregation. Das Betrugs-Dashboard für die Partner nutzt Differential Privacy mit einem festen Jahresbudget. Die Testdaten für die Entwicklung sind synthetisch, mit Differential Privacy erzeugt und auf kopierte Datensätze geprüft.
Die letzte Zeile der Tabelle braucht Infrastruktur. Unsere LLM-Datenbank führt 172 Modelle mit offenen Gewichten, die Sie selbst betreiben können. Nach Angaben des Anbieters vermietet Runpod GPUs auf Abruf für solche Aufgaben, und Airia sichert und regelt nach eigener Beschreibung Agenten, Modelle und Datenzugriffe in Unternehmen. Beide verschieben Vertrauen, statt es überflüssig zu machen — sie gehören deshalb in Ihr Threat Model. Teil 5 zeigt, wo diese Entscheidungen in einem Sicherheitsprogramm ihren Platz haben.



Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.