

Ein Chatbot, der Kunden antwortet, ein Assistent, der Ihre Dokumente durchsucht, ein Agent, der Termine bucht: Sie alle setzen ein großes Sprachmodell (Large Language Model, LLM) zwischen Menschen, Daten und Systeme. Dadurch entstehen Risiken, die klassische Sicherheits-Checklisten nicht abdecken. Das Modell befolgt Anweisungen, die in einer Webseite versteckt sind, gibt wieder, was es in einem Dokument gelesen hat, oder ruft eine Funktion auf, die niemand aufrufen wollte.
Dieser Artikel ist Teil 1 von Level 2 unseres Lernpfads AI Security. Level 1 hat einzelne Risiken erklärt, etwa Prompt Injection. Level 2 dreht sich um Abläufe und Qualitätskontrolle und beginnt mit der Landkarte: den OWASP Top 10 für LLM-Anwendungen. Sie lernen, was jedes der zehn Risiken bedeutet, und sehen zu jedem ein Beispiel und eine erste Gegenmaßnahme. Dann nutzen Sie die Liste als Checkliste, wenn Ihr Team eine LLM-Anwendung baut oder einkauft.
Was die OWASP-Liste ist und wie Sie sie lesen
OWASP, das Open Worldwide Application Security Project, ist eine gemeinnützige Stiftung, bekannt für ihre Top 10 für Webanwendungen. Das GenAI Security Project von OWASP veröffentlicht eine eigene Liste für Anwendungen, die auf LLMs aufbauen. Aktuell ist die Ausgabe 2026 vom August 2026. Sie hat die Ausgabe 2025 vom November 2024 abgelöst (Quelle: OWASP Top 10 for LLM Applications 2026, genai.owasp.org).
Jeder Eintrag beschreibt ein Risiko mit Beispielen und nennt Wege, es zu verringern. Die Liste ist kostenlos und stammt von Fachleuten aus der Praxis. Sie ist kein Gesetz und keine Norm, nach der Sie sich zertifizieren lassen können. Ihre Reihenfolge beruht auf einer Abstimmung unter Fachleuten und 2026 zum ersten Mal auch auf Daten aus Tausenden echter Vorfälle. Welches Risiko für Ihre Anwendung am meisten zählt, hängt davon ab, was sie lesen und tun kann.
Eine LLM-Anwendung ist jede Software, die Eingaben an ein Sprachmodell schickt und dessen Antwort verwendet: ein Chatbot, ein Assistent, der Dokumente durchsucht (Retrieval-Augmented Generation, kurz RAG), oder ein Agent, der Werkzeuge aufruft. Die Liste betrachtet das Modell als einen Baustein Ihrer Anwendung. Für Agenten, die über viele Schritte selbstständig handeln, hat OWASP im Dezember 2025 eine zweite Liste veröffentlicht, die Top 10 for Agentic Applications.
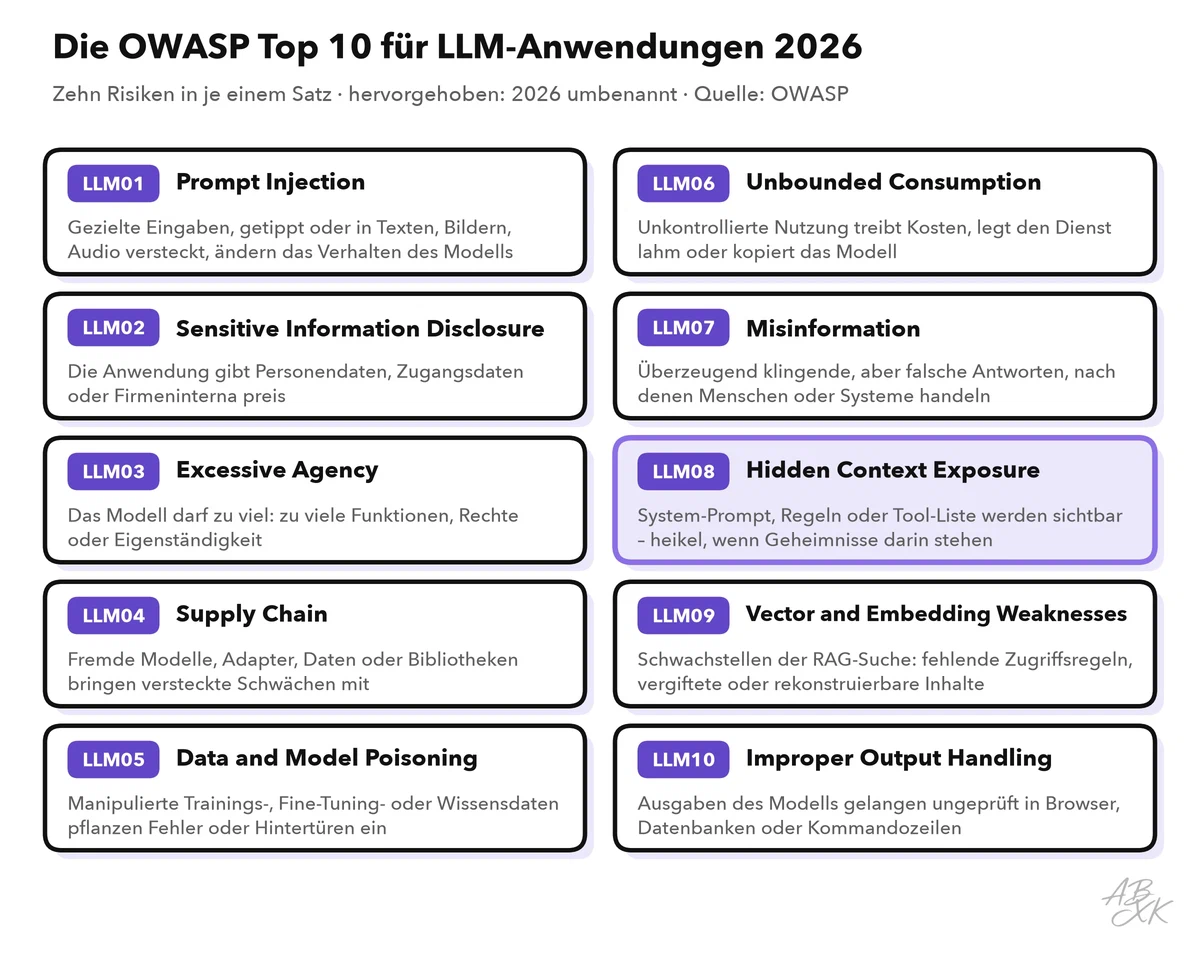
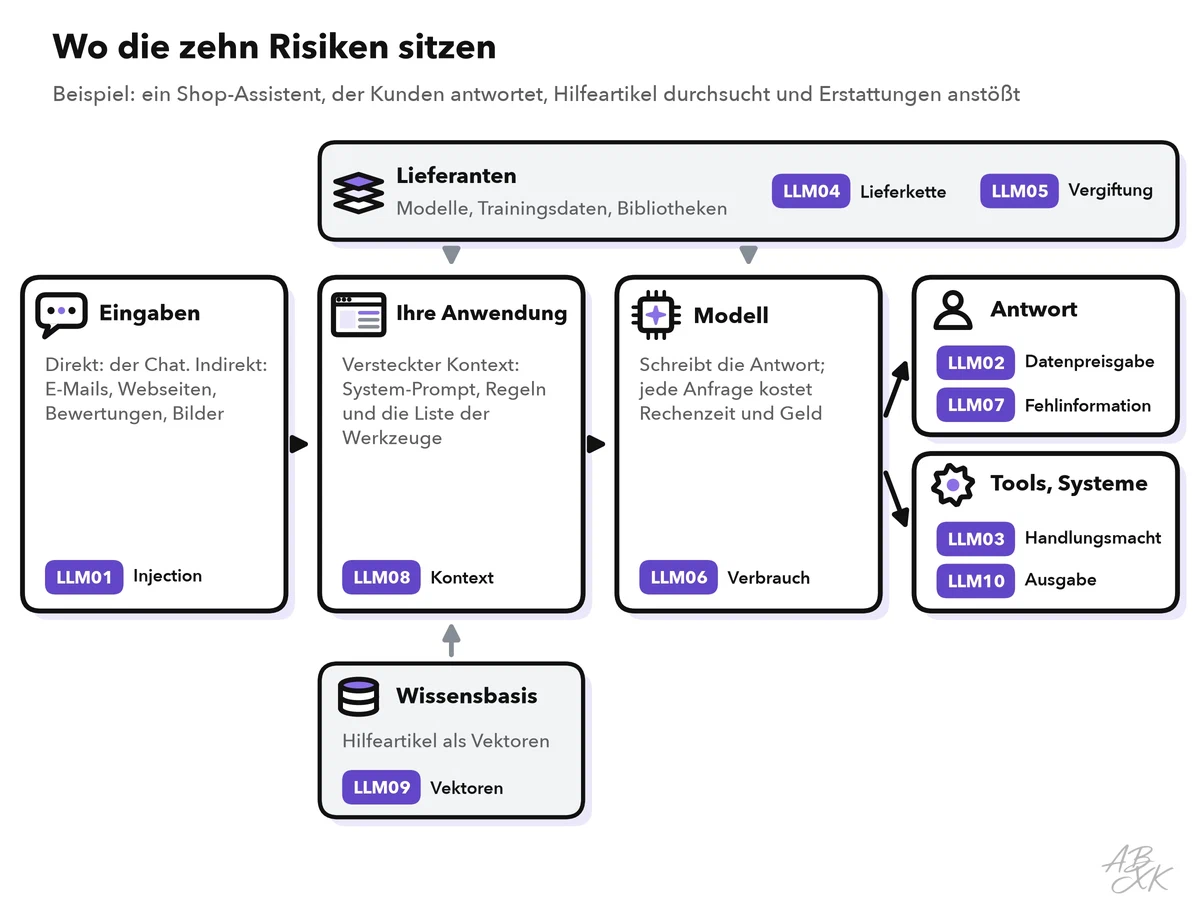
Damit die Risiken greifbar werden, nutzt dieser Artikel durchgehend ein Beispiel: einen Support-Assistenten für einen Onlineshop. Er beantwortet Kundenfragen im Chat, durchsucht die Hilfeartikel des Shops, schlägt Bestellungen nach und kann Erstattungen bis zu einer festen Grenze anstoßen. Die Tabelle zeigt, wie jedes Risiko diesen Assistenten treffen könnte, und eine erste Gegenmaßnahme:
| Risiko | So könnte es den Shop-Assistenten treffen | Erste Gegenmaßnahme |
|---|---|---|
| LLM01 Prompt Injection | Eine Produktbewertung enthält versteckte Anweisungen, die den Assistenten zu einer Erstattung bewegen sollen | Fremde Inhalte als Daten behandeln; jede Erstattung mit Regeln außerhalb des Modells prüfen |
| LLM02 Sensitive Information Disclosure | Der Assistent zeigt die Adresse einer anderen Kundin aus einer Bestellung | Bestellungen nur für den angemeldeten Kunden abrufen; Antworten auf Personendaten filtern |
| LLM03 Excessive Agency | Das Erstattungs-Tool kann auch Preise ändern und Bestellungen löschen | Werkzeugen nur die Funktionen und Rechte geben, die die Aufgabe braucht |
| LLM04 Supply Chain | Ein heruntergeladenes Modell oder eine Bibliothek enthält Schadcode | Geprüfte Quellen nutzen, Signaturen prüfen, ein Inventar führen |
| LLM05 Data and Model Poisoning | Jemand schmuggelt falsche Rückgaberegeln in die Hilfeartikel | Festlegen, wer die Wissensbasis ändern darf; Änderungen prüfen |
| LLM06 Unbounded Consumption | Ein Skript schickt nachts Tausende sehr lange Anfragen | Limits für Anfragen und Tokens, ein harter Kostendeckel |
| LLM07 Misinformation | Der Assistent erfindet eine Garantiefrist | Aus freigegebenen Quellen antworten und im Zweifel an Menschen übergeben |
| LLM08 Hidden Context Exposure | Die versteckten Anweisungen enthalten einen API-Schlüssel und die Rabattregeln | Keine Geheimnisse in Prompts; Regeln im Code durchsetzen |
| LLM09 Vector and Embedding Weaknesses | Interne Preisnotizen liegen im selben Suchindex wie öffentliche Hilfeartikel | Zugriffsrechte direkt in der Suche anwenden |
| LLM10 Improper Output Handling | Das Chatfenster führt ein Skript aus, das in die Antwort des Modells geraten ist | Ausgaben vor der Anzeige kodieren; nie ungeprüft ausführen |
Was sich 2026 geändert hat
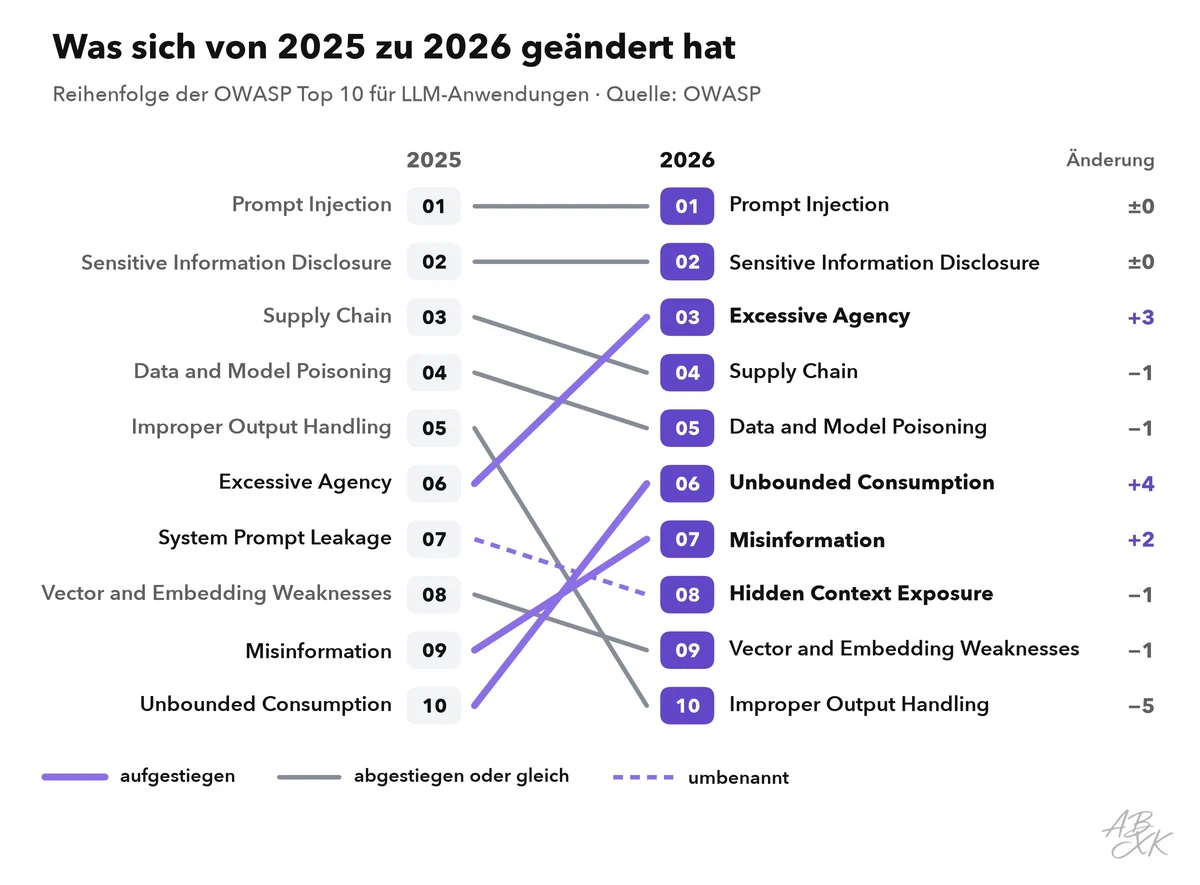
Kein Eintrag ist ganz neu, aber die Reihenfolge hat sich stärker verschoben als in früheren Ausgaben. Excessive Agency ist von Platz sechs auf Platz drei gestiegen. Laut OWASP sind sich Abstimmung und Vorfallsdaten einig, dass der Schaden heute vor allem bei Agenten entsteht. Misinformation ist aufgestiegen, weil die Vorfallsdaten dieses Risiko viel häufiger zeigten, als die Abstimmung erwarten ließ. System Prompt Leakage hat einen weiter gefassten Namen bekommen: Hidden Context Exposure. Nutzen Ihre Checklisten noch die Nummern von 2025, passen Sie sie an. LLM06 etwa stand 2025 für Excessive Agency und steht jetzt für Unbounded Consumption.
Risiken am Eingang: Prompt Injection und versteckter Kontext
LLM01 Prompt Injection steht weiter an der Spitze der Liste. Ein Angreifer formuliert Eingaben, die verändern, was das Modell tut. Bei einer direkten Injection tippt er sie in den Chat. Bei einer indirekten Injection steckt sie in Inhalten, die das Modell liest: einer Webseite, einer E-Mail, einer Produktbewertung, sogar einem Bild oder einer Audiodatei. OWASP zählt auch Jailbreaking zur Prompt Injection: Eingaben, die das Modell dazu bringen, seine Sicherheitsregeln zu ignorieren. Teil 3 dieses Levels behandelt Jailbreaks und Guardrails.
Kein Filter hält jede Injection auf, denn ein Modell unterscheidet technisch nicht zwischen Anweisungen und Daten. Gegen SQL-Injection gibt es eine saubere Lösung, parametrisierte Abfragen. Für LLMs gibt es laut OWASP kein solches Gegenstück. Deshalb liegt der wichtigste Schutz im Design. Die Projektleitung von OWASP sagt es deutlich: Bauen Sie das System so um das Modell herum, dass nichts Wichtiges kaputtgeht, wenn das Modell getäuscht wird – und das wird es. In der Praxis heißt das: Geben Sie dem Modell so wenige Rechte wie möglich, kennzeichnen Sie fremde Inhalte als Daten, prüfen Sie, was das Modell zurückgibt, und lassen Sie riskante Aktionen von einem Menschen freigeben.
LLM08 Hidden Context Exposure – die Preisgabe versteckten Kontexts. Jede LLM-Anwendung gibt dem Modell Informationen, die Nutzer nicht sehen: den System-Prompt mit Rolle und Regeln, interne Richtlinien und die Liste der Werkzeuge. Der alte Name, System Prompt Leakage, erfasste nur das Erste davon. Der Rat von OWASP: Gehen Sie davon aus, dass Nutzer das Modell dazu bringen können, all das preiszugeben, und nutzen Sie es nie als Geheimnis oder als Sicherheitskontrolle. Das eigentliche Problem ist, was Teams hineinschreiben: Passwörter, API-Schlüssel oder interne Regeln wie „Erstattungen bis 50 Euro ohne Prüfung“. Bewahren Sie Geheimnisse in einem sicheren Speicher auf und setzen Sie Regeln im Code durch, wo das Modell sie nicht wegdiskutieren kann.
Risiken in den Daten: Lecks, Vergiftung und Vektorspeicher
LLM02 Sensitive Information Disclosure – die Preisgabe vertraulicher Informationen – bleibt auf Platz zwei. Die Anwendung verrät, was sie nicht verraten soll: Personendaten, vertrauliche Geschäftszahlen, Zugangsdaten oder Details aus Trainingsdaten. Lecks können auch über Werkzeugaufrufe, Protokolle und gespeicherte Embeddings laufen. Eine Hauptursache ist laut OWASP zu breiter Zugriff, das sogenannte Oversharing: Der Assistent kann mehr lesen, als er sollte, etwa alle Bestellungen oder ein Laufwerk mit alten, zu weit gefassten Freigaben. Prüfen Sie Zugriffsrechte vor der Suche, geben Sie dem Modell nur die Daten, die die Aufgabe braucht, und filtern Sie Antworten auf Personendaten. Teil 2 dieses Levels zeigt Kontrollen gegen Datenabfluss bei KI-Tools.
LLM05 Data and Model Poisoning – die Vergiftung von Daten und Modellen. Jemand manipuliert die Daten, aus denen ein Modell lernt oder in denen es nachschlägt: Trainingsdaten, Daten für das Fine-Tuning oder die Dokumente einer Wissensbasis. Ein vergiftetes Modell kann sogar eine versteckte Hintertür (Backdoor) enthalten: Es verhält sich normal, bis ein bestimmter Auslöser auftaucht. In einer Studie von 2025, die OWASP zitiert, genügten 250 vergiftete Dokumente, um eine Hintertür einzubauen. Das galt für Modelle von 600 Millionen bis 13 Milliarden Parametern (Souly et al., 2025). Für die meisten Unternehmen betrifft das realistisch die eigenen Daten, etwa einen veränderten Hilfeartikel. Halten Sie fest, woher Daten stammen, regeln Sie, wer sie ändern darf, und testen Sie das Verhalten des Modells nach jedem Update.
LLM09 Vector and Embedding Weaknesses – Schwachstellen in Vektoren und Embeddings. RAG-Systeme verwandeln Dokumente in Embeddings, Zahlenreihen, die die Bedeutung erfassen, und speichern sie in einer Vektordatenbank. Die Suche liefert, was der Frage ähnelt – egal, wer es sehen darf, solange Sie das nicht einbauen. OWASP fasst es so zusammen: Vergiftung macht das System falsch, Inversion macht es undicht, Blockade macht es stumm, und fehlende Zugriffskontrolle macht es wahllos. Inversion heißt, aus Embeddings wieder Text zu gewinnen. Ein abgeflossenes Vektor-Backup zählt deshalb wie ein Leck der Dokumente selbst. Der wichtigste Schutz: Zugriffsrechte direkt in der Suchabfrage anwenden, nicht erst als Filter danach. Level 3 zeigt, wie Sie RAG und KI-Agenten absichern.
Risiken bei Aktionen und Ausgaben: Handlungsmacht, falsche Antworten, unsichere Verarbeitung
LLM03 Excessive Agency – zu viel Handlungsmacht. Ein Agent kann handeln: E-Mails senden, Datensätze ändern, Zahlungen anstoßen. OWASP nennt drei Ursachen: zu viele Funktionen, zu viele Rechte und zu viel Eigenständigkeit. Das Beispiel von OWASP ist ein E-Mail-Assistent, der Nachrichten nur lesen müsste, aber auch senden kann. Eine versteckte Anweisung in einer eingehenden E-Mail bringt ihn dazu, vertrauliche Nachrichten an einen Angreifer weiterzuleiten. Geben Sie jedem Werkzeug nur die Funktionen, die es braucht, lassen Sie es mit den Rechten des aktuellen Nutzers laufen und prüfen Sie jede Aktion gegen Regeln im Code. OWASP rät außerdem, Aktionen nach Risiko abzustufen: Ein Support-Chatbot darf eine Erstattung als Guthaben selbst freigeben, weil sie sich rückgängig machen lässt, eine Auszahlung auf ein externes Konto geht dagegen an einen Menschen.
LLM07 Misinformation – Fehlinformation. LLMs erzeugen falsche Aussagen, die überzeugend klingen. Zum Sicherheits- und Haftungsproblem wird das, wenn Menschen oder Systeme danach handeln. 2024 hat ein kanadisches Tribunal entschieden, dass Air Canada für falsche Auskünfte zu Trauerfall-Tarifen haftet, die der Chatbot auf seiner Website einem Kunden gegeben hatte (Moffatt v. Air Canada). Programmierassistenten schlagen manchmal Pakete vor, die es nicht gibt, und Angreifer können unter genau diesen Namen Schadsoftware veröffentlichen. Stützen Sie Antworten auf freigegebene Quellen, zeigen Sie die Quellen an und prüfen Sie eine Aussage, bevor ein System danach handelt.
LLM10 Improper Output Handling – die unsichere Verarbeitung von Ausgaben. Was das Modell ausgibt, ist für jedes System, das es empfängt, eine nicht vertrauenswürdige Eingabe. Reicht eine Anwendung die Ausgabe ungeprüft an einen Browser, eine Datenbank oder eine Kommandozeile weiter, kontrolliert, wer den Prompt kontrolliert, auch diese Systeme. Klassische Webangriffe wie Cross-Site-Scripting oder SQL-Injection kommen durch diese Tür zurück. Ein neuerer Fall: Das Chatfenster lädt ein Bild, dessen Webadresse Daten aus dem Gespräch an den Server eines Angreifers trägt. OWASP empfiehlt Zero Trust: Behandeln Sie das Modell wie jeden anderen Nutzer, kodieren Sie Ausgaben passend zu dem Ort, an dem sie erscheinen, und nutzen Sie parametrisierte Datenbankabfragen. Laden Sie Bilder oder Linkvorschauen aus Modellausgaben nicht automatisch. Platz zehn macht dieses Risiko nicht klein.
Risiken im Betrieb: Lieferkette und unbegrenzter Verbrauch
LLM04 Supply Chain – die Lieferkette. Eine LLM-Anwendung besteht aus Teilen anderer: Modellen, Adaptern, Datensätzen, Bibliotheken und Hosting. Jedes Teil kann Schwachstellen, unklare Lizenzen oder versteckte Manipulationen mitbringen. Heruntergeladene Modelldateien brauchen besondere Vorsicht, denn manche Dateiformate können beim Laden Code ausführen. Allein unsere LLM-Datenbank führt 172 Modelle mit offenen Gewichten, deren Modelldateien zum Download veröffentlicht sind. Nutzen Sie vertrauenswürdige Quellen, prüfen Sie Signaturen und Prüfsummen und testen Sie fremde Modelle für Ihren eigenen Einsatz. Eine Signatur belegt, woher eine Datei stammt, nicht, dass sie sicher ist. Führen Sie ein Inventar aller Bestandteile, eine Software Bill of Materials (SBOM). Für Modelle und Datensätze heißt sie oft AI BOM.
LLM06 Unbounded Consumption – unbegrenzter Verbrauch. Jede Anfrage kostet Rechenzeit und Geld. Ohne Grenzen kann eine Flut langer Anfragen den Dienst verlangsamen oder eine hohe Rechnung erzeugen; OWASP nennt das Denial of Wallet. Reasoning-Modelle, die vor der Antwort viele Zwischenschritte durchdenken, und Agenten, die aus einer Anfrage viele Werkzeugaufrufe machen, verschärfen das Problem. Systematische Abfragen lassen sich außerdem nutzen, um das Verhalten eines Modells zu kopieren. Setzen Sie Limits je Nutzer für Anfragen und Tokens, einen harten Kostendeckel, der die Verarbeitung stoppt, statt nur zu warnen, sowie Schritt- und Zeitlimits für Agenten.
Die Liste im Design-Review nutzen
Am meisten hilft die Liste an festen Punkten: wenn Sie eine neue LLM-Funktion entwerfen, vor dem Start und nach großen Änderungen wie einem neuen Modell oder einem neuen Werkzeug. Gehen Sie alle zehn Einträge mit den Menschen durch, die die Anwendung bauen, betreiben und verantworten. Beantworten Sie zu jedem Risiko drei Fragen:
- Trifft es zu? Eine Anwendung ohne Werkzeuge hat keine Excessive Agency, aber jede Anwendung hat Eingaben und Ausgaben.
- Was ist das schlimmste realistische Ergebnis? Eine falsche Antwort in einer Demo ist etwas anderes als eine Erstattung an einen Angreifer.
- Welche Kontrolle gibt es, und woher wissen Sie, dass sie wirkt? Eine Kontrolle ohne Test ist eine Hoffnung, keine Kontrolle.
Für Agenten ergänzt OWASP einen Schnelltest, die „Rule of Two“ von Meta. Kann der Agent (A) nicht vertrauenswürdige Eingaben lesen, (B) auf vertrauliche Daten zugreifen und (C) etwas verändern oder Daten nach außen senden? Treffen alle drei zu, braucht jede Aktion eine menschliche Freigabe. Kommen nicht vertrauenswürdige Eingaben mit einem der beiden anderen Punkte zusammen, halten Sie schriftlich fest, warum das verbleibende Risiko vertretbar ist.
Sie werden merken, dass dieselben Maßnahmen immer wieder auftauchen. Das ist eine gute Nachricht: Wenige, gut gebaute Kontrollen decken den größten Teil der Liste ab.
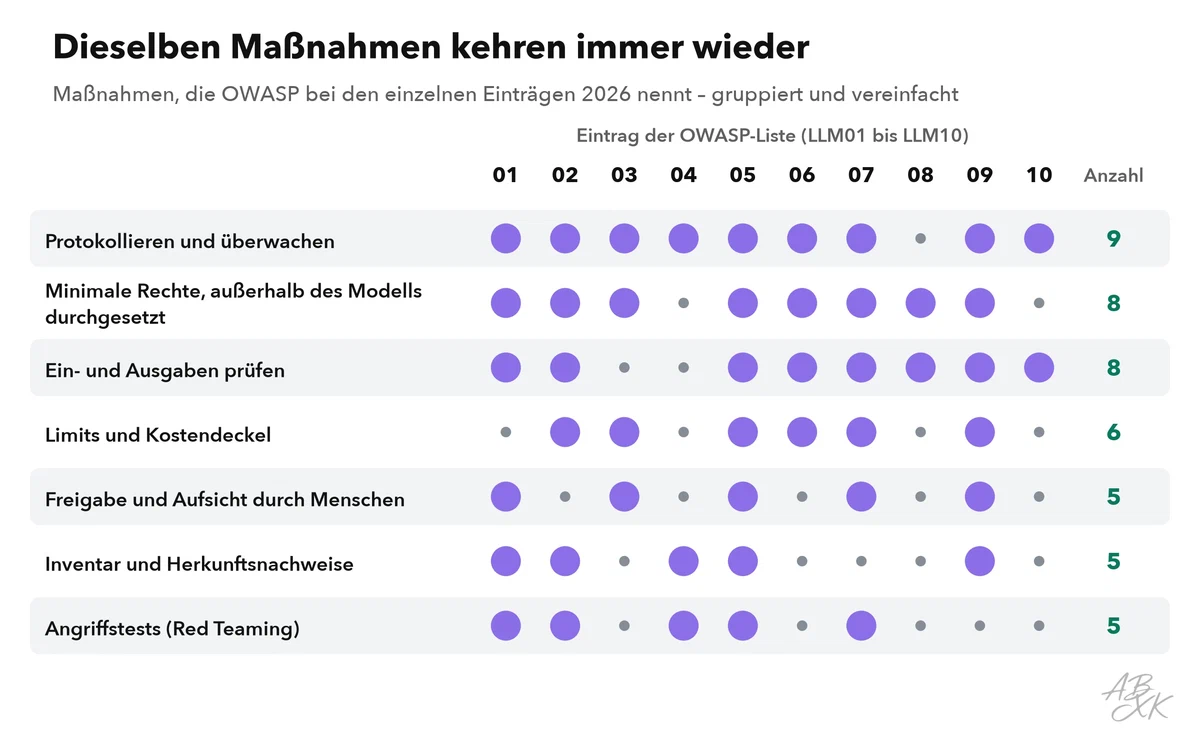
Minimale Rechte, die außerhalb des Modells durchgesetzt werden, Prüfungen von Ein- und Ausgaben sowie Protokolle tauchen bei fast jedem Eintrag auf. Protokollieren und Überwachen verhindern keine Angriffe, zeigen Ihnen aber, wenn eine Kontrolle versagt hat. Level 3 macht aus diesem Review ein vollständiges Bedrohungsmodell für KI-Systeme.
Die Liste gilt für jeden Baustein einer LLM-Anwendung. Unser Tool-Vergleich enthält Beispiele für drei davon. Pinecone ist eine Vektordatenbank für RAG (LLM09). Devs.ai ist eine Plattform, auf der Teams KI-Anwendungen und Agenten mit eigenen Daten bauen (LLM01, LLM03). Airia ist nach Angaben des Anbieters eine Kontrollschicht, die Agenten, Modelle, Werkzeuge und Datenzugriffe absichert und steuert:


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.