

Jeder öffentliche KI-Chatbot trifft auf Menschen, die ihn dazu bringen wollen, etwas zu sagen oder zu tun, was er nicht soll. Manche wollen gefährliche Anleitungen, manche einen Rabatt, den der Shop nie angeboten hat, und manche wollen nur sehen, wie das System bricht. Gelingt es, spricht man von einem Jailbreak. Die Kontrollen, die das verhindern, heißen Guardrails – Leitplanken.
Dieser Artikel ist Teil 3 von Level 2 unseres Lernpfads AI Security. Teil 1 hat Jailbreaking als Form der Prompt Injection eingeordnet, des ersten Risikos der OWASP-Liste. Hier lernen Sie, warum Jailbreaks funktionieren, welche Arten von Guardrails es gibt, wie Sie sie in Schichten kombinieren und wie Sie sie testen. Angriffe erklärt der Artikel nur als Prinzip: Er enthält keine funktionierenden Angriffs-Prompts.
Was ein Jailbreak ist
Ein Jailbreak ist eine Eingabe, die ein Sprachmodell dazu bringen soll, seine Sicherheitsregeln oder die Regeln seiner Anwendung zu ignorieren. OWASP zählt ihn zur Prompt Injection: Die Worte des Angreifers setzen sich gegen die Anweisungen durch, denen das Modell folgen soll (Quelle: OWASP Top 10 for LLM Applications 2026, LLM01, genai.owasp.org).
Jailbreaks zielen auf zwei Arten von Regeln:
- Die Sicherheitsregeln des Modellanbieters. Anbieter trainieren ihre Modelle darauf, gefährliche Anfragen abzulehnen, etwa Hilfe bei Waffen oder Schadsoftware. Ein Jailbreak versucht, diese Ablehnung zu umgehen.
- Die Geschäftsregeln Ihrer Anwendung. Ein Support-Assistent soll nur über Ihre Produkte sprechen, keine Erstattungen über einer Grenze zusagen und keine internen Notizen preisgeben. Ein Jailbreak versucht, ihn diese Regeln brechen zu lassen.
Für ein Unternehmen ist die zweite Art oft das größere Alltagsrisiko. Stellen Sie sich einen Shop-Chatbot vor, dem ein Nutzer einen Rabatt von 90 Prozent „bestätigen“ lässt – und der Screenshot verbreitet sich im Netz. Ob eine solche Zusage verbindlich ist, klären Juristen. Der Vertrauensschaden entsteht sofort.
| Begriff | Bedeutung |
|---|---|
| Jailbreak | Eingabe, die ein Modell seine Sicherheitsregeln oder die Regeln der Anwendung ignorieren lässt |
| Prompt Injection | Eingabe, die ein Modell den Anweisungen eines Angreifers statt Ihren folgen lässt; Jailbreaking ist eine Form davon |
| Guardrail | Eine Kontrolle, die Eingaben, Ausgaben oder Aktionen in festgelegten Grenzen hält |
| Ablehnung (Refusal) | Das Modell lehnt eine Anfrage ab |
| Überblockieren (Over-Refusal) | Das Modell oder ein Filter blockiert eine berechtigte Anfrage |
Warum Jailbreaks funktionieren
Sicherheitstraining ist gelerntes Verhalten, keine fest programmierte Regel. Modellanbieter zeigen ihren Modellen viele Beispiele für Anfragen, die abzulehnen sind, und belohnen die richtige Reaktion. Das Modell lernt ein Muster – aber kein Trainingsdatensatz deckt jede mögliche Formulierung, Sprache und Situation ab.
Fachleute beschreiben zwei Grundursachen (Quelle: Wei et al., „Jailbroken: How Does LLM Safety Training Fail?“, 2023). Die erste sind konkurrierende Ziele: Das Modell soll hilfreich und sicher sein, und eine geschickte Anfrage spielt das eine Ziel gegen das andere aus. Die zweite ist eine ungleiche Verallgemeinerung: Die Fähigkeiten des Modells reichen weiter als sein Sicherheitstraining. Ein Modell versteht eine Anfrage vielleicht in einer Kodierung oder einer seltenen Sprache, während sein Sicherheitstraining vor allem gewöhnliche Formulierungen abdeckte.
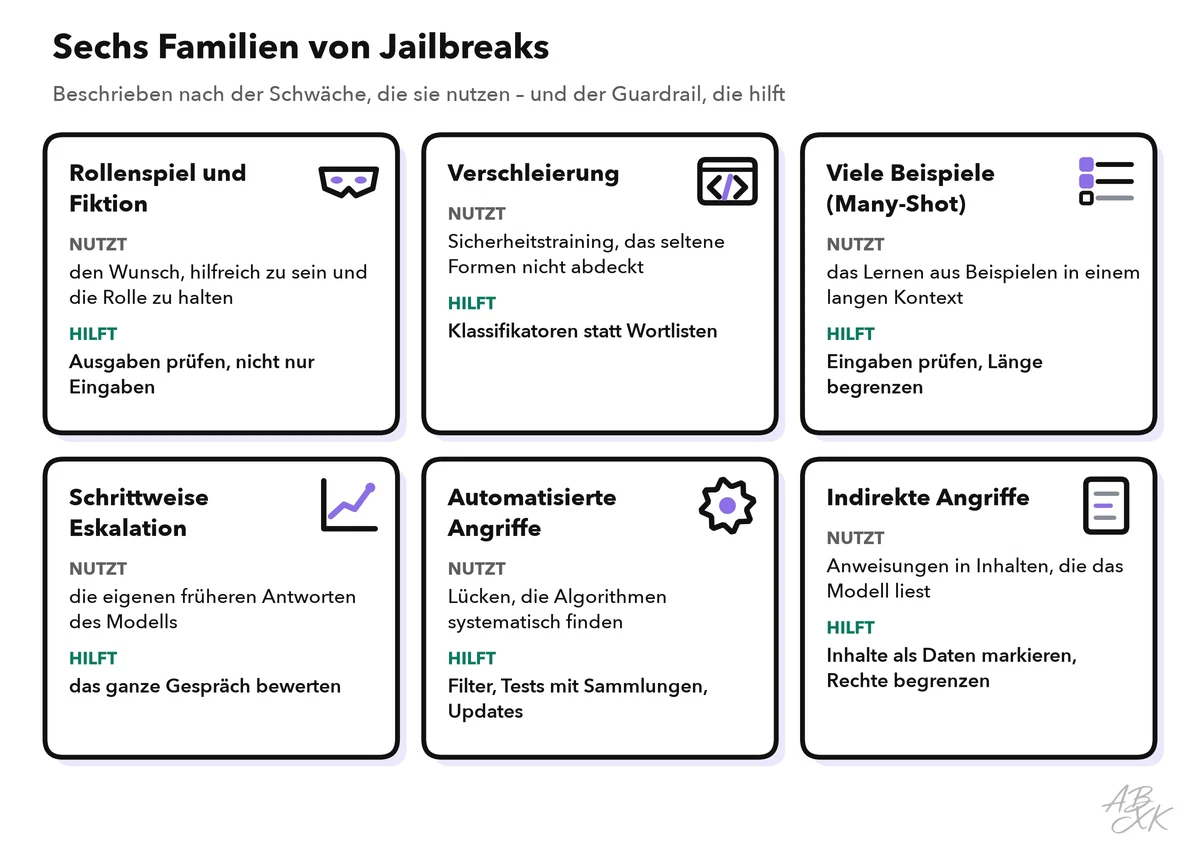
Die meisten bekannten Jailbreaks gehören zu wenigen Familien. Um sich zu schützen, müssen Sie die genauen Tricks nicht kennen. Sie müssen wissen, welche Eigenschaft des Modells sie ausnutzen:
- Rollenspiel und Fiktion verpacken eine Anfrage in eine Geschichte oder eine Rolle, sodass eine Ablehnung wie ein Bruch des Spiels wirkt.
- Verschleierung versteckt eine Anfrage in einer Kodierung, einer anderen Sprache oder in Tippfehlern, um an einfachen Filtern vorbeizukommen.
- Many-Shot-Angriffe füllen ein langes Kontextfenster mit erfundenen Dialogen, in denen ein Assistent seine Regeln bricht, und das Modell setzt das Muster fort. Anthropic hat das 2024 beschrieben und darauf hingewiesen, dass erst die wachsenden Kontextfenster es möglich machten.
- Schrittweise Eskalation beginnt mit harmlosen Fragen und nähert sich dem Ziel über viele Runden, aufbauend auf den früheren Antworten des Modells. Forscher von Microsoft haben einen solchen Angriff 2024 unter dem Namen Crescendo beschrieben.
- Automatisierte Angriffe lassen einen Algorithmus nach Zeichenfolgen suchen, die das Sicherheitstraining aushebeln. 2023 zeigten Forscher, dass solche Zeichenfolgen, gefunden an offenen Modellen, auch bei geschlossenen Chatbots wirkten (Quelle: Zou et al., „Universal and Transferable Adversarial Attacks on Aligned Language Models“, 2023).
- Indirekte Angriffe verstecken die Anweisungen in Dokumenten, E-Mails oder Webseiten, die das Modell liest – wie Level 1 in Prompt Injection einfach erklärt zeigt.
Fünf Arten von Guardrails
Guardrails gibt es in fünf Arten. Sie unterscheiden sich darin, was sie abfangen, was sie übersehen und was sie kosten:
| Guardrail | Was sie abfängt | Was sie übersieht | Nebenwirkungen |
|---|---|---|---|
| Sicherheitstraining des Modells | Offensichtlich schädliche Anfragen | Neue Formulierungen, Kodierungen, Many-Shot- und Mehr-Runden-Angriffe | Sie können es weder sehen noch ändern, und es unterscheidet sich je Modell und Version |
| Regeln im System-Prompt | Themenfremde Anfragen, Ton, einfacher Missbrauch | Nutzer, die lange genug argumentieren; laut OWASP ist der System-Prompt keine Sicherheitskontrolle | Ein falsches Gefühl von Sicherheit |
| Eingabefilter | Bekannte Angriffsmuster, verbotene Themen, übergroße Eingaben | Neue Angriffe, Angriffe über mehrere Runden oder in Dokumenten | Blockiert manche berechtigte Anfrage |
| Ausgabefilter | Schädliche Inhalte, Personendaten, Zusagen außerhalb Ihrer Regeln, falsche Formate | Feine Fehler und Schäden, die erst in einer Aktion sichtbar werden | Mehr Verzögerung; gute Antworten werden manchmal gekappt |
| Systemdesign | Den Schaden nach einem gelungenen Jailbreak, durch Grenzen im Code, minimale Rechte und Freigaben | Den Jailbreak selbst, der im Modell trotzdem passiert | Weniger Eigenständigkeit für die KI |
Ein- und Ausgabefilter sind oft Klassifikatoren: kleinere Modelle, die darauf trainiert sind zu beurteilen, ob ein Text gegen eine Richtlinie verstößt. Meta hat zum Beispiel Llama Guard veröffentlicht, ein offenes Modell, das Prompts und Antworten einordnet, und NVIDIA bietet mit NeMo Guardrails ein Open-Source-Toolkit, um programmierbare Regeln um eine LLM-Anwendung zu legen. Modellanbieter nutzen dieselbe Idee in ihren eigenen Diensten: 2025 hat Anthropic beschrieben, wie getrennte Klassifikatoren für Ein- und Ausgaben seine Modelle gegen universelle Jailbreaks schützen.
Offene Modelle brauchen besondere Sorgfalt. Unsere LLM-Datenbank führt 172 Modelle mit offenen Gewichten. Wenn Sie ein solches Modell selbst betreiben, ist jede Guardrail darum herum Ihre Aufgabe. Prüfen Sie, welche Version Sie einsetzen, denn feinjustierte Varianten auf öffentlichen Modellplattformen haben ihr Sicherheitstraining manchmal absichtlich verloren. Und wenn Sie selbst ein Modell per Fine-Tuning anpassen, testen Sie seine Sicherheit erneut: Studien zeigen, dass Fine-Tuning das Sicherheitstraining schwächen kann, selbst mit harmlosen Trainingsdaten (Quelle: Qi et al., „Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To!“, ICLR 2024).
Guardrails in Schichten kombinieren
Keine Guardrail stoppt jeden Jailbreak. Die Antwort ist dieselbe wie sonst in der Sicherheit: mehrere Schichten mit unterschiedlichen Schwachstellen. In der Sicherheitsforschung heißt das Schweizer-Käse-Modell: Jede Scheibe hat Löcher, aber die Löcher liegen selten übereinander.
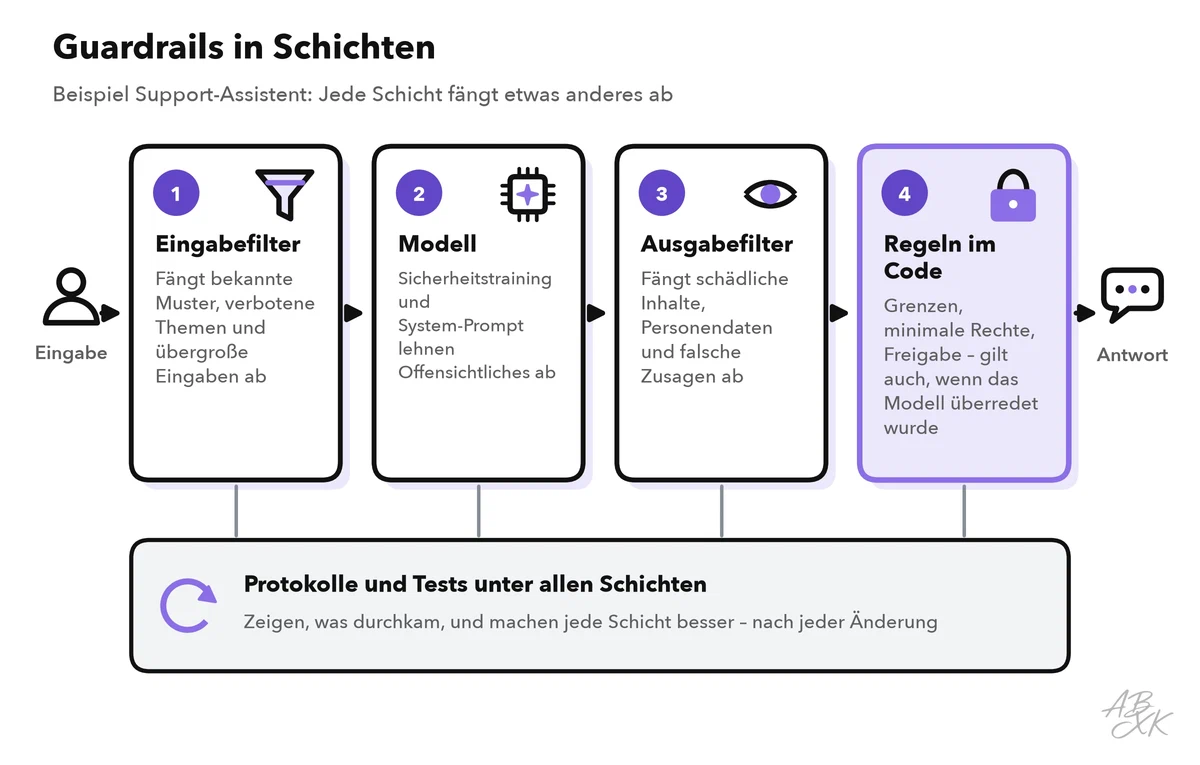
Zurück zum Shop-Assistenten. Ein Nutzer überredet das Modell langsam dazu, eine Erstattung weit über der Grenze „zu gewähren“. Der Eingabefilter übersieht die freundliche, schrittweise Eskalation. Das Sicherheitstraining des Modells sieht kein Problem, denn Erstattungen sind ein normales Thema. Aber das Erstattungs-Tool prüft die Grenze im Code und schickt größere Beträge an einen Menschen. Der Ausgabefilter fängt die Zusage im Chattext ab. Die Protokolle bewahren das Gespräch auf, sodass das Team den Filter verbessern kann. Der Jailbreak hat beim Modell funktioniert – und ist am System gescheitert.
Die wichtigste Schicht ist die, die gar nicht vom Modell abhängt: Regeln, die im Code durchgesetzt werden, minimale Rechte und menschliche Freigabe für Aktionen, die Geld kosten oder sich nicht rückgängig machen lassen. Unternehmen mit vielen KI-Agenten verwalten solche Richtlinien manchmal auf einer zentralen Plattform. Nach Angaben des Anbieters bietet Airia Laufzeitrichtlinien, Red Teaming und Prüfnachweise für Agenten, Modelle und Werkzeuge.
Guardrails testen
Guardrails brauchen Tests wie jede andere Funktion. Ein guter Testsatz hat drei Teile:
- Anfragen, die abgelehnt werden müssen, geordnet nach den Risiken, die für Ihre Anwendung zählen: schädliche Inhalte, Zusagen außerhalb Ihrer Regeln, Anfragen nach Daten anderer Personen und themenfremde Nutzung.
- Varianten dieser Anfragen, die den Jailbreak-Familien folgen: Rollenspiel, mehrere Runden, andere Sprachen. Öffentliche Sammlungen wie HarmBench und JailbreakBench liefern Testfälle, sodass Ihr Team keine Angriffe erfinden muss.
- Harmlose Anfragen, die ähnlich aussehen, etwa eine Kundin, die fragt, wie Erstattungen funktionieren. Sie zeigen, ob Ihre Guardrails berechtigte Nutzung blockieren.
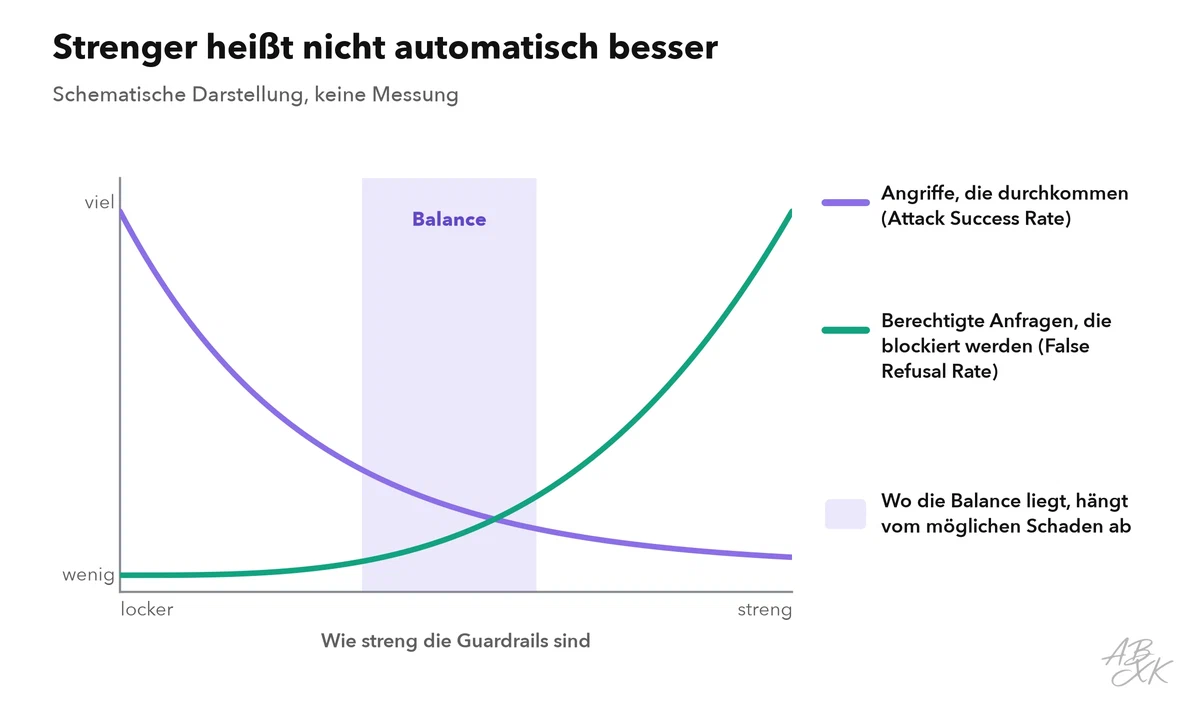
Dann messen Sie zwei Zahlen. Die Erfolgsquote von Angriffen (Attack Success Rate) ist der Anteil der Angriffsversuche, die durchkommen. Die Quote falscher Ablehnungen (False Refusal Rate) ist der Anteil berechtigter Anfragen, die blockiert werden. Ein strengerer Filter senkt die erste Zahl und erhöht die zweite. Wo Sie die Balance setzen, hängt vom möglichen Schaden ab: Eine Lern-App für Kinder braucht strengere Einstellungen als ein internes Tool für Sicherheitsfachleute.
Ein fester Testsatz hat einen blinden Fleck: Echte Angreifer passen sich an. In einer Studie von 2025 kamen Angriffe, die sich an die jeweilige Abwehr anpassten, an zwölf neueren Schutzverfahren vorbei, bei den meisten in mehr als 90 Prozent der Versuche. Die meisten dieser Verfahren hatten in ihren eigenen Tests kaum erfolgreiche Angriffe gemeldet (Quelle: Nasr et al., „The Attacker Moves Second“, 2025). Lassen Sie deshalb Tester, die Ihre Guardrails kennen, versuchen, sie zu umgehen, und werten Sie ein gutes Ergebnis auf einem öffentlichen Testsatz als Ausgangspunkt, nicht als Beweis.
Lassen Sie den Testsatz vor dem Start laufen und nach jeder Änderung erneut: bei einer neuen Modellversion, einem neuen System-Prompt, einem neuen Werkzeug. Ein Modell-Update kann Verhalten ändern, auf das sich Ihre Filter verlassen haben. Level 3 zeigt, wie Teams KI-Systeme mit Red Teaming gründlich testen. Finden Sie einen Jailbreak, der bei einem Modell eines Anbieters funktioniert, melden Sie ihn über dessen Sicherheits- oder Bug-Bounty-Programm und veröffentlichen Sie den funktionierenden Prompt nicht.
Betreiben Sie einen Kunden-Chatbot auf einer Plattform, fragen Sie den Anbieter, welche Guardrails enthalten sind, und testen Sie sie mit Ihrem eigenen Testsatz. Unser Vergleich führt mehrere solcher Plattformen in AI Work:
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Typische Fehler bei Guardrails
| Fehler | Warum er scheitert | Besser |
|---|---|---|
| Regeln nur im System-Prompt | Nutzer können das Modell davon abbringen | Regeln im Code durchsetzen; Prompt-Regeln sind nur die erste Schicht |
| Listen verbotener Wörter | Synonyme, Tippfehler und andere Sprachen rutschen durch, harmlose Texte werden blockiert | Klassifikatoren, dazu Grenzen für das, was das System tun kann |
| Nur die Eingabe prüfen | Angriffe über mehrere Runden und indirekte Angriffe passieren die Eingabeprüfung | Auch Ausgaben und Aktionen prüfen |
| Einmal vor dem Start testen | Neue Modellversionen verändern das Verhalten | Den Testsatz nach jeder Änderung erneut laufen lassen |
| Nur blockierte Angriffe zählen | Überblockieren frustriert Nutzer und treibt sie zu anderen Tools | Auch falsche Ablehnungen messen |
| Auf das Sicherheitstraining des Anbieters vertrauen | Es kennt Ihre Geschäftsregeln nicht | Eigene Guardrails für eigene Regeln ergänzen |