

Die Websites von Detektoren versprechen erstaunliche Genauigkeit. Studien finden Detektoren, die mehr als die Hälfte der Aufsätze einer Testgruppe fälschlich markieren. Beides kann gleichzeitig stimmen. Es hängt davon ab, welche Texte getestet wurden, welche Fehler gezählt wurden und wo die Schwelle lag.
Dieser Artikel ist Teil 4 von Level 2 unseres Lernpfads AI Security. Level 0 hat gefragt, ob sich KI-erzeugte Inhalte überhaupt erkennen lassen, und unser Artikel So funktioniert unser KI-Text-Detektor erklärt die neun Signale unseres eigenen Tools. Dieser Teil geht eine Ebene tiefer: wie die vier Ansätze im Inneren arbeiten, wie Sie Genauigkeitsangaben lesen, warum Umformulieren und Basisraten Detektoren aus dem Tritt bringen und wie Schulen und Personalabteilungen einen fairen Ablauf darum herum aufbauen.
Vier Ansätze und wie sie im Inneren arbeiten
Tools, die die Frage „KI oder nicht?“ beantworten, stützen sich auf vier Ansätze, manchmal kombiniert. Die ersten beiden schätzen im Nachhinein. Die letzten beiden brauchen die Mithilfe dessen, der den Inhalt erzeugt hat.
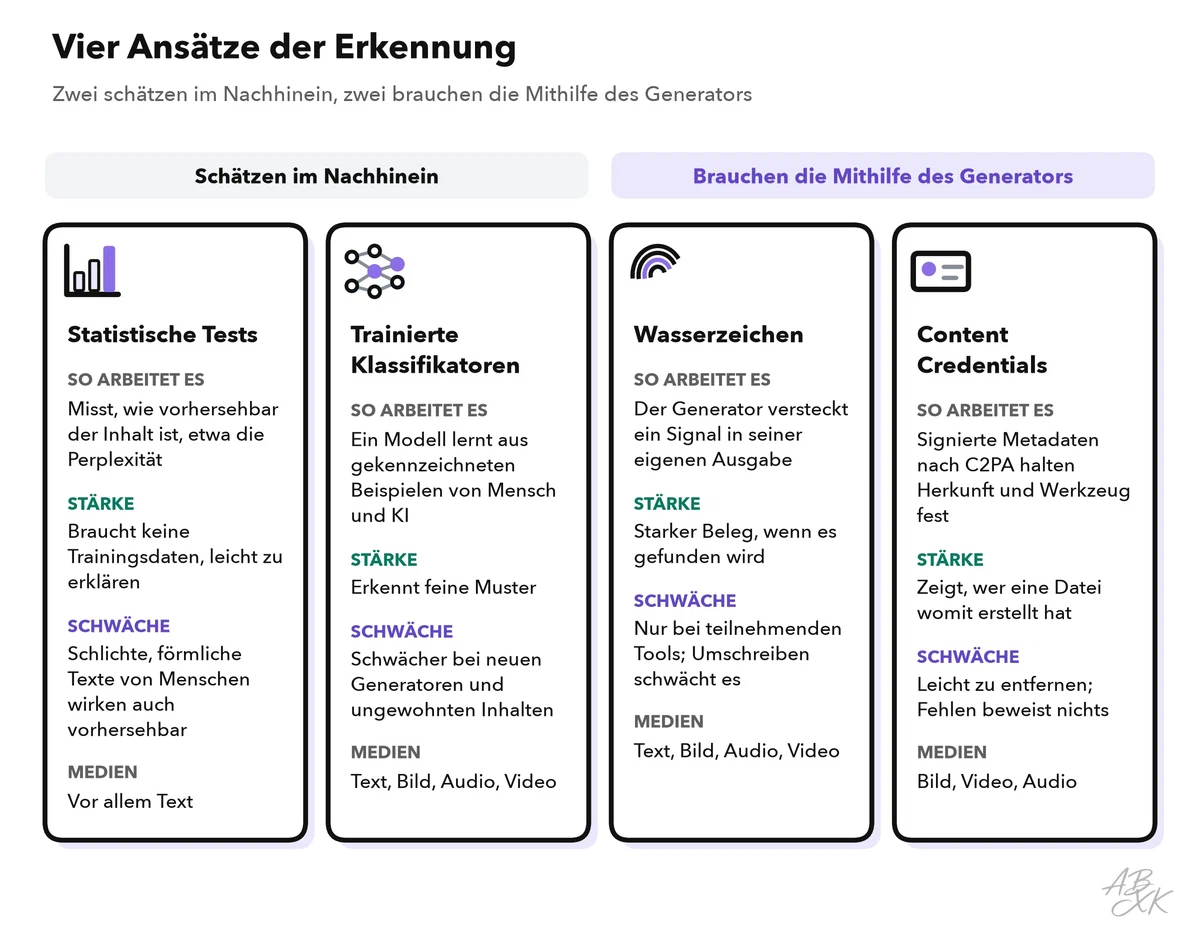
Statistische Tests messen Eigenschaften des Inhalts selbst. Bei Text ist die wichtigste Größe die Perplexität: wie überraschend jedes Wort für ein Sprachmodell ist. KI-Text ist meist gut vorhersehbar und erreicht deshalb niedrige Werte. Weitere Signale sind die Schwankung der Satzlängen und wiederholte Wendungen. Diese Tests brauchen kein Training mit Beispielen, und ihre Logik lässt sich leicht erklären. Ihre Schwachstelle: Schlichte, förmliche oder einfache Texte von Menschen sind ebenfalls gut vorhersehbar. Unser eigener Detektor gehört zu dieser Gruppe. Er bewertet Texte mit statistischen Signalen direkt in Ihrem Browser:
Trainierte Klassifikatoren sind Modelle, die aus vielen gekennzeichneten Beispielen von Menschen und KI gelernt haben, beides zu unterscheiden. Die meisten kommerziellen Detektoren für Text, Bild und Audio arbeiten so, etwa Pangram Labs für Text, das sich nach Angaben des Anbieters an Lehrende, Redaktionen und Unternehmen richtet. Klassifikatoren können feine Muster lernen. Aber sie sind nur so gut wie ihre Trainingsdaten: Inhalte eines neuen Generators, einer anderen Sprache oder einer ungewohnten Textsorte können anders aussehen als alles, was sie gesehen haben.
Wasserzeichen sind versteckte Signale, die ein Generator in seine eigene Ausgabe einbaut; wie das bei Text funktioniert, zeigt der nächste Abschnitt. Content Credentials sind signierte Metadaten, die festhalten, wer oder was eine Datei mit welchem Werkzeug erstellt hat. Sie folgen dem Standard C2PA der Coalition for Content Provenance and Authenticity. Adobe etwa gibt an, sie an Bilder anzuhängen, die vollständig mit Firefly erzeugt wurden. Beide Verfahren liefern starke Belege, wenn sie vorhanden sind – aber nur für Inhalte aus Tools, die mitmachen.
| Ansatz | Braucht die Mithilfe des Generators? | Typische Medien | Größte Schwäche |
|---|---|---|---|
| Statistische Tests | Nein | Vor allem Text | Fehlalarme bei schlichten oder förmlichen Texten |
| Trainierte Klassifikatoren | Nein | Text, Bild, Audio, Video | Schwächer bei neuen Generatoren und ungewohnten Inhalten |
| Wasserzeichen | Ja | Text, Bild, Audio, Video | Nur bei teilnehmenden Tools; starke Bearbeitung schwächt sie |
| Content Credentials | Ja | Bild, Video, Audio | Leicht zu entfernen; fehlende Credentials beweisen nichts |
So funktioniert ein Wasserzeichen in Text
Ein Wasserzeichen in Text steckt in der Wortwahl. Während das Modell schreibt, markiert ein geheimer Schlüssel bei jedem Schritt einen Teil der möglichen nächsten Wörter als „bevorzugt“. Das Modell gibt diesen Wörtern einen kleinen zusätzlichen Schub – so klein, dass der Text weiterhin natürlich klingt. Ein Detektor, der den Schlüssel kennt, zählt die bevorzugten Wörter. In Text von Menschen ist nur der Anteil bevorzugt, den man zufällig erwarten würde. In Text mit Wasserzeichen ist es deutlich mehr. Ein statistischer Test macht aus der Zählung einen Sicherheitsgrad, und längere Texte geben mehr Sicherheit. Forscher haben diese Idee 2023 veröffentlicht (Quelle: Kirchenbauer et al., „A Watermark for Large Language Models“, ICML 2023). Google hat später ein eigenes Verfahren für Text, SynthID Text, als Open Source veröffentlicht.
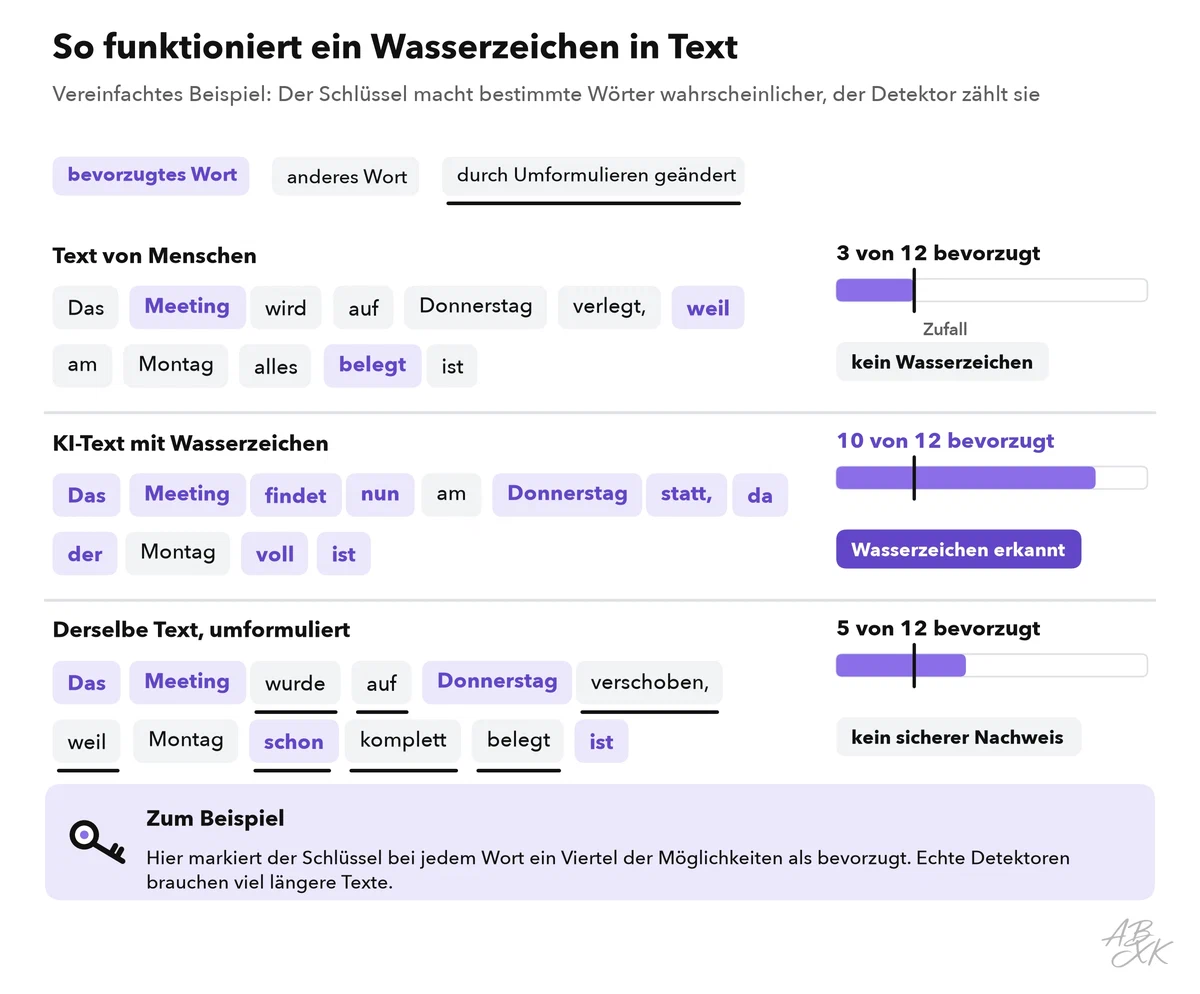
Das Prinzip erklärt auch die Grenzen. Umschreiben ersetzt viele der bevorzugten Wörter, und die Zählung rutscht zurück in Richtung Zufall. Google gibt an, dass die Sicherheit seines Text-Detektors deutlich sinkt, wenn ein Text gründlich umgeschrieben oder übersetzt wird. Laut Google wirkt das Wasserzeichen außerdem bei sachlichen Antworten schlechter, weil es dort wenig Spielraum für andere Formulierungen gibt. Nur wer den Schlüssel hat, kann ein Wasserzeichen prüfen. Sie brauchen also den Detektor des jeweiligen Anbieters.
Genauigkeitsangaben lesen wie ein Prüfer
Jeder Detektor macht zwei Arten von Fehlern. Ein falsch positives Ergebnis markiert die Arbeit eines Menschen als KI und kann einer unschuldigen Person schaden. Ein falsch negatives Ergebnis lässt KI-Inhalte durch. „Genauigkeit“ mischt beides zu einer Zahl und kann eine hohe Quote falsch positiver Ergebnisse verstecken. Zwei Kennzahlen sagen mehr: die Erkennungsrate (wie viel KI-Inhalt das Tool findet) und die Falsch-positiv-Rate (wie viel menschlichen Inhalt es fälschlich markiert), beide bei der Schwelle, die das Tool tatsächlich verwendet.
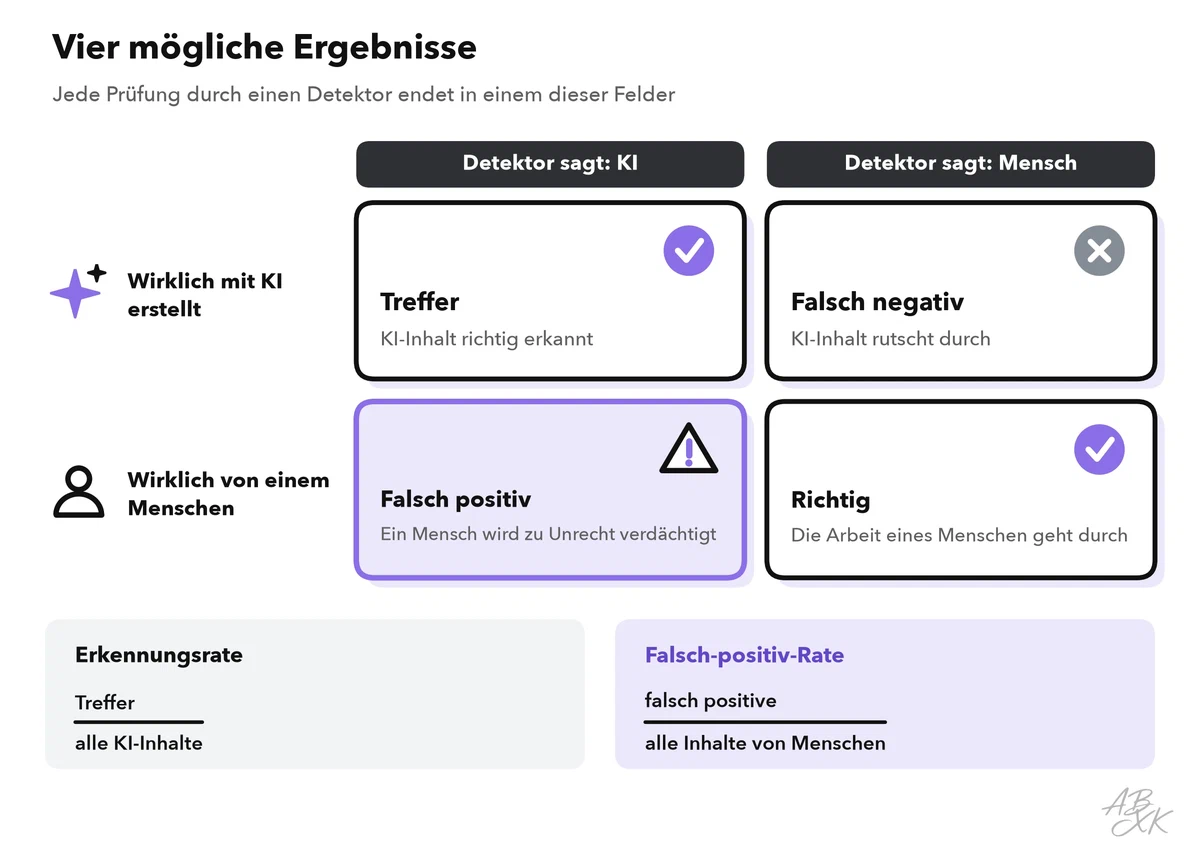
Level 0 hat zwei Warnsignale beschrieben. OpenAI hat seinen eigenen Text-Klassifikator 2023 wegen geringer Genauigkeit zurückgezogen. Und in einer Studie aus Stanford markierten sieben Detektoren im Schnitt mehr als die Hälfte der Aufsätze von Menschen mit Englisch als Fremdsprache als KI. Eine Angabe ist nur so viel wert wie der Test dahinter. Bevor Sie sich auf einen Detektor verlassen, fragen Sie den Anbieter:
| Frage | Warum sie zählt |
|---|---|
| Wie hoch ist die Falsch-positiv-Rate, und bei welcher Schwelle? | Diese Zahl entscheidet, wie viele Unschuldige markiert werden |
| Welche Texte wurden getestet: Sprache, Länge, Textsorte, Verfasser? | Ergebnisse mit Nachrichtentexten sagen wenig über Schulaufsätze |
| Waren Menschen dabei, die nicht in ihrer Muttersprache schreiben? | Viele Detektoren markieren sie häufiger |
| Welche Generatoren und Versionen wurden abgedeckt? | Neue Modelle können anders aussehen als die Trainingsdaten |
| Was bedeutet ein Wert von 80? | Nur ein kalibrierter Wert lässt sich als Wahrscheinlichkeit lesen |
| Wohin gehen hochgeladene Texte? | Aufsätze und Bewerbungen enthalten personenbezogene Daten |
Warum Umformulieren und Bearbeiten Detektoren aushebeln
Detektoren suchen nach Spuren des Erzeugungsprozesses. Jede Änderung nach der Erzeugung kann sie verwischen. In einer Studie senkte ein automatisches Umformulierungsmodell die Erkennungsrate eines Forschungsdetektors von 70,3 auf 4,6 Prozent, bei einer festen Falsch-positiv-Rate von 1 Prozent. Derselbe Umformulierer kam auch an Wasserzeichen und kommerziellen Detektoren vorbei (Quelle: Krishna et al., „Paraphrasing evades detectors of AI-generated text, but retrieval is an effective countermeasure“, NeurIPS 2023).
Bearbeitung durch Menschen wirkt ähnlich. Und die meisten echten Texte sind ohnehin gemischt: Ein Mensch schreibt einen Entwurf und lässt ihn von KI glätten, oder die KI schreibt einen Entwurf und ein Mensch schreibt die Hälfte neu. Ein Detektor gibt einen Wert für den ganzen Text aus, obwohl „KI oder Mensch“ längst keine Ja-Nein-Frage mehr ist. Bei Bildern und Videos richten Kompression und Screenshots denselben Schaden an Pixelspuren und Metadaten an. Deshalb zählt dort die Prüfung von Quelle und Zusammenhang mehr. Level 1 zeigt Schritt für Schritt, wie Sie Bilder, Audio und Video prüfen.
Basisraten: Warum viele Markierungen Menschen treffen
Selbst ein guter Detektor löst viele Fehlalarme aus, wenn die meisten Texte von Menschen stammen. Den Anteil der KI-Texte in einer Gruppe nennt man Basisrate. Je seltener KI-Texte sind, desto größer ist der Anteil menschlicher Texte unter den Markierungen. Level 0 hat das an einem einzelnen Fall mit angenommenen Zahlen gezeigt. Das Diagramm zeigt den ganzen Verlauf für einen Beispiel-Detektor, der 90 Prozent der KI-Texte findet und 2 Prozent der menschlichen Texte fälschlich markiert:
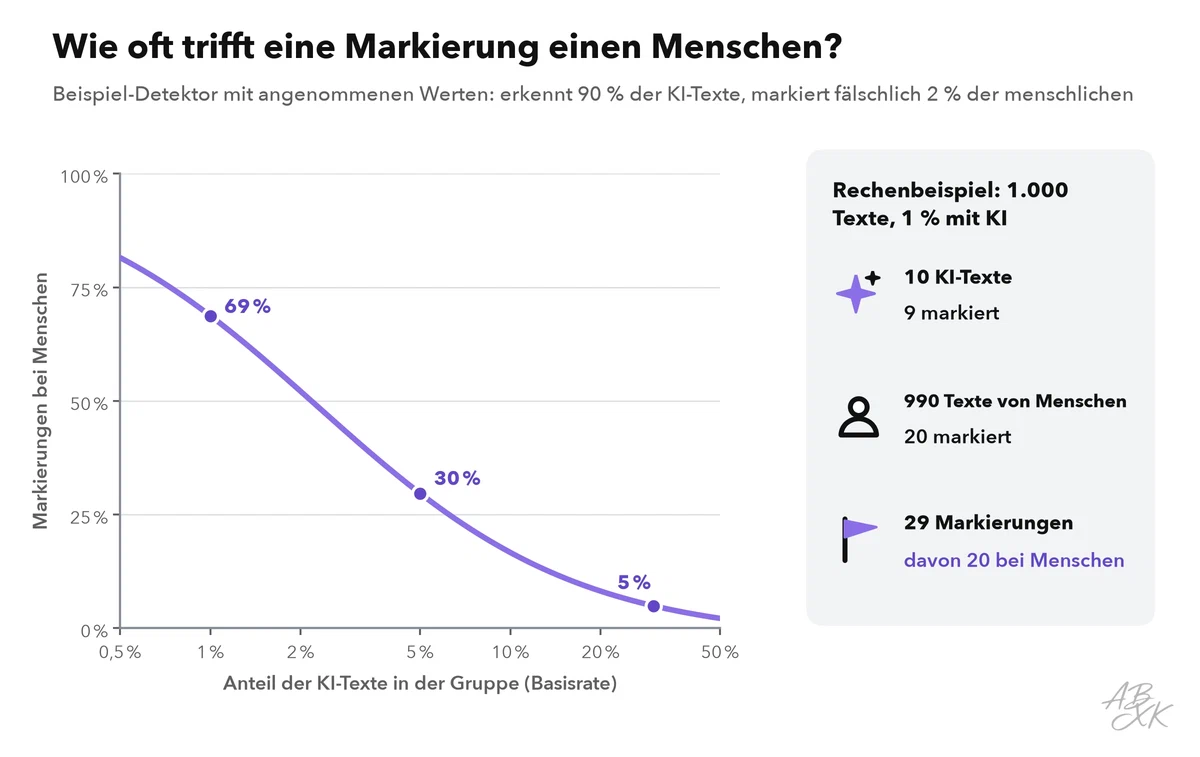
Kalibrierung ist die verwandte Frage, was ein Wert bedeutet. Ein Detektor ist gut kalibriert, wenn von allen Texten mit einem Wert von 80 etwa 80 Prozent wirklich von einer KI stammen. Ein Detektor kann für eine Gruppe gut kalibriert sein, etwa englische Nachrichtentexte, und für eine andere schlecht, etwa Aufsätze von Schülerinnen und Schülern, die Englisch lernen. Lesen Sie einen Wert deshalb als Aussage über Texte wie die, mit denen der Detektor getestet wurde, und nicht als Wahrscheinlichkeit für die Person vor Ihnen.
Ein fairer Ablauf für Schulen und Personalabteilungen
Ein Detektor kann eine Frage aufwerfen, beantworten muss sie ein Mensch. Level 0 hat fünf Regeln genannt, um einen einzelnen Wert fair zu lesen. Schulen und Personalabteilungen brauchen mehr: einen Ablauf, den alle vorher kennen. Sieben Schritte machen ihn fair:
- Regeln zuerst festlegen. Sagen Sie, welche KI-Hilfe erlaubt ist. In vielen Kursen und Berufen ist KI für Rechtschreibung oder Gliederung in Ordnung.
- Vorab informieren, welche Tools Sie wofür nutzen und was mit den Texten geschieht.
- Eine Markierung nur als Anlass für einen genaueren Blick nutzen, nie als Note oder Absage.
- Prüfen, ob der Text zum Tool passt: Länge, Sprache und Textsorte.
- Belege aus dem Arbeitsprozess sammeln: Entwürfe, Versionsverlauf, Notizen und Quellen.
- Mit der Person sprechen. Wer einen Text geschrieben hat, kann meist erklären, wie er entstanden ist.
- Einen Menschen entscheiden lassen, die Gründe dokumentieren und Widerspruch ermöglichen.
Bei Einstellungen liegt die Latte noch höher. Viele Bewerberinnen und Bewerber glätten ihr Anschreiben mit KI, ein Detektor sagt also wenig über ihre Fähigkeiten. In der EU haben Menschen das Recht, keiner ausschließlich automatisierten Entscheidung unterworfen zu werden, die ihnen gegenüber rechtliche Wirkung entfaltet oder sie ähnlich erheblich beeinträchtigt (Art. 22 DSGVO). Eine Bewerbung allein wegen eines Detektorwerts abzulehnen, ist genau die Art von Entscheidung, die Sie vermeiden sollten.