

Ein KI-Assistent, der eine Tatsache erfindet, ist beim Schreiben einer E-Mail ärgerlich. Zum Sicherheitsproblem wird es, wenn jemand danach handelt: Software installiert, die es nicht gibt, eine Lösung übernimmt, die einen Schutz abschaltet, oder sich auf ein Urteil stützt, das nie gefällt wurde. Angreifer haben sogar gelernt, von diesen Fehlern zu profitieren.
Dieser Artikel ist Teil 3 von Level 1 unseres Lernpfads AI Security. Die Sicherheits-Checkliste in Level 0 hat Ihnen geraten, KI-Antworten vor dem Handeln zu prüfen; dieser Teil zeigt, was passiert, wenn niemand prüft. Sie lernen, wann eine Halluzination zum Sicherheitsrisiko wird und wie Angreifer erfundene Paketnamen ausnutzen. Außerdem sehen Sie, warum KI-Ratschläge zu Sicherheitseinstellungen einen zweiten Blick brauchen, was Benchmarks über Faktenwissen zeigen, und lernen eine kurze Prüfroutine kennen.
Wann eine erfundene Antwort zum Risiko wird
Eine Halluzination ist eine Antwort, die richtig klingt, aber erfunden ist: eine Tatsache, eine Quelle, eine Zahl oder ein Befehl. Ein Sprachmodell sagt wahrscheinliche Wörter voraus. Es hat kein verlässliches Gespür dafür, welche Fakten es sicher kennt. Ein Grund: Training und gängige Tests belohnen eine selbstsichere Vermutung stärker als ein ehrliches „Ich weiß es nicht“ (Quelle: Kalai et al., „Why Language Models Hallucinate“, 2025, arxiv.org).
OWASP zählt das unter dem Namen Misinformation (Falschinformation) zu den zehn größten Risiken für KI-Anwendungen. Dazu nennt es ein verwandtes Problem, Overreliance: Menschen vertrauen KI-Ausgaben, ohne sie zu prüfen (Quelle: OWASP Top 10 for LLM Applications 2025, LLM09, genai.owasp.org). In der aktuellen Ausgabe von 2026 ist Falschinformation auf Platz 7 vorgerückt.
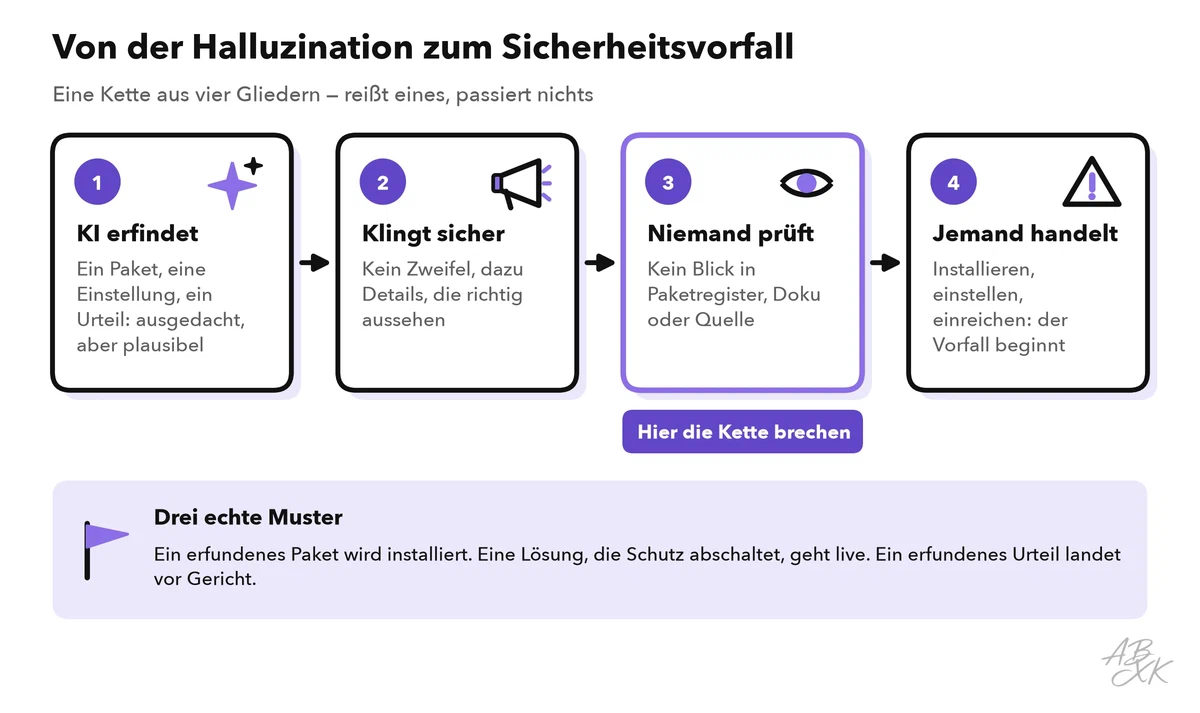
Eine Halluzination allein richtet keinen Schaden an. Zum Vorfall wird sie über eine Kette aus vier Gliedern: Das Modell erfindet etwas, es klingt sicher, niemand prüft, und jemand handelt danach. Reißt ein Glied, hält die Kette nicht. Das Glied, das Sie am besten in der Hand haben, ist die Prüfung.
Erfundene Paketnamen: Slopsquatting
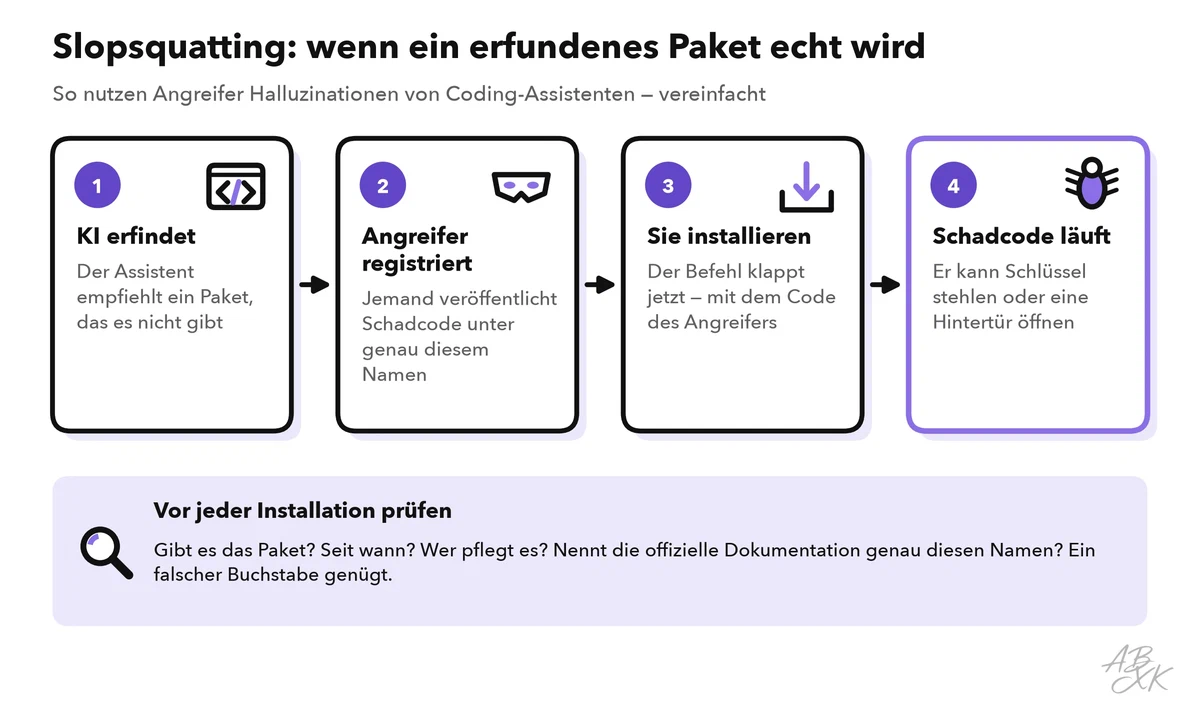
Programmierer schreiben selten alles selbst. Sie nutzen Pakete: fertige Code-Bibliotheken, die sie aus öffentlichen Registern laden, etwa PyPI für Python oder npm für JavaScript. KI-Coding-Assistenten schlagen oft Pakete vor — und manchmal solche, die es gar nicht gibt.
Eine Studie, vorgestellt 2025 auf dem USENIX Security Symposium, testete 16 Code-Modelle mit 576.000 Codebeispielen. Im Schnitt existierten mindestens 5,2 Prozent der Pakete nicht, die kommerzielle Modelle vorschlugen. Bei Open-Source-Modellen lag der Anteil bei 21,7 Prozent. Insgesamt zählten die Forschenden 205.474 verschiedene erfundene Paketnamen (Quelle: Spracklen et al., USENIX Security 2025, arxiv.org).
Das öffnet Angreifern eine Tür. Erfinden Modelle denselben Namen immer wieder, kann ein Angreifer ihn registrieren und mit Schadcode füllen. Wer der KI als Nächstes vertraut, installiert das Paket des Angreifers. Diesen Angriff nennt man Slopsquatting, eine Mischung aus „AI Slop“ (KI-Ramsch) und Typosquatting, dem alten Trick, falsch geschriebene Namen beliebter Pakete zu registrieren. Die OWASP-Liste von 2025 beschreibt genau dieses Szenario als Beispiel für das Risiko der Falschinformation.
Wie realistisch ist das? Ein Sicherheitsforscher von Lasso Security lud ein leeres Testpaket unter einem Namen hoch, den KI-Modelle immer wieder erfanden. Innerhalb von drei Monaten wurde es mehr als 30.000-mal heruntergeladen (Quelle: Lasso Security, 2024). Dieses Paket war harmlos. Das Paket eines echten Angreifers wäre es nicht.
Lösungen, die einen Schutz abschalten
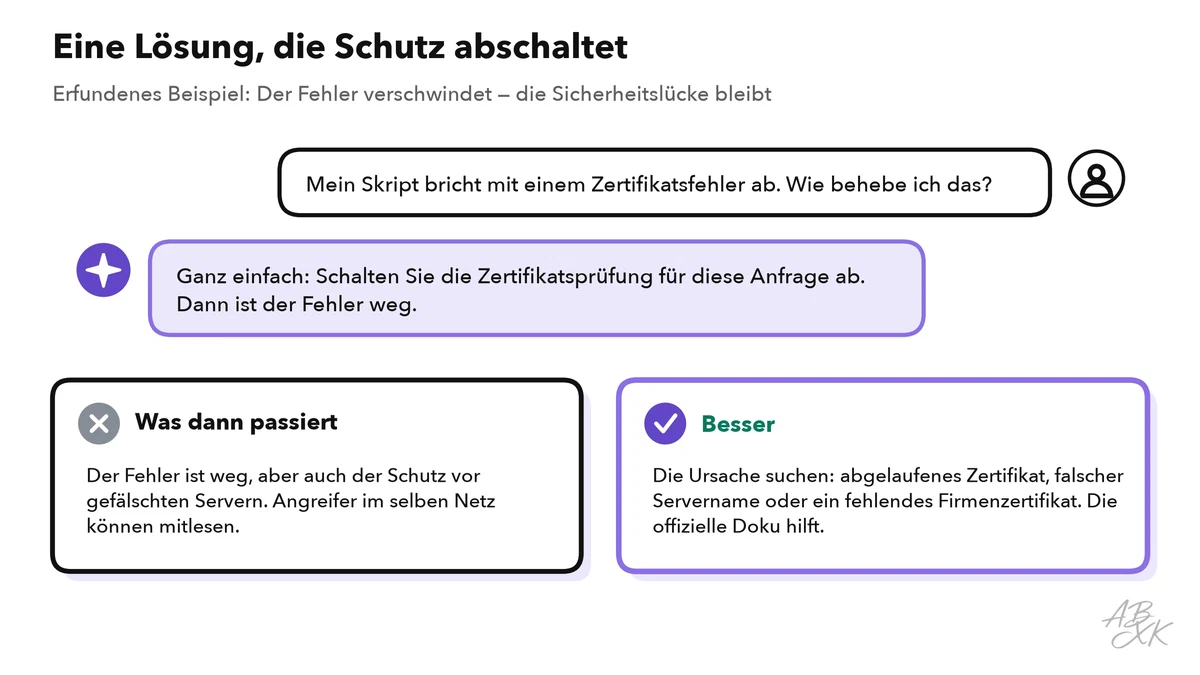
Erfundene oder leichtfertige Antworten stecken auch in Ratschlägen, und derselbe OWASP-Eintrag zählt unsichere Code-Vorschläge zu diesem Risiko. Bitten Sie einen KI-Assistenten, einen Fehler zu beheben, schlägt er vielleicht eine schnelle Lösung vor, die einen Schutz entfernt: Zertifikatsprüfung abschalten, einen Firewall-Port für alle öffnen, einem Konto volle Admin-Rechte geben oder ein Passwort im Klartext speichern. Der Fehler verschwindet. Die Sicherheitslücke bleibt.
Die Forschung zeigt, wie leicht das durchrutscht. In einer Studie an der Stanford University schrieben Teilnehmende mit KI-Assistent deutlich unsichereren Code als jene ohne. Zugleich hielten sie ihren Code häufiger für sicher (Quelle: Perry et al., ACM CCS 2023, arxiv.org). Behandeln Sie jeden KI-Rat, der einen Schutz schwächt, als Warnzeichen, und prüfen Sie ihn anhand der offiziellen Dokumentation des Produkts oder mit Ihrem Sicherheitsteam.
Erfundene Rechts- und Compliance-Fakten
Dasselbe Muster trifft rechtliche Fragen. 2023 verhängte ein US-Bundesgericht Sanktionen gegen zwei Anwälte und ihre Kanzlei, weil ein Schriftsatz Urteile zitierte, die ChatGPT erfunden hatte (Quelle: Mata v. Avianca, Inc., U.S. District Court for the Southern District of New York, 2023). In Sicherheits- und Compliance-Fragen sieht das Risiko ähnlich aus: ein erfundener Gesetzesartikel, eine falsche Meldefrist nach einer Datenpanne oder eine ausgedachte Anforderung einer Norm. Eine selbstsichere falsche Antwort kann zu einer Entscheidung führen, die eine Regel bricht oder eine Frist verpasst.
Die Tabelle zeigt, woran Sie die vier Risikoarten erkennen und wie Sie sie prüfen:
| Risiko | Woran Sie es erkennen | So prüfen Sie |
|---|---|---|
| Erfundenes Paket | Ein Installationsbefehl für eine Bibliothek, von der Sie nie gehört haben | Im Register nachsehen: Alter, Betreuer, Downloads, Link zum Quellcode; mit der offiziellen Doku vergleichen |
| Schwächende Lösung | „Prüfung abschalten“, „alles erlauben“, „als Admin ausführen“ | Die Ursache in der offiziellen Dokumentation suchen; nie einen Schutz abschalten, nur damit ein Fehler verschwindet |
| Erfundener Rechtsfakt | Ein Urteil, Gesetzesartikel oder eine Frist, die Sie nicht finden | Die Primärquelle lesen, etwa den Gesetzestext oder eine Urteilsdatenbank, oder Ihre Rechtsabteilung fragen |
| Erfundene Referenz | Eine Sicherheitsmeldung, Versionsnummer oder Normklausel, die es zu geben scheint | Auf der Website des Herausgebers suchen; kein Treffer heißt: keine Tatsache |
Was Benchmarks über Faktenwissen zeigen
Wie oft liegen Modelle bei Fakten falsch? Forschende messen das mit Benchmarks: standardisierten Tests, die jedes Modell auf dieselbe Weise ablegt. SimpleQA Verified stellt kurze Faktenfragen mit genau einer richtigen Antwort, und die Modelle antworten ohne Websuche. Das sind die aktuellen Spitzenreiter in unseren LLM-Daten:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Gemini 4 Argon (high) Google DeepMind | 30.09.2026 | 76,0 % |
| 2 | GPT-6 Astra (max) OpenAI | 03.09.2026 | 75,6 % |
| 3 | GPT-6.1 Sol (max) OpenAI | 29.09.2026 | 73,9 % |
| 4 | Gemini 3.1 Pro Preview Google DeepMind | 19.02.2026 | 73,5 % |
| 5 | Claude Opus 5.5 (max) Anthropic | 22.09.2026 | 72,2 % |



Kurze Faktenfragen mit genau einer richtigen Antwort, beantwortet ohne Hilfsmittel. Zeigt, wie viel ein Modell wirklich weiß — und wie oft es eine Antwort erfindet, statt Nichtwissen zuzugeben. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Selbst die Spitzenreiter verfehlen einen beträchtlichen Teil der Fragen. Die Grafik zeigt jedes Modell unserer Datenbank, das diesen Test abgelegt hat, und viele liegen weit unter den Spitzenreitern:
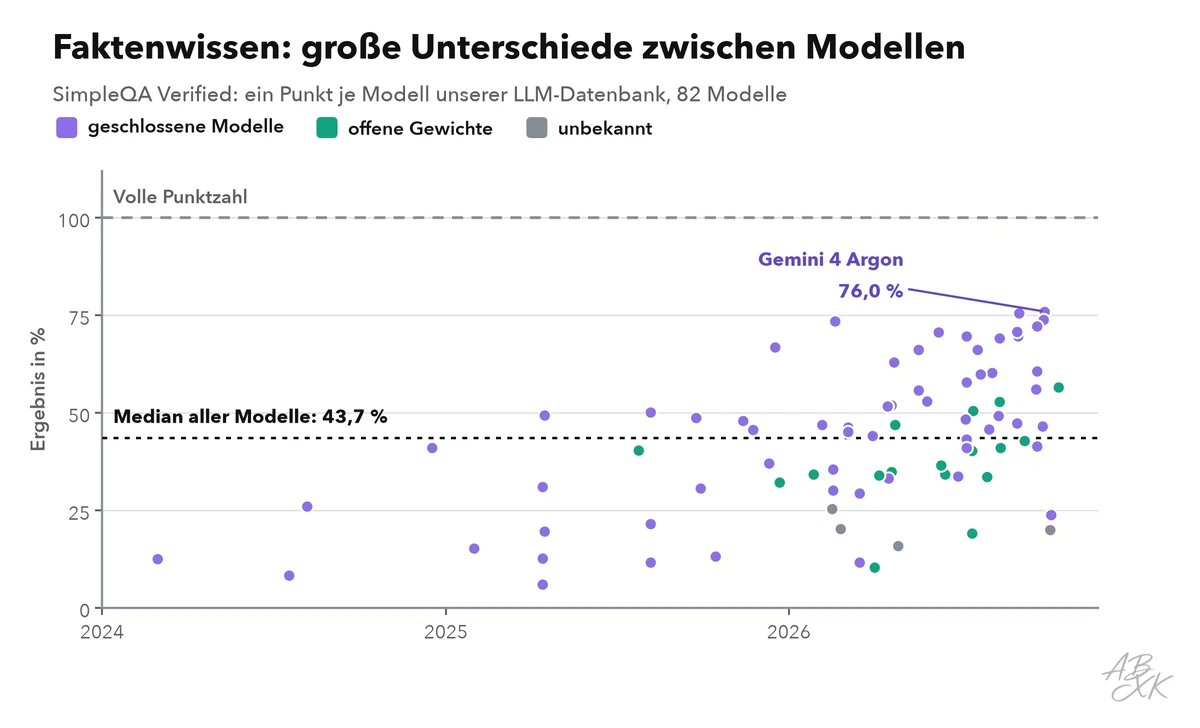
Für die Sicherheitsarbeit folgen daraus zwei Lehren. Erstens kommt es auf das Modell an: Nutzen Sie für wissenslastige Aufgaben Modelle, die in Faktentests gut abschneiden, und vergleichen Sie sie in unserer LLM-Datenbank. Zweitens macht kein Ergebnis die Prüfung überflüssig. Ein Modell, das meistens richtig liegt, liegt manchmal falsch — und klingt dann genauso sicher. Level 2 ordnet Falschinformation in die OWASP Top 10 ein, und Level 3 zeigt, wie Sie die ganze KI-Lieferkette absichern, von Modellen bis zu Paketen.
Prüfen, bevor Sie handeln
Nutzen Sie diese kurze Routine immer dann, wenn eine KI-Antwort zu einer Handlung mit Folgen für die Sicherheit führt:
- Die Handlung benennen. Was genau würden Sie aufgrund der Antwort tun: installieren, einstellen, unterschreiben oder senden?
- Die Primärquelle suchen. Die offizielle Dokumentation, das Paketregister, den Gesetzestext oder die Sicherheitsmeldung des Herstellers.
- Die Details prüfen. Genauer Name, Version, Nummer und Datum. Ein falscher Buchstabe im Paketnamen genügt.
- Die sichere Voreinstellung wählen. Schwächt der Rat einen Schutz, suchen Sie einen anderen Weg oder fragen Sie Ihr Sicherheitsteam.
- Notieren, was Sie geprüft haben. So können andere Ihre Entscheidung nachvollziehen.
Die Routine zählt am meisten, wenn der Assistent zuverlässig wirkt. In einer Umfrage von Microsoft Research und der Carnegie Mellon University unter 319 Wissensarbeitenden von 2025 gaben Menschen mit mehr Vertrauen in generative KI weniger kritisches Denken an, Menschen mit mehr Vertrauen in die eigenen Fähigkeiten dagegen mehr (Quelle: Lee et al., CHI 2025). Eine feste Gewohnheit wie Schritt 5 verhindert, dass die Prüfung mit wachsendem Vertrauen einschläft.
Tools können einige dieser Schritte beschleunigen. Nach Angaben der Anbieter antwortet Consensus mit Belegen aus Fachartikeln, Nouswise antwortet aus den Dokumenten, die Sie hochladen, und TestDriver.ai führt Tests für Codeänderungen aus, bevor sie übernommen werden. Keines davon ersetzt Ihre eigene Prüfung.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.