

Eine Lehrerin fragt sich, ob ein Aufsatz von ChatGPT stammt. Eine Redaktion erhält ein Video, das fast zu gut aussieht. Ein Unternehmen bekommt eine Sprachnachricht vom „Chef“. Alle wünschen sich dasselbe: ein Tool, das „echt“ oder „KI“ sagt. Solche Tools gibt es, doch ihre Antworten sind unsicherer, als sie wirken, und wer sie unbedacht einsetzt, kann Unschuldigen schaden.
Dieser Artikel ist Teil 5 von Level 0 in unserem Lernpfad AI Security. Sie lernen die zwei Wege kennen, KI-Inhalte zu erkennen, erfahren, worauf Detektoren bei Text, Bild, Audio und Video achten, warum sie Fehler machen und wie Sie sie fair einsetzen.
Zwei Wege, die Frage zu beantworten
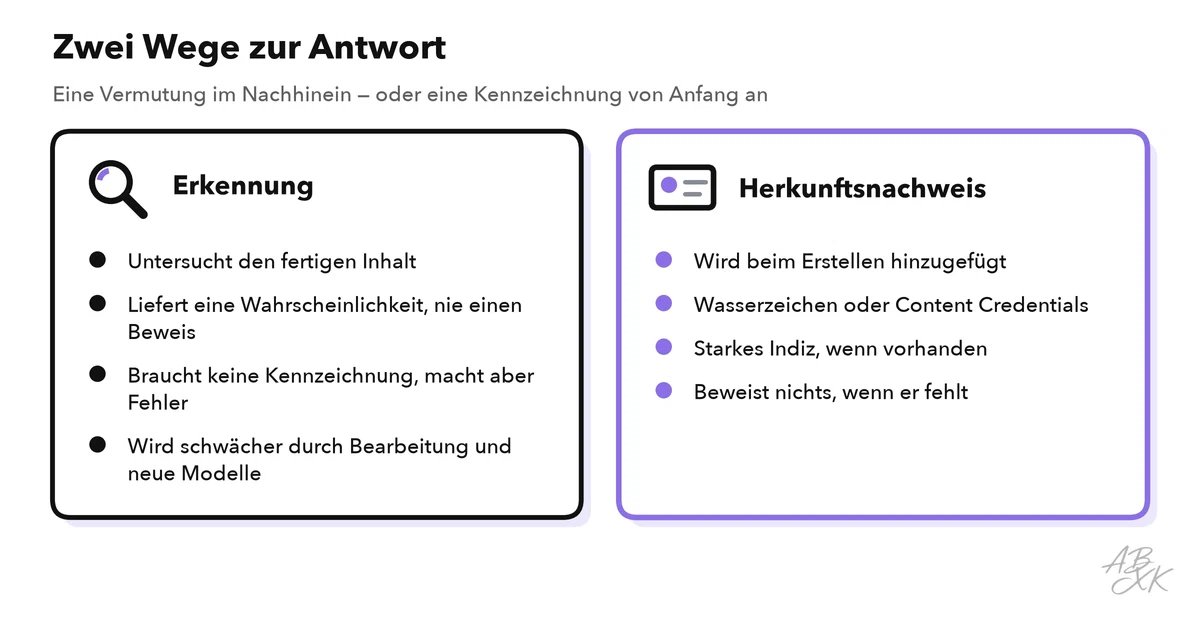
Es gibt zwei sehr verschiedene Ansätze, und es hilft, sie auseinanderzuhalten:
- Erkennung untersucht den Inhalt im Nachhinein und sucht nach Mustern, die typisch für KI sind. Das Ergebnis ist eine Wahrscheinlichkeit, nie ein Beweis.
- Herkunftsnachweis heißt: Angaben zur Herkunft einer Datei, die schon beim Erstellen hinzugefügt werden. Ein Generator kann ein Wasserzeichen einbetten, ein verstecktes Signal im Inhalt selbst. Oder die Datei trägt Content Credentials, signierte Angaben darüber, wer oder was sie erstellt und bearbeitet hat.
Worauf Detektoren achten
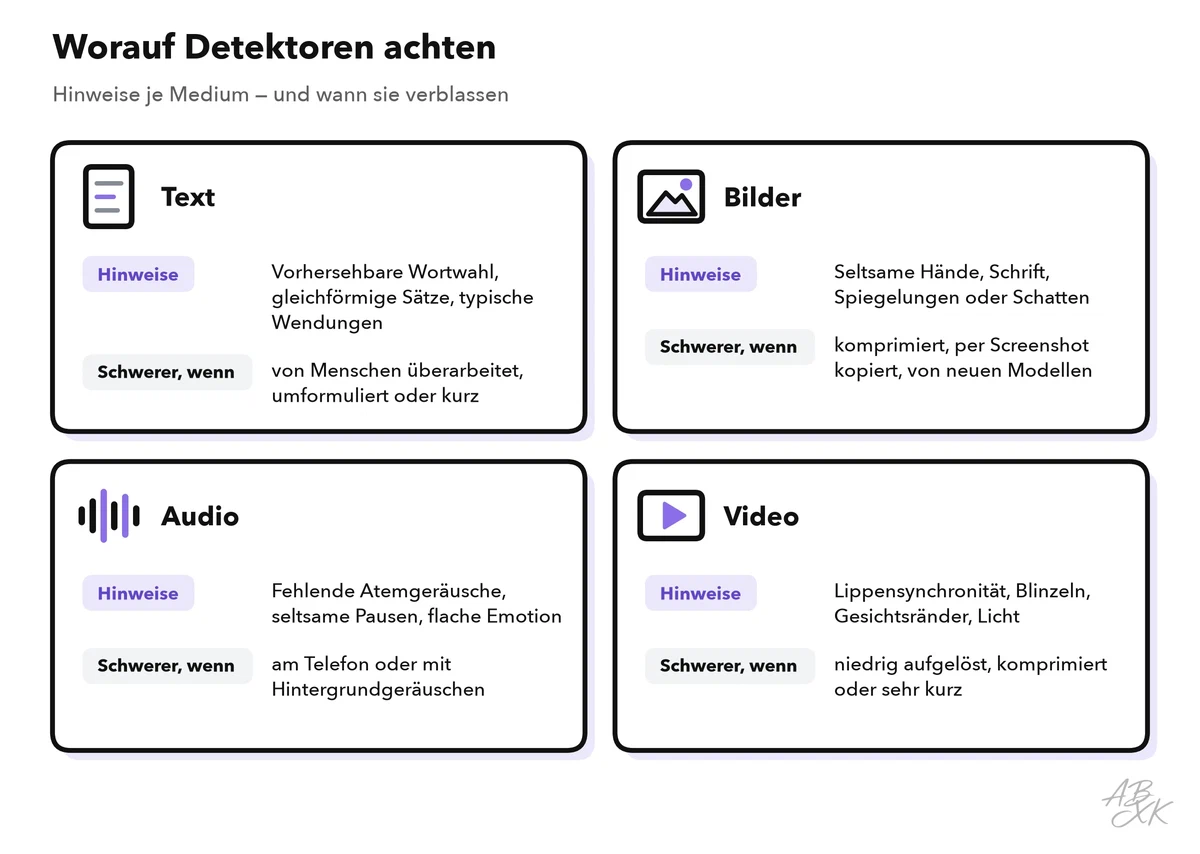
Detektoren arbeiten je nach Medium anders. Bei Text achten viele auf die Perplexität: wie vorhersehbar jedes nächste Wort für ein Sprachmodell ist. KI-Text ist meist glatt und vorhersehbar, mit ähnlich langen Sätzen und typischen Wendungen. Manche Detektoren messen solche Statistiken direkt; andere sind trainierte Modelle, die große Mengen menschlicher und KI-erzeugter Texte gesehen haben.
Unser eigener KI-Text-Detektor nutzt neun statistische Signale und läuft vollständig in Ihrem Browser. Unser Artikel darüber, wie der Detektor funktioniert, erklärt jedes Signal in einfachen Worten.
| Medium | Hinweise, die Detektoren nutzen | Was die Erkennung erschwert |
|---|---|---|
| Text | Vorhersehbare Wortwahl, gleichförmige Sätze, typische Wendungen | Menschliche Überarbeitung, Umformulierungs-Tools, kurze Texte |
| Bilder | Seltsame Hände, Schrift, Spiegelungen oder Schatten; Pixelmuster | Kompression, Screenshots, neuere Modelle |
| Audio | Fehlende Atemgeräusche, seltsame Pausen, flache Emotion | Telefonqualität, Hintergrundgeräusche |
| Video | Lippensynchronität, Blinzeln, Gesichtsränder, Licht | Geringe Auflösung, Kompression, kurze Clips |
Audio ist für Menschen der schwierigste Fall. In einer Studie am University College London hörten 529 Teilnehmende echte und KI-erzeugte Sprache auf Englisch und Mandarin. Sie erkannten die Fälschungen nur in 73 Prozent der Fälle, und ein Training half nur wenig, obwohl die falschen Stimmen mit älterer Technik erzeugt worden waren (Quelle: Mai et al., „Warning: Humans cannot reliably detect speech deepfakes“, PLOS ONE, 2023). Für Telefonate heißt das: Versuchen Sie nicht, die Stimme zu beurteilen. Prüfen Sie stattdessen die Forderung.
Unser Artikel Deepfakes erkennen geht tiefer auf die sichtbaren Hinweise und die Technik hinter der automatischen Erkennung ein.
Warum Detektoren Fehler machen
Ein Detektor kann in zwei Richtungen irren. Ein Falsch-positiv-Ergebnis ist ein menschlicher Text oder ein echtes Foto, das der Detektor als KI markiert. Ein Falsch-negativ-Ergebnis ist ein KI-Inhalt, der durchrutscht. Beides kommt vor, und die Zahlen sind ernüchternd.
OpenAI brachte Anfang 2023 einen eigenen Text-Klassifikator heraus. In OpenAIs Tests stufte er 26 Prozent der KI-geschriebenen Texte korrekt als „wahrscheinlich KI-geschrieben“ ein und markierte menschliche Texte in 9 Prozent der Fälle fälschlich als KI. Im Juli 2023 nahm OpenAI das Tool wegen geringer Genauigkeit vom Netz (Quelle: OpenAI, 2023, openai.com).
Detektoren können auch unfair sein. Forschende in Stanford testeten sieben Detektoren mit Aufsätzen, die Menschen mit Englisch als Fremdsprache für die TOEFL-Prüfung geschrieben hatten. Im Schnitt markierten die Detektoren 61 Prozent dieser menschlichen Aufsätze als KI-erzeugt, während sie Aufsätze von US-Achtklässlern fast fehlerfrei einordneten. Die Autoren vermuten, dass ein einfacherer Wortschatz für die Detektoren „vorhersehbar“ wirkt (Quelle: Liang et al., „GPT detectors are biased against non-native English writers“, Patterns, 2023).
Detektoren altern außerdem. Sie lernen die Muster der KI-Modelle, die es zum Zeitpunkt ihres Trainings gab. Erscheint ein neuer Generator, sehen seine Ergebnisse womöglich anders aus, und die Erkennung wird schlechter, bis der Detektor aktualisiert ist. Leichtes Überarbeiten wirkt ähnlich: Schon ein paar umformulierte Sätze können den Wert für einen Text deutlich senken.
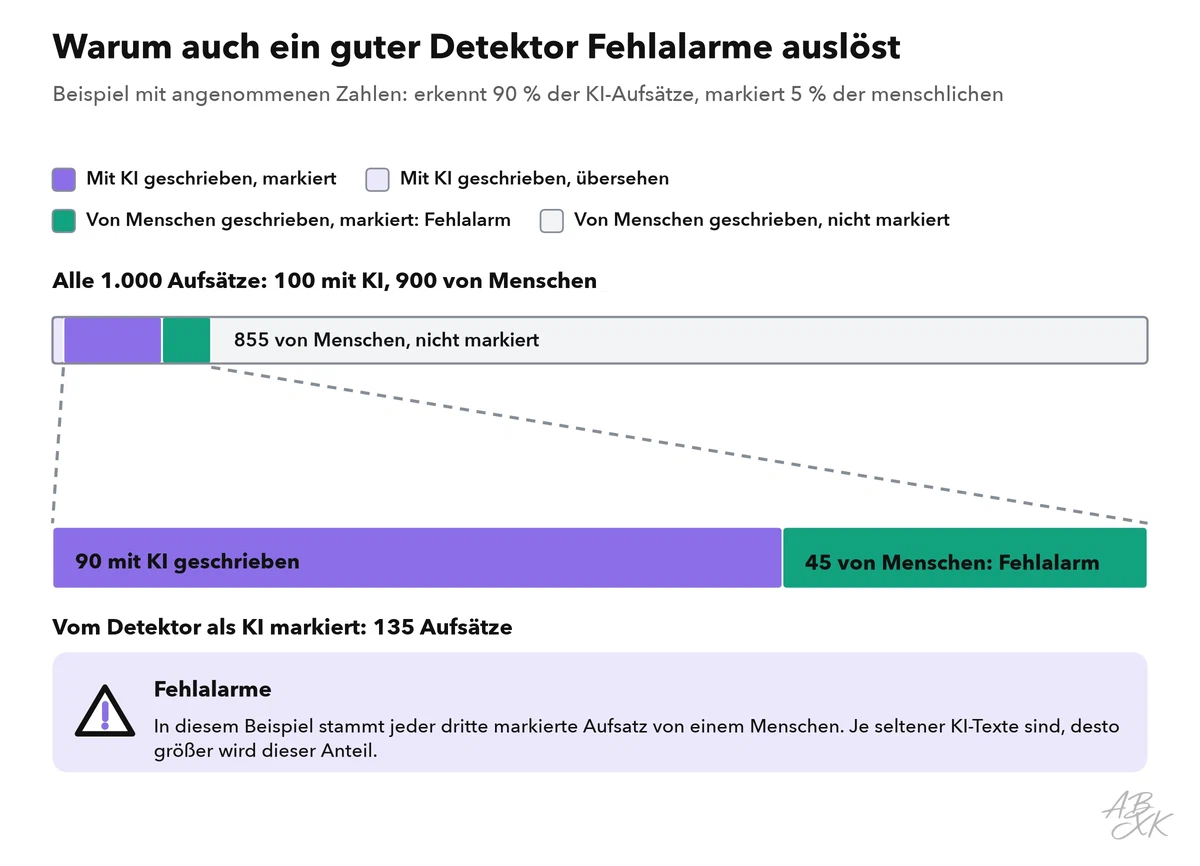
Und es gibt ein weiteres, weniger offensichtliches Problem: Selbst ein guter Detektor löst viele Fehlalarme aus, wenn die meisten Texte von Menschen stammen. Das Beispiel unten zeigt den Effekt mit angenommenen Zahlen.
Wasserzeichen und Content Credentials
Der Herkunftsnachweis kommt ohne Raten aus, aber nur, wenn der Generator mitmacht:
- Wasserzeichen. SynthID von Google DeepMind bettet ein unsichtbares Wasserzeichen in Inhalte von Googles KI-Modellen ein. Google gibt an, dass Bilder aus seinen Gemini-Bildmodellen es tragen und dass Sie ein Bild in die Gemini-App hochladen können, um zu fragen, ob es von Googles KI stammt (Quelle: Google, 2025, blog.google).
- Content Credentials. Sie folgen dem offenen Standard C2PA, kurz für Coalition for Content Provenance and Authenticity. Adobe versieht Bilder, die vollständig mit Firefly erzeugt wurden, automatisch damit (Quelle: Adobe-Hilfe, helpx.adobe.com). OpenAI fügt den Bildern, die es in ChatGPT erzeugt, C2PA-Metadaten hinzu (Quelle: OpenAI, 2025).
Beide haben Grenzen. Ein Wasserzeichen sagt nur etwas über Tools, die es verwenden, und starke Bearbeitungen können es schwächen. Content Credentials stecken in den Metadaten, und die gehen leicht verloren. OpenAI weist selbst darauf hin, dass die meisten sozialen Netzwerke Metadaten aus hochgeladenen Bildern entfernen und dass schon ein Screenshot sie löschen kann (Quelle: OpenAI Help Center, help.openai.com). Als Faustregel gilt: Ein gefundenes Wasserzeichen oder ein gefundener Nachweis ist ein starkes Indiz. Ein fehlender beweist nichts.
Die Bildgeneratoren unten kennzeichnen ihre Ergebnisse nach Angaben der Anbieter. Diese Angaben haben wir nicht überprüft.


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Wie Sie Detektoren fair einsetzen
Ein Detektor-Wert kann eine Frage eröffnen. Beantworten sollte er sie nie. Fünf Regeln helfen:
- Behandeln Sie den Wert als Hinweis, nicht als Beweis. Niemand sollte allein wegen eines Detektor-Werts beschuldigt, schlechter benotet oder abgelehnt werden.
- Prüfen Sie, ob der Text zum Tool passt. Kurze Texte und Sprachen, die das Tool nicht unterstützt, liefern unzuverlässige Ergebnisse. OpenAI bezeichnete seinen Klassifikator unter 1.000 Zeichen als unzuverlässig.
- Seien Sie vorsichtig bei Menschen, die nicht in ihrer Muttersprache schreiben, und bei förmlichen, technischen oder stark überarbeiteten Texten.
- Sammeln Sie weitere Belege. Entwürfe, Versionsverlauf, Quellen und ein Gespräch über den Inhalt sagen mehr als jeder Wert.
- Setzen Sie bei Bildern und Videos auf den Herkunftsnachweis. Suchen Sie nach Content Credentials, prüfen Sie Originalquelle und Datum und schauen Sie, ob vertrauenswürdige Medien dasselbe berichten.
Unser Detektor begrenzt seinen Wert auf 5 bis 95 Prozent, weil er nie Gewissheit behauptet. Pangram Labs bietet nach Angaben des Anbieters einen Detektor für Lehrende, Redaktionen und Unternehmen; wir haben ihn nicht getestet. Level 2 vergleicht Erkennungsmethoden ausführlich im Teil Wie KI-Detektoren arbeiten und wo sie versagen.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Übung: was ein Detektor beiträgt und was Sie zusätzlich brauchen
Erkennung ist ein Werkzeug unter mehreren. Die Tabelle zeigt, was sie in fünf typischen Situationen leisten kann und was nicht:
| Situation | Was ein Detektor beitragen kann | Was Sie zusätzlich brauchen |
|---|---|---|
| Eine Lehrerin vermutet, dass ein Aufsatz mit KI geschrieben wurde | Einen ersten Hinweis bei längeren Texten | Entwürfe, Versionsverlauf und ein Gespräch mit dem Schüler |
| Eine Personalerin zweifelt an einem Anschreiben | Sehr wenig: Viele überarbeiten Anschreiben mit KI | Den Inhalt selbst und ein Vorstellungsgespräch |
| Eine Redaktion erhält ein Video von einem Ereignis | Hinweise auf Manipulation; Content Credentials, falls vorhanden | Originalquelle, Datum, Ort und eine zweite, unabhängige Quelle |
| Ein Bild verbreitet sich nach einer Katastrophe | Ein Wasserzeichen oder einen Nachweis, falls vorhanden | Eine umgekehrte Bildersuche und Berichte vertrauenswürdiger Medien |
| Eine Familie bekommt eine Sprachnachricht mit einer Geldforderung | In Echtzeit fast nichts | Die Rückrufregel und das Codewort der Familie aus Teil 2 |