

Kaum ein Team baut ein KI-System von Grund auf. Es nimmt ein Modell von einem Anbieter oder aus einem Modell-Hub, ein Embedding-Modell, eine Vektordatenbank, Python-Pakete, Datensätze für das Fine-Tuning und Plugins, die einem Agenten seine Werkzeuge geben. Jedes dieser Teile stammt von jemand anderem, und jedes kann ein Risiko in Ihr System bringen. Zusammen bilden sie die KI-Lieferkette (AI Supply Chain). Sie abzusichern heißt: jedes Teil kennen, wissen, woher es kommt, und beurteilen, ob Sie ihm trauen können.
Dies ist Teil 4 von Level 3 (Profi) im Lernpfad AI Security. Sie lernen die wichtigsten Risiken der Lieferkette kennen — Modelldateien, die Code ausführen, vergiftete Daten, schädliche Plugins und Abhängigkeiten — und die Gegenmaßnahmen: sichere Formate, Signaturen, Model Cards, eine KI-Stückliste (AI-BOM) und einen Prüfprozess. Die OWASP Top 10 für LLM-Anwendungen aus Level 2 führen „Supply Chain“ und „Data and Model Poisoning“ als zwei eigene Risiken (Quelle: OWASP Top 10 for LLM Applications 2026, genai.owasp.org).
Die KI-Lieferkette im Überblick
Die Karte zeigt die Teile unseres Support-Assistenten, die von außen kommen. In der linken Spalte tritt das Risiko ein; die mittlere Spalte ist Ihre Chance, es aufzuhalten.
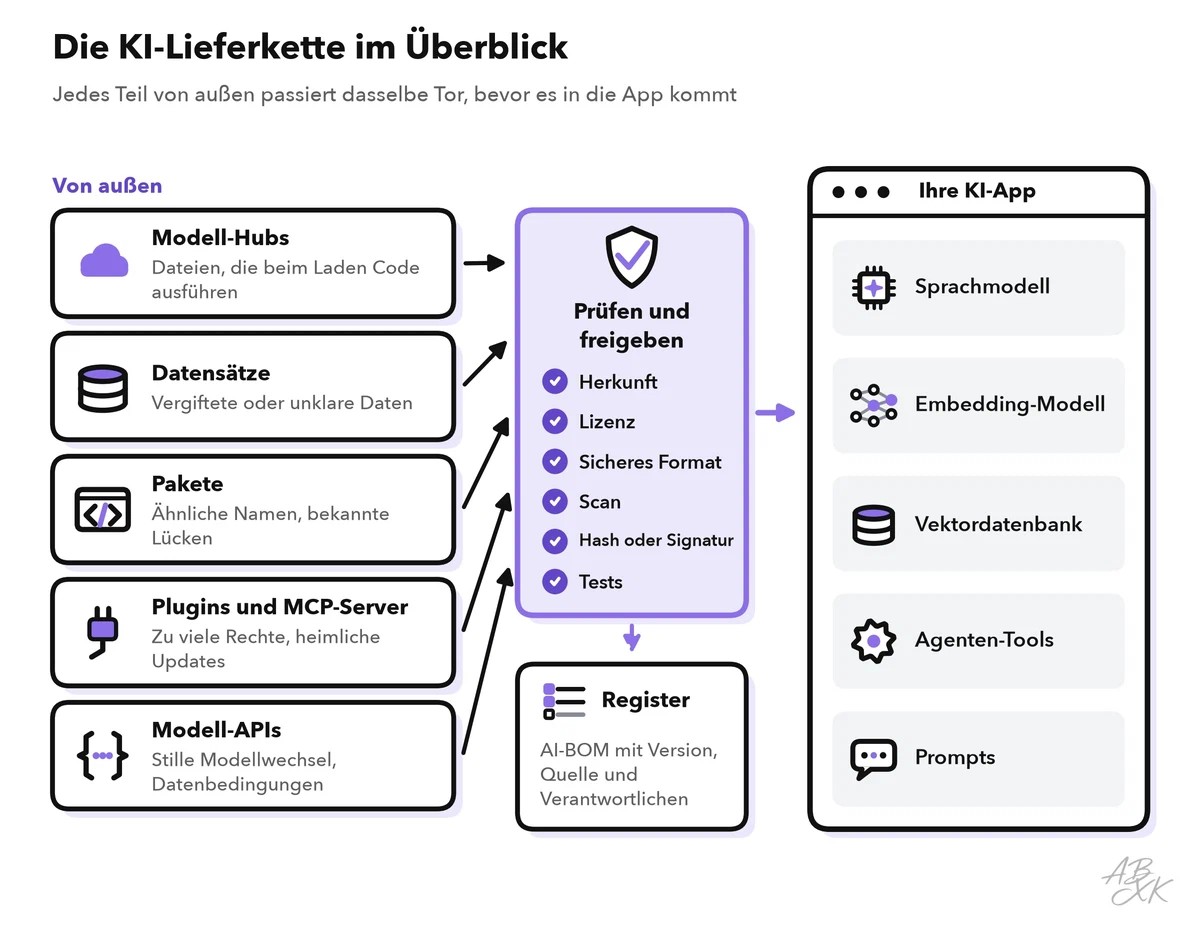
Aus der Karte folgen zwei Regeln:
- Wissen, was läuft. Führen Sie eine Liste aller Modelle, Datensätze, Pakete und Plugins, mit Version und Herkunft.
- Nichts geht ungeprüft in den Betrieb. Neue Teile und neue Versionen alter Teile passieren dasselbe Tor.
Modelldateien, die Code ausführen
Die Gewichte eines Modells sind nur Zahlen, doch das Dateiformat drumherum ist nicht immer harmlos. Viele ältere Modelldateien nutzen das Pickle-Format von Python. Pickle kann Anweisungen speichern, die beim Laden der Datei ausgeführt werden. Eine manipulierte Modelldatei zu laden kann also heißen, den Code eines Angreifers auf Ihrem Rechner auszuführen.
Das ist keine Theorie. Im Februar 2024 berichtete das Sicherheitsunternehmen JFrog, es habe auf der Plattform Hugging Face rund 100 Modelle mit schädlichem Code gefunden, der beim Laden lief (Quelle: JFrog Security Research, 2024, jfrog.com). Vier Gegenmaßnahmen helfen:
- Sichere Formate bevorzugen. Das Format safetensors, entwickelt von Hugging Face, speichert nur die Zahlen und kann keinen Code ausführen. Seit Version 2.6 (Januar 2025) lädt die Funktion
torch.loadvon PyTorch standardmäßig in einem eingeschränkten Modus: Sie lädt Gewichte und einfache Datentypen, aber keine beliebigen Objekte (Quelle: Release Notes zu PyTorch 2.6, pytorch.org). - Fremden Code nicht blind ausführen. Manche Modelle bringen eigenen Python-Code mit, und Ladeoptionen wie
trust_remote_codein der Bibliothek Hugging Face Transformers führen ihn aus. Nutzen Sie sie erst, wenn Sie den Code geprüft haben. - Neue Dateien isoliert laden. Öffnen Sie nicht vertrauenswürdige Modelldateien in einer Sandbox ohne Geheimnisse und ohne Netzwerkzugang, wie in Teil 2 dieses Levels beschrieben.
- Versionen genau festlegen. Verweisen Sie auf ein Modell über eine feste Revision oder einen Datei-Hash, nicht über „latest“. Ein Repository auf einem Modell-Hub kann sich ändern, nachdem Sie es geprüft haben.
Vergiftete Daten und versteckte Hintertüren
Data Poisoning (Datenvergiftung) heißt, Trainings- oder Fine-Tuning-Daten so zu manipulieren, dass das Modell etwas lernt, das es nicht lernen soll: falsche Fakten, eine Verzerrung oder eine versteckte Hintertür (Backdoor). Eine Hintertür ist ein Verhalten, das nur auftritt, wenn eine bestimmte Auslöserphrase vorkommt. In allen anderen Tests verhält sich das Modell normal — deshalb sind Hintertüren schwer zu finden.
Für eine Vergiftung braucht es weniger Daten, als viele annehmen. Die OWASP-Liste zitiert dazu eine Studie von 2025, wie Teil 1 von Level 2 erwähnt hat. Darin trainierten Anthropic, das britische AI Security Institute und das Alan Turing Institute Modelle mit 600 Millionen bis 13 Milliarden Parametern. Bei jeder Größe genügten 250 vergiftete Dokumente, um eine einfache Hintertür einzubauen — obwohl die größeren Modelle weit mehr saubere Trainingsdaten sahen (Quelle: Anthropic, „A small number of samples can poison LLMs of any size“, 2025, anthropic.com). Die Hintertür in dieser Studie war harmlos — sie brachte das Modell dazu, Kauderwelsch zu schreiben —, zeigt aber, dass Größe allein ein Modell nicht schützt.
In Ihrem eigenen System hat Vergiftung drei Einfallstore: das Basismodell, das Sie herunterladen, die Daten für das Fine-Tuning und die Dokumente in Ihrer RAG-Wissensbasis. Gegenmaßnahmen:
- Kennen Sie die Herkunft jedes Datensatzes: wer ihn erstellt hat, wann und wie die Daten gesammelt wurden. Datasheets for Datasets, ein von Forschenden vorgeschlagenes Dokumentationsformat, beschreiben genau das.
- Begrenzen Sie, wer Trainingsdaten und Wissensquellen ändern darf, und protokollieren Sie jede Änderung.
- Filtern Sie Daten, entfernen Sie Dubletten und prüfen Sie Stichproben von Hand.
- Testen Sie das Modell vor und nach dem Fine-Tuning mit demselben Evaluationsdatensatz und vergleichen Sie die Ergebnisse.
Level 4 behandelt Vergiftung und verwandte Angriffe ausführlich im Teil über Adversarial Machine Learning.
Plugins, Tools und Abhängigkeiten
Agenten bekommen ihre Fähigkeiten über Plugins und Tools, heute oft über das Model Context Protocol (MCP), einen offenen Standard, der Tools und Datenquellen mit KI-Assistenten verbindet. Ein Plugin läuft mit den Rechten, die Sie ihm geben, und seine Tool-Beschreibungen landen direkt im Kontext des Modells. Ein schädliches oder kompromittiertes Plugin kann deshalb Daten stehlen, Anweisungen in seinen Beschreibungen verstecken oder sein Verhalten mit einem Update ändern.
Auch klassische Software-Abhängigkeiten zählen. Python-Pakete, deren Namen bekannten Paketen ähneln — man spricht von Typosquatting —, können Schadsoftware enthalten. KI-Programmierassistenten schlagen manchmal Pakete vor, die es gar nicht gibt, und Angreifer können solche Namen registrieren. Level 1 erklärt dieses Risiko im Teil über Halluzinationen als Sicherheitsrisiko. Gegenmaßnahmen:
- Führen Sie eine Positivliste freigegebener Plugins und MCP-Server und installieren Sie nichts aus unbekannten Quellen.
- Prüfen Sie, welche Rechte jedes Plugin verlangt, und gewähren Sie nur das Nötigste.
- Legen Sie Versionen fest und prüfen Sie Updates, bevor Sie sie ausrollen.
- Nutzen Sie Lock-Dateien mit Hashes für Pakete sowie Software Composition Analysis (SCA), eine Art von Tool, das Abhängigkeiten auf bekannte Schwachstellen prüft.
Herkunftsnachweise: Model Cards, Signaturen und AI-BOMs
Vier Arten von Nachweisen sagen Ihnen, was Sie betreiben:
| Nachweis | Was er enthält | Welche Frage er beantwortet |
|---|---|---|
| Model Card | Zweck, Trainingsdaten, Evaluationen und Grenzen eines Modells | Passt dieses Modell zu meinem Einsatz? |
| Datasheet eines Datensatzes | Herkunft, Erhebungsmethode und Inhalt eines Datensatzes | Woher stammen diese Daten? |
| Hash oder Signatur | Ein kryptografischer Fingerabdruck der Dateien | Sind das genau die Dateien, die der Herausgeber veröffentlicht hat? |
| SBOM oder AI-BOM | Eine Bestandsliste aller Komponenten mit Versionen und Herkunft | Was genau steckt in meinem System? |
Model Cards wurden 2019 von Forschenden bei Google vorgeschlagen (Quelle: Mitchell et al., „Model Cards for Model Reporting“, 2019). Für Signaturen hat eine Arbeitsgruppe der Open Source Security Foundation (OpenSSF) 2025 Version 1.0 einer Bibliothek zum Signieren von Modellen veröffentlicht. Sie kann Modelldateien mit dem Projekt Sigstore signieren und die Signatur prüfen, bevor ein Modell geladen wird (Quelle: Sigstore-Blog, „Taming the Wild West of ML: Practical Model Signing with Sigstore“, 2025, blog.sigstore.dev). Eine Software-Stückliste (Software Bill of Materials, SBOM) führt alle Bestandteile einer Software auf; eine AI-BOM erweitert sie um Modelle und Datensätze. Beide verbreiteten SBOM-Standards decken inzwischen KI ab: CycloneDX mit seiner Machine-Learning-BOM und SPDX 3.0 mit seinen Profilen für KI und Datensätze.
Modelle mit offenen Gewichten: der größte Download
Viele Teams betreiben Open-Weight-Modelle — Modelle, deren Gewichte jeder herunterladen kann — auf eigenen Servern oder in einer GPU-Cloud. Unsere LLM-Datenbank führt 172 Modelle mit offenen Gewichten, von insgesamt 343 Modellen. Das Diagramm zeigt, wann sie erschienen sind:
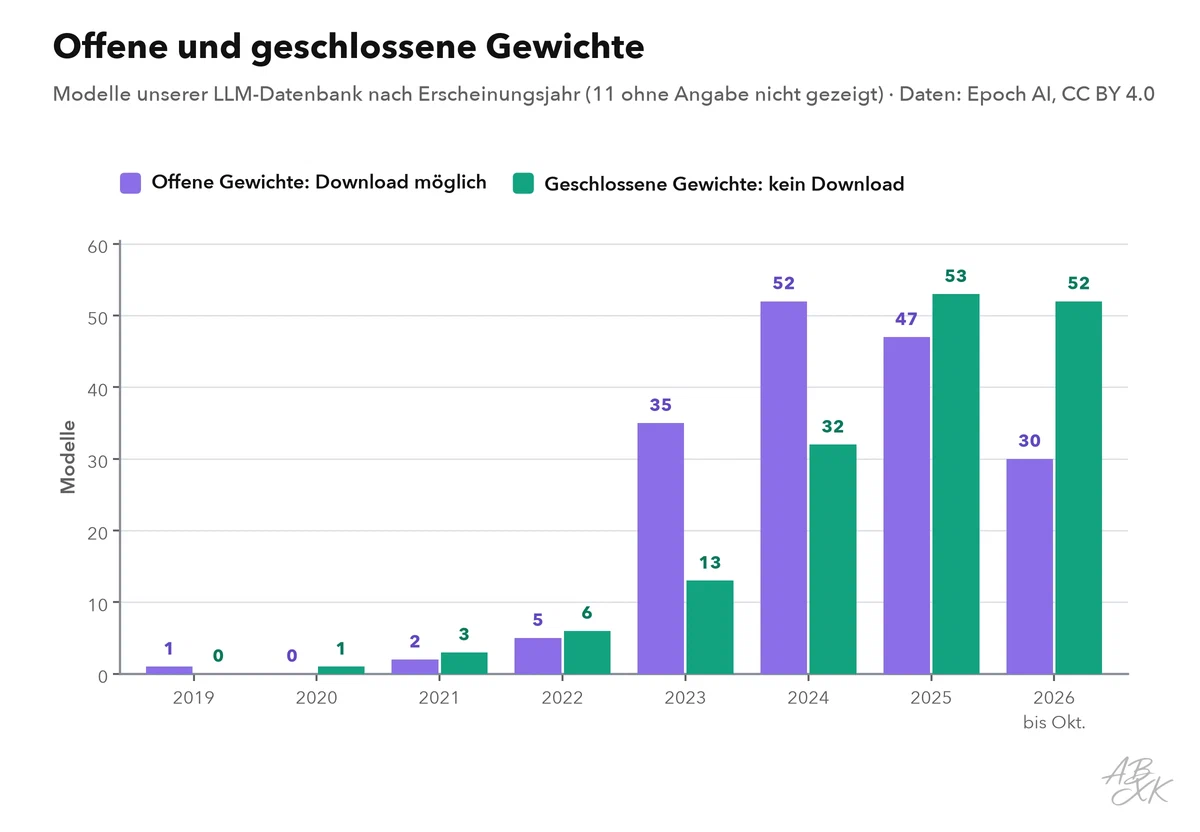
Jedes dieser Modelle ist ein großer Download aus einer fremden Quelle. Hier einige Beispiele aus unserer Datenbank mit ihrem Gesamtwert für die Leistungsfähigkeit:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Kimi K3 Moonshot | 16.07.2026 | offen | 157,4 | 17 |
| DeepSeek V4.1 Flash DeepSeek | 09.09.2026 | offen | 155,6 | 31 |
| Qwen 3.8 27B Alibaba | 14.08.2026 | offen | 151,6 | 52 |
| GLM-5.3-Flash Z.ai (Zhipu AI) | 20.08.2026 | offen | 153,2 | 45 |
| Llama 3-70B Meta AI | 18.04.2024 | offen | 122,9 | 191 |


ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Offene Gewichte sind an sich nicht unsicher. Mit einem Download wird die Prüfung der Lieferkette aber zu Ihrer Aufgabe. Bei einer API verwaltet der Anbieter die Modelldateien, und Ihre Prüfungen verlagern sich auf Vertrag, Datenbedingungen und Versionswechsel. Wenn Sie Modelle selbst betreiben — zum Beispiel in einer GPU-Cloud wie Runpod —, wenden Sie die Prüfliste unten auf jedes Modell und jedes Update an. Plattformen wie Airia helfen Unternehmen nach Angaben des Anbieters, die genutzten Modelle, Agenten und Tools abzusichern und zu steuern. Wir haben keines der beiden Tools getestet.


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Prüfliste für KI-Komponenten
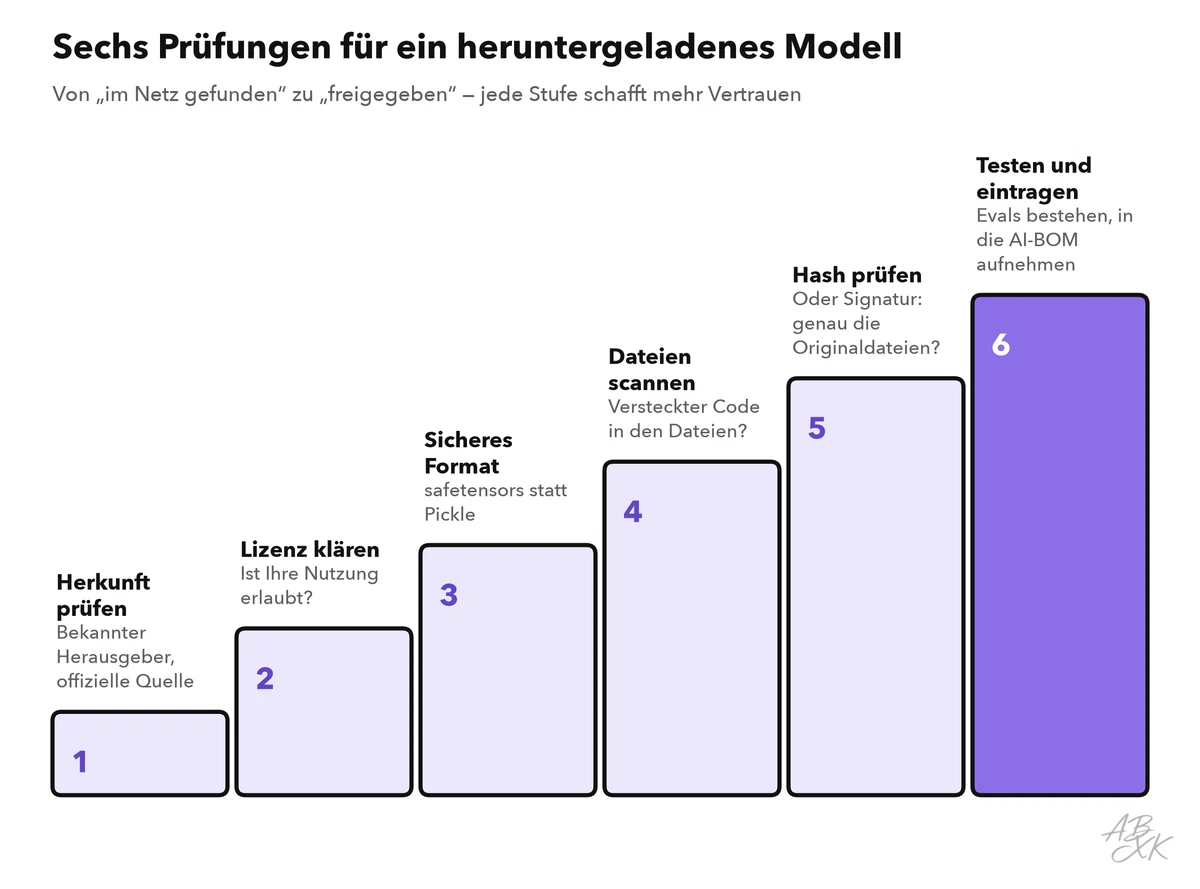
Die Treppe zeigt die Reihenfolge der Prüfungen für ein heruntergeladenes Modell; die Tabelle deckt alle Arten von Komponenten ab.
| Komponente | Vor der Nutzung prüfen | Nachweis, den Sie aufbewahren |
|---|---|---|
| Modellgewichte | Bekannter Herausgeber, Lizenz, Format safetensors, Scan, Hash oder Signatur | Model Card, Hash, Scan-Ergebnis |
| Modell-API | Vertrag und Datenbedingungen, festgelegte Modellversion, Ankündigung von Änderungen | Vertrag, Modellversion in den Logs |
| Datensätze | Herkunft, Lizenz, personenbezogene Daten, Prüfung auf Vergiftung | Datasheet, Stichprobenprüfung |
| Pakete | Exakte Namen, festgelegte Versionen mit Hashes, bekannte Schwachstellen | Lock-Datei, SCA-Bericht |
| Plugins und MCP-Server | Herausgeber, Rechte, festgelegte Version, Prüfung von Updates | Eintrag in der Positivliste, Rechteprüfung |
| Quellen der Wissensbasis | Wer schreiben darf, Prüfung neuer Quellen | Quellenliste, Änderungsprotokoll |
Jede freigegebene Komponente kommt mit Version, Herkunft und verantwortlicher Person in Ihre AI-BOM. Wird eine neue Schwachstelle oder ein schädliches Paket bekannt, beantwortet diese Liste innerhalb von Minuten die erste Frage der Incident Response für KI: Sind wir betroffen?