

Auch ein gut gebautes KI-System versagt irgendwann. Der Support-Assistent zeigt einer Kundin die Bestellung eines anderen Kunden. Eine versteckte Anweisung in einer E-Mail führt zu einer Erstattung. Ein Modell-Update verschlechtert die Antworten über Nacht, oder ein Paket in Ihrer Lieferkette erweist sich als schädlich. Incident Response, die geplante Reaktion auf Sicherheitsvorfälle, ist der vorbereitete Umgang mit solchen Ereignissen: sie früh bemerken, den Schaden begrenzen, die Ursache beheben und daraus lernen. Ein vorbereitetes Team braucht Minuten, um eine riskante Funktion abzuschalten. Ein unvorbereitetes Team verbringt diese Minuten mit der Suche nach der richtigen Person.
Dies ist Teil 5 von Level 3 (Profi) im Lernpfad AI Security. Sie lernen, was als KI-Vorfall zählt, welche Signale ihn verraten, was Sie protokollieren müssen, um ihn untersuchen zu können, und wie ein Playbook Sie durch fünf Schritte führt: eindämmen, bewerten, informieren, beheben und lernen. Der Teil nutzt die Audit-Logs aus Teil 2 und die AI-BOM aus Teil 4 und endet mit einem vollständigen Playbook für unseren Support-Assistenten.
Was als KI-Vorfall zählt
Die OECD definiert einen KI-Vorfall (AI Incident) als Ereignis, bei dem Entwicklung, Nutzung oder Fehlfunktion eines KI-Systems direkt oder indirekt zu einem Schaden führt. Der Schaden kann die Gesundheit von Menschen oder kritische Infrastruktur treffen. Er kann auch in der Verletzung von Menschenrechten oder von Gesetzen zum Schutz von Grundrechten, Arbeitnehmerrechten und geistigem Eigentum bestehen oder Eigentum, Gemeinschaften und Umwelt schädigen. Ein Ereignis, das plausibel zu einem solchen Schaden führen könnte, ist eine KI-Gefährdung (AI Hazard) (Quelle: OECD, „Defining AI incidents and related terms“, 2024, oecd.org).
Für ein Unternehmen taugt eine einfachere Regel: Behandeln Sie jedes Ereignis als Vorfall, bei dem ein KI-System Schaden anrichtet oder beinahe anrichtet. Dazu gehören Beinahe-Vorfälle (Near Misses) — Ereignisse, die gerade noch gestoppt wurden, etwa durch eine Freigabe. Sie zeigen, welche Kontrolle gegriffen hat und wie knapp es war. KI-Vorfälle fallen in drei Gruppen:
| Art | Beispiel beim Support-Assistenten | Typisches erstes Signal |
|---|---|---|
| Sicherheitsvorfall in Ihrem KI-System | Eine versteckte Anweisung in einer E-Mail bringt den Agenten dazu, Erstattungen vorzubereiten; ein API-Schlüssel gelangt nach außen; ein Plugin erweist sich als schädlich | Ein Alarm wegen ungewöhnlicher Tool-Aufrufe, eine Warnung eines Anbieters |
| Schädliche oder falsche Antworten | Der Assistent erfindet eine Rückgaberegel oder beleidigt einen Kunden | Eine Beschwerde, negatives Feedback, eine fehlgeschlagene Ausgabeprüfung |
| Angriff, der KI gegen Sie einsetzt | Eine geklonte Stimme der Geschäftsführerin verlangt eine dringende Zahlung; eine Welle KI-geschriebener Phishing-Mails | Eine Meldung von Beschäftigten, ein Alarm der E-Mail-Sicherheit |
Die zweite Gruppe wird leicht unterschätzt. 2024 entschied ein kanadisches Tribunal, dass Air Canada für eine falsche Auskunft seines Website-Chatbots haftet: Der Chatbot hatte einem Kunden gesagt, er könne einen Trauerfalltarif auch nach dem Flug noch rückwirkend beantragen, was die Regeln der Airline nicht vorsahen. Die Airline argumentierte, der Chatbot sei für seine Antworten selbst verantwortlich; das Tribunal folgte dem nicht (Quelle: Moffatt v. Air Canada, Civil Resolution Tribunal of British Columbia, 2024). Eine falsche Antwort kann ein Vorfall sein, auch ganz ohne Angreifer.
Die dritte Gruppe läuft über Ihren normalen Sicherheitsprozess; Level 1 erklärt Phishing im KI-Zeitalter. Der Rest dieses Teils konzentriert sich auf Vorfälle in Ihren eigenen KI-Systemen.
Erkennungssignale: wie Vorfälle sichtbar werden
Vorfälle kündigen sich selten an. Sie zeigen sich als kleine Signale an verschiedenen Stellen, und jemand muss sie zusammenführen:
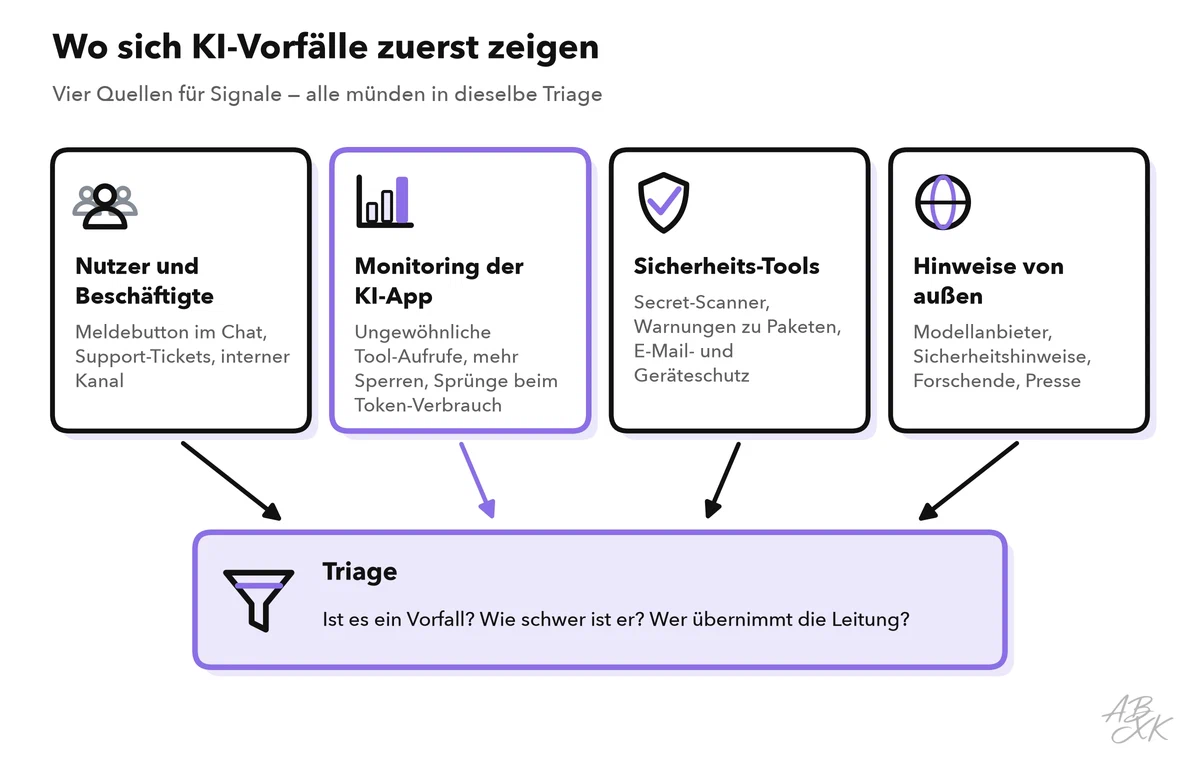
- Nutzer und Beschäftigte bemerken falsche oder seltsame Antworten zuerst. Machen Sie das Melden leicht: mit einem Button „Antwort melden“ im Chat und einem bekannten internen Kanal. Der Support sollte wissen, dass „der Bot hat mir eine Erstattung versprochen“ ein Vorfall sein kann und nicht nur eine Beschwerde.
- Das Monitoring der KI-App erkennt Muster, die kein einzelner Nutzer sieht: mehr Tool-Aufrufe als üblich, Erstattungen außerhalb der üblichen Beträge, mehr gesperrte Eingaben oder fehlgeschlagene Ausgabeprüfungen, viele Versuche eines Kontos, den System-Prompt auszulesen, oder einen plötzlichen Sprung beim Token-Verbrauch.
- Sicherheits-Tools decken die klassischen Wege ab: Scanner für veröffentlichte Geheimnisse, Warnungen zu verwundbaren Paketen, E-Mail-Sicherheit und Schutz für Firmengeräte.
- Hinweise von außen kommen von Modellanbietern, aus Sicherheitswarnungen, von Forschenden, die eine Schwachstelle melden, und manchmal aus der Presse.
Gute Alarme führen zu Handlungen. Lösen Sie einen Alarm nur aus, wenn jemand sofort handeln muss, geben Sie jedem Alarm eine verantwortliche Person und stellen Sie alles andere auf ein Dashboard. Richten Sie die Schwellen am Normalbetrieb aus: Bereitet der Assistent üblicherweise 20 Erstattungen am Tag vor, verdienen 60 in einer Stunde einen Blick (Zahlen zur Veranschaulichung). Zu viele Alarme führen zu Alarmmüdigkeit (Alert Fatigue): Die Beteiligten reagieren nicht mehr — so wie bei zu vielen Freigaben in Teil 2 niemand mehr hinsieht.
Manche Tools liefern einen Teil dieser Signale. Nach Angaben des Anbieters prüft Sentaro Kontext und Absicht von E-Mails und warnt vor Phishing; Bitdefender schützt Firmengeräte vor Ransomware, Phishing und dateilosen Angriffen. Airia ergänzt laut Anbieter Richtlinien und Prüfnachweise für KI-Agenten, Modelle und Tools. Wir haben diese Tools nicht getestet.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Welche Logs eine Untersuchung braucht
Wenn ein Vorfall beginnt, stellen sich sofort drei Fragen: Was ist passiert? Seit wann? Wer ist betroffen? Nur Logs können sie beantworten. Teil 2 hat aufgezählt, was ein Agent protokollieren sollte. Für die Incident Response zählen vier Eigenschaften der Logs ebenso viel wie ihr Inhalt:
- Verknüpfung: Jeder Schritt einer Anfrage trägt dieselbe Request-ID. So können Sie der Anfrage von der Chatnachricht über Suche und Tool-Aufrufe bis zur Antwort folgen.
- Versionen: Halten Sie zu jeder Anfrage die Modellversion, die Prompt-Version und den Stand der Wissensbasis fest. Ohne sie können Sie nicht nachstellen, was das System letzten Dienstag getan hat.
- Aufbewahrung: Vorfälle werden oft erst Wochen später entdeckt. Bewahren Sie sicherheitsrelevante Logs lange genug auf, um diese Lücke abzudecken, und stimmen Sie die Frist mit Ihrem Datenschutzbeauftragten ab, denn Logs enthalten personenbezogene Daten.
- Unveränderbarkeit: Speichern Sie Logs so, dass weder das KI-System noch seine Betreiber sie ändern können, und halten Sie fest, wer sie liest. Eine einheitliche Zeitzone für alle Systeme (UTC) macht eine Zeitleiste erst möglich.
| Frage bei der Untersuchung | Log-Daten, die sie beantworten |
|---|---|
| Welche Eingabe hat die Aktion ausgelöst? | Request-ID, Eingabe des Nutzers, IDs der gefundenen Dokumente, Tool-Aufrufe mit Argumenten |
| Seit wann passiert es? | Zeitstempel, Verlauf der Modell- und Prompt-Versionen, Änderungen an der Wissensbasis |
| Wer ist betroffen? | Nutzer- oder Kunden-IDs in Tool-Aufrufen und Antworten |
| Haben Daten das System verlassen? | Ausgehende Tool-Aufrufe und E-Mails, Links und Bilder in Antworten |
| Passiert es immer noch? | Live-Ansicht derselben Signale nach dem Eindämmen |
Allgemeines Monitoring von LLM-Apps — Traces, Dashboards, Kennzahlen zu Kosten und Qualität — ist ein eigenes Thema. Unser Bereich AI Development behandelt es aus Sicht der Entwicklung.
Das Playbook: eindämmen, bewerten, informieren, beheben, lernen
Ein Playbook ist ein schriftlicher Plan für eine Art von Vorfall: wer was tut, in welcher Reihenfolge, mit welchen Schaltern und welchen Kontakten. Es ersetzt nicht den allgemeinen Prozess Ihres Unternehmens für Sicherheitsvorfälle, sondern fügt sich in ihn ein. NIST SP 800-61 Revision 3 beschreibt einen solchen allgemeinen Prozess passend zum NIST Cybersecurity Framework 2.0. Der OWASP GenAI Incident Response Guide ergänzt, was bei KI-Systemen besonders ist (Quellen: NIST SP 800-61r3, 2025, nist.gov; OWASP GenAI Incident Response Guide 1.0, 2025, genai.owasp.org).
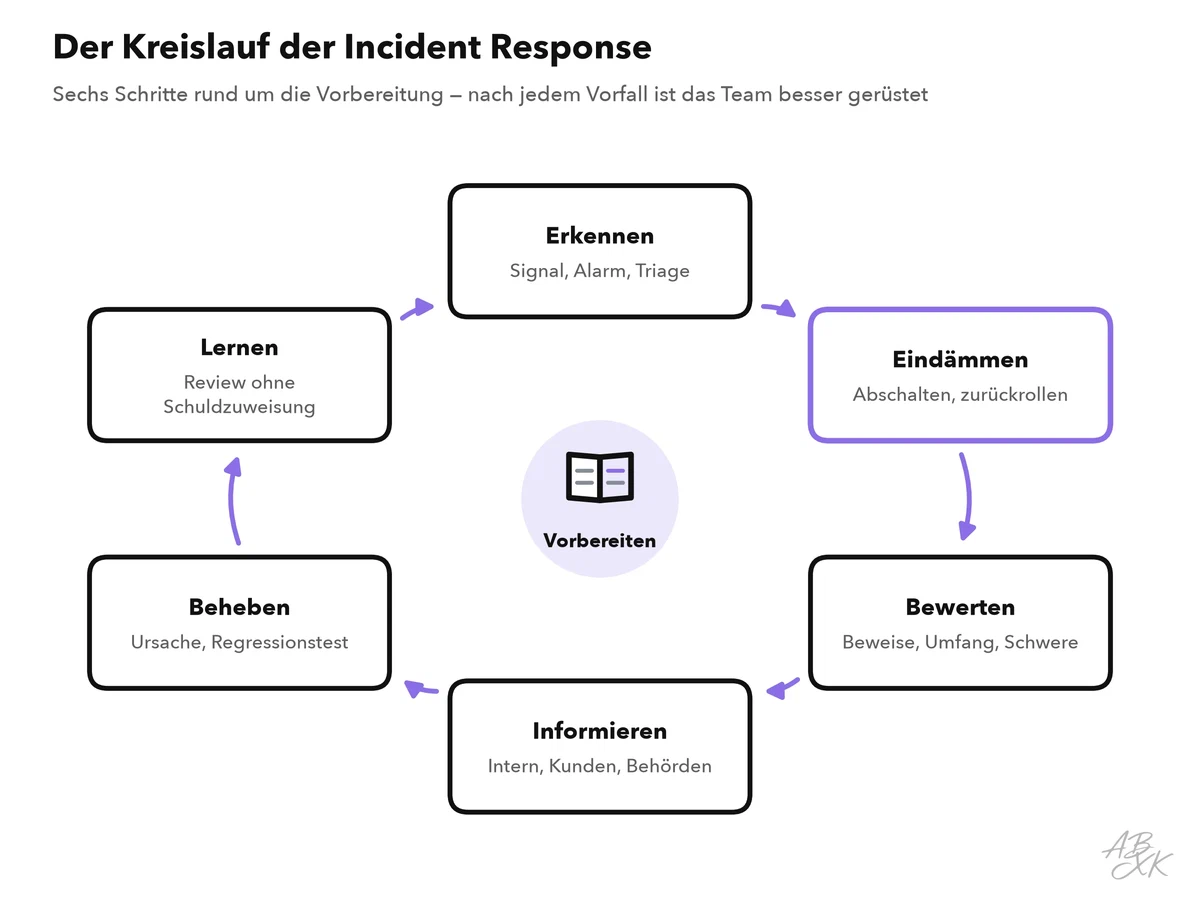
- Eindämmen. Erst den Schaden stoppen, dann untersuchen. Schalten Sie das betroffene Tool ab, versetzen Sie den Agenten in einen Modus, in dem er nur noch antwortet, rollen Sie den Prompt oder die Modellversion zurück, nehmen Sie ein vergiftetes Dokument aus dem Index, sperren Sie offengelegte Schlüssel oder blockieren Sie ein Konto.
- Bewerten. Sichern Sie die Beweise, bevor Sie weiter etwas ändern: Kopieren Sie die Logs und die betroffenen Dokumente. Rekonstruieren Sie dann anhand der Logs, was passiert ist, seit wann und wen es betrifft. Bewerten Sie den Schweregrad nach Auswirkung und Reichweite, wie bei der Risikobewertung in Teil 1.
- Informieren. Informieren Sie zuerst die Menschen im Unternehmen, die entscheiden oder handeln müssen. Dann diejenigen außerhalb, die es wissen müssen: betroffene Kunden, Anbieter und, wo das Gesetz es verlangt, Behörden. Nach der DSGVO muss eine Verletzung des Schutzes personenbezogener Daten in der Regel unverzüglich und möglichst binnen 72 Stunden, nachdem sie bekannt wurde, der Aufsichtsbehörde gemeldet werden. Der EU AI Act verpflichtet Anbieter von Hochrisiko-KI-Systemen zusätzlich, schwerwiegende Vorfälle zu melden. Klären Sie vorab mit Ihrer Rechtsabteilung, welche Pflichten für Sie gelten; Level 4 erklärt die rechtlichen Rahmen in KI-Governance-Rahmenwerke.
- Beheben. Beseitigen Sie die Ursache auf der richtigen Ebene: Design vor Rechten, Rechte vor Filtern, Filter vor Prompt-Formulierungen — dieselbe Reihenfolge, die Teil 3 für Befunde aus dem Red Teaming nutzt. Machen Sie aus dem Vorfall einen Regressionstest, nehmen Sie den Dienst dann Schritt für Schritt wieder in Betrieb und beobachten Sie die Signale genau.
- Lernen. Halten Sie innerhalb weniger Tage ein Review ohne Schuldzuweisung (Blameless Review): Was ist passiert, warum haben die Kontrollen es nicht verhindert, und was ändert sich? Suchen Sie nach schwachen Systemen und Prozessen, nicht nach einer schuldigen Person. Aktualisieren Sie anschließend das Threat Model, die Testfälle des Red Teaming und das Playbook selbst.
Rollen und Kommunikation
Ein Vorfall braucht klare Rollen, auch in einem kleinen Team, in dem eine Person mehrere davon übernimmt:
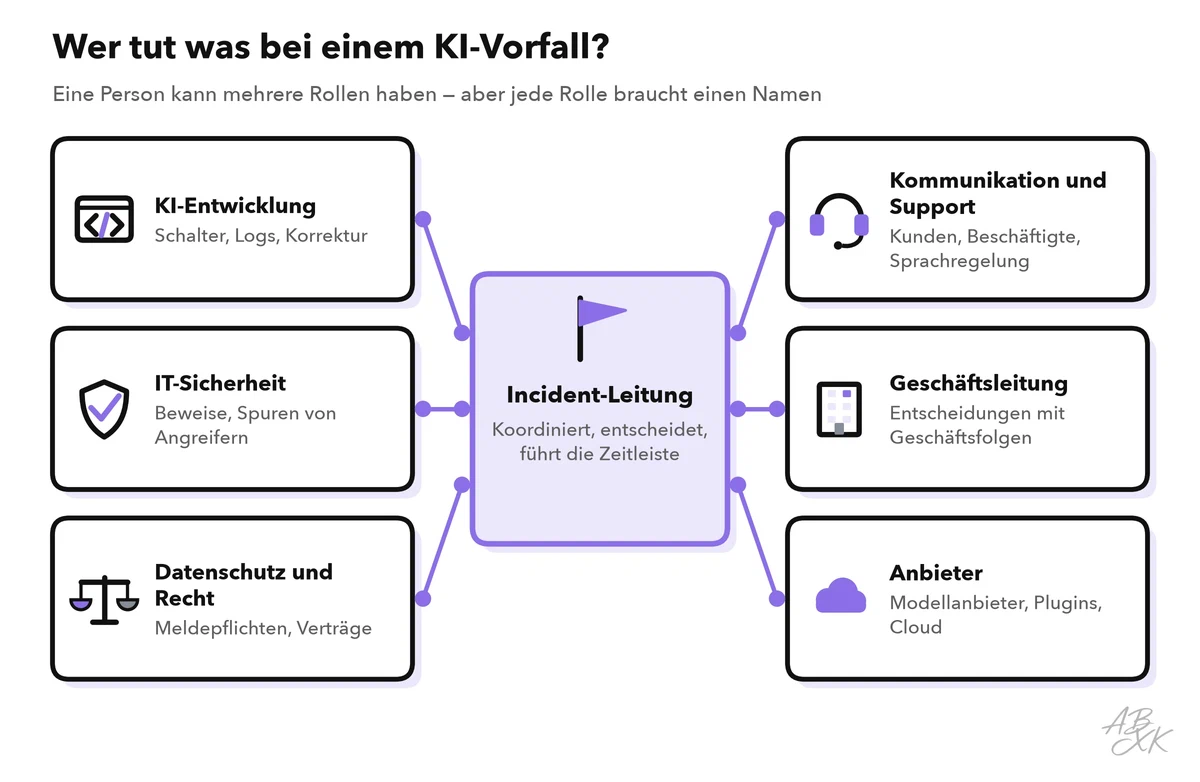
- Die Incident-Leitung koordiniert die Reaktion, trifft Entscheidungen und hält sie in einer Zeitleiste fest.
- Die KI-Entwicklung bedient die Schalter, liest die Logs und baut die Korrektur.
- Die IT-Sicherheit sichert die Beweise und sucht nach Spuren von Angreifern über das KI-System hinaus.
- Datenschutz und Recht entscheiden über Meldepflichten und prüfen Verträge.
- Kommunikation und Support informieren Kunden und Beschäftigte und geben dem Support eine kurze Sprachregelung.
- Die Geschäftsleitung trifft Entscheidungen mit Geschäftsfolgen, etwa eine Funktion für mehrere Tage abzuschalten.
- Anbieter — der Modellanbieter, die Herausgeber von Plugins, der Cloud-Anbieter — sollten früh von Ihnen hören. Sie sehen denselben Angriff womöglich auch bei anderen Kunden.
Für die Kommunikation gelten einige Regeln. Nutzen Sie einen eigenen Kanal und führen Sie dort das Entscheidungsprotokoll. Teilen Sie Details nur mit denen, die sie brauchen, denn ein Angreifer hat womöglich noch Zugriff. Sagen Sie, was Sie wissen, was Sie noch nicht wissen und wann das nächste Update kommt. Das NIST AI Risk Management Framework verlangt, Vorfälle und Fehler den relevanten KI-Akteuren mitzuteilen, einschließlich der betroffenen Gemeinschaften (Quelle: NIST AI RMF 1.0, MANAGE 4.3, 2023, nist.gov).
Sie können auch aus den Vorfällen anderer Organisationen lernen. Öffentliche Sammlungen wie die AI Incident Database und der AI Incidents and Hazards Monitor der OECD erfassen gemeldete Schäden durch KI. Die Fälle aus Ihrer Branche zu lesen, ist ein günstiger Weg, Ihre eigenen Playbooks zu prüfen.
Ein durchgespieltes Playbook: Eine versteckte Anweisung löst Erstattungen aus
Hier ist das Playbook für das größte Risiko aus Teil 1 dieses Levels: Eine E-Mail mit einer versteckten Anweisung bringt den Support-Assistenten dazu, Erstattungen für Bestellungen vorzubereiten, die keinen Anspruch darauf haben.
| Schritt | Was das Team tut | Wer |
|---|---|---|
| Erkennen | Ein Alarm schlägt an: dreimal so viele Erstattungen pro Stunde wie üblich. Eine Support-Mitarbeiterin meldet eine seltsame Erstattung | Rufbereitschaft der Technik |
| Eindämmen | Das Erstattungs-Tool abschalten, den Chat nur noch antworten lassen und die Verarbeitung eingehender E-Mails pausieren | Rufbereitschaft, freigegeben von der Incident-Leitung |
| Bewerten | Logs kopieren; die E-Mail über die IDs der gefundenen Dokumente finden; alle betroffenen Bestellungen auflisten; prüfen, ob schon Geld ausgezahlt wurde; nach ähnlichen E-Mails suchen | Incident-Leitung, IT-Sicherheit |
| Informieren | Das Zahlungsteam bitten, offene Erstattungen zu stoppen; die Geschäftsleitung informieren; den Datenschutzbeauftragten einbeziehen, falls Kundendaten offengelegt wurden | Incident-Leitung |
| Beheben | Das Tool bereitet Erstattungen nur noch vor, ein Mensch gibt sie frei; E-Mails gelangen nicht mehr in den gemeinsamen Kontext; eine harmlose Testanweisung wird zum Regressionstest | KI-Entwicklung |
| Lernen | Review ohne Schuldzuweisung innerhalb einer Woche; Threat Model, Testfälle des Red Teaming und dieses Playbook aktualisieren | Ganzes Team |