

Prompt Injection bekommt die Schlagzeilen, ist aber nur ein Weg, KI anzugreifen. Jedes Modell des maschinellen Lernens — ein Betrugsfilter, ein Spamfilter, eine Produktempfehlung oder ein großes Sprachmodell — lässt sich auch über seine Daten und seine Mathematik angreifen. Angreifer bauen Eingaben, die das Modell falsch einordnet, schleusen Fehler in seine Trainingsdaten ein oder schicken Anfragen, die das Modell kopieren oder verraten, was es gelernt hat. Dieses Fachgebiet heißt Adversarial Machine Learning (Adversarial ML), auf Deutsch etwa „Angriffe auf maschinelles Lernen“.
Dies ist Teil 2 von Level 4 (Experte) im Lernpfad AI Security. Sie lernen die wichtigsten Angriffsklassen entlang des Lebenszyklus eines Modells kennen, die Begriffe, die NIST dafür verwendet, und die Abwehrmaßnahmen, die wirken — und wo sie an Grenzen stoßen. Die Beispiele stammen aus dem Onlineshop dieses Levels: seinem Betrugsmodell, seinen Produktempfehlungen und seinem Support-Assistenten. Wie immer in diesem Lernpfad erklären wir Angriffe nur im Prinzip und zeigen keinen Angriffscode.
Eine gemeinsame Sprache: die NIST-Taxonomie
Die meistgenutzte Referenz ist NIST AI 100-2, „Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations“ (Quelle: NIST AI 100-2 E2025, März 2025, nist.gov). Teil 1 dieses Levels hat gezeigt, wie das übergreifende KI-Risikorahmenwerk von NIST aufgebaut ist. Die Taxonomie ordnet jeden Angriff nach vier Fragen:
- Ziel: Was will der Angreifer? NIST nennt drei Ziele: die Verfügbarkeit stören (das Modell fällt aus oder wird langsam), die Integrität verletzen (das Modell liefert die Ausgaben, die der Angreifer will) oder die Privatsphäre verletzen (der Angreifer erfährt etwas über die Trainingsdaten oder das Modell). Für generative KI ergänzt NIST den Missbrauch: ein Modell dazu bringen, was sein Anbieter verhindern will.
- Fähigkeit: Was kann der Angreifer steuern — Trainingsdaten, das Modell selbst, Eingaben im Betrieb oder nur Anfragen?
- Wissen: Bei einem White-Box-Angriff kennt der Angreifer das Modell samt seiner Gewichte. Bei einem Black-Box-Angriff kann er nur Eingaben senden und Ausgaben sehen. Gray-Box liegt dazwischen.
- Phase: Findet der Angriff im Training statt oder nach der Inbetriebnahme?
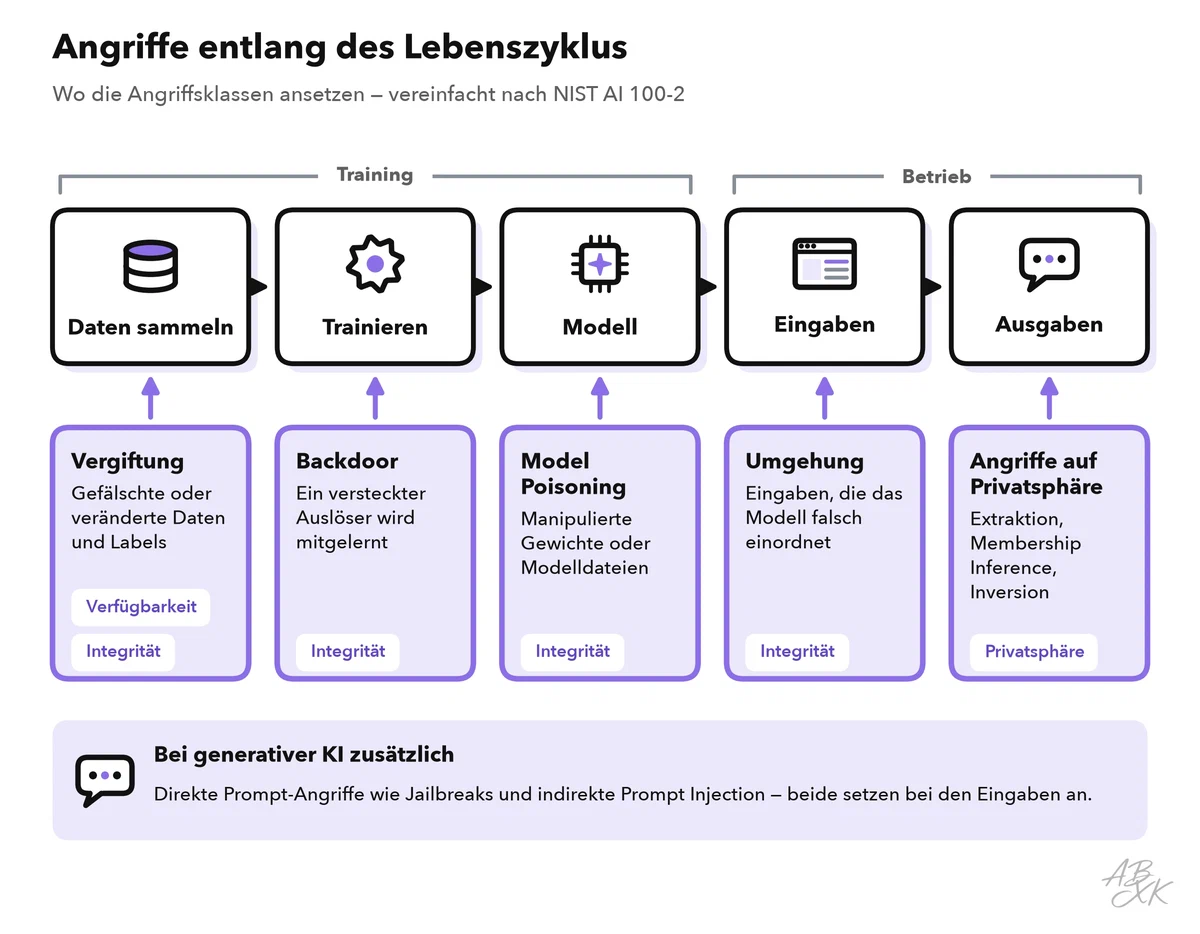
Für klassische Vorhersagemodelle wie Klassifikatoren und Scoring-Modelle unterscheidet NIST drei Klassen: Umgehung (Evasion), Vergiftung (Poisoning) und Angriffe auf die Privatsphäre. Für generative KI kommen direkte Prompt-Angriffe wie Jailbreaks und indirekte Prompt Injection hinzu. Die Abbildung ordnet die wichtigsten Klassen dem Lebenszyklus eines Modells zu.
Das Wissen verändert die Bedrohung stark. Ein Modell mit offenen Gewichten ist für alle eine White-Box, denn jeder kann die Gewichte herunterladen und untersuchen. Unsere LLM-Datenbank führt 172 Modelle mit offenen Gewichten. Diese Offenheit nützt Forschung und Selbstbetrieb, sie erlaubt Angreifern aber auch, ihre Eingaben offline zu testen, bevor sie Ihr System berühren.
Umgehung: Eingaben, die ein trainiertes Modell täuschen
Ein Umgehungsangriff (Evasion) verändert eine Eingabe im Betrieb so, dass ein trainiertes Modell falsch entscheidet. Die veränderte Eingabe heißt Adversarial Example. Um 2014 zeigten Forschende, dass kleine, gezielte Pixeländerungen einen Bildklassifikator ein Foto falsch benennen lassen, das für Menschen unverändert aussieht (Quelle: Szegedy et al., „Intriguing properties of neural networks“, ICLR 2014). Spätere Arbeiten übertrugen die Idee in die physische Welt: Einige Aufkleber ließen einen Klassifikator für Verkehrszeichen ein Stoppschild falsch lesen (Quelle: Eykholt et al., CVPR 2018).
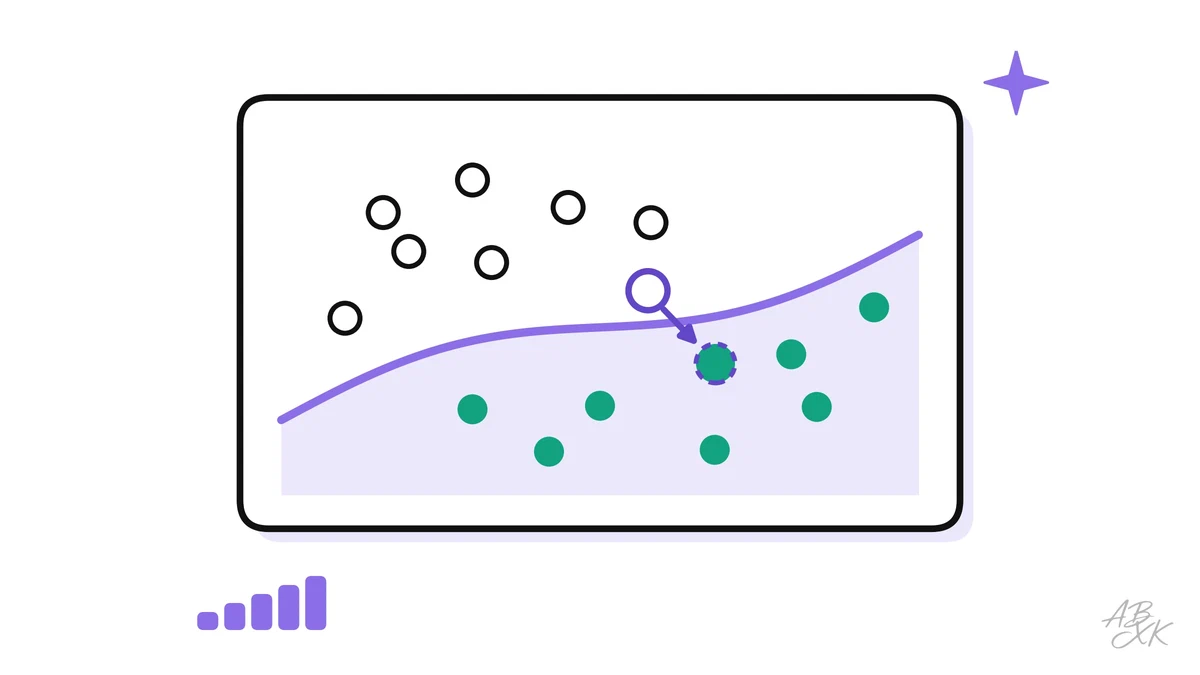
Warum funktioniert das? Ein Klassifikator trennt seine Eingaben mit einer Entscheidungsgrenze. Viele echte Eingaben liegen nah an dieser Grenze, und ein Modell hat sehr viele Dimensionen, in denen sich eine Eingabe bewegen kann. Ein kleiner Schritt in die richtige Richtung genügt, um die Grenze zu überqueren.
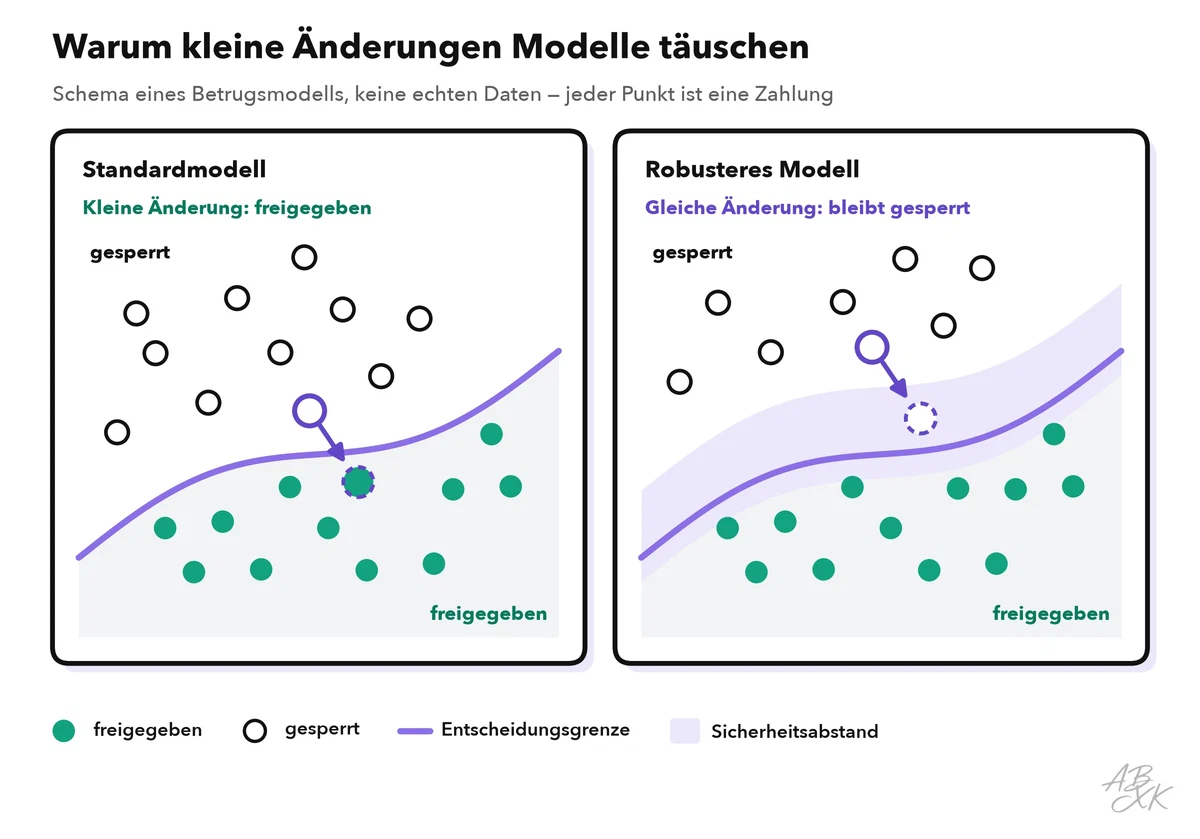
Umgehung betrifft nicht nur Bilder. Spam- und Phishing-Filter, Malware-Scanner, Betrugsmodelle und KI-Textdetektoren erleben sie täglich: Der Angreifer verändert die Eingabe, bis der Filter sie durchlässt. Beim Shop könnte eine Betrügerbande viele kleine Testbestellungen aufgeben, um zu lernen, welche Muster das Betrugsmodell freigibt — ein Black-Box-Angriff, der nur Geduld braucht. Wer einen KI-generierten Aufsatz mit einem Paraphrasier-Tool umschreibt, führt einen Umgehungsangriff gegen einen Detektor aus, wie unser Level-2-Teil Wie KI-Detektoren arbeiten und scheitern erklärt.
Auch Sicherheitsprodukte sind Systeme des maschinellen Lernens. Nach Angaben der Anbieter prüft Sentaro E-Mails auf Anzeichen von Phishing, und Bitdefender schützt vor Phishing und Ransomware. Pangram Labs schätzt wie unser eigener ABXK AI Text Detector, ob ein Text von einer KI stammt. Wenn Sie solche Tools vergleichen, fragen Sie, wie sie mit Angreifern umgehen, die sich anpassen, und wie oft ihre Modelle aktualisiert werden. Außer unserem eigenen Detektor haben wir diese Tools nicht getestet.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Abwehrmaßnahmen gibt es, aber keine ist vollständig:
- Adversarial Training nimmt Adversarial Examples in die Trainingsdaten auf. Das macht ein Modell robuster gegen die Angriffsarten aus dem Training, kostet aber Rechenzeit und oft etwas Genauigkeit bei normalen Eingaben (Quelle: Madry et al., ICLR 2018).
- Zertifizierte Abwehr beweist, dass keine Änderung unterhalb einer festgelegten Größe eine Entscheidung kippen kann — aber nur innerhalb dieses kleinen, definierten Rahmens.
- Systemdesign hilft am meisten: Kombinieren Sie den Modellwert mit Regeln und menschlicher Prüfung bei wertvollen Fällen, begrenzen Sie die Zahl der Anfragen und achten Sie auf Abtastversuche wie viele fast gleiche Anfragen.
Vorsicht bei Abwehrmaßnahmen, die nur stark aussehen. 2018 untersuchten Forschende neun Abwehrverfahren von einer großen Konferenz für maschinelles Lernen desselben Jahres. Sieben davon umgingen sie, sechs vollständig (Quelle: Athalye, Carlini und Wagner, ICML 2018). Testen Sie eine Abwehr immer gegen einen Angreifer, der sie kennt.
Vergiftung: Angriffe im Training
Ein Vergiftungsangriff (Poisoning) manipuliert Trainingsdaten oder das Modell, sodass es das Falsche lernt. NIST unterscheidet vier Arten. Availability Poisoning verschlechtert das ganze Modell. Targeted Poisoning ändert das Ergebnis für bestimmte Eingaben. Backdoor Poisoning baut einen versteckten Auslöser ein, der das falsche Verhalten einschaltet. Model Poisoning manipuliert das Modell selbst, etwa seine Gewichte.
Backdoors sind am gefährlichsten, weil sich das Modell normal verhält, bis der Auslöser auftaucht. In einer frühen Demonstration hielt ein manipulierter Klassifikator für Verkehrszeichen Stoppschilder für Tempolimit-Schilder, sobald ein kleiner Aufkleber darauf war (Quelle: Gu et al., „BadNets“, 2017). Level 3 hat den bekanntesten neueren Fall für Sprachmodelle beschrieben. In einer Studie von 2025 pflanzten etwa 250 vergiftete Dokumente Modellen jeder getesteten Größe eine Backdoor ein, von 600 Millionen bis 13 Milliarden Parametern (Quelle: Anthropic, UK AI Security Institute und The Alan Turing Institute, 2025, anthropic.com). Für Ihr Threat Model ändert das eine Annahme. Ein Angreifer muss keinen Anteil Ihrer Daten kontrollieren, denn eine kleine, feste Zahl von Dokumenten kann genügen. Die getestete Backdoor war allerdings eng gefasst: Sie ließ die Modelle Kauderwelsch schreiben, und die Autoren weisen darauf hin, dass komplexeres oder schädlicheres Verhalten anders funktionieren könnte.
Der Shop hat mehrere Angriffsflächen für Vergiftung. Gefälschte Bewertungen und gefälschte Kaufhistorien können die Empfehlungen verschieben. Rückbuchungen liefern die Labels für das Betrugsmodell; wer falsche Labels auslösen kann, bringt ihm die falschen Muster bei. Hilfeartikel speisen den Suchindex des Assistenten. Heruntergeladene Modelle und Datensätze bringen die Lieferkettenrisiken aus Level 3 mit.
Die Grundlagen der Datenhygiene hat Level 3 genannt: wissen, woher Daten stammen, kontrollieren, wer sie ändern darf, und sie vor dem Training filtern und deduplizieren. Gegen einen entschlossenen Angreifer kommen drei Maßnahmen hinzu:
- Einfluss begrenzen: Deckeln Sie, wie viel ein einzelner Nutzer, eine Quelle oder ein Kunde beitragen kann, damit wenige gefälschte Konten das Modell nicht verschieben.
- Vertrauenswürdige Testsets, die Angreifer nicht erreichen, und Prüfungen auf unerwartete Auslöser vor jedem Release.
- Rollback: Bewahren Sie geprüfte Stände von Daten und Modellen auf, geschützt durch Hashes oder Signaturen, um sauber neu trainieren zu können.
Angriffe auf die Privatsphäre: Extraktion, Membership Inference, Inversion
Angriffe auf die Privatsphäre finden nach der Inbetriebnahme statt, und oft brauchen sie nichts als gewöhnliche Anfragen.
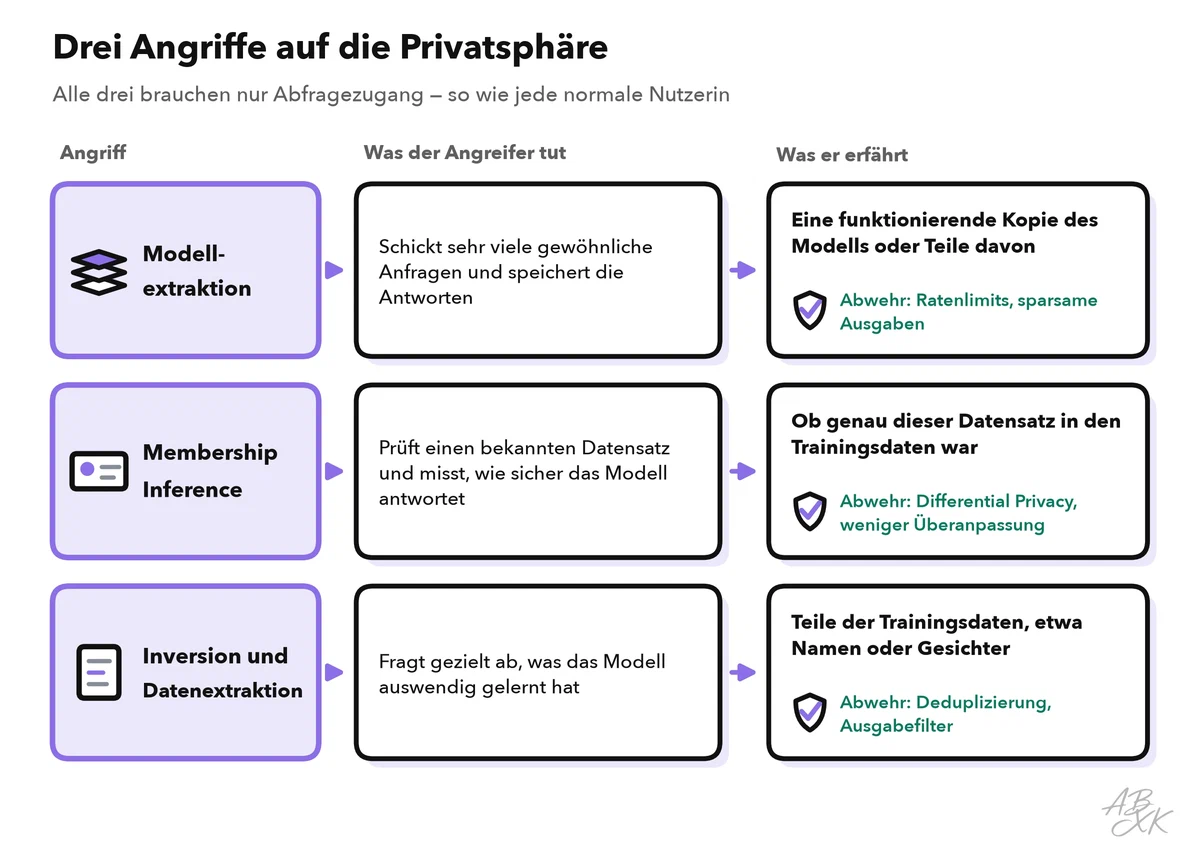
- Modellextraktion kopiert das Verhalten eines Modells oder Teile davon über seine API. Für kommerzielle Vorhersage-APIs zeigten Forschende das 2016 (Quelle: Tramèr et al., USENIX Security 2016). 2024 rekonstruierte ein Team eine vollständige Schicht zweier produktiver Sprachmodelle von OpenAI mit gewöhnlichen API-Anfragen (Quelle: Carlini et al., „Stealing Part of a Production Language Model“, ICML 2024). Eine gestohlene Kopie ist mehr als verlorenes geistiges Eigentum: Sie macht aus einem Black-Box-Angriff einen White-Box-Angriff, weil der Angreifer Umgehungseingaben nun offline bauen kann.
- Membership Inference stellt fest, ob ein bestimmter Datensatz Teil der Trainingsdaten war (Quelle: Shokri et al., IEEE S&P 2017). Das zählt, wenn schon die Zugehörigkeit sensibel ist — etwa wenn ein Modell nur mit Daten von Patientinnen und Patienten mit einer bestimmten Krankheit trainiert wurde.
- Modellinversion und Datenextraktion rekonstruieren Trainingsdaten aus den Antworten eines Modells. Forschende erzeugten erkennbare Gesichtsbilder aus einem Gesichtserkennungsmodell (Quelle: Fredrikson et al., CCS 2015). Andere extrahierten wörtliche Texte samt Namen und Kontaktdaten aus den Trainingsdaten von GPT-2 (Quelle: Carlini et al., USENIX Security 2021).
Die wichtigsten Gegenmaßnahmen: So wenig wie möglich zurückgeben — etwa ein Label statt eines vollständigen Wahrscheinlichkeitswerts —, Anfragen begrenzen und überwachen, Trainingsdaten deduplizieren und mit Differential Privacy trainieren. Teil 3 dieses Levels erklärt Differential Privacy und weitere datenschutzfreundliche KI-Techniken.
Abwehr den Angriffen zuordnen
Die Tabelle führt die Klassen zusammen. Prüfen Sie damit, welche Klassen für jedes Modell zählen und ob Sie gegen jede mindestens eine Maßnahme haben.
| Angriffsklasse | Wann | Was der Angreifer braucht | Wichtigste Abwehr | Bekannte Grenzen |
|---|---|---|---|---|
| Umgehung | Betrieb | Abfragezugang; mehr mit Wissen über das Modell | Adversarial Training, Regeln und menschliche Prüfung, Ratenlimits, Überwachung | Angreifer passen sich an; Robustheit kann Genauigkeit kosten |
| Vergiftung und Backdoors | Training | Schreibzugriff auf Daten, Labels oder Modell | Herkunft, Zugriffskontrolle, Filter, vertrauenswürdige Testsets, Rollback | Wenige Beispiele können genügen |
| Modellextraktion | Betrieb | Viele Anfragen | Ratenlimits, Überwachung der Anfragen, sparsame Ausgaben, Vertragsklauseln | Langsame, verteilte Anfragen fallen kaum auf |
| Membership Inference | Betrieb | Anfragen und ein Kandidaten-Datensatz | Differential Privacy, weniger Überanpassung, sparsame Ausgaben | Mehr Schutz kann Genauigkeit kosten |
| Inversion und Datenextraktion | Betrieb | Anfragen | Deduplizierung, Differential Privacy, Ausgabefilter für personenbezogene Daten | Seltene, auswendig gelernte Daten bleiben gefährdet |
NIST beschreibt den Stand des Fachs offen. Die meisten Abwehrverfahren sind empirisch: Man nutzt sie, weil sie in der Praxis zu wirken scheinen, nicht weil sie Sicherheitsbeweise mitbringen. Neue Angriffstechniken können sie brechen. Deshalb gehören Überwachung und ein schneller Weg zurück zu einem geprüften Stand in jeden Plan.
Übung: Angriffsklassen für ein Modell durchgehen
Wählen Sie ein Modell, das Ihre Organisation betreibt oder einkauft — beim Shop ist das Betrugsmodell ein guter Anfang. Gehen Sie mit der verantwortlichen Person fünf Fragen durch:
- Ziel: Welche Angreiferziele zählen — Betrug am Modell vorbeibringen (Integrität), gute Kunden sperren lassen (Verfügbarkeit) oder über das Modell etwas über Kunden erfahren (Privatsphäre)?
- Wissen: Was können Außenstehende erfahren? Lässt sich das Modell herunterladen, liefert die API Wahrscheinlichkeitswerte, sind die Entscheidungsregeln öffentlich?
- Daten: Welche Trainingsdaten oder Labels können Außenstehende beeinflussen, und wie schnell erreichen neue Daten das Modell?
- Tests: Welche Robustheitstests laufen vor jedem Release? Open-Source-Bibliotheken wie die Adversarial Robustness Toolbox unterstützen solche Tests — setzen Sie sie nur auf Systeme an, die Ihnen gehören oder die Sie testen dürfen.
- Signale: Welche Überwachung würde Abtasten, Vergiftung oder Extraktion zeigen — Anfragen pro Konto, fast gleiche Anfragen, plötzliche Verschiebungen der Entscheidungen?