
Deepfakes haben sich von offensichtlichen Fälschungen zu nahezu perfekten synthetischen Medien entwickelt, die selbst geschulte Augen täuschen. Weil Generative Adversarial Networks und Diffusionsmodelle immer besser werden, verschärft sich das Wettrennen zwischen Erzeugung und Erkennung. Wer Bild- und Videomaterial prüfen muss, sollte deshalb sowohl die manuelle Prüfung als auch automatische Erkennungssysteme verstehen.
Bei ABXK.AI beschäftigen wir uns mit KI-Erkennung. Unser KI-Text-Detektor spürt KI-generierte Texte mit statistischer Analyse und Mustererkennung auf. Dasselbe Prinzip — feine Muster finden, die menschliche von maschinell erzeugten Inhalten unterscheiden — gilt auch für Bilder und Videos; dieser Beitrag erklärt die technischen Grundlagen.
Was Menschen erkennen können
Bildfehler und Unstimmigkeiten
Am einfachsten ist die Suche nach Bildfehlern, die Deepfake-Generatoren nur schwer sauber nachbilden. Achten Sie auf Asymmetrien im Gesicht, besonders um Augen und Mund, wo komplexe Muskelbewegungen stattfinden. Deepfakes zeigen oft feine Verzerrungen an den Gesichtsrändern, vor allem am Haaransatz und an der Kieferlinie, wo das gefälschte Gesicht auf den Originalhintergrund trifft.
Auch die Beleuchtung verrät viel. Beobachten Sie, wie das Licht auf verschiedenen Gesichtspartien reflektiert — Deepfakes haben oft widersprüchliche Lichtrichtungen oder falsch gesetzte Schatten. Die Haut wirkt mitunter unnatürlich glatt oder zeigt sich wiederholende Muster, die eher auf einen Algorithmus als auf echte Poren und kleine Unebenheiten hindeuten.
Unstimmige biologische Signale
Der menschliche Körper erzeugt feine Muster, an denen Deepfake-Algorithmen lange gescheitert sind. Das Blinzeln ist eines der verlässlichsten Merkmale: Echte Menschen blinzeln 15- bis 20-mal pro Minute in typischen Abständen. Frühe Deepfakes blinzelten auffällig selten, weil die Trainingsdaten überwiegend Bilder mit offenen Augen enthielten. Heutige Deepfakes sind hier besser geworden, doch Timing und Abstimmung des Blinzelns mit dem Sprechen sind weiterhin oft unstimmig.
Achten Sie auf Atmung und kleine Bewegungen. Echte Menschen korrigieren ständig minimal ihre Haltung, der Brustkorb hebt und senkt sich, der Kopf bewegt sich natürlich. Deepfakes frieren diese Bewegungen häufig ein oder wirken unnatürlich ruhig. Auch der Puls, der sich per Remote-Photoplethysmographie in der Gesichtshaut messen lässt, liefert Hinweise: Echte Videos zeigen periodische Farbänderungen im Takt des Herzschlags, die bei Deepfakes gestört sind oder ganz fehlen.
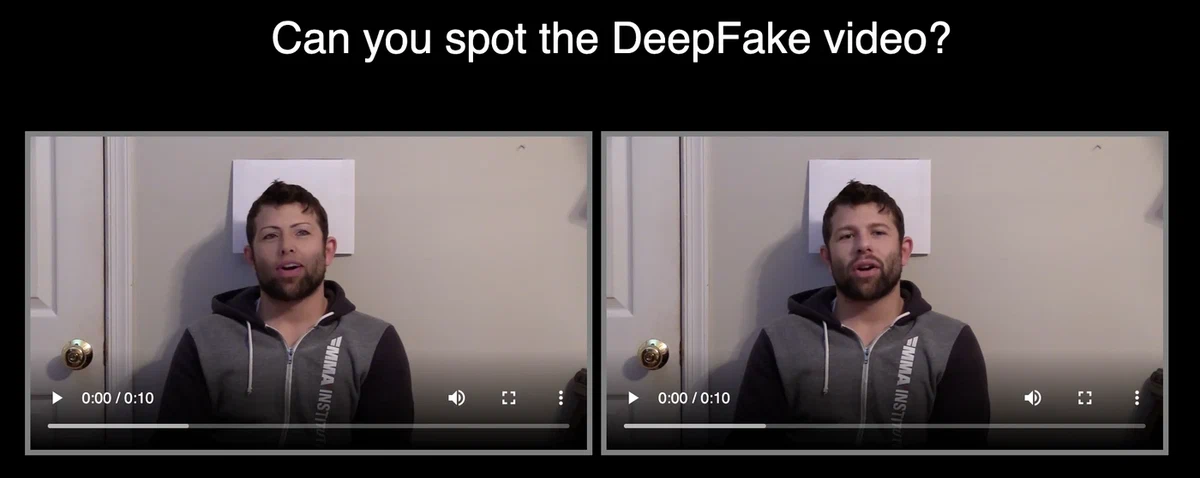
Oberfläche des Forschungsprojekts Detect Fakes am MIT Media Lab. Bildquelle, lizenziert unter CC BY 4.0.
Technische Erkennungssysteme
Ansätze mit Convolutional Neural Networks
CNN-basierte Detektoren bilden die Grundlage der meisten automatischen Deepfake-Erkennungen. Diese Netze analysieren räumliche Merkmale auf mehreren Skalen, um Spuren von Manipulation zu finden. Besonders verbreitet ist die XceptionNet-Architektur, die mit tiefenweise separierbaren Faltungen feine Fälschungsspuren effizient erfasst.
Trainiert werden die CNNs mit großen Datensätzen aus echten und manipulierten Bildern. Dabei lernt das Netz, Kompressionsartefakte, Farbunstimmigkeiten und Kantenprobleme zu erkennen, die beim Gesichtstausch entstehen. Entscheidend sind die Zwischenschichten: Statt Bilder nur zu klassifizieren, erzeugen sie Merkmalskarten, die Bereiche mit ungewöhnlichen statistischen Eigenschaften hervorheben. So hinterlassen etwa die Upsampling-Schritte in GAN-Generatoren bestimmte Frequenzmuster, die ein CNN erkennen lernen kann.
Eine Mehrskalen-Analyse verbessert die Erkennung, weil sie Bilder gleichzeitig in verschiedenen Auflösungen untersucht. Deepfakes sind oft nicht über alle Skalen stimmig: In normaler Betrachtung wirken sie überzeugend, bei höherer oder niedrigerer Auflösung zeigen sich Artefakte. CNNs verarbeiten dafür pyramidenförmig aufgebaute Eingaben und erfassen diese Unterschiede gezielt.
Analyse im Frequenzbereich
Die Frequenzanalyse nutzt eine grundlegende Schwäche generativer Modelle: Sie können die Frequenzverteilung natürlicher Bilder nicht perfekt nachbilden. Echte Fotos tragen eine Frequenzsignatur, die von Kamerasensor, Objektiv und der Physik des Lichts geprägt ist. Von neuronalen Netzen erzeugte Deepfakes haben andere Frequenzeigenschaften.
Für die Erkennung werden Bilder per diskreter Fourier- oder Kosinustransformation vom Ortsbereich in den Frequenzbereich überführt. Echte Bilder zeigen ein glattes Spektrum mit fließenden Übergängen zwischen hohen und niedrigen Frequenzen. Deepfakes dagegen haben unregelmäßige Muster: harte Brüche im Frequenzraum, auffällige Energiekonzentrationen oder fehlende Frequenzanteile, die natürliche Bilder enthalten.
Kombiniert man die Frequenzanalyse mit räumlichen CNNs, entstehen hybride Detektoren mit besserer Trefferquote. Sie gewinnen Frequenzmerkmale über Transformationen und speisen Frequenz- und Ortsmerkmale in parallele Zweige eines neuronalen Netzes. Eine Fusionsschicht führt beide zusammen, sodass das Modell beide Arten von Indizien gleichzeitig nutzt. Das funktioniert besonders gut bei hochwertigen Deepfakes, die sichtbare Artefakte im Bild weitgehend vermeiden.
Erkennung mit Transformern
Vision Transformer haben die Deepfake-Erkennung verändert, weil sie weiträumige Zusammenhänge erfassen, die CNNs entgehen. Während CNNs lokale Nachbarschaften verarbeiten, zerlegen Transformer ein Bild in Kacheln und analysieren per Self-Attention die Beziehungen auch zwischen weit entfernten Kacheln.
Dazu wird das Eingabebild in gleich große Kacheln (meist 16 × 16 Pixel) zerlegt, jede Kachel abgeflacht und in einen Vektor eingebettet. Diese Einbettungen laufen zusammen mit Positionskodierungen durch mehrere Encoder-Schichten. Jede Schicht berechnet per Multi-Head-Self-Attention Aufmerksamkeitswerte zwischen allen Kachelpaaren und erkennt so, welche Bildbereiche über das ganze Bild hinweg zusammenhängen.
Für die Deepfake-Erkennung ist dieser Gesamtblick entscheidend. Gesichtsmanipulationen erzeugen oft feine Widersprüche zwischen entfernten Gesichtspartien — das Licht auf der Stirn passt etwa nicht zum Licht am Kinn. Genau solche weiträumigen Unstimmigkeiten erkennen Transformer über ihre Aufmerksamkeitsmechanismen besonders gut. Die Aufmerksamkeitsgewichte machen zudem nachvollziehbar, welche Bildbereiche das Modell für verdächtig hält.
Zeitliche Transformer übertragen das Prinzip auf Videos. Sie betrachten nicht nur die räumlichen Beziehungen innerhalb eines Bildes, sondern auch die zeitlichen zwischen den Bildern. So fallen Artefakte in Bewegungsabläufen, Mimikwechseln und der Konsistenz von Bild zu Bild auf, die eine Einzelbildanalyse übersieht.
Systeme, die biologische Signale auswerten
Die Remote-Photoplethysmographie (rPPG) gehört zu den fortschrittlichsten Ansätzen der Deepfake-Erkennung. Sie gewinnt den Herzschlag aus Gesichtsvideos, indem sie feine Farbschwankungen der Haut misst, die der Blutfluss verursacht. Die Erkennung läuft in mehreren technischen Schritten.
Zuerst bestimmt das System Gesichtsmerkmale, um geeignete Hautbereiche für die Messung zu finden — meist Stirn, Wangen und Nase. Aus diesen Bereichen werden über alle Videobilder hinweg Farbkanalwerte erfasst (vor allem der Grünkanal, der das stärkste Pulssignal trägt) und zu Zeitreihen zusammengesetzt. Bandpassfilter (0,7 bis 4 Hz für normale Herzfrequenzen) und Trendbereinigung entfernen Rauschen und Lichtschwankungen.
Anschließend durchlaufen die rPPG-Signale eine Frequenzanalyse per Fast-Fourier-Transformation, um die dominante Frequenz — die Herzfrequenz — zu bestimmen. Echte Videos liefern klare periodische Signale mit gleichbleibender Frequenz und Amplitude. Bei Deepfakes ist die Periodizität unregelmäßig oder fehlt, weil der Gesichtstausch die feinen Farbänderungen zerstört, in denen der Puls steckt.
Fortgeschrittene rPPG-Detektoren arbeiten mit einer räumlich-zeitlichen Mehrskalen-Analyse. Sie messen rPPG-Signale gleichzeitig in mehreren Gesichtsregionen und erstellen zweidimensionale PPG-Karten, deren eine Achse den Ort und deren andere die Zeit abbildet. Neuronale Netze werten diese Karten aus und erkennen typische Störmuster — verschiedene Deepfake-Verfahren hinterlassen unterschiedliche Signaturen in den rPPG-Mustern.
Multimodale Erkennungssysteme
Moderne Detektoren kombinieren mehrere Verfahren, um bei unterschiedlichen Deepfake-Arten zuverlässig zu bleiben. Sie verbinden visuelle Merkmale, Frequenzanalyse, biologische Signale und teils auch Audiohinweise in einem gemeinsamen System. Meist gibt es für jedes Verfahren ein eigenes spezialisiertes Netz, dessen Ergebnisse über gelernte Kombinationsstrategien zusammengeführt werden.
Auch die Fusion selbst ist anspruchsvoll. Bei der frühen Fusion werden die Merkmale aller Verfahren vor der Klassifikation zusammengelegt. Bei der späten Fusion werden die Vorhersagewerte getrennter, spezialisierter Klassifikatoren kombiniert. Aufmerksamkeitsbasierte Fusion lernt, die Verfahren je nach Eingabe unterschiedlich zu gewichten: Sind die biologischen Signale in einem Video schwach, stützt sich das System automatisch stärker auf visuelle und Frequenzmerkmale.
Dieser multimodale Ansatz macht die Erkennung widerstandsfähiger gegen gezielte Angriffe und neue Deepfake-Techniken. Lernen Generatoren, ein Verfahren zu umgehen, decken die anderen die Manipulation oft trotzdem auf.
Das Wettrüsten bei der Erkennung
Die Deepfake-Erkennung bleibt eine bewegliche Herausforderung, weil generative Modelle rasant besser werden. Heutige Detektoren verlieren an Genauigkeit, wenn sie auf Daten treffen, die sich von ihren Trainingsdaten unterscheiden — ein Zeichen, dass sie sich zu stark an bestimmte Manipulationsverfahren angepasst haben. Diffusionsmodelle und neuere generative Ansätze hinterlassen andere Artefakte als GAN-basierte Verfahren, sodass Detektoren laufend nachgezogen werden müssen. Wer sich auf Erkennung verlässt, sollte deshalb die Grenzen eines Verfahrens ebenso kennen wie seine Stärken, bevor ein Prüfprozess darauf aufbaut.
Am vielversprechendsten sind Detektoren, die grundlegende Unmöglichkeiten in gefälschten Inhalten finden statt der Spuren eines bestimmten Generators: biologische Signale, physikalische Eigenschaften des Lichts und natürliche Bewegungsmuster, die jedes synthetische System nur schwer perfekt nachbildet. Solche Ansätze bieten den robusteren Schutz, während sich die Deepfake-Technik weiterentwickelt.