

ChatGPT, Gemini, Claude, Grok: Hinter jedem dieser Assistenten steckt ein großes Sprachmodell, englisch Large Language Model, kurz LLM. Um eines gut zu nutzen, müssen Sie die Mathematik dahinter nicht verstehen. Aber ein Grundbild davon, wie ein LLM arbeitet, erklärt vieles: warum es so flüssig schreibt, warum es manchmal Fakten erfindet und warum dieselbe Frage unterschiedliche Antworten bekommen kann.
Dies ist Teil 3 von Level 0. Sie brauchen kein technisches Vorwissen. Sie erfahren, was passiert, wenn Sie eine Anfrage eintippen, was Tokens und das Kontextfenster sind, wie sich Training und Nutzung unterscheiden und wer diese Modelle baut.
Ein LLM sagt das nächste Wort voraus, immer wieder
Ein großes Sprachmodell ist ein Computerprogramm, das aus riesigen Textmengen gelernt hat, wie Sprache üblicherweise weitergeht. Geben Sie ihm den Anfang eines Satzes, sagt es voraus, was als Nächstes kommt. „Groß“ bezieht sich auf die Menge der Trainingstexte und auf das Modell selbst. Moderne LLMs enthalten Milliarden interner Zahlen, sogenannte Parameter, in denen steckt, was das Modell gelernt hat.
Wenn Sie eine Frage stellen, schlägt das Modell keine fertige Antwort nach. Es schreibt die Antwort Stück für Stück. Für jedes nächste Stück schätzt es, wie wahrscheinlich jede mögliche Fortsetzung ist, wählt eine der wahrscheinlichen aus, hängt sie an den Text an und beginnt von vorn.
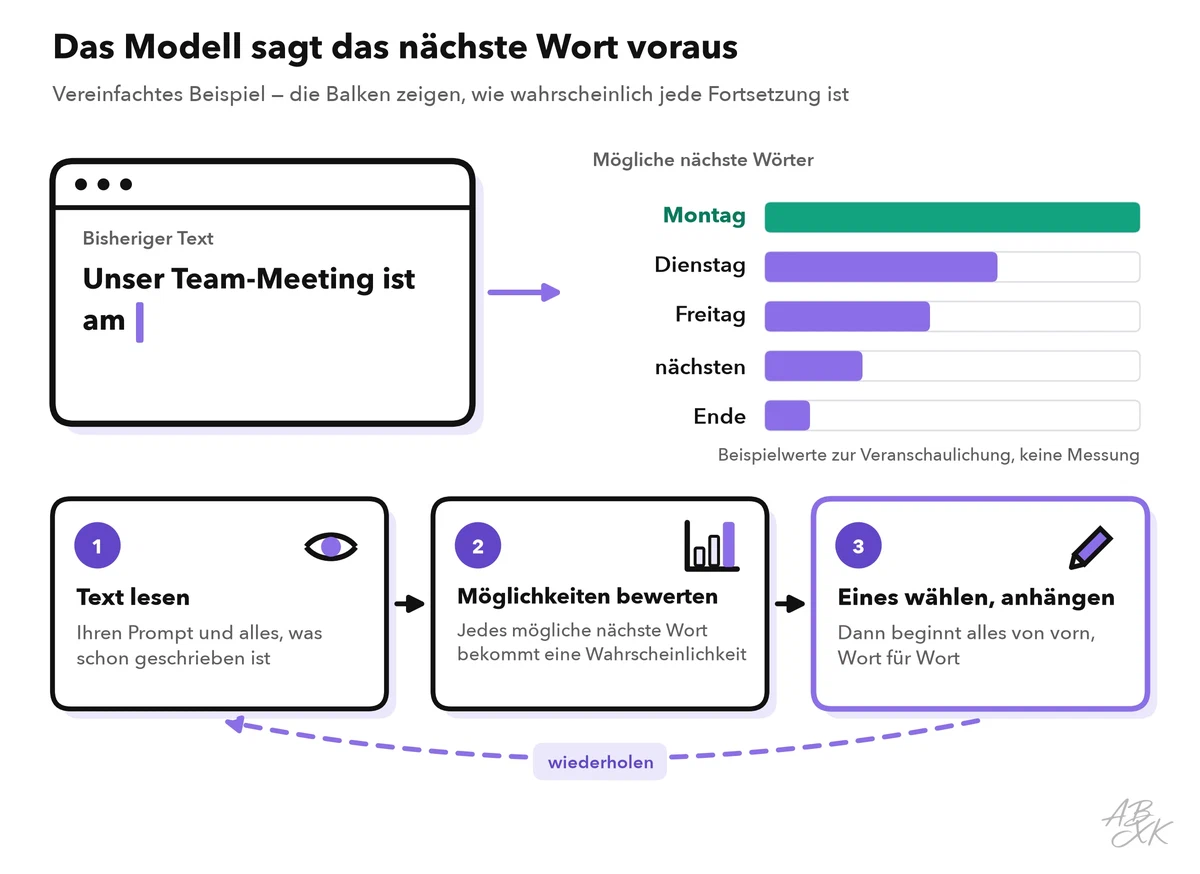
Die meisten Chat-Tools fügen dieser Wahl ein wenig Zufall hinzu. Deshalb kann dieselbe Frage jedes Mal eine etwas andere Antwort ergeben — und deshalb können Sie einfach noch einmal fragen, wenn Ihnen das erste Ergebnis nicht gefällt.
Tokens: die Stücke, mit denen ein LLM wirklich arbeitet
Genau genommen liest ein LLM keine ganzen Wörter. Es liest Tokens: kleine Textstücke. Ein häufiges kurzes Wort ist oft ein Token. Ein langes oder seltenes Wort wird in mehrere Stücke zerlegt. Jedes Modell zerlegt Text auf seine eigene Weise.
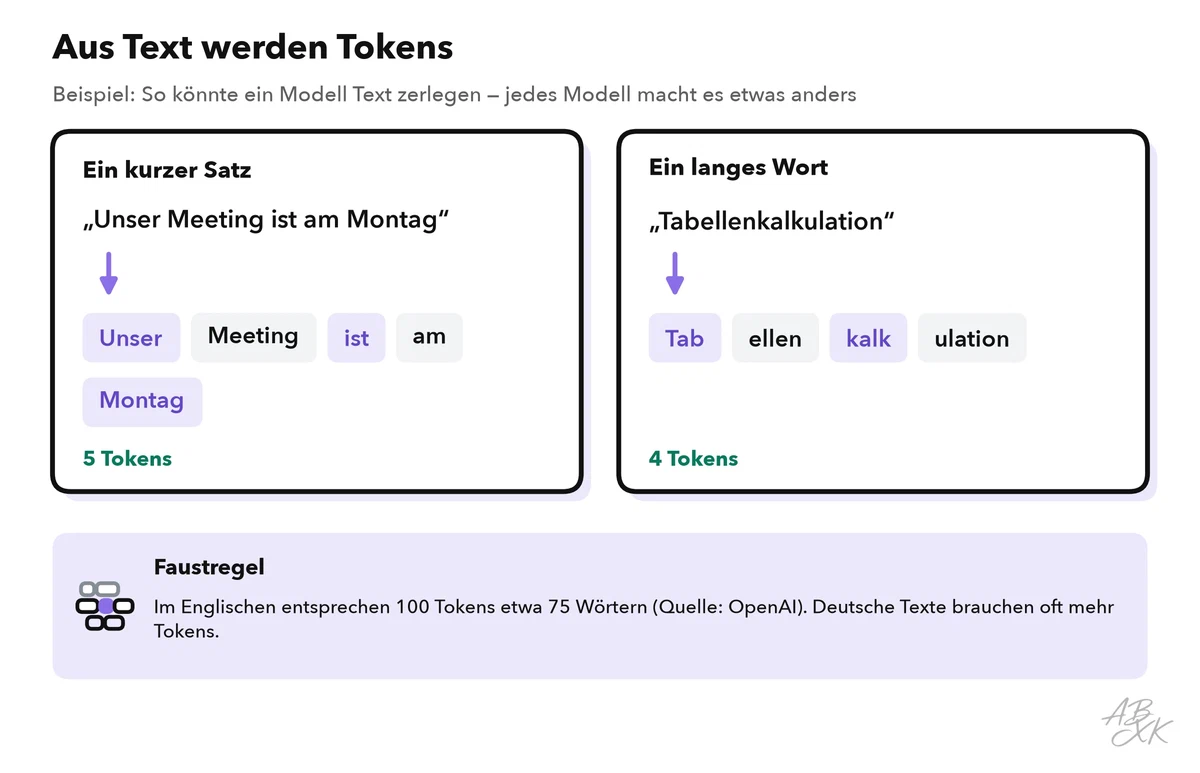
Als grobe Orientierung nennt OpenAI für englische Texte: 100 Tokens entsprechen etwa 75 Wörtern (Quelle: OpenAI Help Center, help.openai.com). Andere Sprachen wie Deutsch brauchen für denselben Inhalt oft mehr Tokens. Tokens begegnen Ihnen immer wieder: Die Grenze, wie viel Text ein Modell verarbeiten kann, wird in Tokens gezählt — und ebenso die Nutzung, die Entwickler bezahlen, wenn sie ein Modell direkt anbinden.
Training und Nutzung: zwei getrennte Phasen
Ein LLM durchläuft zwei sehr unterschiedliche Phasen.
Das Training findet beim Unternehmen statt, das das Modell baut, bevor es jemand nutzt. Das Modell liest enorme Textmengen — zum Beispiel Bücher, Websites und Programmcode — und passt seine Parameter Schritt für Schritt an, bis seine Vorhersagen besser werden. Bei großen Modellen dauert das Wochen oder Monate auf Tausenden spezialisierter Computerchips. Danach wird das Modell weiter trainiert, damit es Anweisungen befolgt und hilfreich antwortet.
Die Nutzung, auch Inferenz genannt, ist das, was passiert, wenn Sie einen Prompt eintippen. Das fertige Modell sagt in Sekunden eine Antwort voraus. Aus Ihrem Chat lernt es in diesem Moment nichts: Seine Parameter bleiben gleich, egal was Sie ihm sagen.
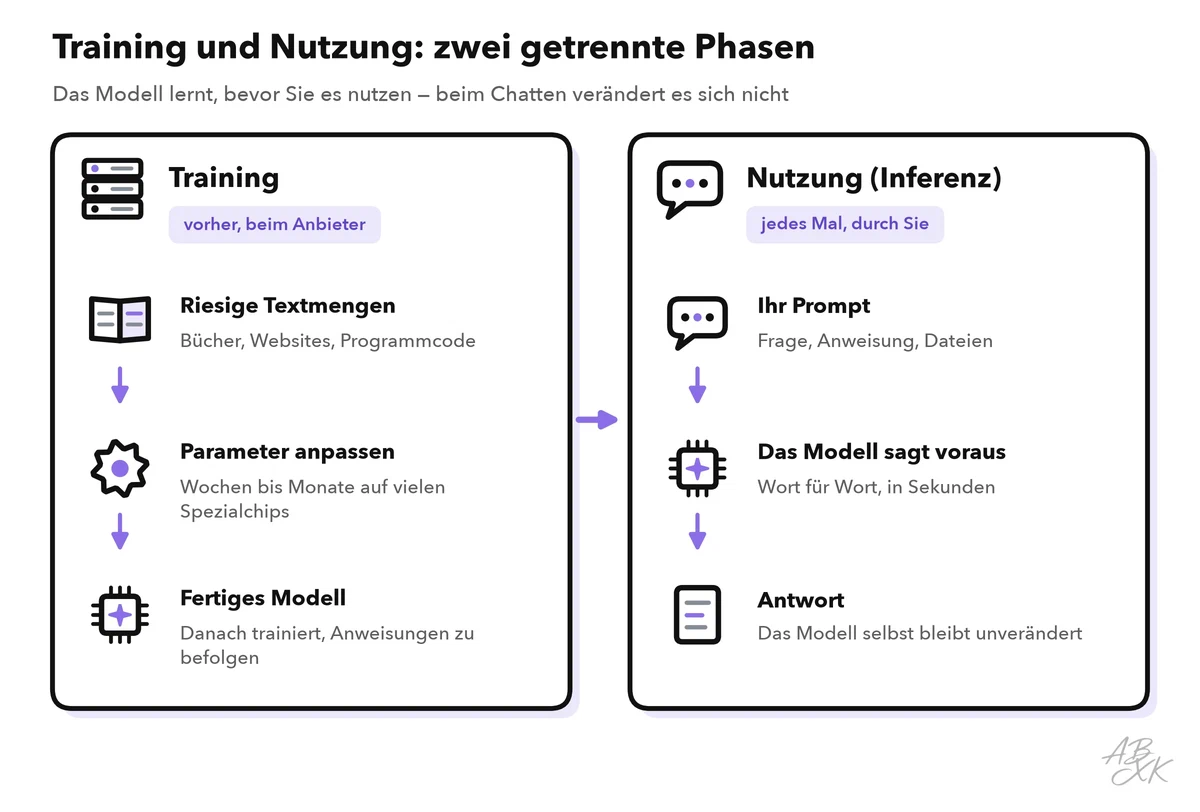
Daraus folgen zwei praktische Punkte. Erstens hat jedes Modell einen Wissensstichtag (Knowledge Cutoff): das Datum, an dem seine Trainingsdaten enden. Ohne Websuche weiß es nicht, was danach passiert ist. Zweitens geht es beim Datenschutz nicht darum, dass das Modell live von Ihnen lernt. Es geht darum, was der Anbieter speichert und ob er Ihre Chats nutzt, um künftige Modelle zu trainieren. Das hängt vom Anbieter und von Ihren Einstellungen ab — prüfen Sie diese, bevor Sie etwas Sensibles teilen.
Warum flüssige Antworten trotzdem falsch sein können
Ein LLM ist dafür gebaut, Text zu erzeugen, der richtig klingt. Es ist nicht dafür gebaut zu erkennen, wann es falschliegt. Hat das Modell eine Tatsache nicht gut gelernt, erzeugt es trotzdem eine plausibel klingende Antwort: ein falsches Datum, einen verwechselten Namen, eine Quelle, die es nicht gibt. Das nennt man Halluzination, und sie klingt genauso selbstsicher wie eine richtige Antwort.
Manche Tools verringern dieses Risiko. Sie durchsuchen zuerst das Web oder Ihre eigenen Dokumente und antworten dann mit Belegen — so arbeiten die KI-Suchmaschinen aus Teil 2. Auch dann kann das Modell eine Quelle falsch lesen. Level 2 erklärt Schritt für Schritt, wie Sie KI-Ergebnisse prüfen.
Das Kontextfenster: was das Modell auf einmal sieht
Das Modell selbst erinnert sich nicht von einem Chat zum nächsten an Sie; manche Tools speichern Notizen über Sie separat. Innerhalb eines Gesprächs arbeitet das Modell mit dem, was in sein Kontextfenster passt: die Textmenge, gemessen in Tokens, die es auf einmal aufnehmen kann. Alles zählt zu dieser Grenze — die eigenen Anweisungen des Tools, Ihre Dateien, der Chatverlauf und Ihre neue Frage.
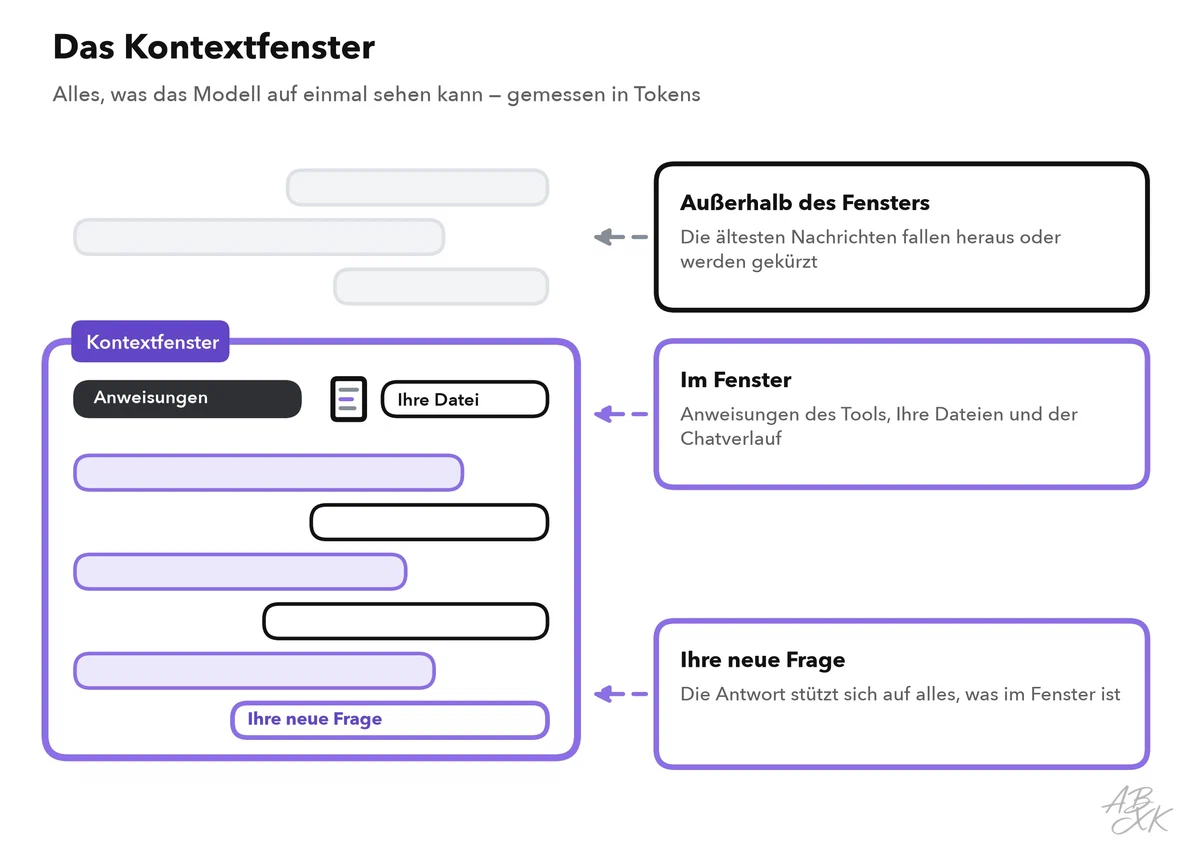
Heutige Modelle haben große Kontextfenster, aber unbegrenzt sind sie nicht. In einem sehr langen Chat kann ein Tool die ältesten Nachrichten weglassen oder kürzen, und das Modell kann Details vom Anfang aus dem Blick verlieren. Zwei einfache Gewohnheiten helfen: Beginnen Sie für ein neues Thema einen neuen Chat, und wiederholen Sie die wichtigsten Fakten, wenn ein Gespräch lang wird. Level 4 geht tiefer auf die Arbeit mit langen Dokumenten ein.
Warum sich Modelle unterscheiden und wer sie baut
Alle LLMs sagen Tokens voraus, aber sie sind nicht gleich. Sie unterscheiden sich in den Daten, aus denen sie gelernt haben, in ihrer Größe, darin, wie sie auf Anweisungen trainiert wurden, in der Geschwindigkeit und in der Größe ihres Kontextfensters. Manche sind stärker beim Schreiben, andere bei Mathematik oder Programmcode.
Ein weiterer wichtiger Unterschied ist der Zugang. Ein Modell mit offenen Gewichten (Open Weights) können Sie herunterladen und auf eigenen Rechnern betreiben, weil der Anbieter die trainierten Parameter veröffentlicht hat. Ein geschlossenes Modell lässt sich nur über die Apps oder Schnittstellen seines Anbieters nutzen.
Die meisten bekannten Modelle stammen von einer kleinen Gruppe von Unternehmen: OpenAI (GPT), Anthropic (Claude), Google DeepMind (Gemini), Meta (Llama), xAI (Grok) sowie Unternehmen in China wie Alibaba (Qwen), DeepSeek und Moonshot (Kimi). Unsere LLM-Datenbank erfasst 343 Modelle von GPT-2 bis heute; 172 davon haben offene Gewichte.
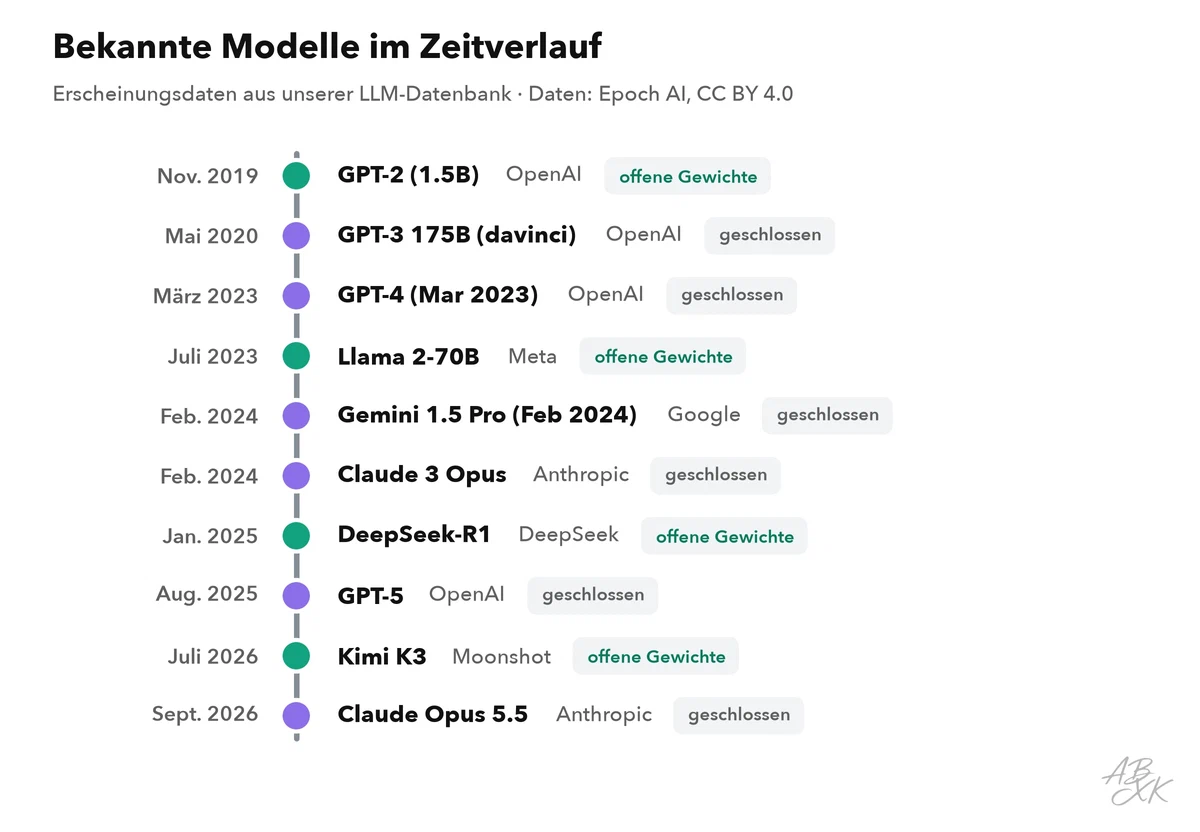
Die Tabelle zeigt sechs aktuelle Modelle aus unserer Datenbank, mit Erscheinungsdatum, offenen oder geschlossenen Gewichten und ihrem Gesamtwert im Epoch Capabilities Index (ECI), der viele Benchmark-Tests zusammenfasst:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Claude Opus 5.5 Anthropic | 22.09.2026 | geschlossen | 166,8 | 1 |
| GPT-6 Astra OpenAI | 03.09.2026 | geschlossen | 166,4 | 2 |
| Gemini 3.7 Flash Google DeepMind | 13.08.2026 | geschlossen | 157,2 | 18 |
| Grok 4.6 xAI | 12.08.2026 | geschlossen | 156,3 | 27 |
| DeepSeek V4 Pro 0813 DeepSeek | 13.08.2026 | offen | 155,3 | 32 |
| Kimi K3 Moonshot | 16.07.2026 | offen | 157,4 | 17 |




ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Ein höherer Gesamtwert heißt nicht, dass ein Modell für Ihre Aufgabe die beste Wahl ist. Level 3 zeigt, wie Sie das passende LLM für eine Aufgabe wählen, indem Sie zwei oder drei Modelle an Ihrer eigenen Arbeit testen.
Vier kleine Experimente zum Selbstausprobieren
All das können Sie mit jedem Chat-Assistenten in wenigen Minuten beobachten. Probieren Sie diese vier Experimente aus und notieren Sie, was Ihnen auffällt:
| Experiment | Was Sie eingeben | Worauf Sie achten |
|---|---|---|
| Vorhersage | „Setze diesen Satz auf fünf verschiedene Arten fort: Unser Team-Meeting ist am …“ | Mehrere plausible Enden: Das Modell wägt Möglichkeiten ab |
| Zufall | Dieselbe Frage in zwei neuen Chats | Gleicher Sinn, andere Formulierung |
| Wissensstichtag | Eine Frage zu Nachrichten der letzten Woche, in einem Tool ohne Websuche | Das Modell sagt vielleicht, dass es das nicht weiß — oder es rät |
| Halluzination | „Nenne drei Studien zu [einem Thema aus Ihrem Fachgebiet] mit Autoren und Jahr.“ | Suchen Sie jede Studie: Gibt es sie wirklich? |
Das letzte Experiment ist das wichtigste. Finden Sie eine Studie, die es nicht gibt, haben Sie die wichtigste Grenze von LLMs mit eigenen Augen gesehen. Denken Sie an dieses Beispiel, wenn eine Antwort das nächste Mal perfekt klingt.