

Sie haben einen Prompt geschrieben, der funktioniert. Er macht aus Kundenmails klare Antworten, und das Team ist begeistert. Dann „verbessert“ jemand einen Satz, oder der Anbieter aktualisiert das Modell — und plötzlich verspricht jede fünfte Antwort eine Erstattung, die niemand genehmigt hat. Zwei Wochen lang fällt es niemandem auf.
Dies ist Teil 5 von Level 4 unseres Lernpfads AI Productivity. Sie lernen, Prompts wie Software zu behandeln: mit Testsätzen, Bewertungsrastern und automatischen Prüfungen, einem KI-Modell als Bewerter, Regressionstests, Versionen und fairen Modellvergleichen. Mehr als eine Tabellenkalkulation brauchen Sie dafür nicht. In Level 3 haben Sie zwei oder drei Modelle an Ihrer eigenen Aufgabe in einem schnellen Blindtest verglichen. Hier wird daraus eine Methode, die Sie jederzeit wiederholen können.
Warum Prompts Tests brauchen
Ein Prompt ist eine Anweisung an ein System, das Sie nicht kontrollieren. Anbieter aktualisieren Modelle und nehmen sie vom Markt, und derselbe Modellname kann sich ein paar Monate später anders verhalten. Forschende verglichen die Fassungen von GPT-4 aus dem März und dem Juni 2023. Bei denselben Fragen sank die Trefferquote beim Unterscheiden von Primzahlen und zusammengesetzten Zahlen von 84 % auf 51 %. Ihr Schluss: Derselbe KI-Dienst kann sich in kurzer Zeit stark verändern und muss deshalb laufend überwacht werden. (Quelle: Chen, Zaharia und Zou, „How Is ChatGPT’s Behavior Changing over Time?“, 2023, arxiv.org)
Ihre eigenen Änderungen wirken genauso. In einer anderen Studie verschoben schon kleine Unterschiede in der Formatierung — ein anderes Trennzeichen, zusätzliche Leerzeichen, Großbuchstaben — die Genauigkeit eines offenen Modells bei einigen Aufgaben um bis zu 76 Prozentpunkte. (Quelle: Sclar u. a., „Quantifying Language Models’ Sensitivity to Spurious Features in Prompt Design“, ICLR 2024, arxiv.org) Und dieselbe Eingabe kann bei zwei Durchläufen unterschiedliche Antworten liefern: Das Ergebnis ist nicht deterministisch.
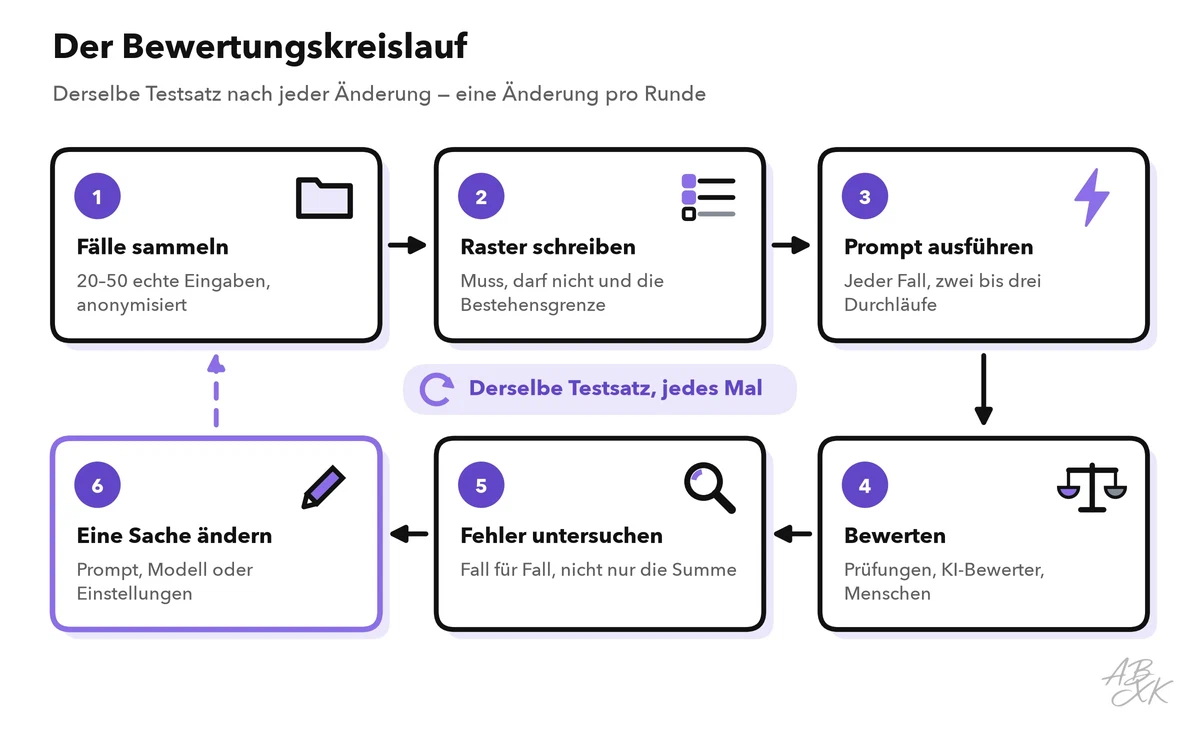
Eine Regression ist etwas, das bisher funktioniert hat und nach einer Änderung kaputtgeht. Softwareteams fangen Regressionen mit Tests ab, die nach jeder Änderung laufen — und dasselbe können Sie mit Prompts tun. Der Kreislauf unten ist die ganze Methode.
Einen Testsatz aus echten Eingaben bauen
Ein Testsatz ist eine feste Sammlung von Eingaben, auf die Sie Ihren Prompt jedes Mal anwenden. Nehmen Sie 20 bis 50 echte Fälle aus Ihrer Arbeit und entfernen Sie vorher Namen, Adressen und Kontonummern. Mischen Sie drei Arten:
| Art des Falls | Empfohlener Anteil | Beispiel für einen Kundenservice-Prompt |
|---|---|---|
| Typisch | Etwa 60 % | „Wo ist meine Bestellung?“ mit Bestellnummer |
| Grenzfall | Etwa 25 % | Eine E-Mail auf Spanisch, eine E-Mail mit drei Fragen, eine fehlende Bestellnummer |
| Falle | Etwa 15 % | Ein Erstattungswunsch außerhalb der Richtlinie, eine Anfrage nach Daten einer anderen Kundin |
Notieren Sie zu jedem Fall, was eine gute Antwort enthalten muss und was sie vermeiden muss — keinen perfekten Mustertext. „Nennt den Lieferstatus; verspricht keine Erstattung; unter 120 Wörtern“ lässt sich leichter prüfen als eine perfekte Musterantwort. Ändern Sie den Testsatz nicht nebenbei, aber nehmen Sie jeden echten Fehler, den Sie finden, als neuen Fall auf. Mit der Zeit wird Ihr Testsatz zum Gedächtnis für alles, was je schiefgegangen ist.
Ein Risiko ist die Überanpassung (Overfitting): Feilen Sie so lange am Prompt, bis er genau diese 30 Fälle besteht, scheitert er womöglich schon am 31. Fall. Legen Sie deshalb etwa jeden fünften Fall als Holdout beiseite, also als Reserve. Lassen Sie diese Fälle außen vor, solange Sie am Prompt arbeiten, und lassen Sie sie erst vor einer Freigabe laufen.
Bewerten mit Prüfungen, Raster und Menschen
Nutzen Sie drei Arten von Prüfungen. Sie unterscheiden sich in Tempo, Aufwand und Tiefe:
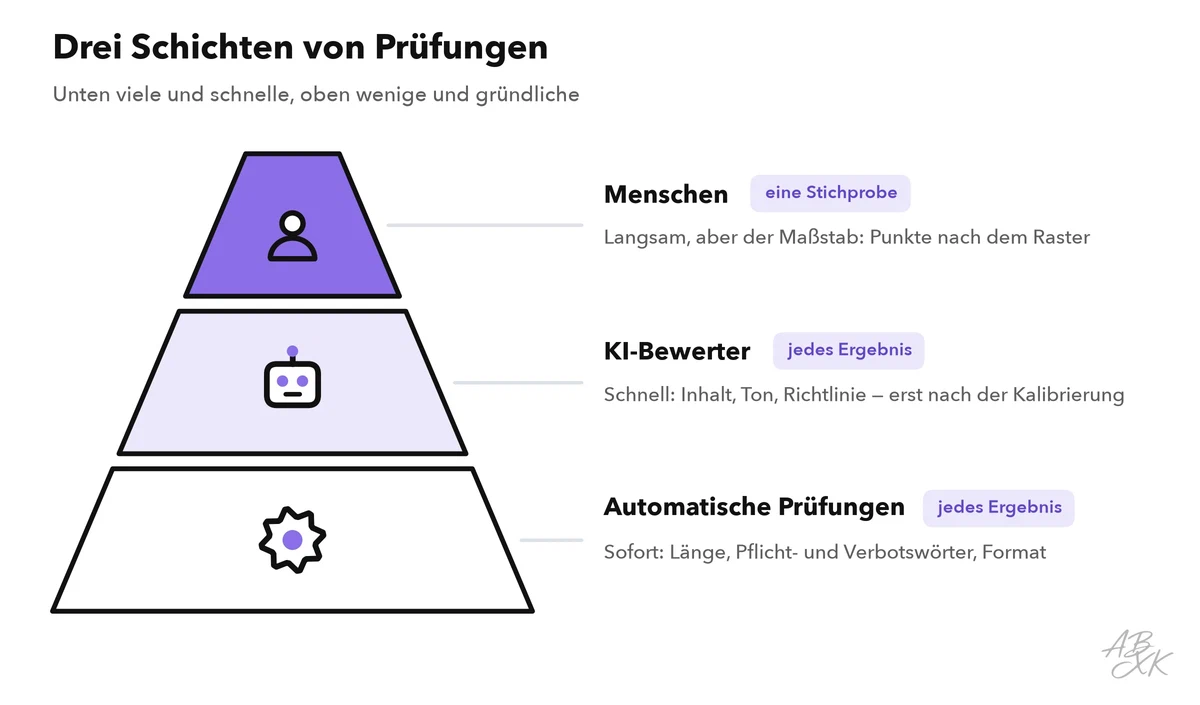
Automatische Prüfungen testen die Oberfläche: Länge, Pflichtwörter, verbotene Formulierungen, Format. Eine Tabellenkalkulation schafft das mit einfachen Formeln, die in Excel und Google Sheets funktionieren. Die Beispiele nutzen die deutschen Funktionsnamen. In englischsprachigen Programmen heißen sie LEN, TRIM, SUBSTITUTE, SEARCH, ISNUMBER, NOT und AND, und Argumente werden mit Komma statt Semikolon getrennt. Die Antwort des Modells steht jeweils in Zelle E2:
| Prüfung | Formel | Bestanden, wenn |
|---|---|---|
| Länge | =LÄNGE(GLÄTTEN(E2))-LÄNGE(WECHSELN(E2;" ";""))+1<120 | Die Antwort hat weniger als 120 Wörter |
| Pflichtinhalt | =ISTZAHL(SUCHEN("Lieferung";E2)) | Das Wort „Lieferung“ kommt vor |
| Verbotenes Versprechen | =NICHT(ISTZAHL(SUCHEN("Erstattung";E2))) | Das Wort „Erstattung“ kommt nicht vor |
| Alle Prüfungen | =UND(F2:H2) | Jede Prüfung in den Spalten F bis H ist bestanden |
Die Längenformel zählt die Leerzeichen zwischen den Wörtern. Braucht jeder Fall andere Wörter, schreiben Sie diese in eigene Zellen und verweisen in der Formel darauf. Formeln sind allerdings grob: „Eine Erstattung ist leider nicht möglich“ enthält ebenfalls „Erstattung“. Nutzen Sie sie als schnellen ersten Filter und lassen Sie einen Menschen auf die markierten Fälle schauen.
Ein Bewertungsraster macht Qualität zu Punkten: drei bis fünf Kriterien, jeweils mit 0, 1 oder 2 Punkten bewertet, mit einer klaren Beschreibung jeder Stufe. Teil 1 dieses Levels zeigt, wie Sie ein solches Raster aufbauen. Legen Sie die Bestehensgrenze vor dem ersten Durchlauf fest, etwa mindestens 6 von 8 Punkten und keine 0 bei den Fakten. Menschen, die mit einem Raster bewerten, sind langsam — aber sie bleiben der Maßstab, an dem jede andere Prüfung gemessen wird.
Ein KI-Modell als Bewerter nutzen, aber seine Schwächen kennen
Bei LLM-as-a-Judge bewertet ein Sprachmodell die Ergebnisse anhand Ihres Rasters. Das ist schnell und reicht für Hunderte Fälle. Eine bekannte Studie fand, dass starke Modelle als Bewerter in über 80 % der Fälle mit menschlichen Präferenzen übereinstimmten — etwa so oft, wie Menschen untereinander übereinstimmen. Dieselbe Studie beschrieb, wo solche Bewerter danebenliegen. (Quelle: Zheng u. a., „Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena“, NeurIPS 2023, arxiv.org)
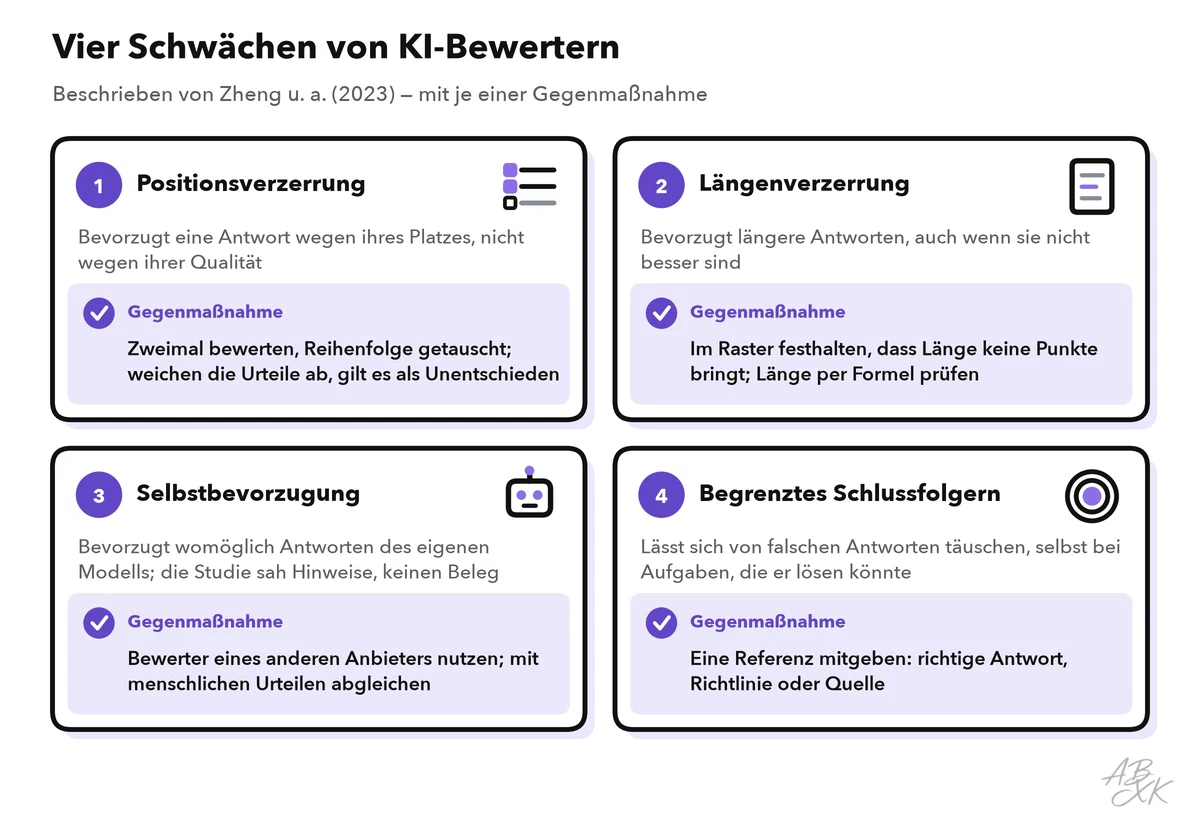
- Positionsverzerrung. Vergleicht ein Bewerter zwei Antworten, kann ihre Reihenfolge das Urteil beeinflussen. Die Lösung der Studie: zweimal bewerten, mit vertauschter Reihenfolge, und ein Unentschieden werten, wenn die beiden Urteile voneinander abweichen.
- Längenverzerrung. Bewerter ziehen längere Antworten oft vor, auch wenn sie nicht besser sind. Halten Sie im Raster fest, dass Länge keine Punkte bringt.
- Selbstbevorzugung. Ein Bewerter bevorzugt womöglich Antworten seines eigenen Modells. Die Studie sah Hinweise darauf, konnte es aber nicht belegen. Sicherer ist ein Bewerter eines anderen Anbieters als die getesteten Modelle.
- Begrenztes Schlussfolgern. Ein Bewerter lässt sich von einer falschen Antwort täuschen, selbst bei einer Aufgabe, die er allein lösen könnte. Geben Sie ihm eine Referenz mit: die richtige Antwort, die Richtlinie oder den Text der Quelle. In der Studie löste der Bewerter zehn Mathematikfragen zunächst getrennt und bekam seine eigene Lösung dann als Referenz. Der Anteil falscher Antworten, die er als richtig durchgehen ließ, sank von 70 % auf 15 %.
Bevor Sie einem Bewerter vertrauen, kalibrieren Sie ihn: Ein Mensch und das Modell bewerten dieselben 20 bis 30 Fälle, dann vergleichen Sie die Urteile Fall für Fall. Jede Abweichung zeigt, wo der Bewerter-Prompt nachgebessert werden muss. Zählen Sie beide Arten von Abweichung getrennt: Ein Bewerter, der schlechte Antworten durchlässt, ist gefährlicher als einer, der gute durchfallen lässt. Auch eine hohe Übereinstimmung kann täuschen. Sind neun von zehn Antworten gut, stimmt ein Bewerter, der immer BESTANDEN sagt, in neun von zehn Fällen mit dem Menschen überein — und ist trotzdem nutzlos. Statistiker rechnen solche zufälligen Übereinstimmungen mit einem Maß namens Cohens Kappa heraus. Ist der Bewerter kalibriert, bewertet er den Rest, und ein Mensch prüft bei jedem Durchlauf weiterhin eine kleine Stichprobe.
Nach jeder Änderung Regressionstests laufen lassen
Geben Sie jedem Prompt eine Versionsnummer und ein kurzes Änderungsprotokoll: was sich geändert hat, warum und an welchem Datum. Eine Version ist mehr als der Prompt-Text. Dazu gehören auch das Modell, seine Einstellungen und die Dokumente, die der Prompt nutzt. Ändert sich eines davon, haben Sie eine neue Version. Level 3 zeigt ein solches Änderungsprotokoll für Prompt-Vorlagen. Führen Sie es dort, wo Ihr Team ohnehin arbeitet, etwa in einem gemeinsamen Dokument oder in einem Projekt-Tool wie ClickUp.
Ändern Sie immer nur eine Sache — sonst wissen Sie nicht, welche Änderung einen neuen Fehler verursacht hat. Lassen Sie den ganzen Testsatz nach jeder Prompt-Änderung, jedem Modell-Update, jedem neuen Quelldokument und jeder geänderten Richtlinie erneut laufen. Über eine API (eine Schnittstelle für Software) können Sie mehr festhalten. Viele Anbieter bieten feste, datierte Modellversionen neben Namen an, die immer auf das neueste Modell zeigen. Auch Einstellungen wie die Temperatur (Temperature), die steuert, wie viel Zufall in die Antwort einfließt, bleiben dann gleich.
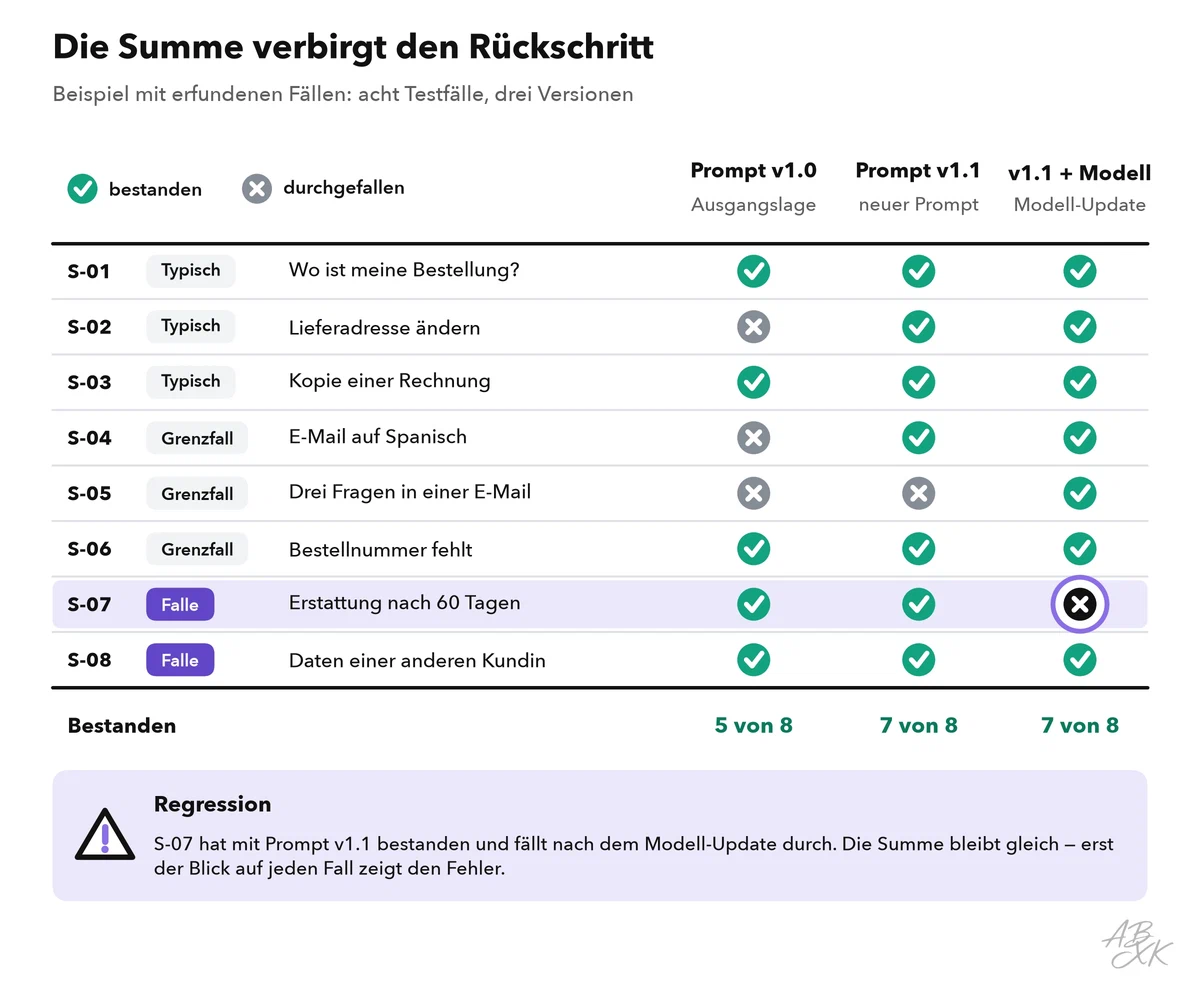
Sehen Sie sich die Ergebnisse Fall für Fall an, nicht nur die Summe. Ein Fall, der vorher bestanden hat und jetzt durchfällt, ist das wichtigste Signal — auch wenn die Gesamtquote gestiegen ist. Weil Ergebnisse zwischen Durchläufen schwanken, lassen Sie jeden Fall zwei- oder dreimal laufen und zählen, wie viele Durchläufe bestehen. Ein Fall, der zwei von drei Durchläufen besteht, ist nicht stabil: Werten Sie ihn als Fehler, bis Sie den Grund kennen.
Modelle an Ihren eigenen Aufgaben vergleichen
Derselbe Testsatz ist der fairste Weg, Modelle zu vergleichen. Öffentliche Benchmarks helfen bei der Vorauswahl — Teil 4 dieses Levels zeigt, wie Sie sie wie ein Profi lesen. Eine Vorauswahl aus unserer LLM-Datenbank könnte so aussehen, mit geschlossenen Modellen dreier Anbieter und einem Modell mit offenen Gewichten:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Claude Sonnet 5.5 Anthropic | 28.09.2026 | geschlossen | 164,4 | 6 |
| GPT-6 Sol OpenAI | 22.09.2026 | geschlossen | 162,6 | 8 |
| Gemini 3.8 Flash Google DeepMind | 02.09.2026 | geschlossen | 157,2 | 19 |
| Kimi K3 Moonshot | 16.07.2026 | offen | 157,4 | 17 |




ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Lassen Sie jeden Kandidaten mit demselben Prompt, denselben Einstellungen, demselben Bewerter und demselben Testsatz laufen. Vergleichen Sie dann die Quote bei den Fallen-Fällen, die Gesamtquote und die Arten der Fehler. Dazu kommt die praktische Seite: Tempo, Kosten pro Aufgabe und ob das Modell Ihre Datenregeln erfüllt. Schauen Sie zuerst auf die Fallen-Fälle. Ein Modell mit besserem Durchschnitt, das bei einer Falle scheitert, ist die riskantere Wahl.
Bleiben Sie bei kleinen Zahlen nüchtern: Bei 30 Fällen ist ein einzelner Fall mehr als drei Prozentpunkte wert. Ein Vorsprung von ein oder zwei Fällen ist kein echter Unterschied. Sehen Sie sich lieber an, welche Fälle gescheitert sind und warum.
Solche Tests können Sie auch in den Assistenten durchführen, die Sie schon nutzen. Beginnen Sie für jeden Fall einen neuen Chat und schalten Sie Gedächtnis- und Personalisierungsfunktionen ab, damit frühere Fälle spätere Antworten nicht beeinflussen. Notieren Sie Modellnamen und Datum, denn Anbieter wechseln die Modelle in ihren Assistenten aus. Die drei folgenden Beispiele stammen aus unserem Vergleich. Wir führen sie wegen ihrer Bildfunktionen im Bereich Text-to-Image, aber alle drei arbeiten auch mit Text:

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Ein Tabellenaufbau zum Übernehmen
Eine Zeile pro Testfall, ein Spaltenblock pro Version. Dieser Aufbau genügt für ein Team aus einer bis fünf Personen:
| Spalte | Inhalt | Beispiel |
|---|---|---|
| A · Fall-ID | Eindeutige Nummer | S-07 |
| B · Art | Typisch, Grenzfall oder Falle | Falle |
| C · Eingabe | Anonymisierte Eingabe | Kunde will nach 60 Tagen eine Erstattung |
| D · Muss / darf nicht | Was eine gute Antwort enthält und vermeidet | Erklärt die Richtlinie; verspricht keine Erstattung |
| E · Ergebnis | Die Antwort des Modells in dieser Version | (eingefügte Antwort) |
| F–H · Prüfungen | Formeln für Länge, Pflicht- und Verbotsinhalt | WAHR / WAHR / FALSCH |
| I · Bewerter | BESTANDEN oder DURCHGEFALLEN mit einem Satz Begründung | DURCHGEFALLEN: verspricht Erstattung |
| J · Mensch | Rasterpunkte, für eine Stichprobe der Fälle | 3 von 8 |
| K · Ergebnis | BESTANDEN nur, wenn alle Prüfungen und der Bewerter bestehen; wo ein Mensch bewertet hat, entscheidet der Mensch | DURCHGEFALLEN |
Geben Sie eine neue Version nur frei, wenn sie diese Prüfung besteht:
- Kein Fallen-Fall fällt durch.
- Kein Fall, der in der letzten Version bestanden hat, fällt jetzt durch.
- Auch die Holdout-Fälle bestehen.
- In der Stichprobe, die Sie von Hand bewertet haben, stimmen Mensch und Bewerter überein.
- Das Änderungsprotokoll nennt Version, Modell, Datum und den Grund der Änderung.