

Ein neues Modell erscheint, und die Ankündigung ist voller Zahlen: ein Rekord in einem Test, ein großer Sprung in einem anderen. Ein paar Wochen später beansprucht ein Wettbewerber den Spitzenplatz. Wenn Sie KI-Tools oder Modelle für sich oder Ihr Team auswählen, müssen Sie wissen, was diese Zahlen aussagen können — und was nicht.
Dies ist Teil 4 von Level 4 unseres Lernpfads AI Productivity. Sie lernen, was ein Benchmark wirklich misst, warum Tests unbrauchbar werden, was Kontamination und Testeinstellungen mit einem Wert machen, wie Gesamtindizes und Agenten-Tests funktionieren und warum der letzte Test immer Ihr eigener sein muss. Alle Modellergebnisse in diesem Artikel stammen direkt aus unserer LLM-Datenbank, die auf Daten von Epoch AI beruht.
Was ein Benchmark eigentlich ist
Ein Benchmark ist ein fester Satz von Aufgaben mit einer festen Bewertungsregel. Die meisten Werte geben den Anteil gelöster Aufgaben in Prozent an. Manche funktionieren anders: Der METR Time Horizon ist eine Dauer, der Epoch Capabilities Index ein Index. Unsere LLM-Seiten führen 16 Benchmarks für 343 Modelle; die Daten wurden zuletzt am 17.10.2026 abgerufen.
Jede Prozentzahl braucht einen Bezugspunkt. Bei Tests mit vier Antwortmöglichkeiten wie MMLU oder GPQA Diamond ergibt reines Raten schon 25 %. Ein Wert von 30 % liegt in einem solchen Test nahe am Zufall.
| Gruppe | Beispiele in unseren Daten | Ein hoher Wert zeigt | Er zeigt nicht |
|---|---|---|---|
| Wissen und Schlussfolgern | MMLU, GPQA Diamond, Humanity’s Last Exam, SimpleQA Verified | Starke Ergebnisse in schriftlichen Expertenprüfungen | Dass das Modell Ihr Unternehmen oder die heutigen Nachrichten kennt |
| Mathematik | GSM8K, MATH Level 5, FrontierMath | Mehrstufiges Rechnen und Beweisen | Dass Ihre Tabellenformeln stimmen werden |
| Programmieren und Agenten | SWE-bench Verified, Aider Polyglot, Terminal-Bench | Echten Code reparieren, in einer Kommandozeile arbeiten | Dass es sicher in Ihren Systemen arbeitet |
| Abstraktion | ARC-AGI, ARC-AGI-2 | Aus wenigen Beispielen eine neue Regel lernen | Allgemeine Intelligenz |
| Gesamtleistung | Epoch Capabilities Index, METR Time Horizon | Breite Leistungsfähigkeit; Länge der Aufgaben, die ein Agent schafft | Eignung für Ihre konkrete Aufgabe |
In den Ranglisten dieses Artikels zeigt jede Zeile das Modell, seinen Entwickler, das Erscheinungsdatum und das Ergebnis. Achten Sie auf das Datum: Ein Modell, das letzte Woche erschienen ist, wurde womöglich einfach noch nicht in jedem Benchmark getestet. Und achten Sie auf die Klammern hinter einem Modellnamen, etwa „(high)“ oder „(max)“: Sie nennen die Einstellung, mit der das Ergebnis entstand.
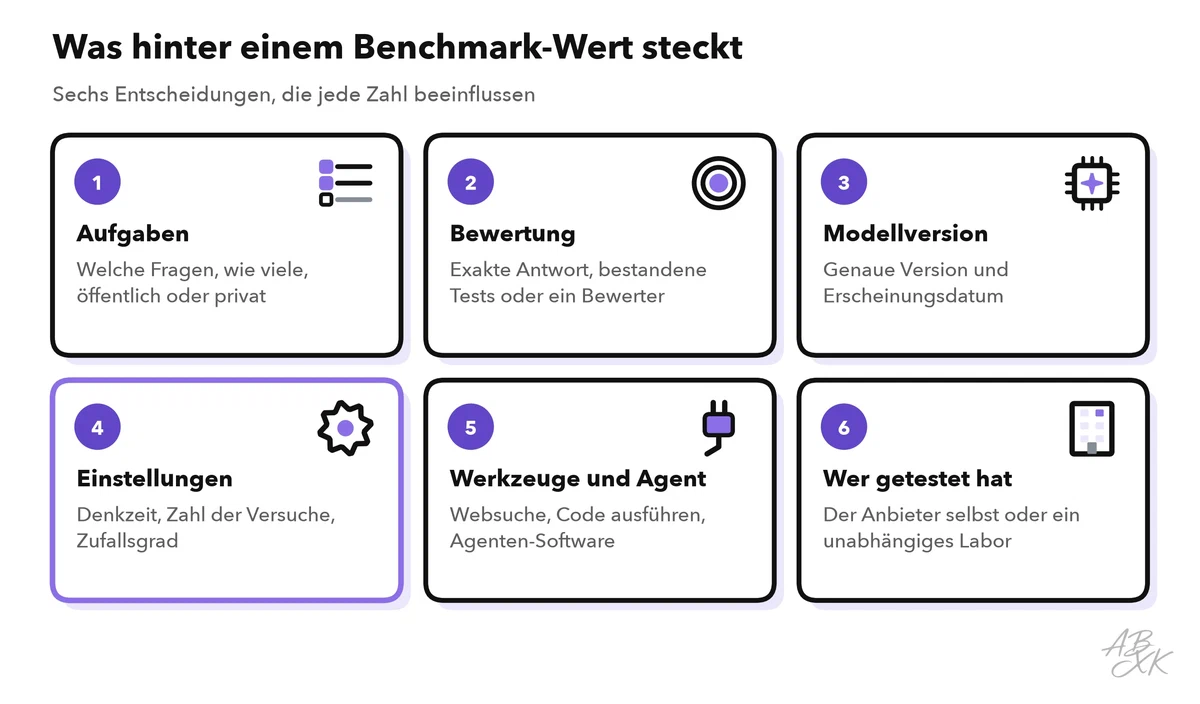
Ein Wert ist nie nur eine Eigenschaft des Modells. Er hängt von vielen Entscheidungen derer ab, die den Test durchgeführt haben:
Sättigung: wenn ein Test Modelle nicht mehr unterscheidet
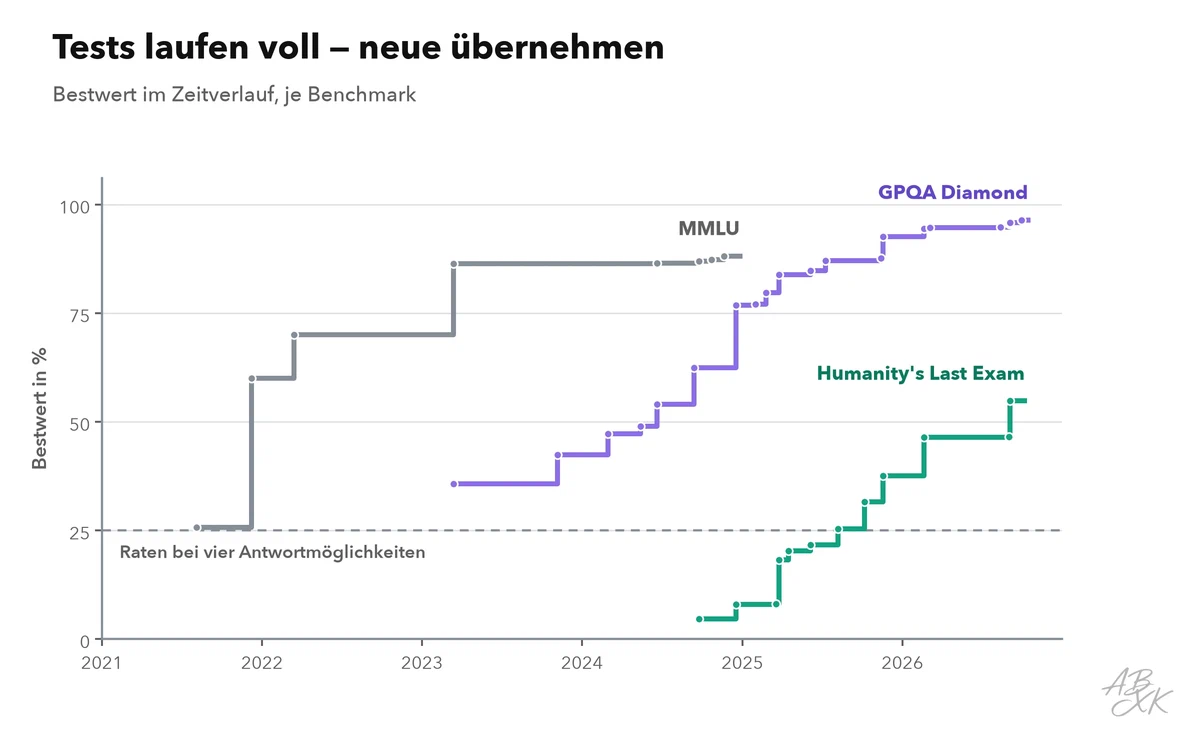
Ein Benchmark ist gesättigt, wenn die besten Modelle so nah am Maximum liegen, dass die verbleibenden Unterschiede wenig bedeuten. MMLU — Multiple-Choice-Fragen aus 57 Fächern — war jahrelang der Standardtest für Wissen. Heute liegen die besten Modelle so nah an der Obergrenze, dass kaum noch neue Ergebnisse erscheinen.
Die Obergrenze liegt zudem niedriger, als es scheint. Forschende, die MMLU nachgeprüft haben, schätzen, dass 6,49 % der Fragen Fehler enthalten; im Teilbereich Virologie waren 57 % der untersuchten Fragen fehlerhaft. (Quelle: Gema u. a., „Are We Done with MMLU?“, 2024, arxiv.org) Ab einer gewissen Höhe kann ein besserer Wert also heißen, dass ein Modell einen falschen Lösungsschlüssel trifft.
Schwerere Tests übernehmen. GPQA Diamond umfasst 198 naturwissenschaftliche Fragen auf Graduiertenniveau, an denen Fachfremde selbst mit Webzugang scheitern. Humanity’s Last Exam (HLE) besteht aus 2.500 von Fachleuten geschriebenen Fragen aus vielen Gebieten und wurde vom Center for AI Safety und Scale AI entwickelt. FrontierMath nutzt unveröffentlichte Mathematikaufgaben, die Epoch AI unter Verschluss hält. Die Grafik zeigt das Muster: Jeder neue Test beginnt niedrig und steigt, während die älteren nahe der Obergrenze abflachen.
Das sind die aktuellen Spitzenreiter bei Humanity’s Last Exam:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | GPT 6 Astra OpenAI | 03.09.2026 | 54,8 % |
| 2 | Fable 5.1 (xhigh) Anthropic | 01.09.2026 | 46,5 % |
| 3 | Gemini 3.1 Pro Preview (thinking high) Google DeepMind | 19.02.2026 | 46,4 % |
| 4 | Sonnet 5.5 (xhigh) Anthropic | 28.09.2026 | 46,1 % |
| 5 | Gemini 3.8 Flash Google DeepMind | 02.09.2026 | 44,5 % |



Von Fachleuten geschriebene Fragen an der Grenze des menschlichen Wissens aus vielen Gebieten — gebaut, um schwer zu bleiben, nachdem ältere Tests gelöst waren. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Kontamination: wenn das Modell den Test schon kennt
Kontamination heißt: Testfragen oder ihre Antworten sind in die Trainingsdaten eines Modells geraten. Das Modell erinnert sich dann womöglich, statt zu lösen. Jeder Test, der im Internet steht, ist gefährdet — und das Risiko wächst mit seinem Alter.
Typische Warnzeichen: Ein Modell schneidet in einem alten öffentlichen Test deutlich besser ab als in einem neueren, der dieselbe Fähigkeit misst; oder seine Antworten wiederholen wörtlich die offiziellen Lösungen. Den besten Schutz bietet ein Test, der nie veröffentlicht wurde: private Aufgabensätze wie FrontierMath, frische Fragen — oder Ihre eigenen Aufgaben aus Ihrer eigenen Arbeit.
Eine einfache Prüfung können Sie selbst machen. Nehmen Sie einige Fragen aus einem öffentlichen Test und formulieren Sie sie um: Ändern Sie Namen, Zahlen und die Reihenfolge der Antwortmöglichkeiten, aber lassen Sie die Aufgabe gleich. Schneidet ein Modell bei den umformulierten Fassungen deutlich schlechter ab, hat es sich vermutlich eher auf sein Gedächtnis verlassen als auf sein Können.
Einstellungen: gleiches Modell, anderer Wert
Dasselbe Modell kann sehr unterschiedliche Werte erreichen, je nachdem, wie getestet wurde. Fünf Einstellungen zählen am meisten:
- Denkaufwand. Viele Modelle können länger „nachdenken“, bevor sie antworten. In unseren Daten sehen Sie Modellnamen mit „(high)“ oder „(max)“ — dasselbe Modell mit mehr Denkzeit und oft einem höheren Wert.
- Versuche. Eine Antwort pro Aufgabe ist etwas anderes als die beste von mehreren.
- Werkzeuge. SimpleQA Verified wird ohne Hilfsmittel beantwortet; ein Modell mit Websuche käme auf einen anderen Wert.
- Agenten-Software. Bei Terminal-Bench gehört der Wert zu einem Modell samt der Agenten-Software, die es steuert. Bei SWE-bench Verified stammen unsere Daten aus Epoch AIs eigenen Läufen mit einem festen Aufbau; Anbieter melden mit eigenem Werkzeug oft höhere Werte.
- Testgröße. GPQA Diamond hat 198 Fragen — eine Frage mehr oder weniger verschiebt den Wert also um etwa einen halben Prozentpunkt. Ein Abstand von ein oder zwei Punkten zwischen zwei Modellen ist oft Rauschen.
Gesamtindizes und Agenten-Tests
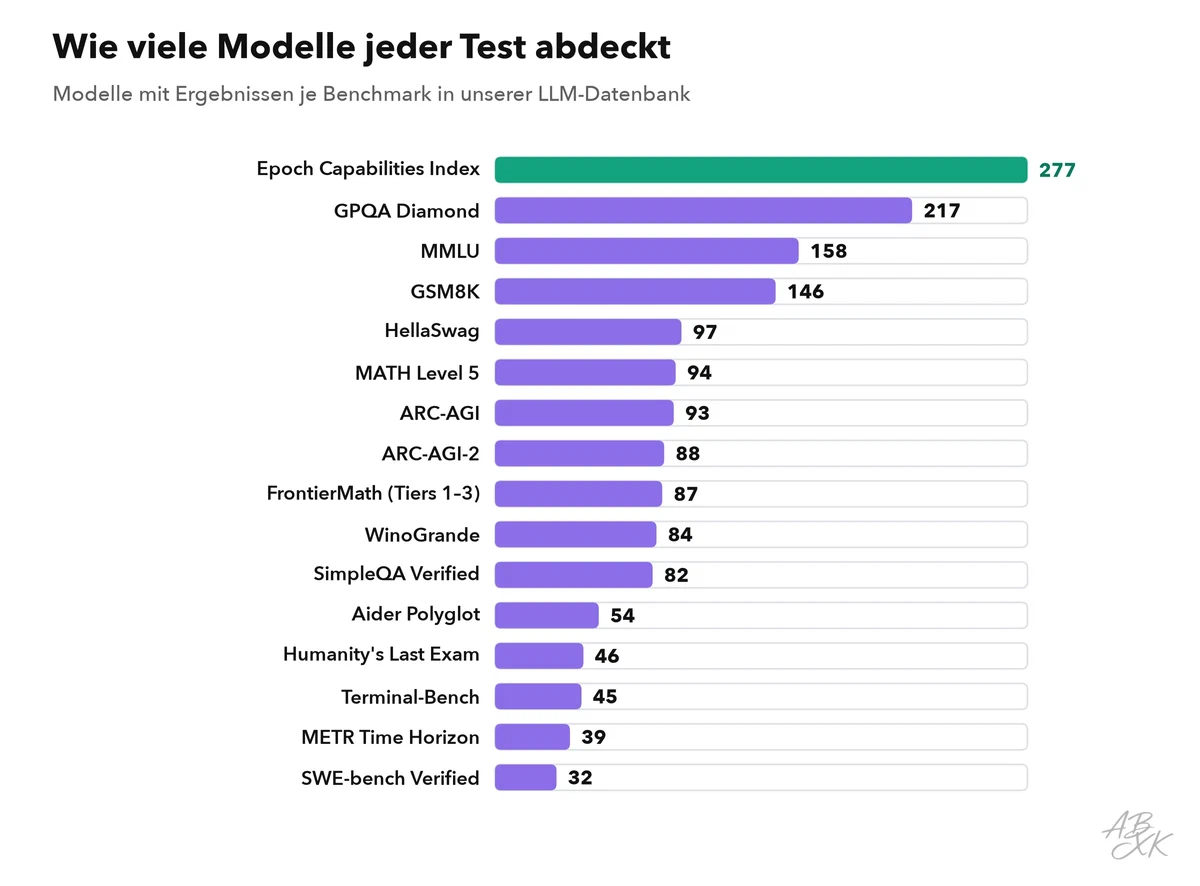
Nicht jedes Modell wird in jedem Benchmark getestet. Die Grafik zeigt, wie viele Modelle unserer Datenbank Ergebnisse in welchem Test haben. Manche Tests decken mehr als zweihundert Modelle ab, andere nur wenige Dutzend — ein fehlender Wert ist also keine Null, und eine Rangliste in einem seltenen Test lässt die meisten Modelle aus.
Der Epoch Capabilities Index (ECI) löst dieses Problem. Er fasst die Ergebnisse von mehr als 50 Benchmarks zu einer Zahl je Modell zusammen, sodass sich Modelle vergleichen lassen, auch wenn sie nie dieselben Tests absolviert haben. Er ist ein Index, kein Prozentwert: Epoch AI skaliert ihn so, dass Claude 3.5 Sonnet bei 130 und GPT-5 bei 150 steht. Ein Index taugt für den ersten Überblick, verdeckt aber Stärken und Schwächen in einzelnen Bereichen.
Der METR Time Horizon misst etwas anderes: die Länge der Aufgaben — gemessen an der Zeit, die ein menschlicher Experte braucht —, die ein Modell in etwa der Hälfte der Versuche richtig löst. METR fand heraus, dass sich dieser Horizont seit 2019 etwa alle sieben Monate verdoppelt hat. (Quelle: METR, „Measuring AI Ability to Complete Long Tasks“, 2025, arxiv.org) Behalten Sie die 50 % im Kopf: Bei dieser Aufgabenlänge scheitert das Modell auch etwa in der Hälfte der Fälle. Die Aufgaben von METR stammen aus der Softwarearbeit, der Horizont sagt also vor allem über diese Art von Aufgaben etwas aus. Ein Horizont von zwei Stunden heißt nicht, dass ein Modell zwei Stunden lang unbeaufsichtigt an Ihrem Projekt arbeiten kann.
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Claude Mythos Preview (Early) Anthropic | 07.04.2026 | 17 Std. 25 min |
| 2 | Claude Opus 4.6 (unknown thinking) Anthropic | 05.02.2026 | 11 Std. 59 min |
| 3 | Gemini 3.1 Pro Preview Google DeepMind | 19.02.2026 | 6 Std. 24 min |
| 4 | GPT-5.2 (high) OpenAI | 11.12.2025 | 5 Std. 52 min |
| 5 | GPT-5.3 Codex OpenAI | 05.02.2026 | 5 Std. 50 min |
Die Länge der Aufgaben, die ein Modell in etwa der Hälfte der Fälle richtig löst — gemessen daran, wie lange ein menschlicher Experte dafür braucht. Die Zahl ist eine Dauer, kein Punktwert: Ein längerer Horizont heißt, das Modell kann länger selbstständig arbeiten. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Von der Rangliste zur eigenen Entscheidung
Benchmarks sind ein Filter, kein Urteil. Nutzen Sie sie für eine Vorauswahl und testen Sie diese dann an Ihrer eigenen Arbeit. Level 3 zeigt, wie Sie das passende LLM für die Aufgabe wählen, und Teil 5 dieses Levels, wie Sie Ihre Prompts testen und bewerten — mit einem eigenen Testsatz.
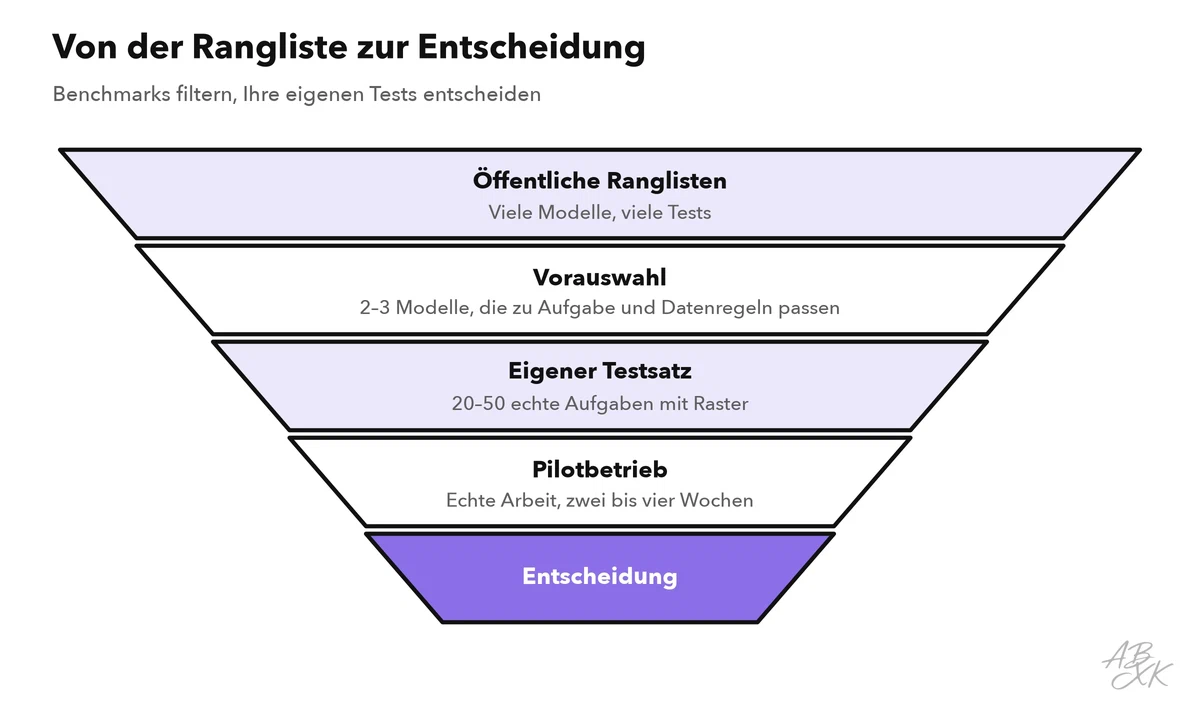
Sieben Fragen helfen Ihnen, jede Benchmark-Aussage zu beurteilen — in einer Anbieter-Ankündigung, einem Nachrichtenartikel oder einer Rangliste:
| Frage | Warum sie zählt | Warnzeichen |
|---|---|---|
| Ist der Test gesättigt? | Spitzenwerte nahe am Maximum sagen wenig | Rekorde bei MMLU, GSM8K oder HellaSwag |
| Könnte das Modell den Test kennen? | Kontamination bläht Werte auf | Nur alte, öffentliche Tests werden genannt |
| Wer hat getestet? | Anbieter nutzen oft ihren eigenen Aufbau | Keine unabhängigen Ergebnisse |
| Mit welchen Einstellungen? | Denkzeit, Versuche und Werkzeuge verändern Werte | Einstellungen werden nicht genannt |
| Wie groß ist der Abstand? | Kleine Tests rauschen | Eine Rangliste, die ein oder zwei Punkte entscheiden |
| Passt der Test zu Ihrer Aufgabe? | Jeder Benchmark misst bestimmte Fähigkeiten | Ein Programmierwert entscheidet über ein Schreibmodell |
| Stimmen mehrere Tests überein? | Ein einzelner Test kann täuschen | Ein Rekord, keine weiteren Ergebnisse |