

Die meisten Menschen beurteilen KI-Tools nach Gefühl. „Das spart mir viel Zeit“ ist das übliche Urteil — und es stimmt oft nicht. In einer Studie der Forschungsgruppe METR von 2025 erwarteten erfahrene Softwareentwickler, dass KI sie schneller macht. Die Messung zeigte, dass sie langsamer waren — und hinterher glaubten sie trotzdem, die KI habe geholfen. Wenn Sie wissen wollen, ob sich KI in Ihrer Arbeit wirklich lohnt, oder wenn Sie Ihre Vorgesetzten überzeugen müssen, brauchen Sie Zahlen, die einer Nachfrage standhalten.
Dies ist Teil 1 von Level 4, der Expertenstufe unseres Lernpfads AI Productivity. Auf Level 0 haben Sie nach jedem Versuch mit KI drei kurze Fragen gestellt (was KI im Arbeitsalltag kann). Hier wird aus dieser Gewohnheit eine Methode: eine klare Arbeitseinheit, eine Baseline, fünf Kennzahlen, ein fairer Vergleich und ein Protokoll, das Sie in eine Tabellenkalkulation übernehmen können.
Messen Sie Aufgaben, nicht „Produktivität“
„Produktivität“ ist zu vage, um sie zu messen. Eine Aufgabe dagegen können Sie zählen: Sie wiederholt sich, hat einen klaren Anfang und ein klares Ende und liefert ein Ergebnis, das jemand prüfen kann. „Besser schreiben“ ist keine Aufgabe. „Erste Antwort auf eine Kundenbeschwerde“ schon.
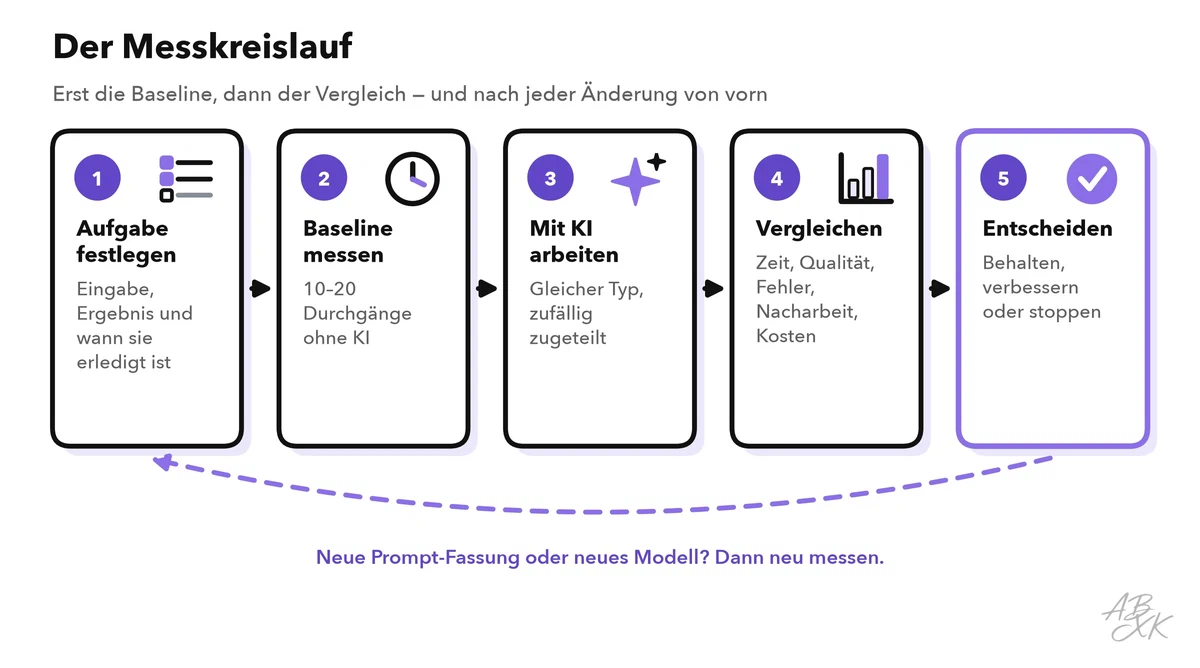
Beschreiben Sie jede Aufgabe in einer Zeile: Eingabe, Ergebnis und wann sie als erledigt gilt. Zum Beispiel: „Eingabe: Meeting-Aufnahme. Ergebnis: Zusammenfassung mit Entscheidungen und Aufgaben. Erledigt: an alle Teilnehmenden verschickt.“ Halten Sie verschiedene Aufgabentypen auseinander. Eine zweizeilige E-Mail und ein zehnseitiger Bericht gehören nicht in denselben Durchschnitt.
Messen Sie dann eine Baseline: wie die Aufgabe heute ohne KI läuft. Erfassen Sie 10 bis 20 Durchgänge, bevor Sie etwas ändern. Manchmal liegen die Daten schon vor — Zeitstempel in Tickets, Versionsverläufe von Dokumenten oder Kalendereinträge. Ohne Baseline hängt jede spätere Zahl in der Luft.
Fünf Kennzahlen, die das ganze Bild zeigen
Zeit allein führt in die Irre. KI macht den ersten Entwurf oft schneller und die Prüfung langsamer. Nutzen Sie deshalb fünf Kennzahlen zusammen:
| Kennzahl | Definition | So messen Sie | Typische Falle |
|---|---|---|---|
| Aktive Zeit | Minuten, die Sie tatsächlich an der Aufgabe arbeiten — inklusive Prompten, Warten, Prüfen und Korrigieren | Timer oder Zeitstempel der App, je Aufgabe gestartet und gestoppt | Nur den Entwurfsschritt zählen |
| Qualität | Punktzahl auf einem festen Bewertungsraster (siehe unten) | Blinde Bewertung durch eine Kollegin oder einen Kollegen | Die eigene Arbeit bewerten, wenn Sie wissen, welche Fassung mit KI entstand |
| Fehlerquote | Anteil der Ergebnisse mit mindestens einem sachlichen Fehler, der bei Lesenden ankam | Fehler aus der Prüfung plus spätere Beschwerden | Nur die Fehler zählen, die Ihnen selbst aufgefallen sind |
| Nacharbeit | Minuten für Korrekturen, dazu Ergebnisse, die komplett neu geschrieben wurden | Korrekturzeit getrennt erfassen | Nacharbeit im „Prüfen“ verstecken |
| Kosten pro Aufgabe | Arbeitszeit plus Tool-Kosten, geteilt durch die gelungenen Aufgaben | Formel unten | Lizenzkosten und Fehlversuche weglassen |
Fehler verdienen eine eigene Zählung, weil sie später teuer werden, nicht sofort. Auf Level 2 lernen Sie, wie Sie KI-Ergebnisse systematisch auf Fehler prüfen.
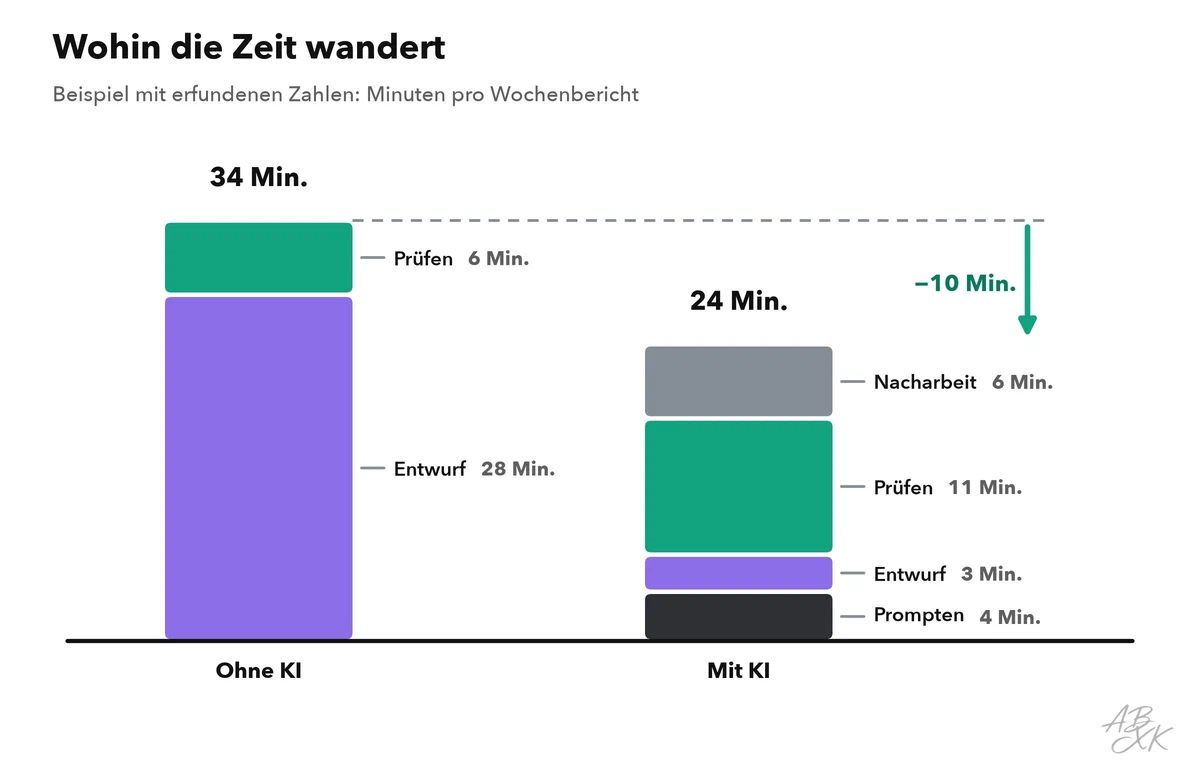
Die Grafik zeigt, warum die ganze Aufgabe zählt. In diesem Beispiel verkürzt KI die Entwurfszeit deutlich, aber Prüfung und Nacharbeit wachsen. Der Gewinn ist echt, aber viel kleiner, als der Entwurfsschritt vermuten lässt.
Qualität: Legen Sie das Raster fest, bevor Sie Ergebnisse sehen
Ein Bewertungsraster (englisch Rubric) ist ein kurzer Bewertungsbogen mit festen Kriterien und klaren Stufen. Schreiben Sie es, bevor Sie das erste Ergebnis ansehen — sonst passen Sie den Maßstab unbewusst an das Ergebnis an. Drei bis fünf Kriterien genügen. Beschreiben Sie für jede Stufe konkret, was diese Punktzahl bedeutet.
| Kriterium | 0 Punkte | 1 Punkt | 2 Punkte |
|---|---|---|---|
| Fakten | Mindestens ein falscher Fakt | Vage oder ungeprüfte Angabe | Alle Fakten richtig und geprüft |
| Vollständigkeit | Ein wichtiger Punkt fehlt | Die Hauptpunkte sind abgedeckt | Alles, was die Lesenden brauchen, ist da |
| Ton und Passung | Falscher Ton für die Lesenden | Akzeptabel, etwas allgemein | Klingt nach Ihrem Team |
| Einsatzbereit | Muss neu geschrieben werden | Braucht leichte Korrekturen | Kann so hinausgehen |
Bewerten Sie blind, wo es geht: Mischen Sie Ergebnisse mit und ohne KI, entfernen Sie jeden Hinweis auf die Herkunft und lassen Sie eine Kollegin oder einen Kollegen bewerten. Erfassen Sie außerdem die Übernahmequote — den Anteil der KI-Entwürfe, die Sie nach leichten Korrekturen verwenden. Sinkt sie, ist das oft das erste Zeichen, dass eine Prompt-Änderung oder ein Modell-Update die Ergebnisse verschlechtert hat. Teil 5 dieses Levels zeigt, wie Sie mit einem solchen Raster Ihre Prompts testen und bewerten.
Kosten pro Aufgabe: Zählen Sie auch die Fehlschläge
Die Kosten pro Aufgabe fassen Zeit und Tools in einer Zahl zusammen. Eine einfache Fassung:
Kosten pro gelungener Aufgabe = (aktive Minuten × Kosten pro Minute + KI-Nutzung + Lizenzanteil) ÷ Erfolgsquote
- Kosten pro Minute sind Ihre internen Stundenkosten geteilt durch 60. Einen Standardsatz bekommen Sie von der Finanz- oder Personalabteilung.
- KI-Nutzung spielt bei Tools eine Rolle, die nach Verbrauch abrechnen, etwa pro Token, pro Bild oder pro Videominute.
- Lizenzanteil ist die monatliche Lizenzgebühr geteilt durch die Zahl der Aufgaben, die Sie im Monat mit dem Tool erledigen.
- Die Erfolgsquote berücksichtigt Fehlschläge. Ist jeder fünfte Entwurf unbrauchbar, steigen die echten Kosten der guten Entwürfe.
Ein durchgerechnetes Beispiel mit erfundenen Zahlen, nur in Minuten: Ohne KI dauert ein Wochenbericht 34 Minuten. Mit KI sind es 24 Minuten, aber jeder fünfte Entwurf ist unbrauchbar, und Sie schreiben diesen Bericht von Hand (noch einmal 34 Minuten). Im Schnitt dauert er mit KI 24 + 0,2 × 34 ≈ 31 Minuten. Der Gewinn schrumpft von 10 auf etwa 3 Minuten. Das ist immer noch ein Gewinn — aber für eine Wirtschaftlichkeitsrechnung eine ganz andere Geschichte.
Fair vergleichen, auch mit wenigen Aufgaben
Hunderte Aufgaben zum Vergleichen haben Sie selten. Bei kleinen Stichproben zählt der Versuchsaufbau mehr als die Statistik.
- Zufällig zuteilen. Werfen Sie für jede Aufgabe eine Münze: Kopf mit KI, Zahl ohne. Sonst geben Sie der KI unbemerkt die leichten Aufgaben — eine Auswahlverzerrung (Selection Bias).
- Gleiches mit Gleichem vergleichen. Gleicher Aufgabentyp, ähnliche Länge, dieselbe Person bewertet.
- Die Lernphase getrennt ausweisen. Die erste Woche mit einem neuen Tool ist langsamer. Weisen Sie sie gesondert aus, sonst wirkt das Tool schlechter, als es ist.
- Auf den Neuheitseffekt achten. Anfängliche Begeisterung lässt Menschen mit einem neuen Tool engagierter arbeiten. Messen Sie mindestens zwei bis vier Wochen.
- Median und Spannweite nutzen. Der Median ist der mittlere Wert, wenn Sie alle Ergebnisse der Größe nach sortieren. Eine einzelne völlig misslungene Aufgabe verzerrt ihn nicht so wie den Durchschnitt.
- Angeben, wie viele Aufgaben Sie gemessen haben. „Median 24 Minuten, n = 12“ ist ehrlich. „40 % schneller“ ohne die Zahl der Aufgaben nicht.
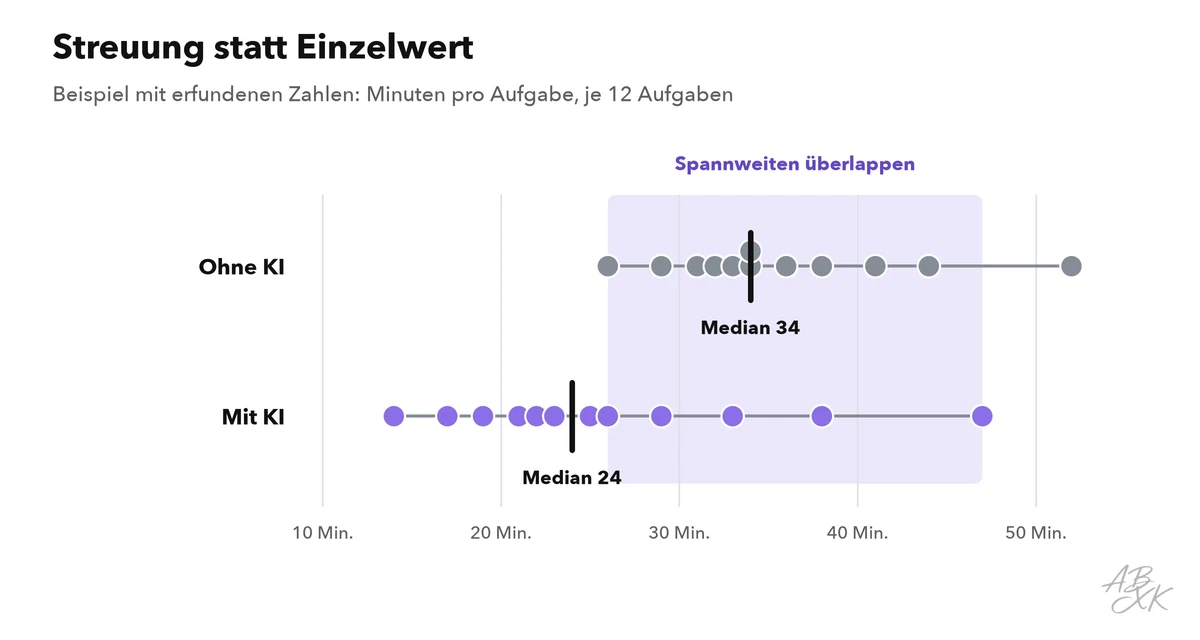
Berichten Sie ein Ergebnis in einer Zeile pro Aufgabentyp, die Gewinn, Preis und Sicherheit zeigt. Mit den Beispielwerten von oben: „Wochenbericht: 12 Aufgaben pro Gruppe, Median 34 → 24 Minuten, Qualität 6,1 → 6,0 von 8 Punkten, Berichte mit Fehlern 1 → 2.“ Das lesen Ihre Vorgesetzten in zehn Sekunden — und sehen sofort, dass der Zeitgewinn mit einem fehlerhaften Bericht mehr erkauft wurde.
Was Feldstudien gefunden haben
Große Studien zeigen, was möglich ist. Ihre eigenen Zahlen ersetzen sie nicht, denn sie haben bestimmte Aufgaben, Tools und Menschen zu einer bestimmten Zeit gemessen.
| Studie | Rahmen | Ergebnis |
|---|---|---|
| Noy und Zhang (MIT), Science, 2023 | 453 Fachkräfte mit Hochschulabschluss, Schreibaufgaben, die Hälfte mit ChatGPT | Die Bearbeitungszeit sank im Schnitt um 40 %, die bewertete Qualität stieg um 18 % |
| Brynjolfsson, Li und Raymond, Quarterly Journal of Economics, 2025 | 5.172 Beschäftigte im Kundensupport mit einem KI-Assistenten | Im Schnitt 15 % mehr gelöste Anfragen pro Stunde; Unerfahrene gewannen am meisten, bei den Erfahrensten sank die Qualität leicht |
| Dell’Acqua u. a., Arbeitspapier der Harvard Business School mit BCG, 2023 | 758 Beraterinnen und Berater mit GPT-4 | Bei Aufgaben innerhalb der KI-Fähigkeiten: 12,2 % mehr Aufgaben, 25,1 % schneller, über 40 % höhere Qualität. Bei einer Aufgabe außerhalb kamen KI-Nutzende seltener zur richtigen Lösung |
| METR, 2025 | 16 erfahrene Open-Source-Entwickler, 246 echte Aufgaben | Mit KI 19 % langsamer, obwohl sie sich schneller fühlten; METR betont, dass dies eine Momentaufnahme der Tools von Anfang 2025 ist |
Die Autoren der Beraterstudie sprechen von einer zerklüfteten Grenze (Jagged Frontier): KI ist bei manchen Aufgaben sehr gut und scheitert an anderen, die genauso schwer aussehen. Von außen sehen Sie nicht, wo diese Grenze verläuft. Sie finden sie nur durch Messen — Aufgabentyp für Aufgabentyp.
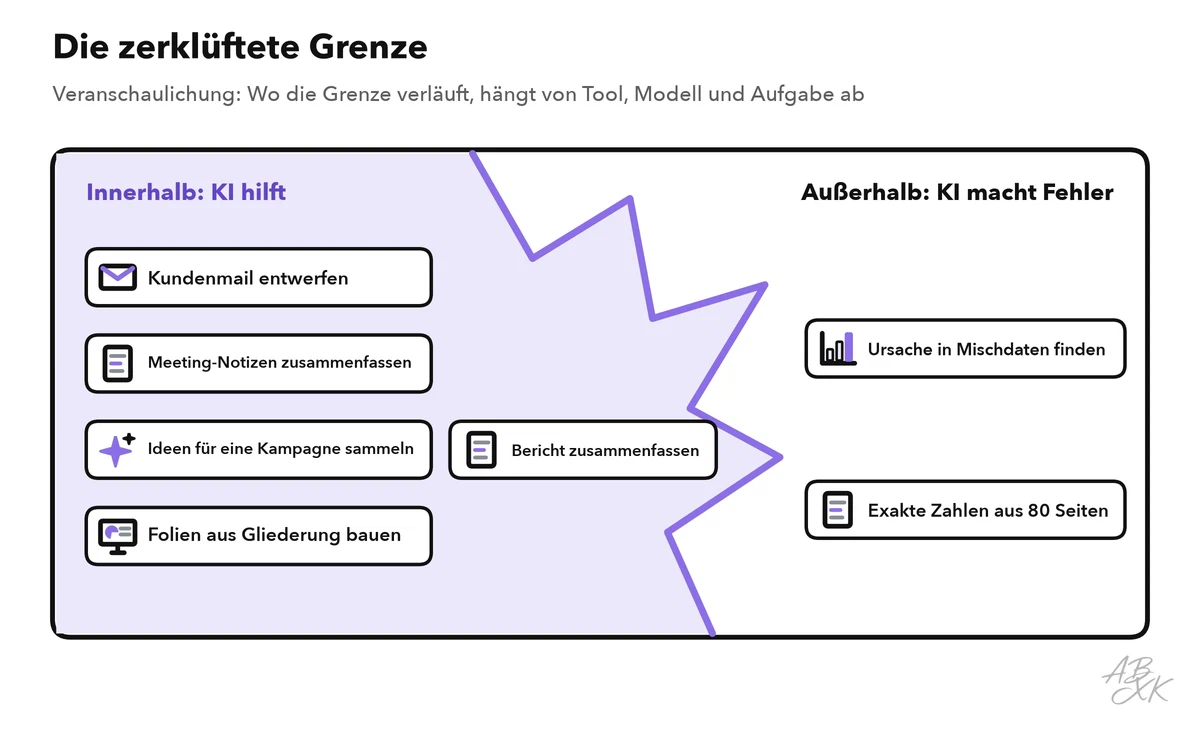
Aus diesen Studien folgen drei Lehren. Der Gewinn hängt von der Person ab: Weniger Erfahrene profitieren oft am meisten. Er hängt von der Aufgabe ab: Jenseits der Grenze kann KI die Ergebnisse verschlechtern. Und das Gefühl täuscht: Nur die Messung zeigt, welcher Fall bei Ihnen vorliegt.
Zwei neuere Befunde erweitern das Bild. Ein Überblick der Internationalen Arbeitsorganisation von 2026 kommt zu dem Schluss, dass die Produktivitätsgewinne real sind, aber oft nicht belegt und ungleich verteilt. Die Zeitersparnis, die Beschäftigte angeben – einige Prozent ihrer Arbeitszeit –, zeigt sich bisher weder in der gemessenen Leistung noch bei Löhnen oder Beschäftigung (Quelle: Merola et al., ILO-Forschungsbericht, Juni 2026). Und gesparte Zeit der einen kann zur Arbeit der anderen werden. In einer Umfrage von BetterUp Labs und dem Stanford Social Media Lab von 2025 hatten 40 % der Büroangestellten in den USA im vergangenen Monat polierte, aber inhaltsleere KI-Ergebnisse erhalten, von den Forschenden „Workslop“ genannt; jeder Fall kostete fast zwei Stunden, bis er geklärt war (Quelle: berichtet von Fortune, September 2025). Messen Sie deshalb auf Teamebene, nicht nur bei der Person, die das Tool nutzt.
Die passende Einheit für jede Tool-Art
Verschiedene Tools brauchen verschiedene Arbeitseinheiten. Unser Vergleich führt 66 Tools für AI Productivity, und Versprechen wie „spart zehn Stunden pro Woche“ beschreiben die Aufgaben anderer Leute, nicht Ihre. So könnten Sie vier verbreitete Tool-Arten messen:
| Tool-Art | Arbeitseinheit | Wichtigste Kennzahl | Zu zählende Fehler |
|---|---|---|---|
| Meeting-Assistent | Eine Meeting-Zusammenfassung mit Aufgaben | Minuten vom Meeting-Ende bis zur verschickten Zusammenfassung | Falsche Namen, Zuständige oder Zahlen |
| Schreibassistent | Ein überarbeitetes Dokument | Bearbeitungsminuten pro Seite | Veränderter Sinn, erfundene Fakten |
| Präsentations-Tool | Ein prüfbereites Foliendeck | Minuten bis zum prüfbaren Deck, plus Korrekturzeit | Falsche Diagramme, austauschbarer Text |
| KI-Kalender | Eine Arbeitswoche | Stunden ununterbrochener Fokuszeit | Wichtige Termine verschoben oder verpasst |


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Ein Messprotokoll zum Übernehmen
Legen Sie in einer Tabellenkalkulation eine Zeile pro Aufgabe an und füllen Sie sie direkt nach jeder Aufgabe aus — nicht erst am Ende der Woche. Die Zeilen unten sind ein Beispiel mit erfundenen Werten; die Qualitätsspalte addiert die vier Kriterien des Rasters (0–8).
| Datum | Aufgaben-ID | Aufgabentyp | Mit KI? | Aktive Min. | Nacharbeit Min. | Qualität (0–8) | Fehler | Nach leichten Korrekturen genutzt? |
|---|---|---|---|---|---|---|---|---|
| 06.10. | R-01 | Wochenbericht | nein | 34 | 0 | 6 | 0 | – |
| 07.10. | R-02 | Wochenbericht | ja | 22 | 5 | 6 | 1 | ja |
| 08.10. | R-03 | Wochenbericht | ja | 31 | 12 | 5 | 2 | nein |
Vergleichen Sie nach vier Wochen die Mediane je Aufgabentyp. Eine Aufgabe, die besteht, wird zum Baustein für einen persönlichen KI-Workflow. Entscheiden Sie nach einer einfachen Regel, die Sie vor dem Start festhalten:
| Ergebnis nach der Lernphase | Entscheidung |
|---|---|
| Zeit um mindestens 20 % gesunken, Qualität gleich oder besser, Fehlerquote nicht höher | KI für diese Aufgabe behalten und den Ablauf dokumentieren |
| Zeit gesunken, aber Qualität oder Fehlerquote schlechter | Prompt verbessern oder einen Prüfschritt einbauen, dann erneut messen |
| Zeit nicht gesunken | KI für diese Aufgabe nicht mehr einsetzen |
| Gemischte Ergebnisse mit weniger als 10 Aufgaben pro Gruppe | Weiter messen, bevor Sie entscheiden |