

Sie laden einen 60-seitigen Vertrag in einen KI-Assistenten und stellen eine einfache Frage. Die Antwort klingt sicher, übersieht aber die Klausel auf Seite 41. Oder sie zitiert einen Satz, der im Vertrag gar nicht steht. Bei langen Dokumenten scheitern KI-Assistenten am leisesten — und gerade hier macht gute Technik den größten Unterschied.
Dies ist Teil 2 von Level 4 unseres Lernpfads AI Productivity. Context Engineering heißt: entscheiden, was in die Eingabe des Modells kommt, in welcher Reihenfolge und in welcher Form. Es ist der Schritt nach dem guten Prompt. Sie lernen, was ein Kontextfenster wirklich enthält, warum Modelle in der Mitte langer Eingaben Details verlieren, fünf Techniken, die ganz ohne Programmieren funktionieren, und wie Sie eine Antwort zu einem Dokument prüfen, das Sie nicht komplett gelesen haben.
Was ein Kontextfenster enthält
Das Kontextfenster kennen Sie aus Level 0: die größte Textmenge, die ein Modell auf einmal berücksichtigen kann. Gemessen wird es in Tokens — Wortstücken. OpenAI nennt für Englisch eine Faustregel: Ein Token entspricht etwa vier Zeichen oder drei Vierteln eines Wortes, 100 Tokens sind also rund 75 Wörter. Andere Sprachen, etwa Deutsch, brauchen für denselben Inhalt oft mehr Tokens.
Ein grobes Beispiel: Ein Vertrag mit 60 Seiten zu je etwa 500 Wörtern hat 30.000 Wörter. Das sind rund 40.000 Tokens. Ob das passt, hängt von Modell und Tool ab. Unsere LLM-Datenbank führt 343 Modelle mit ihren Testergebnissen; die genaue Fenstergröße Ihres Modells finden Sie in der Dokumentation des Anbieters, denn sie ändert sich mit neuen Versionen.
Das Fenster enthält mehr als Ihr Dokument: auch die eigenen Anweisungen des Tools, den Chatverlauf, jede hochgeladene Datei, Ihre Frage — und die Antwort, die ebenfalls Platz braucht.
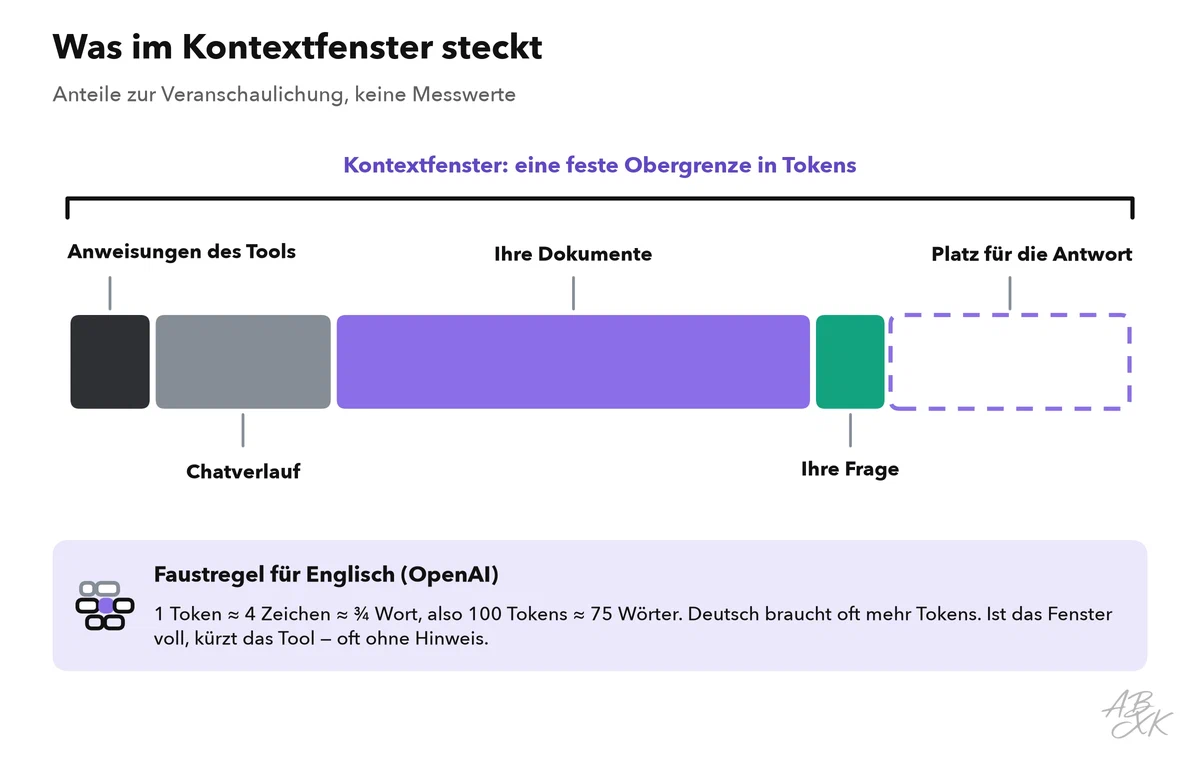
Ist das Fenster voll, muss etwas weichen. Das Tool kürzt, fasst zusammen oder lässt Teile der Eingabe weg — oft ohne deutlichen Hinweis. Ein langer Chat mit mehreren hochgeladenen Dateien ist der klassische Fall: Was Sie vor einer Stunde besprochen haben, ist womöglich schlicht nicht mehr da.
Größer heißt nicht besser: Lost in the Middle
Selbst wenn ein Dokument hineinpasst, liest das Modell es nicht so wie Sie. Eine bekannte Studie hat untersucht, wie Sprachmodelle lange Eingaben nutzen. Die Trefferquote war am höchsten, wenn die entscheidende Information am Anfang oder am Ende der Eingabe stand, und sie sank deutlich, wenn sie in der Mitte stand. (Quelle: Liu u. a., „Lost in the Middle: How Language Models Use Long Contexts“, 2023, 2024 erschienen in Transactions of the Association for Computational Linguistics, arxiv.org)
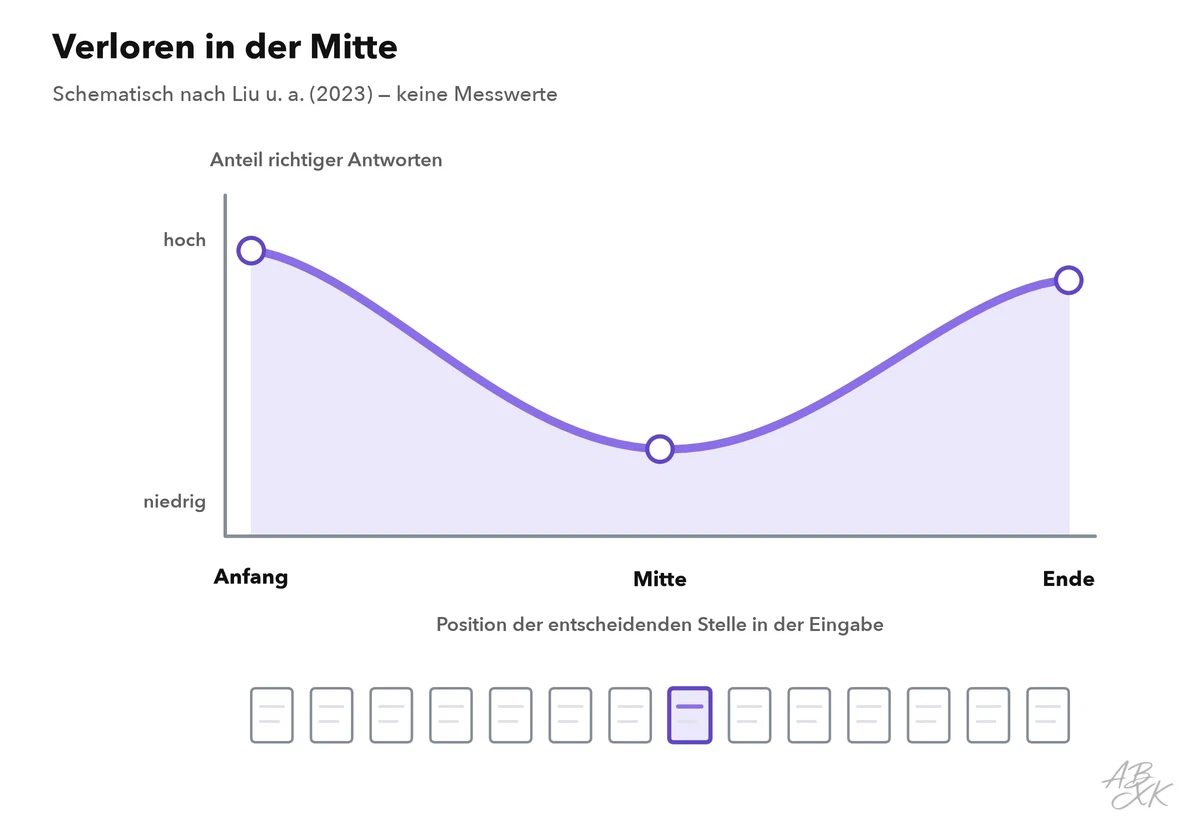
Die Studie hat Modelle aus dem Jahr 2023 getestet, neuere Modelle können sich anders verhalten. Die praktische Lehre gilt trotzdem: Je mehr unwichtiger Text die gesuchte Stelle umgibt, desto größer das Risiko, dass das Modell sie übersieht oder mit einer ähnlichen verwechselt. Vielleicht kennen Sie „Nadel im Heuhaufen“-Tests, bei denen ein einzelner eingeschmuggelter Satz in einem langen Text steckt. Wer sie besteht, kann einen Fakt finden. Das heißt noch nicht, dass das Modell zehn über das Dokument verteilte Fakten verknüpfen kann.
Fünf Techniken, die ohne Programmieren funktionieren
| Technik | Was Sie tun | Geeignet für | Hauptrisiko |
|---|---|---|---|
| Kürzen | Entfernen, was die Frage nicht braucht: Anhänge, Standardtexte, alte Fassungen | Jedes lange Dokument | Sie streichen genau den Teil, auf den es ankam |
| Strukturieren | Jedes Dokument und jeden Abschnitt mit Namen und Kennung versehen; Dokumente zuerst, Ihre Frage zuletzt | Mehrere Dokumente auf einmal | Gering — das hilft fast immer |
| Aufteilen | Das Dokument in Teile von wenigen Seiten zerlegen und nacheinander bearbeiten | Sehr lange Dokumente | Bezüge zwischen den Teilen gehen verloren; Überlappung hilft |
| Erst zusammenfassen, dann fragen | Jeden Teil nach derselben Vorlage zusammenfassen, dann die Frage an die Zusammenfassungen stellen | Überblicksfragen | Details verschwinden in den Zusammenfassungen |
| Abrufen (Retrieval) | Ein Suchschritt wählt die Stellen, die zur Frage passen, und gibt nur diese an das Modell | Fragen an große Sammlungen | Verfehlt die Suche eine Stelle, fehlt sie auch in der Antwort |
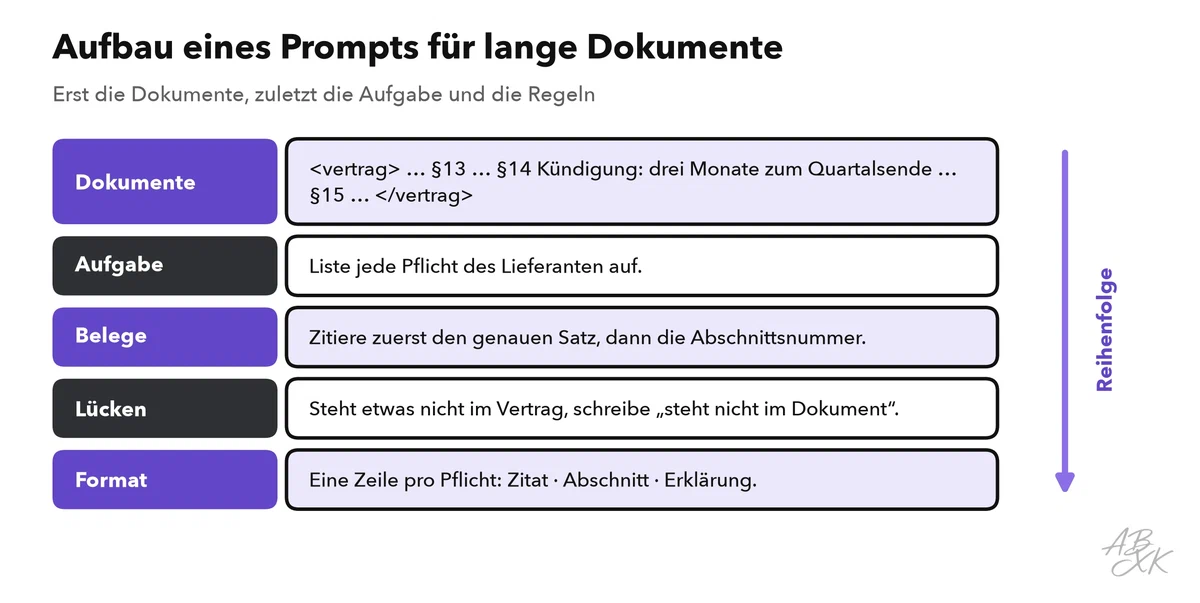
Auch die Reihenfolge in Ihrer Eingabe zählt. Der Prompting-Leitfaden von Anthropic für Claude empfiehlt, lange Dokumente an den Anfang zu stellen, die Frage ans Ende, und das Modell die relevanten Stellen zitieren zu lassen, bevor es antwortet. (Quelle: Anthropic, Claude prompting best practices, platform.claude.com)
Die Eingabe vorbereiten, bevor Sie fragen
Viele falsche Antworten entstehen schon vor der Frage: Das Tool hat das Dokument gar nicht so gelesen, wie Sie denken. Vier Gewohnheiten verhindern die meisten dieser Probleme:
- Prüfen Sie, was das Tool wirklich gelesen hat. Fragen Sie nach der Überschrift des letzten Abschnitts und nach der Seitenzahl. Stimmt die Antwort nicht, wurde die Datei abgeschnitten oder nur teilweise geladen.
- Vorsicht bei gescannten PDFs. Ein Scan ist ein Bild von Text. Das Tool muss die Buchstaben erst erkennen (OCR, optische Zeichenerkennung), und dieser Schritt macht Fehler. Vergleichen Sie einige Sätze mit dem Original.
- Geben Sie Tabellen eine klare Form. Aus PDFs kopierte Tabellen verlieren oft ihre Spalten. Fügen Sie sie als Text mit eindeutigen Spaltennamen ein oder fragen Sie gesondert danach.
- Starten Sie neu für eine neue Aufgabe. Ein langer Chat ist auch ein langes Dokument. Öffnen Sie einen neuen Chat und fügen Sie eine kurze Übersicht mit den Fakten ein, die noch zählen — statt sich darauf zu verlassen, was das Tool vielleicht noch weiß.
Retrieval, erklärt für Nicht-Entwickler
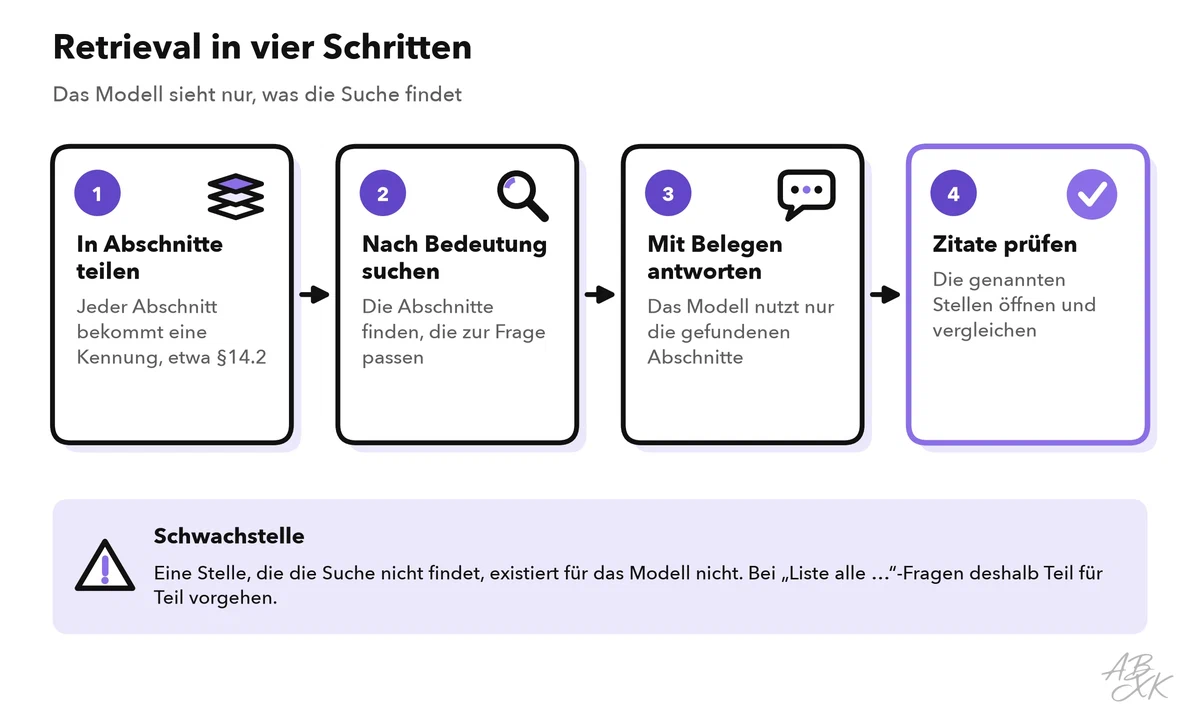
Retrieval-Augmented Generation (RAG) setzt vor die Antwort einen Suchschritt. Das Tool zerlegt Ihre Quellen in kleine Abschnitte und speichert sie. Stellen Sie eine Frage, sucht es die Abschnitte, die zur Bedeutung der Frage passen — nicht nur zu den genauen Wörtern — und gibt sie dem Modell mit. Das Modell antwortet dann aus diesen Abschnitten und kann auf sie verweisen.
Selbst bauen müssen Sie das nicht. Recherche-Tools wie Nouswise stützen ihre Antworten auf die Quellen, die Sie hochladen, und Consensus durchsucht wissenschaftliche Fachartikel, nach Angaben der Anbieter. Meeting- und Audio-Tools machen aus langen Aufnahmen Transkripte — auch das sind lange Dokumente.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Retrieval hat eine große Schwäche: Das Modell kennt nur die Abschnitte, die die Suche geliefert hat. Fragen wie „Liste alle …“ oder „Gibt es irgendeine Klausel zu …“ sind schwierig, weil die Antwort über viele Stellen verteilt sein kann. Für solche Vollständigkeitsfragen gehen Sie das Dokument besser Teil für Teil durch. Level 1 erklärt, wie Sie mit KI recherchieren und Quellen prüfen; wenn Sie ein eigenes Retrieval-System bauen wollen, finden Sie die technische Seite im Bereich AI Development.
Antworten zu langen Dokumenten prüfen
Eine Antwort zu einem langen Dokument nützt nur, wenn Sie sie prüfen können, ohne alles zu lesen. Diese Prüfungen dauern Minuten:
| Prüfung | So geht’s | Was sie aufdeckt |
|---|---|---|
| Zitatprüfung | Jeden zitierten Satz in der Quelle suchen (Strg+F oder Cmd+F) | Erfundene oder veränderte Zitate |
| Test mit bekannter Antwort | Eine Frage stellen, deren Antwort Sie kennen — am besten aus der Mitte des Dokuments | In der Mitte verlorene Details |
| Reihenfolge-Test | Erneut fragen, mit den Teilen in anderer Reihenfolge, und die Antworten vergleichen | Antworten, die von der Position abhängen |
| Vollständigkeitstest | Bei „Liste alle“-Fragen Teil für Teil vorgehen und die Listen zusammenführen | Fehlende Punkte |
| Zahlenprüfung | Jede Zahl mit der Originaltabelle oder -seite vergleichen | Vertauschte oder gerundete Zahlen |
Eine fehlgeschlagene Prüfung ist eine nützliche Information. Sie zeigt, ob Sie stärker kürzen, kleiner aufteilen oder auf Retrieval umsteigen sollten. Level 2 zeigt eine vollständige Routine, um KI-Ergebnisse auf Fehler zu prüfen, und Teil 5 dieses Levels, wie aus solchen Prüfungen ein wiederholbarer Testsatz wird.
Durchgerechnetes Beispiel: ein 60-seitiger Liefervertrag
Sie brauchen für ein Meeting morgen alle Pflichten eines Lieferanten aus einem langen Vertrag, mit Abschnittsnummern. Diese Routine kombiniert die Techniken von oben:
- Kürzen. Entfernen Sie Preisanhänge und Unterschriftenseiten. Behalten Sie die Abschnittsnummern im Text.
- Aufteilen. Teilen Sie den Vertrag entlang seiner Kapitel in sechs Teile. Benennen Sie sie „Teil 1 von 6“ und so weiter.
- Je Teil auslesen. Schicken Sie jeden Teil mit dem Prompt aus dem Kasten oben. Verlangen Sie Zitate und Abschnittsnummern.
- Zusammenführen. Legen Sie die sechs Listen zusammen und lassen Sie das Modell Doppelungen entfernen — ohne etwas Neues hinzuzufügen.
- Prüfen. Machen Sie bei jedem Punkt die Zitatprüfung. Fragen Sie dann nach der Kündigungsfrist, von der Sie wissen, dass sie in Abschnitt 14 steht — als Test mit bekannter Antwort.
- Stellen Sie Ihre eigentlichen Fragen an die zusammengeführte Liste, nicht an den ganzen Vertrag.
Das Ergebnis ist eine Liste, die Sie im Meeting vertreten können: Jede Zeile verweist auf einen Abschnitt, den Sie aufschlagen können. Scheitert der Test mit bekannter Antwort, braucht der Teil mit Abschnitt 14 einen zweiten Durchgang.