

Die meisten Menschen nutzen einen KI-Assistenten mit seinem Standardmodell für alles: E-Mails, Recherche, Tabellenformeln, lange Berichte. Das geht gut, bis eine Aufgabe mehr verlangt. Ein Modell, das bei schwierigen Analysen glänzt, kann für eine kurze Antwort zu langsam sein. Ein schnelles Modell kann an einer kniffligen Rechnung scheitern. Und das Modell an der Spitze einer Rangliste darf in Ihrem Unternehmen womöglich gar nicht genutzt werden.
Dies ist Teil 1 von Level 3 unseres Lernpfads AI Productivity. In Level 3 geht es darum, KI in Ihre Arbeit einzubauen und die Ergebnisse zu messen. Hier lernen Sie die sechs Unterschiede zwischen Sprachmodellen kennen und erfahren, wie Sie unsere LLM-Datenbank und ihre Rangliste lesen. Danach ordnen Sie Aufgaben den Stärken der Modelle zu und testen zwei oder drei Modelle an Ihrer eigenen Arbeit. Wenn Sie die Grundlagen auffrischen möchten: Level 0 erklärt, was ein großes Sprachmodell ist.
Sechs Unterschiede zwischen Sprachmodellen
Alle großen Sprachmodelle (Large Language Models, LLMs) tun im Kern dasselbe: Sie sagen Text voraus, Stück für Stück. Trotzdem unterscheiden sie sich in Punkten, die für Ihre Arbeit zählen. Sechs Unterschiede entscheiden die meisten Fragen.
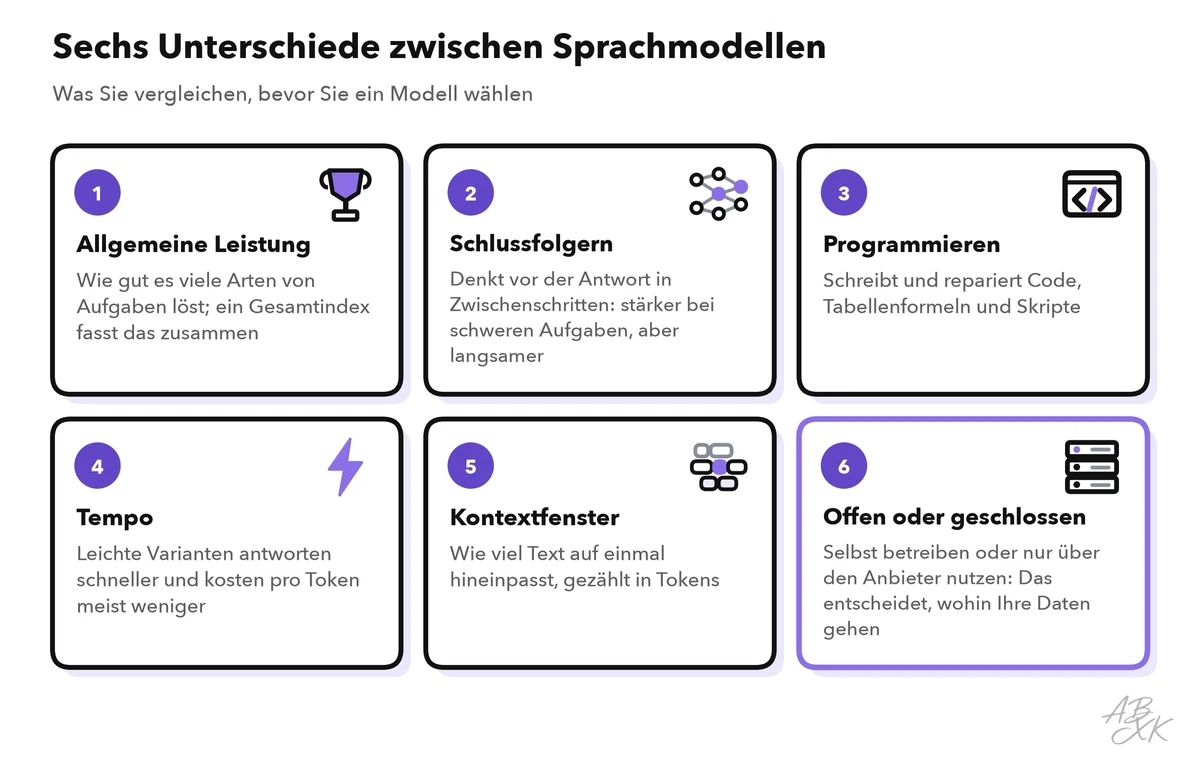
- Allgemeine Leistung. Wie gut ein Modell viele verschiedene Arten von Aufgaben löst. Ein Gesamtindex fasst das in einer Zahl zusammen — mehr dazu unten.
- Schlussfolgern. Viele aktuelle Modelle können schlussfolgern (englisch Reasoning), bevor sie antworten. Sie arbeiten zuerst Zwischenschritte durch, oft für Sie unsichtbar, und schreiben dann die Antwort. Das dauert länger und verbraucht mehr Tokens, hilft aber bei Analysen, Planung, Mathematik und Code. Viele Assistenten bieten dafür einen „Denkmodus“, den Sie einschalten können.
- Programmieren. Manche Modelle schreiben und reparieren Code, Tabellenformeln und Skripte deutlich besser als andere.
- Tempo. Große Modelle sind oft langsamer. Viele Anbieter haben neben einem großen Modell leichtere, schnellere Varianten; Namen wie Flash, Mini oder Haiku kennzeichnen meist die leichteren. Wenn Sie ein Modell über eine API (eine Schnittstelle für Software) nutzen, zahlen Sie pro Token. Leichtere Varianten kosten pro Token meist weniger.
- Kontextfenster. Die Textmenge, die ein Modell auf einmal aufnehmen kann, gezählt in Tokens — kleinen Wortstücken. Es entscheidet, ob ein langer Bericht in einem Stück hineinpasst. Level 4 zeigt, wie Sie mit langen Dokumenten arbeiten.
- Offene oder geschlossene Gewichte. Ein Modell mit offenen Gewichten (Open Weights) können Sie herunterladen und auf eigenen Servern betreiben. Ein geschlossenes Modell lässt sich nur über die Apps oder Schnittstellen seines Anbieters nutzen. Davon hängt ab, wohin Ihre Daten gehen.
Die Kunst ist nicht, das eine „beste“ Modell zu finden. Sie besteht darin zu wissen, welche dieser sechs Punkte für Ihre Aufgabe zählen — und dort, wo sie nicht zählen, einen schwächeren Wert in Kauf zu nehmen.
So lesen Sie unsere LLM-Datenbank und die Rangliste
Unsere LLM-Datenbank führt 343 Sprachmodelle, von GPT-2 bis zu den Modellen von heute. Jede Zeile zeigt, wer das Modell gebaut hat, wann es erschienen ist und ob seine Gewichte offen sind. Dazu kommen der Gesamtindex, der Rang des Modells und die Zahl der Benchmarks mit Ergebnissen. Sie können nach Organisation, Jahr und Zugang filtern und nach Datum oder Index sortieren. Kreuzen Sie zwei bis vier Modelle an, sehen Sie alle ihre Ergebnisse nebeneinander. Von der Startseite aus sind zwei weitere Ansichten einen Klick entfernt. Die Rangliste stellt alle Modelle mit Index auf eine Skala. Die Benchmark-Seite zeigt die Rekorde jedes Tests im Zeitverlauf.
Der Gesamtindex ist der Epoch Capabilities Index (ECI). Er stammt von Epoch AI, der Forschungsorganisation, auf deren Daten unsere LLM-Seiten beruhen. Der ECI fasst viele Benchmark-Ergebnisse zu einer Zahl je Modell zusammen. Diese acht Modelle führen ihn derzeit an:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Claude Opus 5.5 Anthropic | 22.09.2026 | 166,8 |
| 2 | GPT-6 Astra OpenAI | 03.09.2026 | 166,4 |
| 3 | GPT-6.1 Sol OpenAI | 29.09.2026 | 166,3 |
| 4 | Claude Fable 5.1 Anthropic | 01.09.2026 | 164,7 |
| 5 | Gemini 4 Argon Google DeepMind | 30.09.2026 | 164,6 |
| 6 | Claude Sonnet 5.5 Anthropic | 28.09.2026 | 164,4 |
| 7 | Claude Opus 5 Anthropic | 24.07.2026 | 162,6 |
| 8 | GPT-6 Sol OpenAI | 22.09.2026 | 162,6 |



Fasst die Ergebnisse von mehr als 50 Benchmarks zu einer Zahl je Modell zusammen, sodass sich Modelle vergleichen lassen, auch wenn sie nie auf denselben Benchmarks geprüft wurden. Ein Index, kein Prozentwert: Epoch AI skaliert ihn so, dass Claude 3.5 Sonnet bei 130 und GPT-5 bei 150 steht. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Lesen Sie eine solche Liste mit drei Fragen. Wie groß ist der Abstand? Der Index ist eine Schätzung mit Fehlerspanne. Unsere Rangliste weist darauf hin, dass Unterschiede von ein bis zwei Punkten innerhalb dieser Spanne liegen. Wann ist das Modell erschienen? Ein ganz neues Modell hat womöglich noch nicht in jedem Test Ergebnisse. Dürfen Sie es nutzen? Ein Spitzenmodell hilft nicht, wenn Ihr Unternehmen es nicht freigegeben hat oder wenn es für Ihre Aufgabe zu langsam ist.
Die Spalten der Datenbank sagen mehr als der Rang:
| Spalte | Was sie zeigt | Worauf Sie achten sollten |
|---|---|---|
| Erschienen | Wann das Modell herauskam | Ganz neuen Modellen fehlen womöglich noch Ergebnisse in manchen Tests |
| Zugang | Offene Gewichte oder geschlossen (API oder App) | Auch offene Gewichte können Lizenzgrenzen haben |
| ECI und Rang | Gesamtleistung auf einer Skala | Abstände von ein bis zwei Punkten liegen innerhalb der Fehlerspanne |
| Benchmarks | In wie vielen unserer Tests das Modell Ergebnisse hat | Eine kleine Zahl bedeutet weniger Belege, kein schwächeres Modell |
| Direktvergleich | Alle Ergebnisse von zwei bis vier Modellen | Werte nur innerhalb desselben Benchmarks vergleichen |
Die Aufgabe den Stärken des Modells zuordnen
Der Gesamtindex ist ein guter erster Filter, aber er ist ein Durchschnitt. Für eine konkrete Aufgabe schauen Sie auf den Test, der ihr am nächsten kommt. Die Tabelle ordnet typische Büroaufgaben zu: was jeweils am meisten zählt und wo Sie es in unseren Daten prüfen können.
| Ihre Aufgabe | Was am meisten zählt | Wo Sie in unseren Daten nachsehen | Ein guter Startpunkt |
|---|---|---|---|
| E-Mails, Zusammenfassungen, Umformulierungen | Tempo, Ton, Ihre Sprache | Kein Test passt gut — Ihr eigener Test entscheidet | Ein schnelles, leichtes Modell |
| Analysen, Planung, knifflige Fragen | Schlussfolgern | GPQA Diamond, Humanity’s Last Exam | Ein großes Modell oder ein Denkmodus |
| Fakten und Recherche | Richtige Fakten, echte Quellen | SimpleQA Verified (beantwortet ohne Websuche) | Ein Assistent mit Websuche, der seine Quellen zeigt |
| Formeln, Skripte, Code | Programmieren | SWE-bench Verified, Aider Polyglot | Ein Modell, das in diesen Tests gut abschneidet |
| Berechnungen | Mehrstufige Mathematik | FrontierMath, MATH Level 5 | Ein Denkmodus — danach die Zahlen prüfen |
| Lange Dokumente | Kontextfenster | Nicht in unseren Daten — siehe Dokumentation des Anbieters | Ein Modell mit großem Fenster |
| Lange Aufgaben mit vielen Schritten | Selbstständiges Arbeiten | METR Time Horizon | Ein Spitzenmodell, eng beaufsichtigt |
Für schwierige Fachfragen ist GPQA Diamond ein guter Wegweiser. Diese fünf Modelle führen den Test an:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Gemini 4 Argon (high) Google DeepMind | 30.09.2026 | 96,4 % |
| 2 | GPT-6 Astra (max) OpenAI | 03.09.2026 | 95,8 % |
| 3 | Claude Sonnet 5.5 (max) Anthropic | 28.09.2026 | 95,6 % |
| 4 | Gemini 3.8 Flash (high) Google DeepMind | 02.09.2026 | 95,4 % |
| 5 | GPT-6.1 Sol (max) OpenAI | 29.09.2026 | 95,4 % |
198 Multiple-Choice-Fragen aus Biologie, Physik und Chemie auf Graduiertenniveau, so gebaut, dass Fachfremde selbst mit Webzugang scheitern. Raten ergibt 25 %. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Vergleichen Sie diese Liste mit dem Gesamtindex oben: Die Reihenfolge ist nicht dieselbe. Zusätze wie „(high)“ oder „(max)“ hinter einem Namen nennen die Einstellung des Testlaufs — meist mehr Denkzeit. Prüfen Sie also, welche Einstellung Sie tatsächlich nutzen werden: Ein Ergebnis mit maximaler Denkzeit sagt wenig über dasselbe Modell im schnellen Modus. Die Abbildung zeigt die Spitzenreiter von sechs unserer Tests nebeneinander.
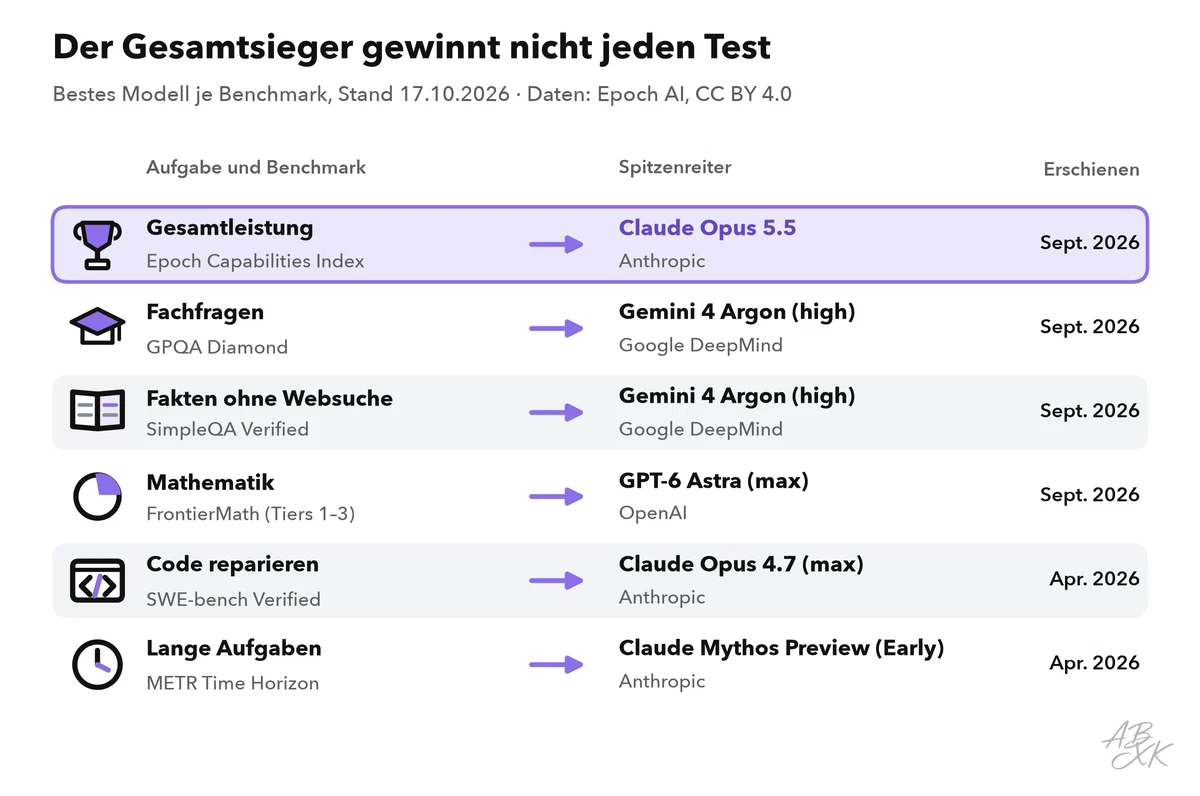
Das Modell an der Spitze des Gesamtindex gewinnt nicht jeden Test. Manche Spitzenreiter sind womöglich ältere Modelle. Das heißt nicht immer, dass die neueren schwächer sind. Vielleicht haben sie in diesem Test einfach noch keine Ergebnisse. Der Teil aus Level 4 über Benchmarks lesen wie ein Profi erklärt diese und weitere Fallen ausführlich.
Offene oder geschlossene Gewichte: wohin Ihre Daten gehen
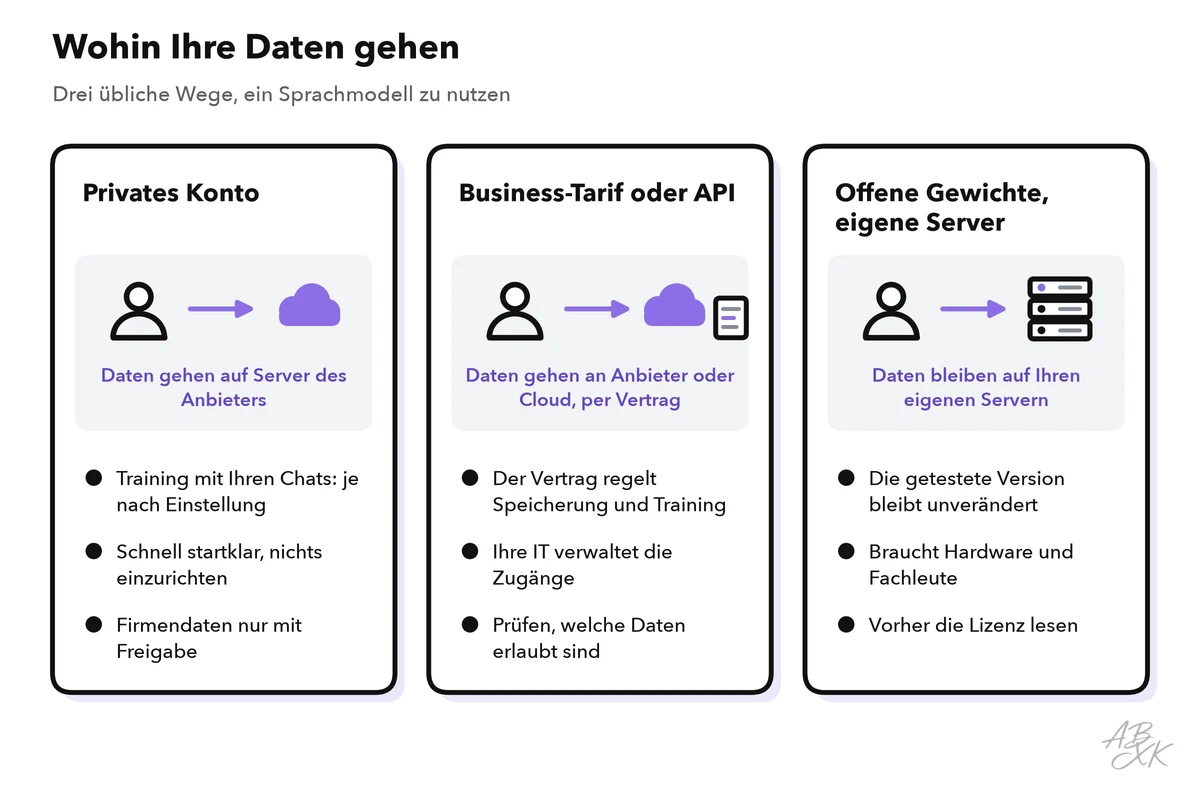
Bei einem geschlossenen Modell gehen Ihre Prompts und Dateien auf Server des Anbieters oder eines Cloud-Anbieters, der das Modell bereitstellt. Bei einem Modell mit offenen Gewichten entscheiden Sie, wo es läuft: auf eigenen Servern oder bei einem Hosting-Anbieter Ihrer Wahl. Deshalb ist „offen oder geschlossen?“ oft eine Frage des Datenschutzes, nicht nur der Qualität.
In unserer Datenbank haben 172 Modelle offene Gewichte, 160 sind geschlossen; bei den übrigen ist der Zugang unbekannt. Das linke Diagramm zeigt, wie viele Modelle jeder Art pro Jahr erschienen sind. Das rechte zeigt den Gesamtindex des stärksten offenen und des stärksten geschlossenen Modells jedes Jahres.
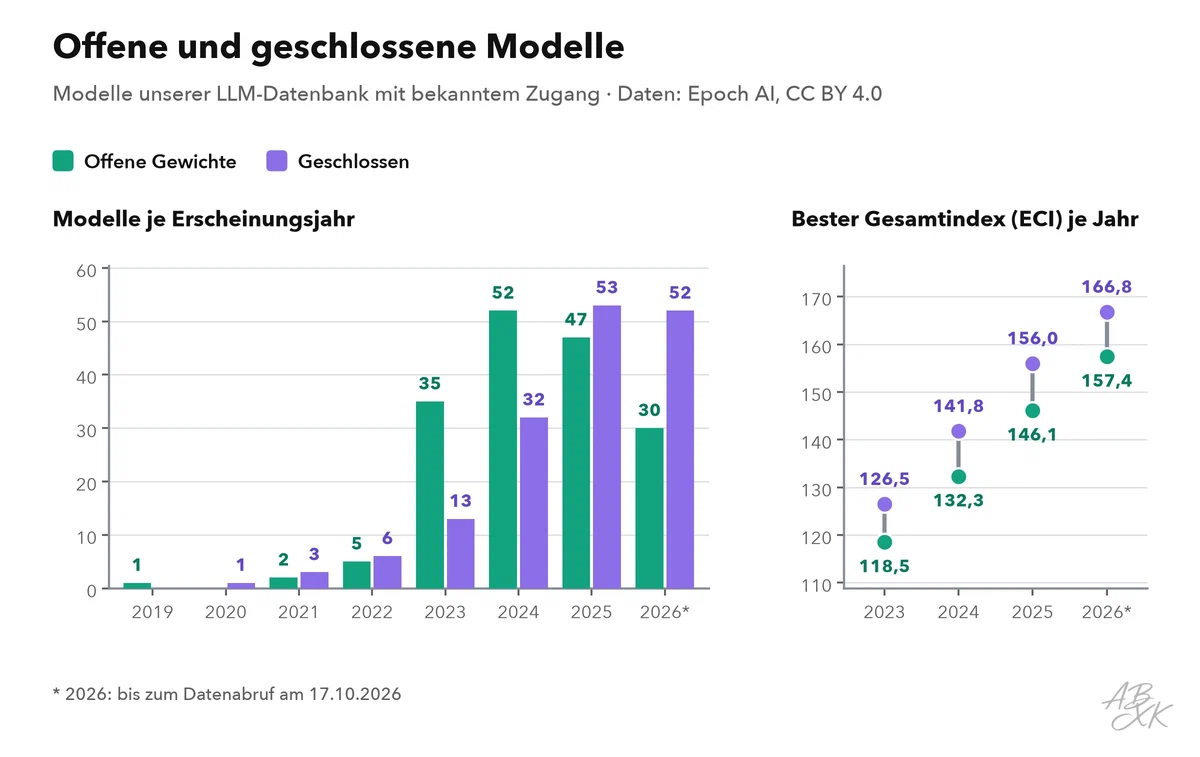
Der Abstand zwischen den beiden Punkten eines Jahres zeigt ungefähr, wie viel Gesamtleistung Sie aufgeben, wenn Sie offene Gewichte brauchen. Bedenken Sie: Die Datenbank führt nur Modelle mit Benchmark-Ergebnissen, sie ist also keine vollständige Zählung aller Modelle. Hier stehen zwei geschlossene Modelle von der Spitze des Index neben zwei starken Modellen mit offenen Gewichten:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Claude Opus 5.5 Anthropic | 22.09.2026 | geschlossen | 166,8 | 1 |
| GPT-6 Astra OpenAI | 03.09.2026 | geschlossen | 166,4 | 2 |
| Kimi K3 Moonshot | 16.07.2026 | offen | 157,4 | 17 |
| DeepSeek V4 Pro 0813 DeepSeek | 13.08.2026 | offen | 155,3 | 32 |

ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Offene Gewichte bringen mehr als Datenschutz. Die Kopie, die Sie betreiben, bleibt unverändert: Der Anbieter kann sie weder ändern noch abschalten. Sie können das Modell außerdem an Ihre eigenen Daten anpassen. Die Kosten sind aber real: Sie brauchen passende Hardware, Fachleute, die das Modell betreiben, und Zeit für Updates. Und offene Gewichte heißen nicht immer freie Nutzung: Manche Lizenzen verbieten den kommerziellen Einsatz oder setzen andere Grenzen. Lesen Sie die Lizenz, bevor Sie auf einem Modell aufbauen.
Wo ein Modell läuft, entscheidet auch, wer Ihre Daten sehen kann. In der Praxis begegnen Ihnen drei Wege, ein Modell zu nutzen:
Zwei oder drei Modelle an Ihrer eigenen Aufgabe testen
Benchmarks grenzen das Feld ein; Ihr eigener Test entscheidet. Dafür brauchen Sie kein Labor. Ein Nachmittag und ein gemeinsames Dokument genügen.
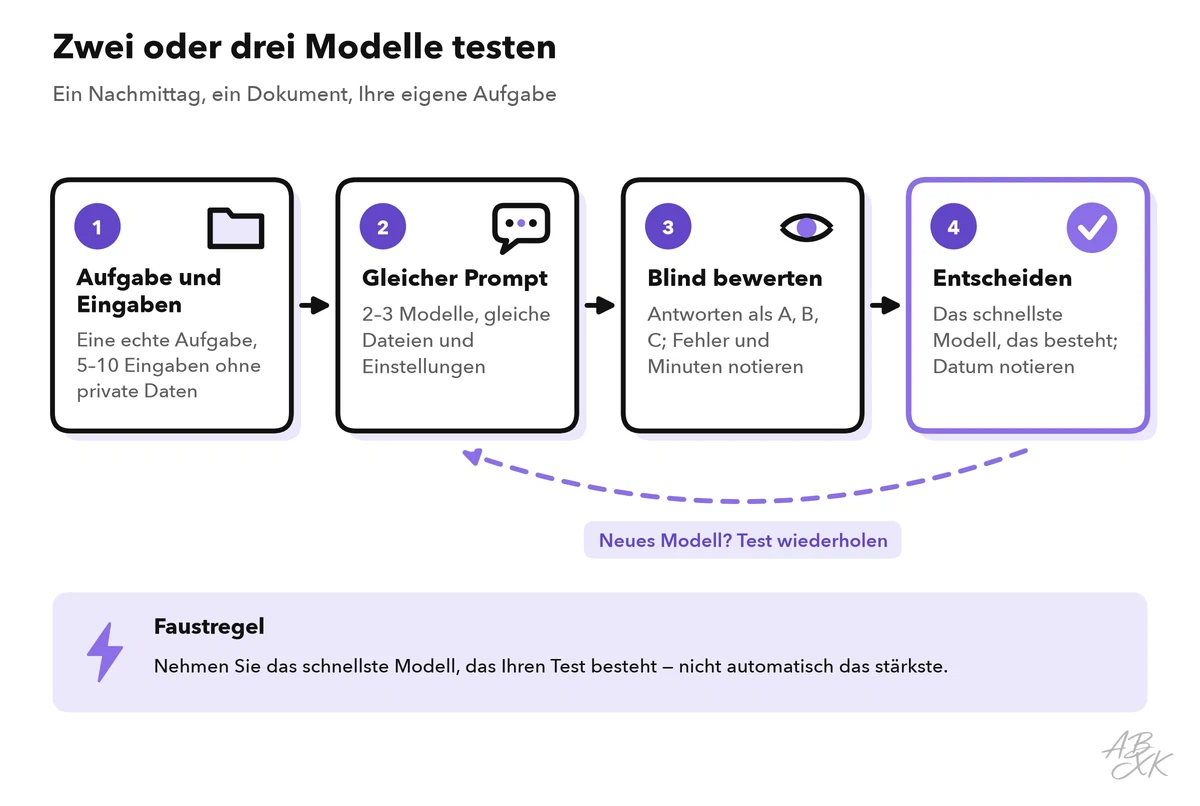
- Wählen Sie eine echte Aufgabe und fünf bis zehn Eingaben. Nehmen Sie eine Aufgabe, die jede Woche wiederkommt, etwa die Antwort auf eine bestimmte Art von Kunden-E-Mail. Entfernen Sie Namen, Zahlen und alles Vertrauliche aus den Eingaben.
- Führen Sie denselben Prompt mit zwei oder drei Modellen aus. Halten Sie alles andere gleich: dieselben Dateien, dieselben Anweisungen, derselbe Modus — alle mit oder alle ohne Denkmodus.
- Bewerten Sie blind. Kopieren Sie die Antworten in ein Dokument und beschriften Sie sie in zufälliger Reihenfolge mit A, B und C. Beurteilen Sie sie, bevor Sie nachsehen, welches Modell was geschrieben hat. Notieren Sie Fehler, die Minuten für die Korrektur jeder Antwort und die Wartezeit.
- Entscheiden Sie und notieren Sie das Datum. Anbieter aktualisieren Modelle und stellen sie ein. Wenn sich Ihr Modell ändert, wiederholen Sie denselben Test.
Eine Regel erleichtert die Entscheidung: Nehmen Sie das schnellste Modell, das Ihren Test besteht, nicht automatisch das stärkste. Einen ersten Test können Sie in Assistenten machen, die Sie vielleicht schon nutzen. Jeder läuft mit den Modellen seines Anbieters, ergänzt aber auch eigene Anweisungen und Werkzeuge wie die Websuche. Sie vergleichen also Produkte, nicht nur Modelle.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Level 4 macht daraus eine vollständige Methode mit Testsatz, Bewertungsraster und Wiederholungstests nach jeder Änderung: Prompts testen und bewerten.
Typische Fehler bei der Modellwahl
| Fehler | Warum er schadet | Besser |
|---|---|---|
| Das Spitzenmodell der Rangliste für alles nutzen | Für einfache Aufgaben langsamer, oft teurer und energiehungriger als nötig | Mit einem schnellen Modell beginnen; nur wechseln, wenn es Ihren Test nicht besteht |
| Nach einem einzigen Benchmark wählen | Jeder Test misst eine Fähigkeit | Auf den Test schauen, der Ihrer Aufgabe am nächsten kommt, und auf mehrere |
| Mit einem einzigen Beispiel testen | Eine gute Antwort kann Glück sein | Fünf bis zehn echte Eingaben nutzen |
| Wissen, welches Modell welche Antwort schrieb | Sie bevorzugen den Namen, den Sie vorn erwarten | Blind bewerten, dann auflösen |
| Datenregeln zuletzt prüfen | Das beste Modell nützt nichts, wenn Sie es nicht nutzen dürfen | Freigabe und Betrieb zuerst prüfen |
| Nie wieder testen | Anbieter aktualisieren Modelle und stellen sie ein | Den Test wiederholen, wenn sich das Modell ändert |
Bewahren Sie Ihre Testeingaben, den Prompt und Ihre Bewertungen an einem Ort auf. Wenn das nächste Modell erscheint, wiederholen Sie den Test in einer Stunde, statt von vorn anzufangen.
Ein kleineres Modell, das Ihren Test besteht, ist auch für die Umwelt die bessere Wahl: Es braucht für jede Antwort weniger Rechenleistung. Level 0 zeigt, wie groß der Energie- und Wasserbedarf von KI geworden ist: Was KI im Arbeitsalltag kann.