

KI-Ergebnisse sehen selten falsch aus. Der Text liest sich flüssig, die Tabelle ist ordentlich, der Ton selbstsicher — auch wenn eine Zahl erfunden ist oder eine Quelle gar nicht existiert. Deshalb ist Prüfen eine eigene Fähigkeit: Sie müssen wissen, wo Fehler stecken, und sie schnell finden, ohne die ganze Aufgabe ein zweites Mal zu erledigen.
Dies ist Teil 5 von Level 2 unseres Lernpfads AI Productivity. In Level 1 haben Sie gelernt, mit KI zu recherchieren und die Quellen zu prüfen, auf die sich eine Antwort stützt. Dieser Teil gilt für alle KI-Ergebnisse, von der E-Mail bis zum Bericht. Sie lernen sechs Fehlerarten, eine Prüfroutine in fünf Schritten und das laterale Lesen kennen. Außerdem sehen Sie, wie KI beim Prüfen helfen kann und wann Sie für eine Aufgabe besser auf KI verzichten.
Sechs Fehlerarten in KI-Ergebnissen
Den Begriff Halluzination kennen viele: eine Aussage, die plausibel klingt, aber falsch oder erfunden ist. Halluzinationen sind allerdings nur eine Fehlerart. Diese sechs decken das meiste ab, was im Arbeitsalltag schiefgeht:
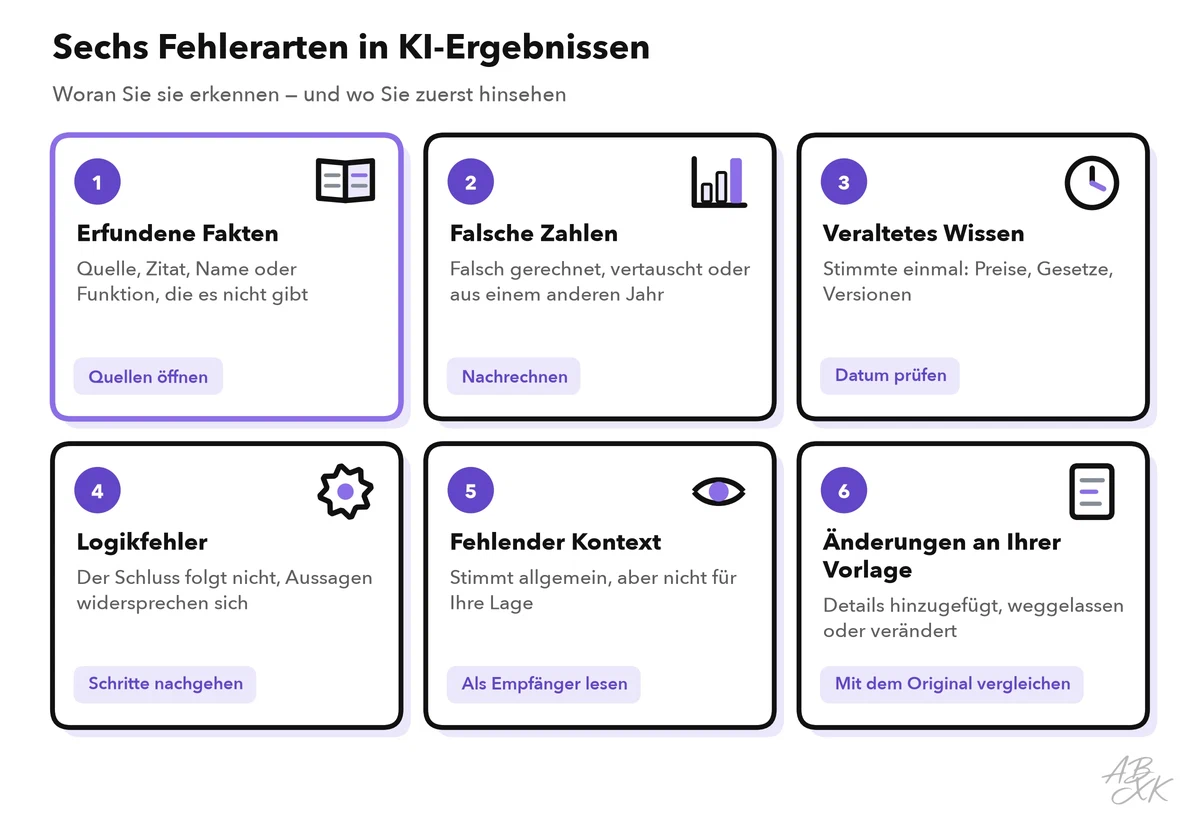
- Erfundene Fakten. Eine Studie, ein Zitat, ein Gerichtsurteil oder eine Produktfunktion, die es nicht gibt. Die Details wirken echt: ein Autor, ein Jahr, sogar eine Seitenzahl.
- Falsche Zahlen. Eine Summe, die nicht aufgeht, ein Prozentwert mit der falschen Basis oder eine Zahl aus einem anderen Jahr. Ein Sprachmodell schreibt Zahlen wie Wörter: als wahrscheinlichen Text. Solange das Tool nicht tatsächlich rechnet, hat niemand nachgerechnet.
- Veraltetes Wissen. Ein Modell lernt aus Daten bis zu einem bestimmten Datum, dem Wissensstichtag (Knowledge Cutoff). Preise, Gesetze, Produktversionen und Zuständigkeiten können sich seitdem geändert haben.
- Logikfehler. Jeder Satz klingt richtig, aber der Schluss folgt nicht daraus, zwei Aussagen widersprechen sich oder ein Schritt fehlt.
- Fehlender Kontext. Die Antwort stimmt im Allgemeinen, aber nicht für Sie. Sie übersieht Ihr Land, Ihre Branche, eine Ausnahme in Ihrem Vertrag oder die andere Seite eines Arguments.
- Änderungen an Ihrer Vorlage. Eine Zusammenfassung oder Umformulierung fügt ein Detail hinzu, lässt eine Bedingung weg oder macht aus „besprochen“ ein „beschlossen“.
Die letzten beiden sind am schwersten zu erkennen, weil im Text nichts falsch aussieht. Sie fallen erst auf, wenn Sie das Ergebnis mit dem Original vergleichen oder an die Person denken, die es lesen wird.
Warum flüssige Antworten trotzdem falsch sein können
Ein Sprachmodell schreibt die wahrscheinlichsten nächsten Wörter. Es hat kein verlässliches Gespür dafür, welche Fakten es gut kennt und welche nicht. Ein Paper von Forschenden bei OpenAI aus dem Jahr 2025 nennt einen weiteren Grund: Training und gängige Tests belohnen Raten. In einem Test bringt „Das weiß ich nicht“ keinen Punkt, ein selbstsicherer Tipp liegt dagegen manchmal richtig. Also lernen Modelle zu raten. (Quelle: Kalai et al., „Why Language Models Hallucinate“, 2025, arxiv.org)
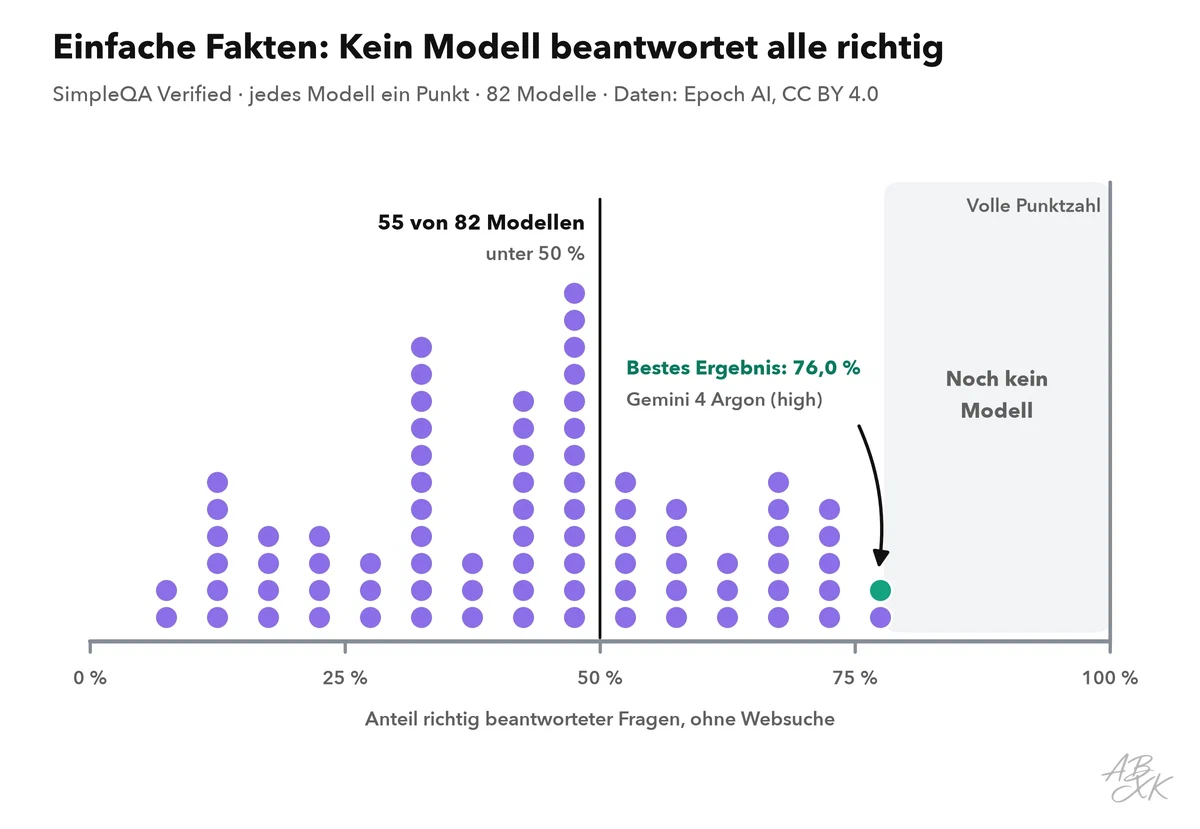
Wie groß das Problem noch ist, zeigen Benchmarks: standardisierte Tests, die alle Modelle auf dieselbe Weise ablegen. SimpleQA Verified kennen Sie aus Level 1: kurze Faktenfragen mit genau einer richtigen Antwort, die die Modelle aus dem Gedächtnis beantworten, ohne Websuche. Das Ergebnis ist der Anteil der Fragen, die ein Modell richtig beantwortet. Das sind die Spitzenreiter in unseren LLM-Daten:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Gemini 4 Argon (high) Google DeepMind | 30.09.2026 | 76,0 % |
| 2 | GPT-6 Astra (max) OpenAI | 03.09.2026 | 75,6 % |
| 3 | GPT-6.1 Sol (max) OpenAI | 29.09.2026 | 73,9 % |
| 4 | Gemini 3.1 Pro Preview Google DeepMind | 19.02.2026 | 73,5 % |
| 5 | Claude Opus 5.5 (max) Anthropic | 22.09.2026 | 72,2 % |



Kurze Faktenfragen mit genau einer richtigen Antwort, beantwortet ohne Hilfsmittel. Zeigt, wie viel ein Modell wirklich weiß — und wie oft es eine Antwort erfindet, statt Nichtwissen zuzugeben. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Level 1 hat gezeigt, wie das beste Ergebnis über die Zeit gestiegen ist. Diese Abbildung zeigt das ganze Feld: jedes getestete Modell als Punkt, platziert nach seinem Ergebnis. Selbst das beste Modell verfehlt einen deutlichen Teil dieser einfachen Fragen, und die meisten Modelle liegen weit darunter.
Assistenten mit Websuche können bei solchen Fragen besser abschneiden, bringen aber eigene Fehler mit, etwa eine echte Quelle, die etwas anderes sagt. Und ein gutes Benchmark-Ergebnis ist ein Durchschnitt: Über die eine Antwort vor Ihnen sagt es nichts. Alle Modelle vergleichen Sie in unserer LLM-Datenbank.
Solche Fehler landen auch in fertiger, bezahlter Arbeit. 2025 erklärte sich Deloitte Australien bereit, der australischen Regierung einen Teil des Honorars für einen Bericht zu erstatten. Der Bericht enthielt ein erfundenes Zitat aus dem Urteil eines Bundesgerichts und Verweise auf Forschungsarbeiten, die es nicht gibt. Die korrigierte Fassung legte offen, dass beim Schreiben ein generatives KI-System genutzt worden war. (Quelle: Associated Press, Oktober 2025)
Fehler rutschen auch deshalb durch, weil Prüfen umso unnötiger wirkt, je mehr man dem Tool vertraut. In einer Umfrage von Microsoft Research und der Carnegie Mellon University unter 319 Wissensarbeitenden von 2025 gaben Menschen mit mehr Vertrauen in generative KI weniger kritisches Denken an, Menschen mit mehr Vertrauen in die eigenen Fähigkeiten dagegen mehr. Kritisches Denken verschwand dabei nicht. Es verlagerte sich auf das Prüfen von Informationen, das Einfügen der Antwort in die Arbeit und die Verantwortung für das Ergebnis (Quelle: Lee et al., CHI 2025). Genau das ist die Aufgabe der folgenden Routine.
Eine Prüfroutine in fünf Schritten
Nicht jedes Wort braucht dieselbe Sorgfalt: Eine Notiz für Sie selbst braucht weniger Prüfung als ein Bericht für die Geschäftsführung.
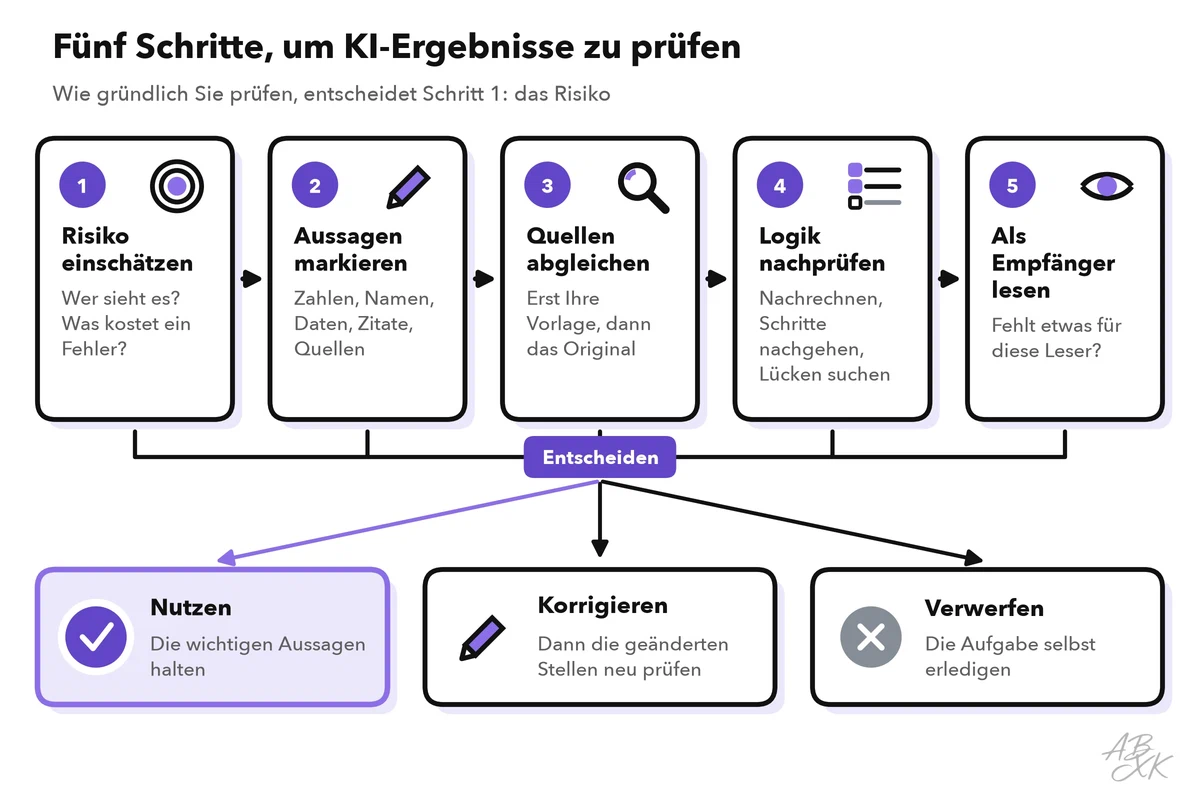
- Risiko einschätzen. Wer sieht das Ergebnis, und was würde ein Fehler kosten? Für einen internen Entwurf reicht kurzes Gegenlesen. Eine Kunden-E-Mail, ein Bericht oder alles, was öffentlich wird, braucht alle fünf Schritte.
- Aussagen markieren. Markieren Sie alles, was wahr oder falsch sein kann: Zahlen, Namen, Daten, Zitate, Quellen und starke Wörter wie „immer“, „nie“ oder „der einzige“.
- Quellen abgleichen. Beginnen Sie mit Ihrer eigenen Vorlage: Steht jede Aussage in dem Text, den Daten oder den Notizen, die Sie dem Tool gegeben haben? Für alle anderen Aussagen suchen Sie die Originalquelle.
- Logik nachprüfen. Rechnen Sie die wichtigsten Zahlen nach. Gehen Sie die Argumentation Schritt für Schritt durch und achten Sie auf Widersprüche und Lücken.
- Als Empfänger lesen. Passt das Ergebnis zu den Lesern und zu der Entscheidung, um die es geht? Was würden sie fragen, das der Text nicht beantwortet?
Dann entscheiden Sie: das Ergebnis nutzen, es korrigieren und die geänderten Stellen erneut prüfen — oder es verwerfen und die Aufgabe selbst erledigen. Die Tabelle zeigt, wie Sie die häufigsten Aussagen schnell prüfen:
| Aussage im Ergebnis | So prüfen Sie | Typischer Fehler |
|---|---|---|
| Zahl oder Rechnung | Nachrechnen, mit Ihren Daten vergleichen, Einheit und Zeitraum prüfen | Falsche Summe, Prozentwert mit falscher Basis, Zahl aus einem anderen Jahr |
| Name, Position oder Produkt | Mit Ihren Unterlagen oder der Website der Organisation vergleichen | Ähnlicher Name, veraltete Position, eine Funktion, die es nicht gibt |
| Datum oder Frist | Mit der Quelle vergleichen; Jahr, Wochentag und Zeitzone prüfen | Falsches Jahr, eine verschobene Frist |
| Zitat | Den genauen Wortlaut im Original finden | Worte, die niemand gesagt hat, oder ein Zitat ohne Zusammenhang |
| Quelle oder Link | Öffnen, die Stelle finden, Urheber und Datum prüfen | Die Quelle existiert nicht oder sagt etwas anderes |
| Zusammenfassung Ihres Texts | Neben das Original legen und Punkt für Punkt durchgehen | Hinzugefügte, weggelassene oder veränderte Details |
Laterales Lesen: eine Quelle von außen beurteilen
Schritt 3 führt Sie oft auf eine Website, die Sie nicht kennen. Wie beurteilen Sie sie schnell? Forschende der Stanford University haben beobachtet, wie professionelle Faktenprüfer, Historiker und Studierende Websites bewerten. Die Faktenprüfer waren am schnellsten und am genauesten. Sie verließen eine unbekannte Seite früh und öffneten neue Tabs, um herauszufinden, was andere über sie sagen. Die Forschenden nannten das laterales Lesen: seitwärts lesen statt nur von oben nach unten. Historiker und Studierende blieben meist auf der Seite und ließen sich oft von einem professionellen Design, einem Logo oder einer langen Liste von Fußnoten täuschen. (Quelle: Wineburg und McGrew, Stanford History Education Group, 2017)
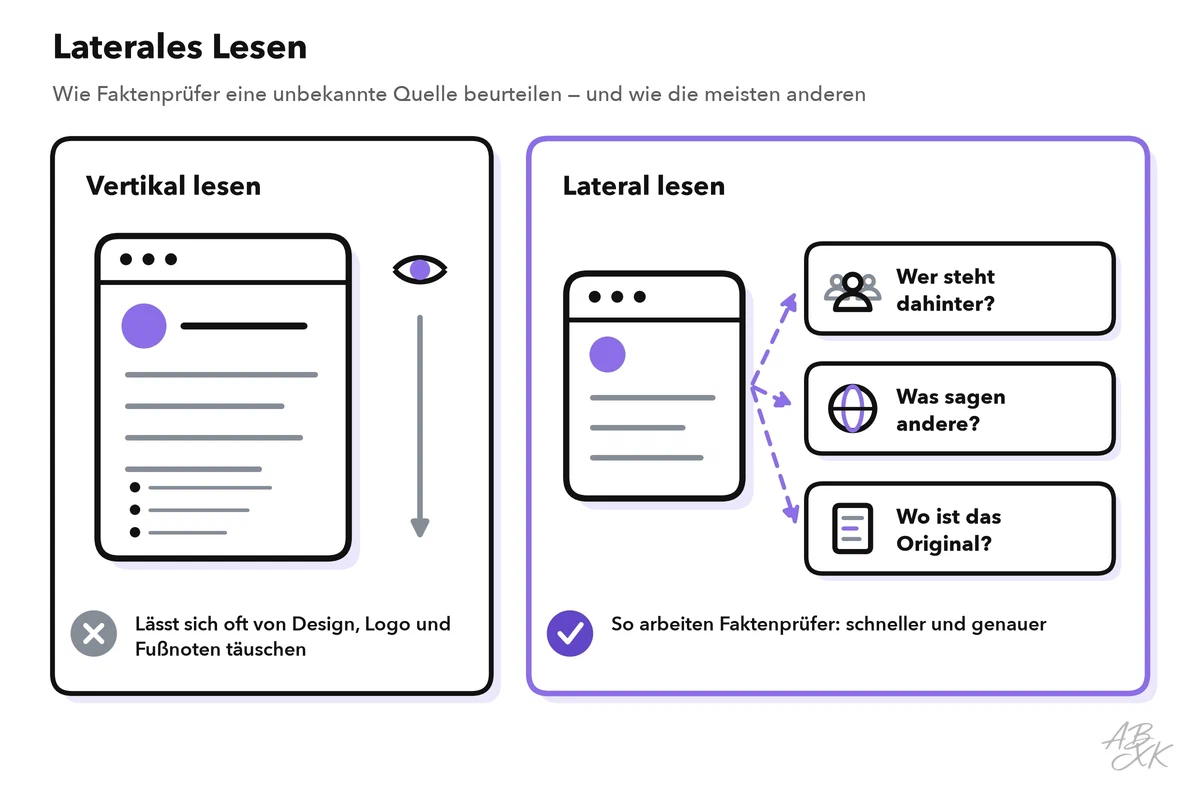
Für eine Aussage aus einer KI-Antwort heißt laterales Lesen, vier Fragen zu stellen:
- Wer steht dahinter? Suchen Sie nach der Organisation oder dem Autor. Ist es ein Forschungsinstitut, eine Behörde, ein Unternehmen, das etwas verkauft, oder ein Interessenverband?
- Was sagen andere? Suchen Sie unabhängige Berichte über dieselbe Aussage. Steht sie nur auf einer einzigen Seite, ist Vorsicht angebracht.
- Woher stammt sie? Verfolgen Sie die Aussage bis zum Original: zur Studie, zur Statistik, zum Gesetz oder zur Pressemitteilung.
- Wann ist sie erschienen? Prüfen Sie das Datum des Originals, nicht das der Seite, die es wiederholt.
KI beim Prüfen helfen lassen — aber nicht entscheiden
KI-Tools können das Prüfen beschleunigen. Ersetzen können sie es nicht, denn die Schwächen, die Fehler verursachen, wirken auch bei der Prüfung. Vier Methoden helfen in der Praxis:
| Methode | Wobei sie hilft | Worauf Sie achten sollten |
|---|---|---|
| Nach der Herkunft jeder Aussage fragen | Zeigt, welche Aussagen nur auf dem Gedächtnis des Modells beruhen | Auch die Herkunftsangaben können falsch sein |
| Fragen, wie sicher das Modell ist | Weist auf Aussagen hin, an denen das Modell selbst zweifelt | Modelle klingen oft sicherer, als sie sind |
| In einem neuen Chat noch einmal fragen | Erfundene Details ändern sich oft von Antwort zu Antwort | Ein Modell kann denselben Fehler jedes Mal wiederholen |
| Ein zweites Modell fragen | Ein frischer Blick findet manche Fakten- und Logikfehler | Modelle können Fehler teilen; Abweichungen selbst prüfen |
Nach der Herkunft fragen. Schicken Sie nach einer wichtigen Antwort: „Liste alle Tatsachenbehauptungen aus der Antwort oben auf. Gib zu jeder an, ob sie aus meinem Text stammt, aus einer benennbaren Quelle oder aus allgemeinem Wissen.“ Die Aussagen aus allgemeinem Wissen prüfen Sie zuerst.
Fragen, wie sicher das Modell ist — und die Antwort nur als Hinweis nehmen. In einer Studie neigten Modelle, die ihre Sicherheit in Worten angaben, zur Selbstüberschätzung. (Quelle: Xiong et al., ICLR 2024, arxiv.org)
Noch einmal fragen, in einem neuen Chat. Erfundene Details sind oft unbeständig. Forschende der University of Oxford haben gezeigt: Gibt ein Modell auf dieselbe Frage Antworten mit unterschiedlicher Bedeutung, ist die Antwort eher erfunden. (Quelle: Farquhar et al., Nature, 2024) Umgekehrt gilt das nicht: Eine Antwort, die gleich bleibt, kann trotzdem falsch sein.
Ein zweites Modell fragen. Kopieren Sie den Entwurf oder die Liste der Aussagen in einen anderen Assistenten, in einen neuen Chat, und lassen Sie jeden Punkt prüfen. Wo sich die beiden widersprechen, prüfen Sie die Quelle selbst. Übereinstimmung ist kein Beweis, denn Modelle lernen aus ähnlichen Texten und können dieselben Fehler machen. Dieselbe Grenze gilt für das Muster Kritik und Überarbeitung aus Teil 1 dieses Levels: Es verbessert die Form, nicht die Fakten.
Bei Rechercheaufgaben beschleunigt ein Tool, das seine Quellen zeigt, die Prüfung. Unser Vergleich führt solche Tools unter Schreiben und Recherche. Laut den Anbietern durchsucht Consensus wissenschaftliche Fachartikel und fasst ihre Ergebnisse zusammen, und Nouswise stützt seine Antworten auf die Quellen, die Sie hochladen. Allgemeine Assistenten wie ChatGPT oder Gemini eignen sich als zweites Modell. Wir führen sie wegen ihrer Bildfunktionen unter Text-to-Image, beide arbeiten aber auch mit Text.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Wann Sie für eine Aufgabe auf KI verzichten
Manchmal zeigt die Prüfung, dass KI das falsche Werkzeug für die Aufgabe ist. Zwei Fragen entscheiden: Was kostet ein Fehler? Und wie viel Aufwand macht es, das Ergebnis zu prüfen?
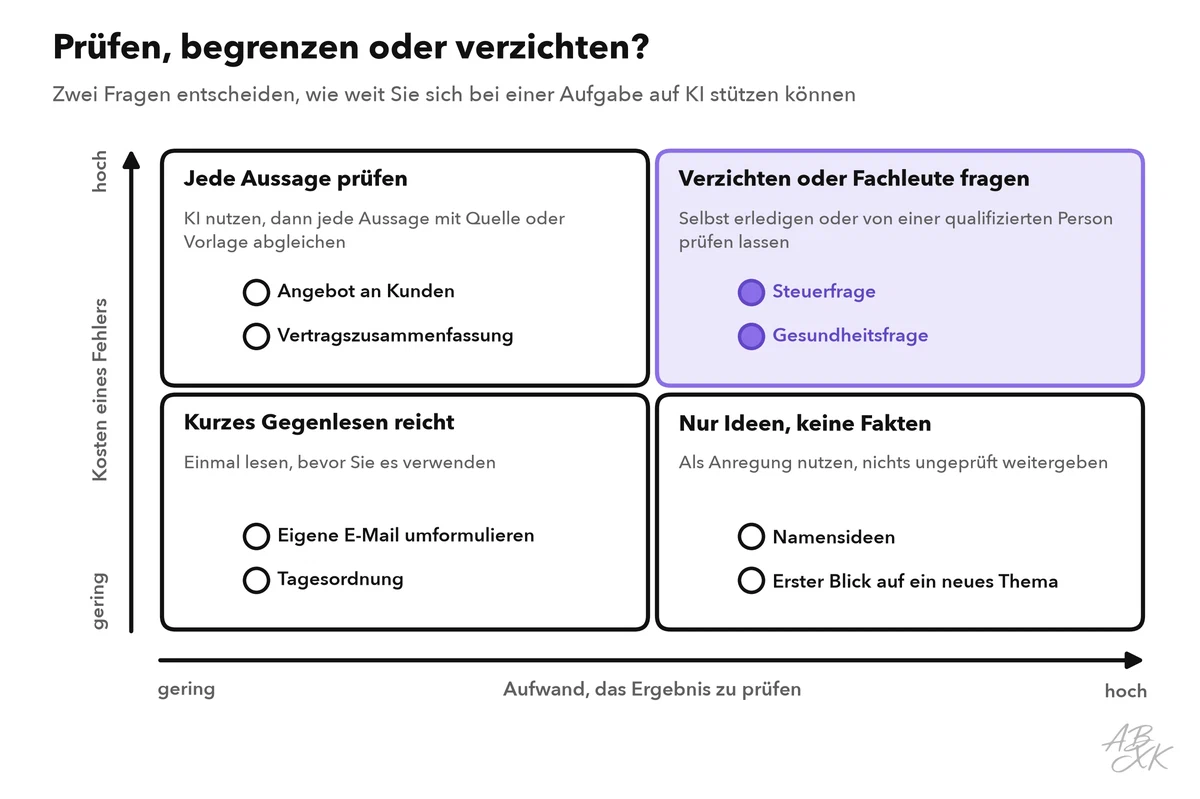
Verzichten Sie bei einer Aufgabe auf KI oder beschränken Sie sie auf kleine Hilfsarbeiten, wenn Sie eines dieser Zeichen sehen:
- Prüfen dauert länger als selbst machen. Wenn Sie fast jeden Satz nachprüfen müssen, schreiben Sie den Text selbst.
- Sie können das Ergebnis nicht beurteilen. Ohne das Wissen oder die Quellen für eine Prüfung können Sie keine Verantwortung dafür übernehmen.
- Derselbe Fehler kommt immer wieder. Nach zwei Korrekturrunden hilft ein besserer Prompt selten. Dem Modell fehlt dann womöglich schlicht das Wissen.
- Dem Tool fehlt, was die Aufgabe braucht. Es hat keinen Zugriff auf aktuelle Daten oder Ihre internen Dokumente, oder die Informationen sind zu vertraulich, um sie zu teilen.
- Es geht um eine folgenreiche Entscheidung. Rechtliche, medizinische, finanzielle oder personelle Entscheidungen gehören in die Hände qualifizierter Menschen. KI kann helfen, sie vorzubereiten, sollte sie aber nicht treffen.