

Ein Produktvideo braucht eine Sprecherstimme und etwas Musik darunter. KI-Tools erledigen beides in Minuten: Ein Text-to-Speech-Tool (TTS, Sprachausgabe) liest Ihr Skript vor, und ein Musikgenerator schreibt aus einem einzigen Satz ein Musikstück. Die eigentliche Arbeit steckt in den Details — etwa in einem Namen, den die Stimme falsch ausspricht, oder in Musik, die den Sprecher übertönt.
Dies ist Teil 4 von Level 3 unseres Lernpfads AI Productivity. In Level 2 haben Sie Aufnahmen über das Transkript bearbeitet und kleine Versprecher mit einer KI-Stimme korrigiert. Hier produzieren Sie den Ton selbst. Sie wählen eine Stimme, steuern Aussprache und Tempo und beschreiben Musik per Prompt. Dann mischen Sie Stimme und Musik, klären die Rechte und kennzeichnen das Ergebnis.
Erst die Stimme, dann die Musik: der Produktionsablauf
Ton für Inhalte entsteht auf zwei Spuren, die sich in der Mischung treffen. Die Sprachspur beginnt mit einem Skript, die Musikspur mit einer kurzen Vorgabe. Erzeugen Sie zuerst die Stimme: Sie trägt die Botschaft und gibt das Timing vor. Die Musik folgt dann ihrer Länge und ihren Pausen — so wie die Bilder in Teil 3 dieses Levels, vom Skript zum Clip.
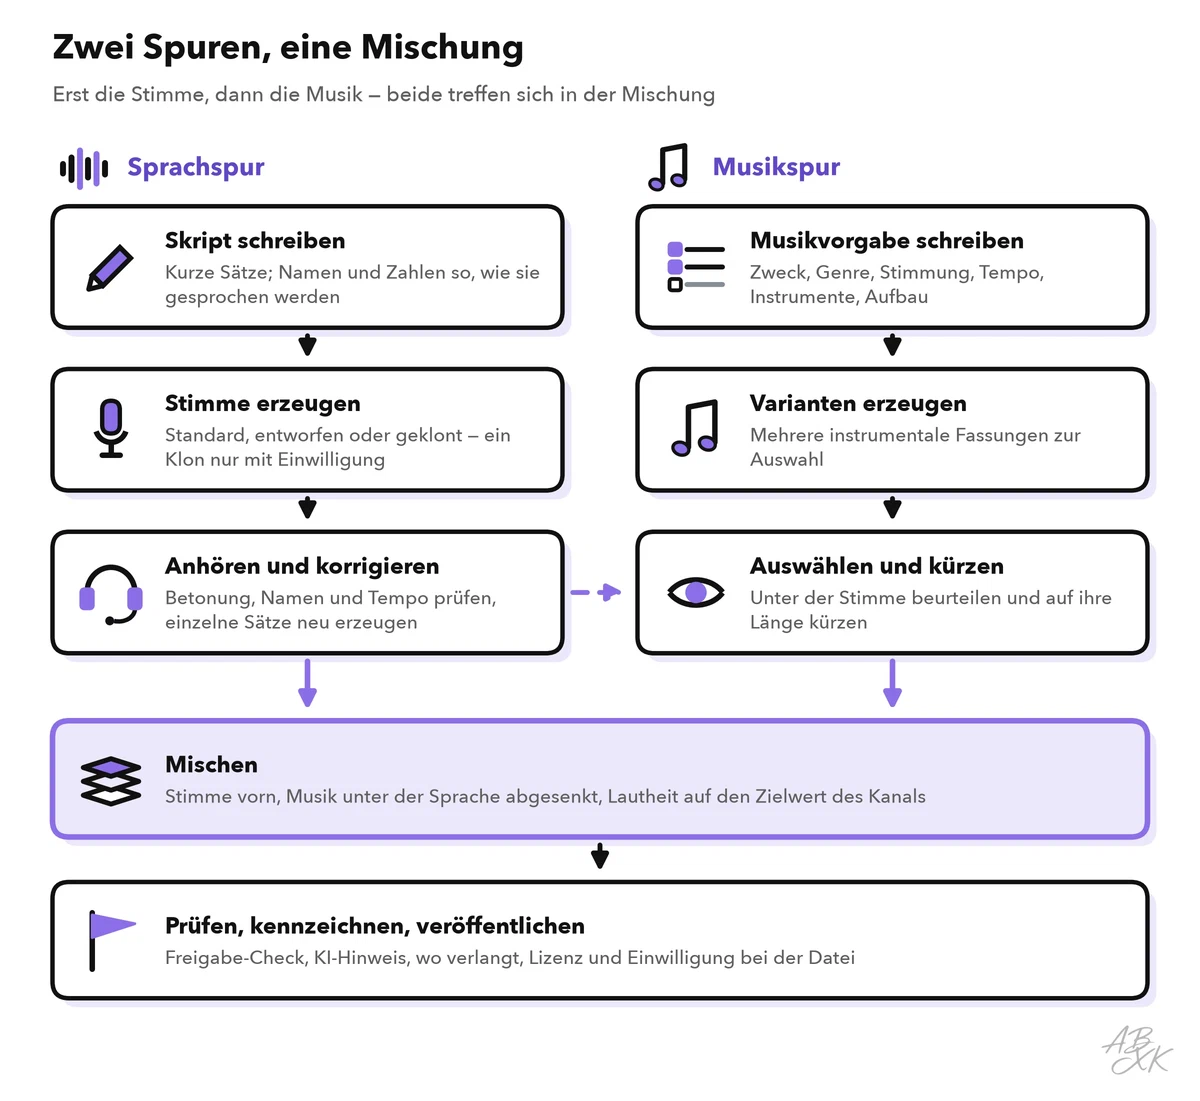
Bei jedem Schritt erzeugt die KI, und Sie urteilen. Planen Sie mehrere Durchgänge ein. Speichern Sie Prompt und Einstellungen jeder Fassung, die Sie behalten, damit spätere Versionen genauso klingen.
KI-Stimmen eignen sich für Erklärvideos, Schulungen, Produkt-Updates und Audiofassungen von Artikeln. Nehmen Sie einen echten Menschen auf, wenn es auf dessen eigene Stimme ankommt — bei persönlichen Botschaften, Kundengeschichten oder Entschuldigungen.
Standard, entworfen oder geklont: drei Wege zu einer Stimme
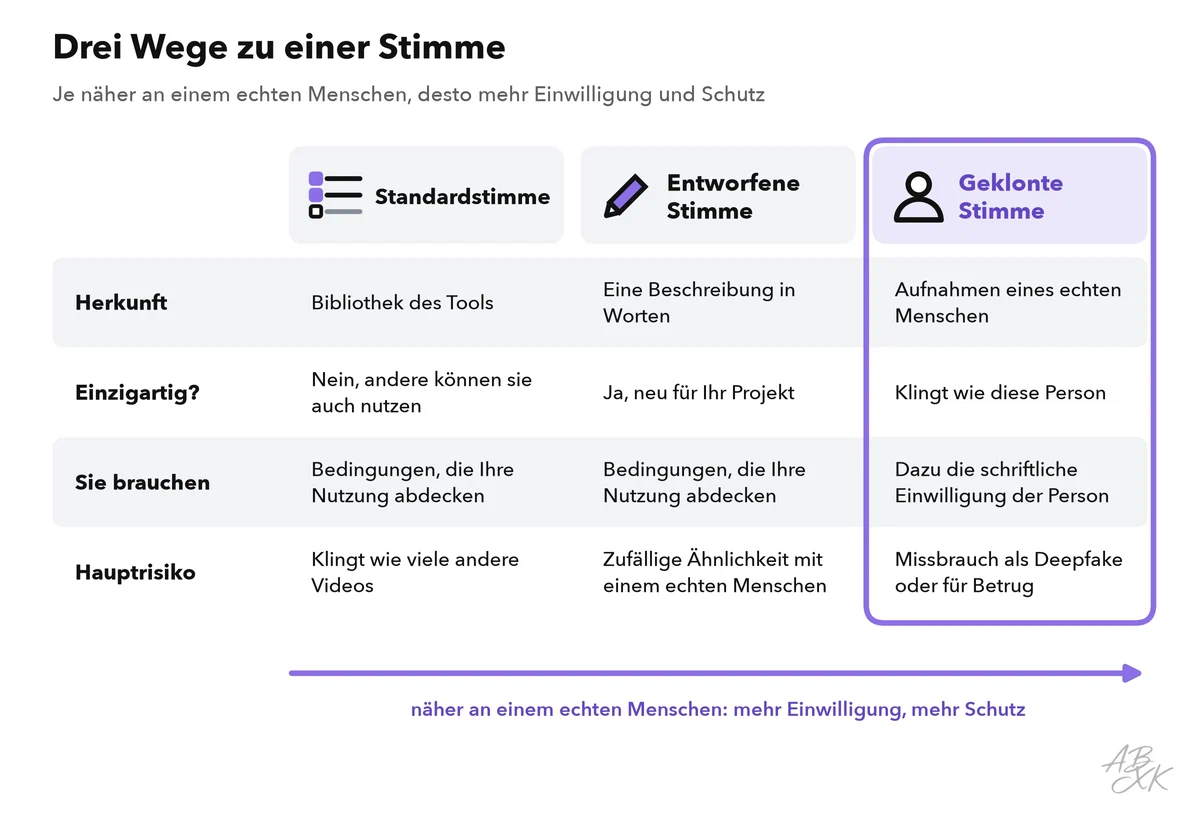
Moderne Sprachausgabe sagt nicht nur die Laute der Wörter voraus, sondern auch die Prosodie: Melodie, Rhythmus und Betonung der Sprache. Deshalb klingen KI-Stimmen natürlich — und deshalb betonen sie hin und wieder trotzdem das falsche Wort. Zu einer Stimme kommen Sie auf drei Wegen:
- Standardstimme. Sie wählen eine fertige Stimme aus der Bibliothek des Tools. Das ist der schnellste Start, aber auch andere Kunden können dieselbe Stimme nutzen.
- Entworfene Stimme. Sie beschreiben die gewünschte Stimme in Worten, und das Tool erzeugt eine neue. Laut Anbieter arbeitet Humes Modell Octave so. Das Ergebnis darf keinen echten Menschen nachahmen.
- Geklonte Stimme. Ein Stimmklon ist eine synthetische Kopie der Stimme eines echten Menschen, erzeugt aus Aufnahmen dieser Person. Er kann alles sagen, mit einer Stimme, der das Publikum vertraut: die nützlichste Option und die riskanteste.
Level 2 hat die Grundregel für Klone gesetzt: ohne Einwilligung kein Klon. Für die regelmäßige Produktion sollte die Einwilligung konkret sein. Die Stimme gehört zur Identität eines Menschen, und in vielen Ländern schützt das Recht sie. Die schriftliche Einwilligung sollte festhalten:
- den Zweck und die Arten von Inhalten, etwa Produktvideos, aber keine Werbung,
- die Sprachen und Kanäle,
- wer den Klon nutzen darf und wie lange,
- dass der Klon am Ende gelöscht wird und wie die Person ihre Einwilligung widerrufen kann.
Dasselbe gilt für Ihre eigene Stimme: Wer Ihren Klon nutzen kann, kann Sie alles sagen lassen.
Laut den Anbietern bietet ElevenLabs Sprachausgabe, Stimmklone und Synchronisation. Murf AI erzeugt Sprecherstimmen und synchronisiert Videos, und Speechify liest Dokumente vor. Unser Vergleich führt 13 Text-to-Voice-Tools, und unser ABXK-Ranking der Text-to-Voice-Generatoren zeigt, welche davon gerade vorn liegen. Testen Sie einen Absatz Ihres eigenen Skripts, mit Ihren Produktnamen, in zwei oder drei davon.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Aussprache und Tempo: fürs Ohr schreiben
Viele Probleme mit KI-Sprecherstimmen beginnen im Skript. Ein Sprachausgabe-Modell muss raten, wie es alles ausspricht, was kein einfaches Wort ist. Typische Stolperstellen sind Namen, Abkürzungen, Zahlen, Datumsangaben und Einheiten. Schwierig sind auch englische Wörter im deutschen Text und Wörter mit zwei Aussprachen, etwa „modern“ in „modernes Design“ und in „Das Laub beginnt zu modern“.
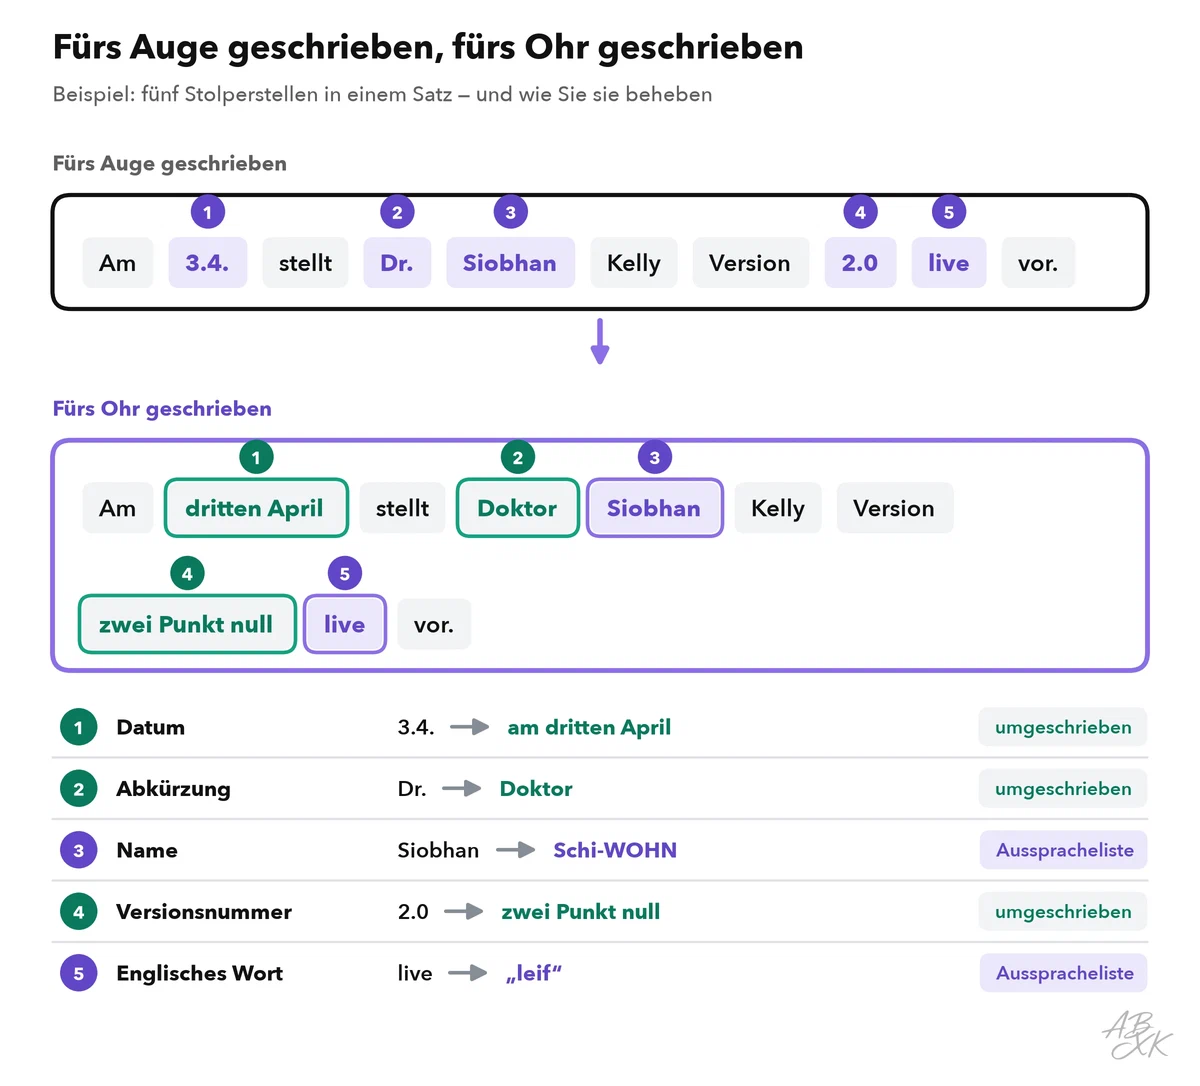
Sie können diese Stellen auf vier Wegen beheben, von einfach bis technisch:
- Fürs Sprechen umschreiben. Schreiben Sie Datum, Abkürzungen und Zahlen so, wie sie klingen sollen: „am dritten April“, „Doktor“, „zwei Punkt null“.
- Die Regler des Tools nutzen. Je nach Tool können Sie Pausen einfügen, das Tempo ändern, ein Wort betonen oder einen einzelnen Satz neu erzeugen.
- Eine Ausspracheliste führen. Notieren Sie jeden Namen und Fachbegriff einmal mit seiner gesprochenen Form. Manche Tools speichern eine solche Liste als Aussprachewörterbuch und nutzen sie projektübergreifend, sodass Sie einen Namen nur einmal korrigieren.
- SSML nutzen, wo es unterstützt wird. Die Speech Synthesis Markup Language (SSML) ist ein W3C-Standard, mit dem Sie Text für die Sprachausgabe auszeichnen: Pausen, wie eine Zahl gelesen wird, die genaue Aussprache eines Wortes (Quelle: W3C, Speech Synthesis Markup Language 1.1, w3.org). Cloud-Dienste wie Amazon Polly und Google Cloud Text-to-Speech verstehen SSML. Das hilft, wenn Sie Audio automatisch erzeugen.
So könnte die Ausspracheliste eines Produktteams beginnen:
| Geschrieben | Gesprochen | Warum ein Eintrag nötig ist |
|---|---|---|
| Siobhan | Schi-WOHN | Irischer Name; die Schreibung verrät den Klang nicht |
| live | leif | Englisches Wort; die Stimme liest es sonst womöglich deutsch |
| am 3.4. | am dritten April | Datum oder Zahl? Und Datumsformate unterscheiden sich je nach Land |
| 2.0 | zwei Punkt null | Versionsnummern: einmal festlegen, überall gleich sprechen |
| SQL | S-Q-L oder „Sequel“ | Teams sprechen es unterschiedlich; eine Form wählen |
| modern (verrotten) | MO-dern | Gleiche Schreibung, zwei Aussprachen |
Das Tempo ist die andere Hälfte. Wer zuhört, kann einen Satz nicht zweimal lesen. Schreiben Sie deshalb kurze Sätze mit je einem Gedanken. Die meisten Stimmen machen nach einem Punkt eine längere Pause als nach einem Komma, also setzen die Satzzeichen die Pausen. Messen Sie das Tempo Ihrer Stimme einmal: Zählen Sie die Wörter eines Testabsatzes und teilen Sie durch seine Länge in Minuten. Dann planen Sie Skripte für eine feste Länge. Ein Beispiel mit einem angenommenen Tempo von 150 Wörtern pro Minute: Ein 60-Sekunden-Video mit je vier Sekunden Musik am Anfang und am Ende lässt 52 Sekunden, also etwa 130 Wörter.
Musik nach Genre, Stimmung und Aufbau beschreiben
Musikgeneratoren gibt es in zwei Arten. Song-Generatoren schreiben vollständige Songs mit Gesang. Laut den Anbietern erzeugt Suno Songs aus einer Texteingabe, und Udio lässt sie Abschnitt für Abschnitt bearbeiten. Tools für Produktionsmusik erzeugen instrumentale Stücke für Videos, Podcasts und Werbung. AIVA etwa komponiert orchestrale Musik und exportiert MIDI: die Noten statt des Klangs, sodass Sie die Instrumente später ändern können.
Unter einer Sprecherstimme brauchen Sie meist instrumentale Musik, denn gesungene Wörter konkurrieren mit gesprochenen. Ein guter Musik-Prompt sagt zuerst, wofür das Stück gedacht ist, und beschreibt dann den Klang. Das Tempo geben Sie in BPM an, in Schlägen pro Minute (beats per minute).
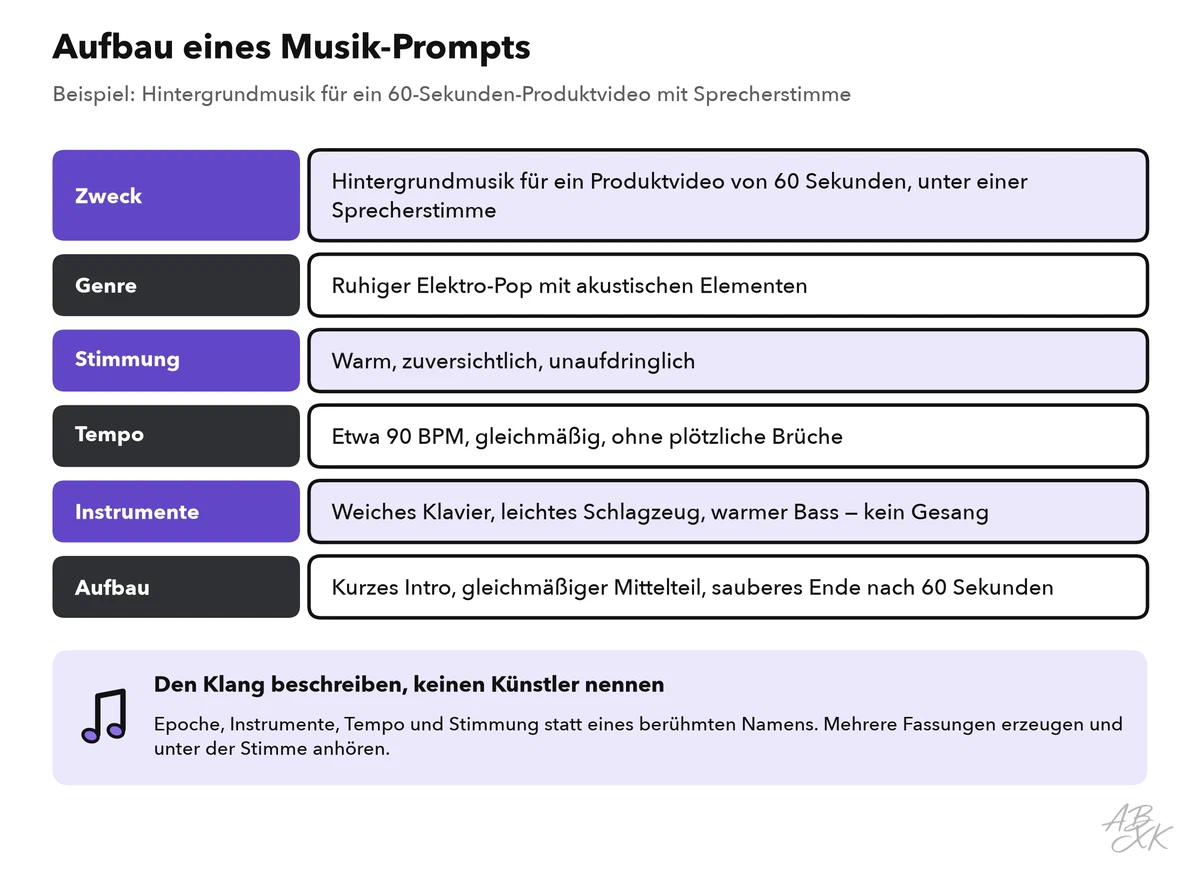
Vier Gewohnheiten verbessern die Ergebnisse:
- Den Klang beschreiben, keinen Künstler nennen. Nennen Sie Epoche, Instrumente, Tempo und Stimmung statt eines berühmten Musikers. Einen bekannten Künstler nachzuahmen, wirft rechtliche und ethische Fragen auf.
- Den Aufbau vorgeben. „Kurzes Intro, gleichmäßiger Mittelteil, sauberes Ende“ lässt der Stimme Raum. Manche Song-Tools nehmen eigene Songtexte mit Abschnittsmarken wie [Verse] und [Chorus] an. Diese Marken sind Hinweise, und das Modell folgt ihnen nicht immer.
- Mehrere Fassungen erzeugen und unter der Stimme beurteilen. Ein Stück, das für sich großartig klingt, kann unter Sprache zu unruhig sein.
- Anfang und Ende prüfen. Erzeugte Stücke können abrupt aufhören oder an einer seltsamen Stelle ausblenden. Kürzen Sie sie in Ihrem Editor und blenden Sie sie aus.
Unser Vergleich führt 12 Text-to-Music-Tools, und unser ABXK-Ranking der Text-to-Music-Generatoren zeigt, welche davon gerade vorn liegen.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Stimme und Musik so mischen, dass jedes Wort klar bleibt
In der Mischung führt die Stimme, und die Musik stützt sie. Vier Techniken erledigen den Großteil der Arbeit:
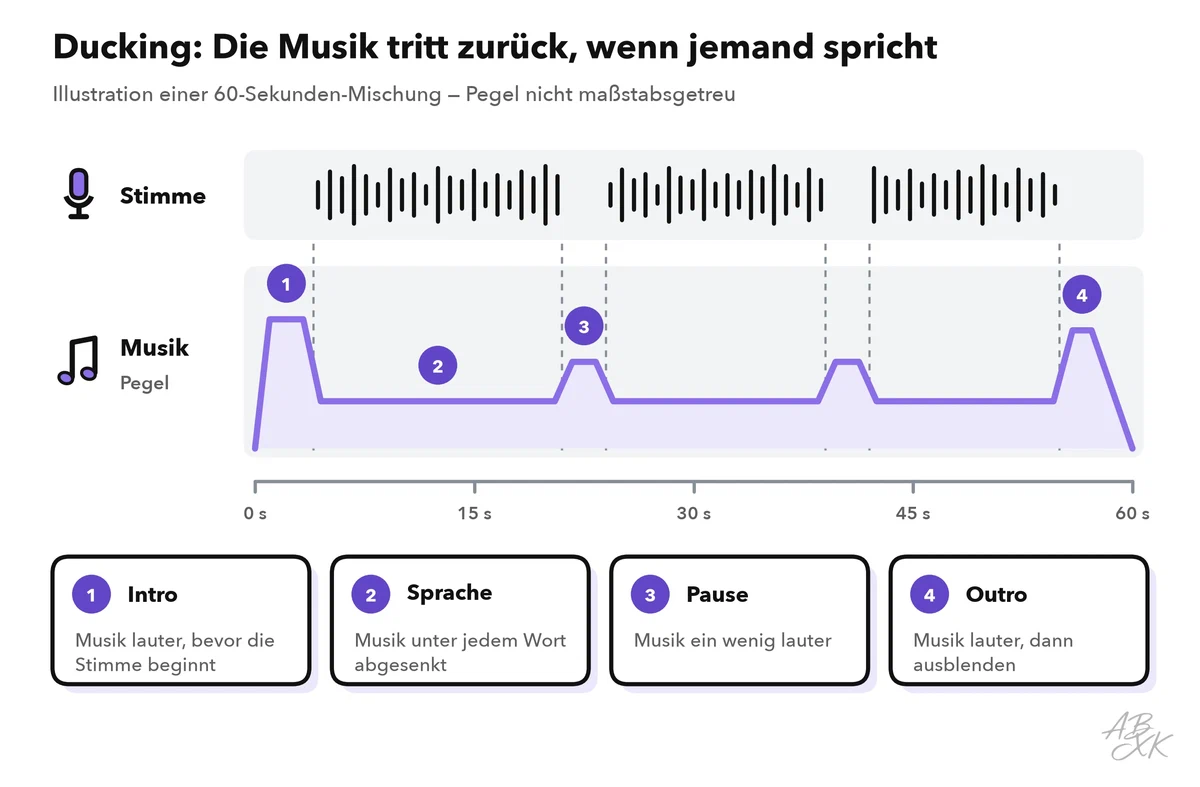
- Ducking. Senken Sie die Musik ab, während jemand spricht, und heben Sie sie in längeren Pausen etwas an. Manche Editoren erledigen das automatisch, oft unter dem Namen Auto-Ducking. Die Musik soll sanft zurücktreten, nicht springen.
- Platz für die Stimme. Vermeiden Sie unter Sprache Musik mit Gesang oder einer unruhigen Melodie. Überdeckt ein Stück die Stimme trotzdem, probieren Sie eine ruhigere Fassung.
- Intro und Outro. Lassen Sie die Musik kurz vor der Stimme beginnen und mit einer Blende enden, nicht mit einem harten Schnitt.
- Lautheit. Plattformen gleichen die Wiedergabe an eine Ziel-Lautheit an. Sie wird in LUFS gemessen (Loudness Units relative to Full Scale), einem Maß dafür, wie laut Audio für Menschen klingt. Spotify nutzt −14 LUFS als Referenzwert für Musik (Quelle: Spotify for Artists, „Loudness normalization“, support.spotify.com). Für Podcasts empfiehlt Apple etwa −16 LKFS, dasselbe Maß unter anderem Namen (Quelle: Apple Podcasts for Creators, „Audio requirements“, podcasters.apple.com).
Hören Sie die Mischung dann auf den Geräten Ihres Publikums an: Smartphone-Lautsprecher, Ohrhörer und Laptop. Eine Mischung, die auf Studiokopfhörern funktioniert, kann die Stimme auf dem Smartphone verschlucken.
Rechte, Lizenzen und Kennzeichnung
Bevor Sie KI-Audio veröffentlichen, klären Sie drei Dinge: die Bedingungen des Tools, die Menschen und das Material darin und das Urheberrecht.
Die Bedingungen unterscheiden sich je nach Tool und oft je nach Tarif, etwa bei der kommerziellen Nutzung. Lesen Sie sie vor der Veröffentlichung und speichern Sie eine Kopie mit Datum. Lizenzfrei (royalty-free) heißt, dass Sie keine Gebühr pro Nutzung oder pro Abspielen zahlen; die Lizenz legt aber weiterhin fest, wo Sie ein Stück verwenden dürfen. Und wie Teil 3 dieses Levels gezeigt hat, machen Prompts allein Sie in den USA nicht zum Urheber eines erzeugten Ergebnisses (Quelle: U.S. Copyright Office, Copyright and Artificial Intelligence, Part 2: Copyrightability, 2025, copyright.gov). Ein Stück, das nur aus einem Prompt entstanden ist, dürfen Sie vielleicht nutzen, aber nicht unbedingt schützen.
| Frage | Warum sie zählt | Wo Sie die Antwort finden |
|---|---|---|
| Erlaubt mein Tarif die kommerzielle Nutzung? | Die Rechte hängen oft vom Tarif ab | Bedingungen und Tarifseite des Tools |
| Deckt die Lizenz meinen Kanal ab? | Bezahlte Werbung, Rundfunk oder Weiterverkauf brauchen eventuell mehr | Lizenzbedingungen |
| Steckt die Stimme eines echten Menschen darin? | Ein Klon braucht die schriftliche Einwilligung dieser Person | Ihre Einwilligungsunterlagen |
| Habe ich fremdes Material hochgeladen? | Ein Referenzsong oder eine Aufnahme braucht Ihre Rechte daran | Ihre eigenen Unterlagen |
| Kann ich all das später belegen? | Plattformen und Kunden fragen womöglich nach | Ein Protokoll mit Tool, Tarif, Datum, Prompt und Datei |
Halten Sie bei jeder Datei Tool, Tarif, Datum und Prompt fest. Der Level-4-Teil zur multimodalen Content-Pipeline zeigt ein vollständiges Asset-Protokoll.
Kennzeichnung. Wer zuhört, soll eine synthetische Stimme nicht für einen echten Menschen halten. YouTube verlangt von Creators, realistische veränderte oder synthetische Inhalte offenzulegen. Eines der Beispiele ist die synthetisch erzeugte Stimme einer Person, die ein Video spricht (Quelle: YouTube, „How we’re helping creators disclose altered or synthetic content“, 2024, blog.youtube). In der EU gelten die Transparenzpflichten der KI-Verordnung (AI Act) für Deepfakes auch für Audio (Artikel 50). Setzen Sie den Hinweis in die Beschreibung oder die Shownotes, oder sprechen Sie ihn zu Beginn. Zum Beispiel: „Sprecherstimme: KI-generiert. Musik: KI-generiert.“ Bei einem Klon ergänzen Sie die Einwilligung: „Stimme: KI-Klon der Stimme von Maria Lopez, mit ihrer Einwilligung.“
Freigabe-Check für KI-Audio
Gehen Sie diesen Check vor jeder Veröffentlichung durch. Er findet die Fehler, die sich nach der Veröffentlichung am schwersten beheben lassen.
| Prüfpunkt | Frage |
|---|---|
| Skript | Werden alle Namen, Zahlen und Daten richtig gesprochen? |
| Stimme | Liegt die Betonung auf den richtigen Wörtern, und kann man dem Tempo gut folgen? |
| Einwilligung | Bei einem Klon: Liegt die schriftliche Einwilligung vor, und deckt sie diese Nutzung ab? |
| Musik | Passt das Stück unter die Stimme, und deckt seine Lizenz diesen Kanal ab? |
| Mischung | Ist jedes Wort auf einem Smartphone-Lautsprecher klar, mit der Musik unter der Stimme? |
| Lautheit | Erreicht die ganze Datei den Zielwert Ihres wichtigsten Kanals? |
| Kennzeichnung | Ist die KI-Stimme oder KI-Musik gekennzeichnet, wo Plattform oder Gesetz es verlangen? |
| Protokoll | Sind Tool, Tarif, Datum, Prompt und Einstellungen bei der Datei gespeichert? |