
KI-Entwicklung ist teuer. Rechenleistung, Datenverarbeitung und Entwicklungszeit lassen Budgets schnell aus dem Ruder laufen. Wir haben Projekte gesehen, in denen Teams mehr für gescheiterte Experimente ausgegeben haben als für die Lösung, die am Ende funktionierte.
Bei ABXK.AI bauen wir KI-Systeme für Forschung und Produktion. Mit der Zeit haben wir gelernt: Kosten senken heißt nicht, Abkürzungen zu nehmen, sondern klüger zu arbeiten. Das teuerste KI-Projekt ist nicht das mit der höchsten Cloud-Rechnung, sondern das, das Monate mit Ansätzen verschwendet, die nicht funktionieren. Es geht nicht darum, weniger auszugeben, sondern mehr Ergebnis pro eingesetztem Euro zu erzielen.
So halten wir die Kosten niedrig, ohne an Qualität zu verlieren.
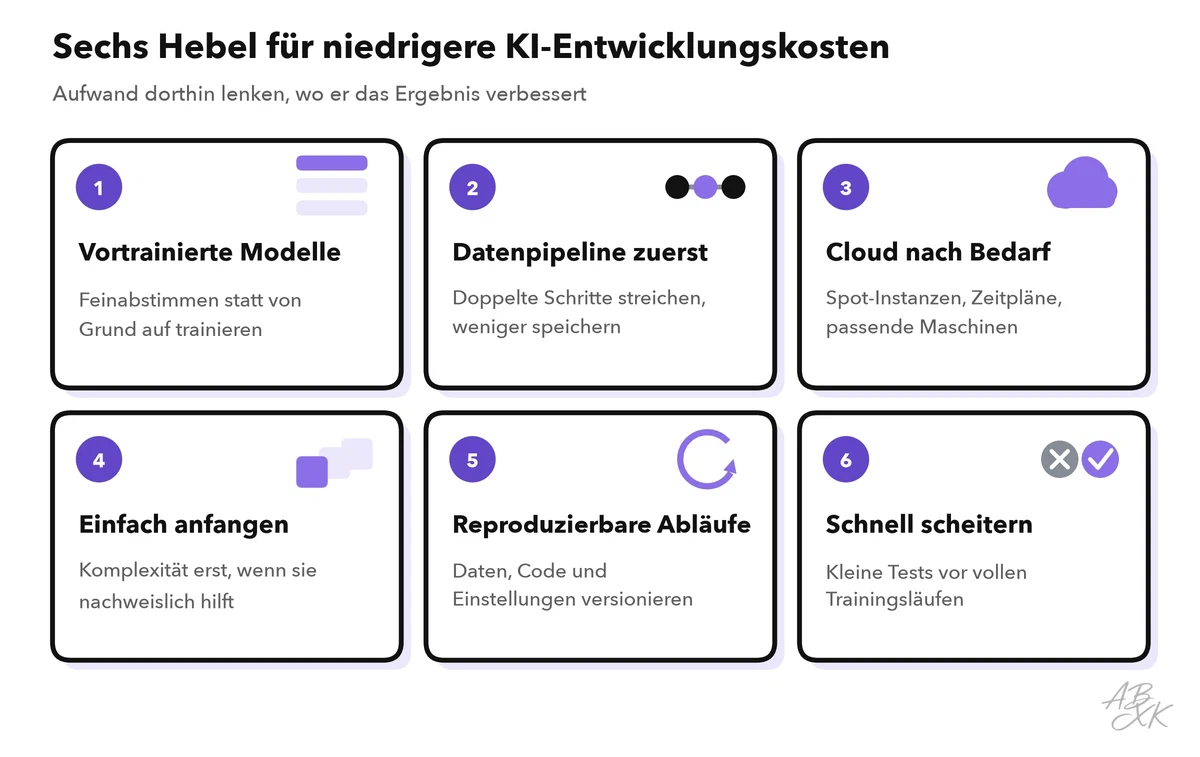
Sechs Hebel, um KI-Entwicklungskosten zu senken und die Qualität zu halten.
Mit vortrainierten Modellen beginnen
Ein Modell von Grund auf zu trainieren, ist selten nötig. Vortrainierte Modelle wie GPT, BERT oder offene Bildverarbeitungsmodelle enthalten bereits Wissen aus Rechenleistung im Wert von Millionen. Für den eigenen Anwendungsfall lassen sie sich mit deutlich weniger Geld feinjustieren.
Statt vom ersten Tag an mit riesigen Datensätzen zu trainieren, nehmen Sie ein bestehendes Modell und passen es an Ihren Bedarf an. Fine-Tuning braucht weniger Daten und weniger Rechenzeit und liefert viel schneller brauchbare Ergebnisse.
Wir haben Teams gesehen, die wochenlang eigene Modelle trainiert haben, obwohl eine feinjustierte Variante genauso gut funktioniert hätte. Der Kostenunterschied kann das Zehnfache und mehr betragen, vor allem wenn man die Arbeitszeit der Entwickler mitrechnet.
Vortrainierte Modelle passen allerdings nicht für jede Aufgabe. Ist Ihr Fachgebiet sehr speziell oder unterscheiden sich Ihre Daten stark von den Trainingsdaten des Modells, brauchen Sie womöglich mehr Anpassung. Testen Sie das früh.
Zuerst die Datenpipeline optimieren
Schlechte Datenpipelines kosten Geld, oft unbemerkt. Langsame Verarbeitung verlängert die Experimentzyklen. Schlechte Datenqualität führt zu verschwendeten Trainingsläufen. Überflüssiger Speicher treibt die Cloud-Rechnung.
Prüfen Sie zunächst den Datenfluss von der Quelle bis zum Modell. Suchen Sie nach langsamen Stellen, doppelter Verarbeitung und Daten, die Sie speichern, aber nie nutzen. Räumen Sie die Pipeline auf, bevor Sie mehr Rechenleistung dazubuchen.
Einmal haben wir die Kosten der Datenverarbeitung eines Kunden um 40 % gesenkt, nur indem wir doppelte Transformationen entfernt und Zwischendateien komprimiert haben. Keine Änderung am Modell, keine Änderung an den Ergebnissen — nur eine sauberere Infrastruktur.
Vermeiden Sie dabei vorzeitige Optimierung. Bringen Sie erst eine funktionierende Pipeline zum Laufen und messen Sie dann, wo die echten Engpässe liegen. Wer das Falsche optimiert, verschwendet Zeit.
Cloud-Ressourcen gezielt einsetzen
Cloud-Computing macht KI zugänglich, aber auch das Geldausgeben leicht. Leistungsstarke Rechner, die rund um die Uhr laufen, zu groß dimensionierte Maschinen oder vergessene Ressourcen verbrennen schnell Budget.
Richten Sie die Rechenleistung nach dem tatsächlichen Bedarf aus. Nutzen Sie Spot-Instanzen (günstigere Server, die jederzeit gestoppt werden können) für Trainingsjobs, die Unterbrechungen verkraften. Fahren Sie in ruhigen Phasen herunter. Wählen Sie die passenden Maschinentypen — manchmal reicht eine CPU.
Wir haben Teams gesehen, die teure GPU-Rechner rund um die Uhr laufen ließen, obwohl ihre Trainingsjobs nur wenige Stunden am Tag brauchten. Eine einfache Zeitplanung kann die Rechenkosten um 50 % und mehr senken.
Spot-Instanzen sind günstig, können aber unterbrochen werden. Bauen Sie Ihre Trainingsjobs so, dass sie regelmäßig Zwischenstände speichern und keine Arbeit verloren geht. Behalten Sie außerdem die Kosten für Datenübertragung im Blick — sie summieren sich, wenn große Datensätze bewegt werden.
Am Anfang nicht überentwickeln
Es ist verlockend, von Beginn an komplexe Systeme zu bauen: Architekturen aus mehreren Modellen, eigene Trainings-Frameworks, aufwendige Systeme zur KI-Verwaltung. Das klingt beeindruckend. Doch Komplexität kostet Geld, und zu Projektbeginn wissen Sie noch nicht, was Sie wirklich brauchen.
Starten Sie einfach. Nutzen Sie einfache Modelle und eine schlichte Infrastruktur. Erhöhen Sie die Komplexität erst, wenn belegt ist, dass sie die Ergebnisse verbessert. Jede zusätzliche Ebene kostet Entwicklungszeit, Wartung und bringt neue Fehlerquellen.
Einige unserer erfolgreichsten Experimente beruhten auf überraschend einfachen Ansätzen. Eine gut eingestellte logistische Regression kann ein komplexes neuronales Netz schlagen, wenn das Problem diese Leistungsfähigkeit gar nicht braucht.
Einfach ist nicht dasselbe wie schlampig. Einfach heißt, die passende Komplexität für das Problem zu wählen. Schlampig heißt, Validierung und Tests zu überspringen. Halten Sie die Ansprüche hoch, auch wenn der Ansatz einfach ist.
In reproduzierbare Abläufe investieren
Sind Experimente nicht reproduzierbar, verschwenden Sie Zeit mit wiederholten Tests, der Suche nach abweichenden Ergebnissen und Zweifeln an den eigenen Befunden. Reproduzierbarkeit ist nicht nur gute Wissenschaft, sie spart vor allem Zeit.
Versionieren Sie Daten, Code und Einstellungen. Nutzen Sie Werkzeuge, die Experimente automatisch protokollieren. Machen Sie es leicht, jedes Ergebnis zu jedem Zeitpunkt der Projektgeschichte nachzustellen.
Wir haben Projekte erlebt, in denen Teams ihre eigenen besten Ergebnisse nicht wiederholen konnten, weil niemand mehr wusste, mit welcher Datenversion und welchen Einstellungen sie entstanden waren. Wochen an Experimenten mussten neu laufen. Ordentliches Tracking verhindert das vollständig.
Machen Sie das Tracking nicht zu kompliziert. Beginnen Sie mit einfacher Versionsverwaltung und Experiment-Logs. Fortgeschrittene Werkzeuge lohnen sich erst, wenn das Projekt sie braucht.
Schnell scheitern, günstig lernen
Der größte Kostenfaktor in der KI-Entwicklung ist nicht die Rechenleistung, sondern Zeit für Ansätze, die nicht funktionieren. Je schneller Sie Sackgassen erkennen, desto weniger geben Sie dafür aus.
Testen Sie im kleinen Maßstab, bevor Sie sich auf vollständige Trainingsläufe festlegen. Prüfen Sie Annahmen mit schnellen Experimenten. Legen Sie vorab klare Erfolgskriterien fest, damit Sie wissen, wann Sie aufhören.
Bei ABXK.AI bauen wir Prototypen gezielt, um zu prüfen, ob sich eine Idee lohnt. Zeigt ein schnelles Experiment kein Signal, machen wir weiter, ohne in eine vollständige Umsetzung zu investieren. Allein diese Gewohnheit hat uns mehr Geld gespart als jede Optimierung der Infrastruktur.
„Schnell scheitern“ heißt nicht „schnell aufgeben“. Manche Ideen brauchen Feinschliff, bevor sie Ergebnisse zeigen. Es geht darum, Ideen, die noch Iteration brauchen, von solchen zu unterscheiden, die grundsätzlich nicht tragen.
Entdecken Sie unsere Tools oder lesen Sie, wie wir mit VibeCoding Experimente schneller umsetzen.