

Chat-Apps sind der einfachste Weg, ein großes Sprachmodell zu nutzen. Sobald KI aber in Ihrer eigenen Software arbeiten soll — in einem Support-Formular, einem Berichtsgenerator oder einem kleinen internen Tool —, muss Ihr Programm direkt mit dem Modell sprechen: über seine API (Application Programming Interface, eine Programmierschnittstelle). Ihr Code schickt eine Anfrage, und die Antwort kommt als Daten zurück, mit denen Ihr Programm weiterarbeiten kann.
Dies ist Teil 1 von Level 1 unseres Lernpfads AI Development. Sie legen einen API-Schlüssel an, speichern ihn sicher, senden eine erste Anfrage mit Python, lesen die Antwort und behandeln Fehler. Wenn Tokens und Kontextfenster für Sie neu sind, lesen Sie zuerst APIs, Tokens und Kontextfenster erklärt aus Level 0.
Was bei einem API-Aufruf passiert
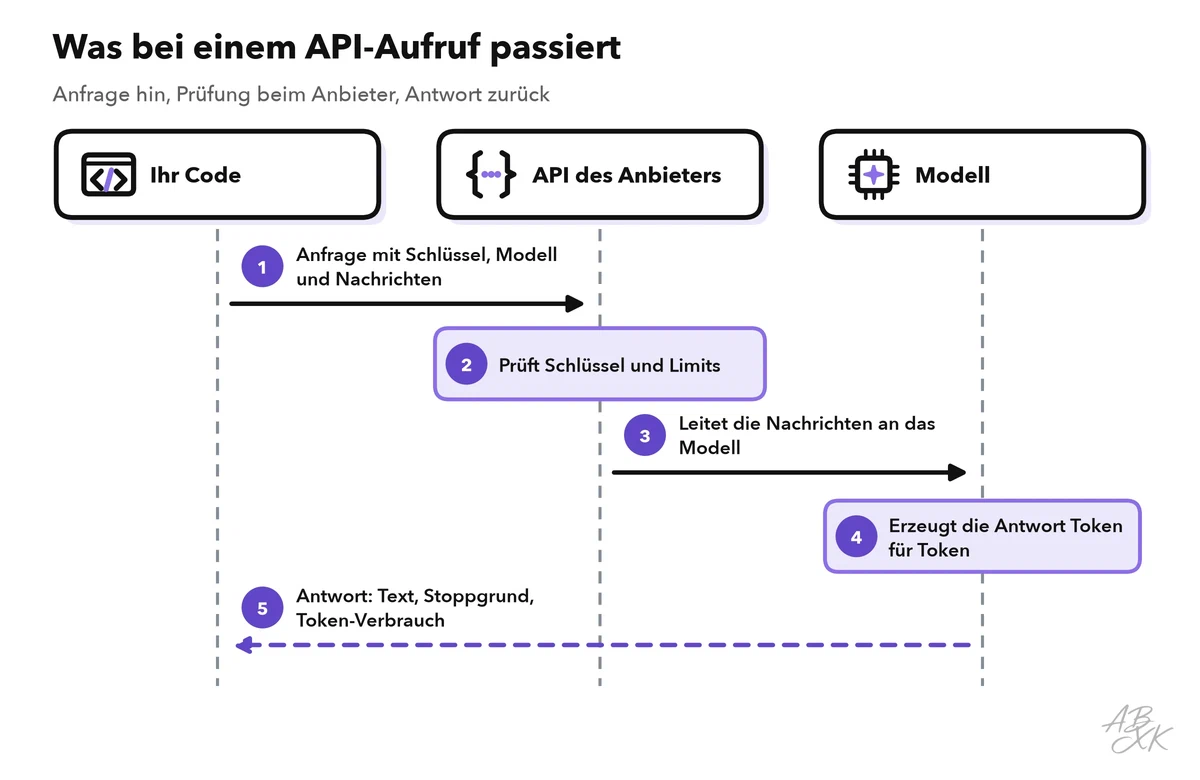
Ein API-Aufruf ist ein kurzer Austausch zwischen zwei Programmen über das Internet. Ihr Programm schickt eine Anfrage (Request) an eine feste Webadresse, den Endpunkt (Endpoint). Der Server des Anbieters prüft Ihren Schlüssel und Ihre Limits, gibt Ihre Nachrichten an das Modell weiter und sendet eine Antwort (Response) zurück. Anfrage und Antwort sind in JSON geschrieben, einem einfachen Textformat aus Namen und Werten, das fast jede Programmiersprache lesen kann.
Bei einer typischen Chat-API erinnert sich das Modell nicht an frühere Aufrufe. Jede Anfrage muss alles enthalten, was das Modell braucht: die Anweisungen, die Frage und in einem Gespräch die früheren Nachrichten, auf die es ankommt. Das klingt nach Mehrarbeit, macht Ihre App aber berechenbar: Das Modell sieht genau das, was Sie schicken.
Schritt 1: API-Schlüssel anlegen und aus dem Code heraushalten
Ein API-Schlüssel (API Key) ist eine lange geheime Zeichenfolge, die Sie gegenüber dem Anbieter ausweist. Jede Anfrage mit Ihrem Schlüssel wird Ihrem Konto berechnet — behandeln Sie ihn wie ein Passwort.
- Öffnen Sie die Entwicklerkonsole eines Modellanbieters, legen Sie ein Konto an und richten Sie die Abrechnung ein.
- Erstellen Sie einen neuen Schlüssel mit einem klaren Namen wie „faq-bot-dev“, damit Sie später wissen, wo er verwendet wird.
- Kopieren Sie den Schlüssel sofort. Viele Konsolen zeigen ihn nur ein einziges Mal.
- Speichern Sie ihn in einer Umgebungsvariable: einem benannten Wert, der in Ihrem System oder in den Einstellungen Ihres Hostings liegt — nicht im Quellcode.
Unter macOS oder Linux setzen Sie die Variable für die aktuelle Terminal-Sitzung so:
export LLM_API_KEY="hier-den-schluessel-einfuegen"
Unter Windows in der PowerShell:
$env:LLM_API_KEY = "hier-den-schluessel-einfuegen"
In Projekten legen viele Entwickler Schlüssel in einer lokalen Datei namens .env ab und laden sie mit einer kleinen Bibliothek. Tragen Sie .env in Ihre .gitignore-Datei ein, damit der Schlüssel nie in der Versionsverwaltung landet.
Schritt 2: Die Anfrage zusammenbauen
Eine Anfrage hat drei Teile: wohin sie geht, wer sie schickt und was sie verlangt.
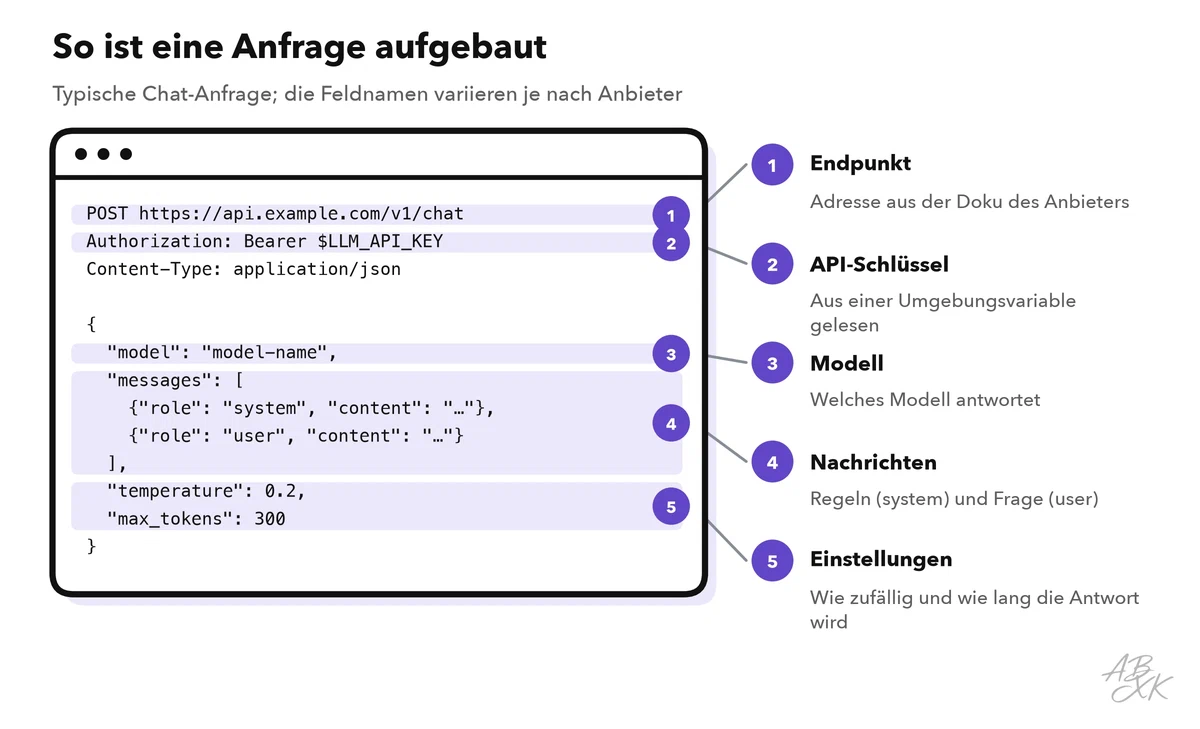
- Endpunkt und Methode. Die Webadresse steht in der Dokumentation des Anbieters. Daten senden Sie mit der HTTP-Methode POST.
- Header. Zusatzzeilen, die mit der Anfrage reisen: Ihr API-Schlüssel und der Inhaltstyp
application/json. Viele Anbieter erwarten den Schlüssel alsAuthorization: Bearer …, andere in einem Header mit anderem Namen. - Body. Das JSON mit Modell, Nachrichten und Einstellungen.
Jede Nachricht hat eine Rolle. Die System-Nachricht enthält Regeln für das ganze Gespräch. User-Nachrichten enthalten die Eingabe. Assistant-Nachrichten enthalten frühere Antworten des Modells. Teil 2 dieses Levels, Prompt-Design für Entwickler, zeigt, wie Sie sie gut formulieren.
Die Einstellungen steuern, wie das Modell antwortet. Diese brauchen Sie am häufigsten:
| Einstellung | Was sie bewirkt | Guter Startwert |
|---|---|---|
| model | Wählt das Modell, das antwortet | Ein mittelgroßes Modell Ihres Anbieters |
| messages | System-Regeln, Eingabe, frühere Antworten | Eine System- und eine User-Nachricht |
| temperature | Zufall: niedrig = fokussiert und wiederholbar, hoch = abwechslungsreicher | 0–0,3 für Fakten und Daten, höher für Ideen |
| max tokens | Obergrenze für die Länge der Antwort | Genug für Ihre längste normale Antwort |
| stream | Schickt die Antwort in kleinen Stücken, während sie entsteht | Aus in Skripten, an in Chat-Oberflächen |
| stop | Text, an dem das Modell aufhört zu schreiben | Nur bei Bedarf |
Namen und Wertebereiche unterscheiden sich je nach Anbieter, und manche Modelle — vor allem Reasoning-Modelle — akzeptieren nicht jede Einstellung. Die API-Referenz Ihres Anbieters nennt, was welches Modell unterstützt.
Schritt 3: Die erste Anfrage senden
So sieht die Anfrage als reines HTTP aus. api.example.com und model-name sind Platzhalter: Setzen Sie den Endpunkt und die Modell-ID aus der Dokumentation Ihres Anbieters ein.
POST https://api.example.com/v1/chat
Authorization: Bearer <Ihr Schlüssel aus LLM_API_KEY>
Content-Type: application/json

{
  "model": "model-name",
  "messages": [
    {"role": "system", "content": "Antworten Sie in einfachem Deutsch, in höchstens drei Sätzen."},
    {"role": "user", "content": "Was ist ein API-Schlüssel?"}
  ],
  "temperature": 0.2,
  "max_tokens": 300
}
Derselbe Aufruf in Python, mit der verbreiteten Bibliothek requests (Installation mit pip install requests):
import os
import requests

API_KEY = os.environ["LLM_API_KEY"]        # Schlüssel aus der Umgebung lesen
URL = "https://api.example.com/v1/chat"    # Endpunkt Ihres Anbieters

payload = {
    "model": "model-name",
    "messages": [
        {"role": "system", "content": "Antworten Sie in einfachem Deutsch, in höchstens drei Sätzen."},
        {"role": "user", "content": "Was ist ein API-Schlüssel?"},
    ],
    "temperature": 0.2,
    "max_tokens": 300,
}

response = requests.post(
    URL,
    headers={"Authorization": f"Bearer {API_KEY}"},
    json=payload,      # schickt den Body als JSON und setzt den Inhaltstyp
    timeout=30,        # nie endlos warten
)
response.raise_for_status()   # bei einem Fehler mit Meldung abbrechen
print(response.json())
Die meisten Anbieter bieten außerdem offizielle Bibliotheken an, sogenannte SDKs (Software Development Kits), die diese Schritte auf wenige Zeilen verkürzen. Das ist bequem, die Struktur darunter bleibt aber dieselbe. Selbst Open-Weight-Modelle, die Sie selbst betreiben — etwa auf einer GPU-Cloud wie Runpod —, bieten meist dieselbe Art von Chat-Endpunkt. Ihr Code ändert sich dann kaum.
Schritt 4: Die Antwort lesen
Auch die Antwort ist JSON. Ihr genauer Aufbau hängt vom Anbieter ab, aber Sie finden immer dieselben vier Arten von Informationen.
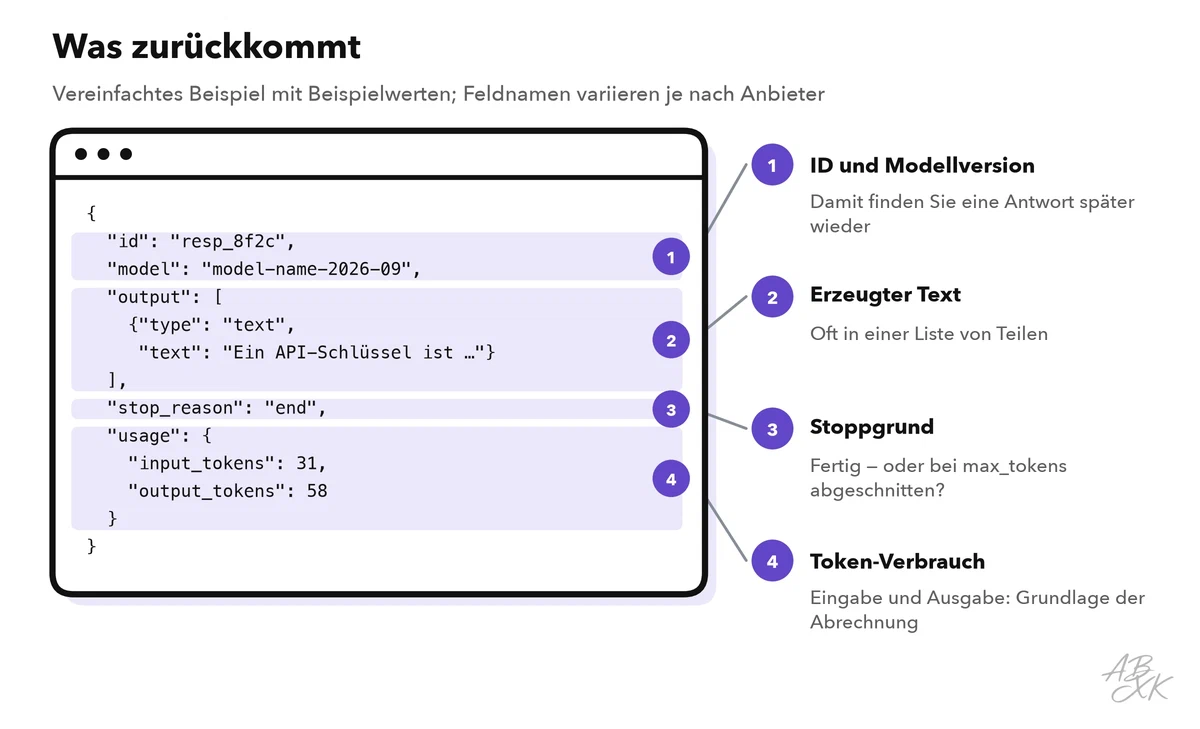
- Der erzeugte Text. Er steht in einem Feld wie
contentodertext, oft innerhalb einer Liste, weil eine Antwort aus mehreren Teilen bestehen kann. - Der Stoppgrund. Er zeigt, ob das Modell normal fertig wurde oder an Ihre Grenze für max tokens gestoßen ist. Im zweiten Fall ist die Antwort abgeschnitten. Erhöhen Sie die Grenze oder bitten Sie um eine kürzere Antwort.
- Der Token-Verbrauch. Die Zahl der Eingabe- und Ausgabe-Tokens. Anbieter rechnen pro Token ab — protokollieren Sie diese Zahlen vom ersten Tag an.
- ID und Modellversion. Damit verfolgen Sie eine seltsame Antwort später zurück.
Das Feld model entscheidet, wer antwortet. Unsere LLM-Datenbank führt 343 Modelle mit Erscheinungsdatum und Testergebnissen. Hier einige aktuelle Modelle verschiedener Anbieter:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Claude Sonnet 5.5 Anthropic | 28.09.2026 | geschlossen | 164,4 | 6 |
| GPT-6 Luna OpenAI | 22.09.2026 | geschlossen | 156,3 | 28 |
| Gemini 3.8 Flash Google DeepMind | 02.09.2026 | geschlossen | 157,2 | 19 |
| DeepSeek V4.1 Flash DeepSeek | 09.09.2026 | offen | 155,6 | 31 |



ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Die Namen in unserer Datenbank sind Anzeigenamen. Die genaue Modell-ID für Ihre Anfrage steht in der Dokumentation des Anbieters. Teil 4 dieses Levels erklärt, wie Sie ein Modell für Ihre App wählen.
Schritt 5: Fehler behandeln und richtig wiederholen
Aufrufe scheitern. Das Netz bricht ab, der Anbieter ist überlastet, oder Ihre Anfrage enthält einen Fehler. Der Statuscode der Antwort verrät, welcher Fall vorliegt. Codes im 200er-Bereich bedeuten Erfolg, alles andere verlangt eine Reaktion:
| Statuscode | Übliche Bedeutung | Was Sie tun |
|---|---|---|
| 400 | Fehlerhafte Anfrage: falsches Feld, ungültiges JSON, Eingabe zu lang | Anfrage korrigieren, nicht wiederholen |
| 401 / 403 | Schlüssel fehlt, ist falsch oder hat keine Rechte | Schlüssel und Berechtigungen prüfen |
| 404 | Unbekannter Endpunkt oder unbekannte Modell-ID | Adresse und Modell-ID prüfen |
| 429 | Zu viele Anfragen oder Nutzungslimit erreicht | Warten, dann wiederholen; Limits prüfen |
| 500 / 503 | Fehler oder Überlast beim Anbieter | Warten, dann wiederholen |
| Zeitüberschreitung | Keine Antwort in der vorgesehenen Zeit | Ein- bis zweimal wiederholen, dann sauber abbrechen |
Die Regel hinter der Tabelle: Vorübergehendes wiederholen, Dauerhaftes korrigieren.
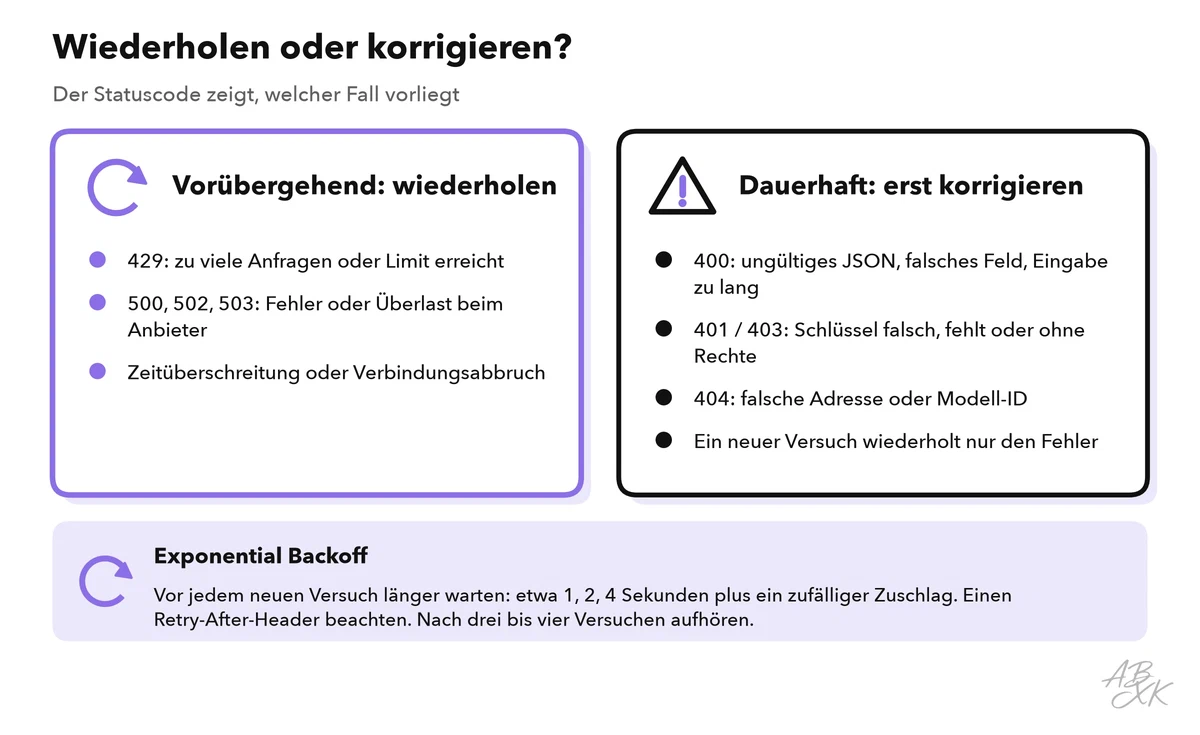
Warten Sie bei jedem neuen Versuch etwas länger — zum Beispiel etwa 1, dann 2, dann 4 Sekunden, plus einen kleinen zufälligen Zuschlag. Dieses Muster heißt Exponential Backoff. Der Zufallsanteil verhindert, dass viele Programme im selben Moment erneut anfragen. Enthält die Antwort einen Retry-After-Header, warten Sie mindestens so lange. Nach drei bis vier Versuchen brechen Sie ab und zeigen eine verständliche Meldung.
import random
import time

import requests

def post_with_retry(url, headers, payload, tries=4):
    for attempt in range(tries):
        try:
            r = requests.post(url, headers=headers, json=payload, timeout=30)
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()   # 400, 401, 403, 404: Anfrage korrigieren, kein neuer Versuch
                return r.json()
        except (requests.exceptions.Timeout, requests.exceptions.ConnectionError):
            pass                       # Netzprobleme sind ebenfalls vorübergehend
        if attempt < tries - 1:        # nach dem letzten Versuch keine Pause
            time.sleep(2 ** attempt + random.random())   # etwa 1, 2, 4 Sekunden
    raise RuntimeError("Die API scheitert auch nach mehreren Versuchen.")
Übung: Ihr erster Aufruf in 20 Minuten
Sie möchten lieber keinen Code schreiben? No-Code-Plattformen wie MindStudio bauen auf denselben Modellen auf, ohne dass Sie diese Aufrufe selbst schreiben müssen — Teil 3 dieses Levels zeigt, wie Sie eine einfache KI-App ohne Code bauen.