

Ein KI-Coding-Assistent kann in Sekunden eine lauffähige Funktion schreiben. Er erklärt verwirrende Fehlermeldungen, schlägt Tests vor und benennt eine Variable im ganzen Projekt um. Derselbe Assistent ruft womöglich aber auch eine Funktion auf, die es nicht gibt, wählt eine jahrealte Version einer Bibliothek oder lässt Angreifern eine Tür offen. Und all das in Code, der sauber und selbstsicher aussieht.
Dies ist Teil 5 von Level 0 unseres Lernpfads AI Development. Sie lernen die drei Hauptformen von Coding-Assistenten kennen, die Aufgaben, bei denen sie wirklich Zeit sparen, die Fehler, die sie typischerweise machen, und warum die Prüfung immer bei Ihnen bleibt. Programmieren müssen Sie dafür nicht: Ein kurzes Codebeispiel zeigt die typischen Fehler, und der Text erklärt sie in einfachen Worten.
Drei Formen: von der Autovervollständigung zum Agenten
Ein KI-Coding-Assistent ist ein Werkzeug, das mithilfe eines großen Sprachmodells (LLM) Programmcode vorschlägt, erklärt oder ändert. Das Modell hat aus riesigen Mengen öffentlichen Codes und Texts gelernt. Es sagt voraus, welcher Code am wahrscheinlichsten zu Ihrer Anfrage passt. Ob dieser Code richtig ist, weiß es nicht. Teil 1 dieses Levels hat die drei Formen vorgestellt. So arbeiten sie in der Praxis:
- Autovervollständigung. Während Sie im Code-Editor tippen, schlägt der Assistent in hellgrauer Schrift die nächste Zeile oder einen ganzen Block vor. Sie übernehmen den Vorschlag mit einer Taste oder tippen einfach weiter.
- Chat. Sie stellen Fragen in einem Chatfenster neben Ihrem Code oder im Browser: „Was macht diese Funktion?“ oder „Schreib eine Funktion, die eine E-Mail-Adresse prüft.“ Die Antwort kopieren Sie selbst in Ihr Projekt.
- Agenten. Sie beschreiben eine Aufgabe, etwa „Füge der Produktseite ein Suchfeld hinzu“. Der Agent plant die Schritte, liest und ändert mehrere Dateien, führt Befehle und Tests aus und zeigt Ihnen das Ergebnis als Diff: eine Liste aller Zeilen, die er hinzugefügt, geändert oder gelöscht hat. Manche Agenten arbeiten in Ihrem Editor oder im Terminal. Andere arbeiten in der Cloud und liefern einen Pull Request: einen Änderungsvorschlag, den ein Mensch prüft, bevor er Teil des Projekts wird.
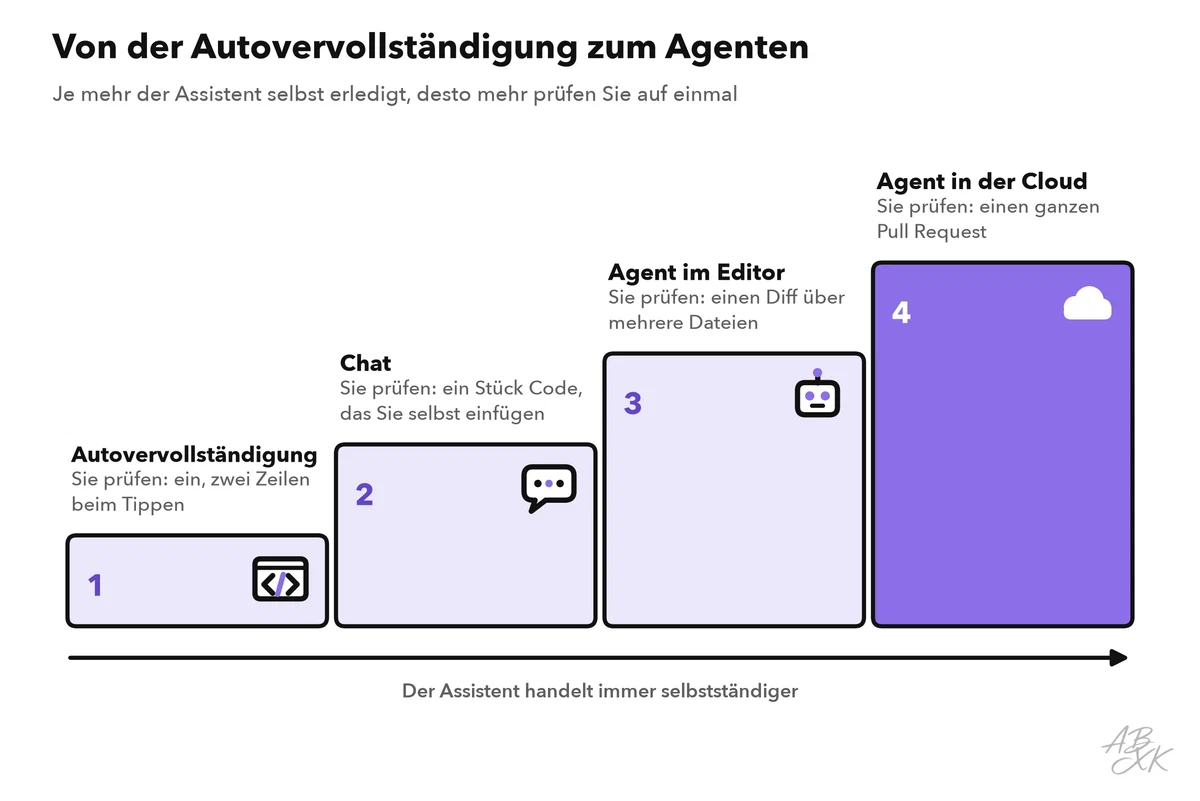
Viele Produkte bieten mehrere dieser Formen, und die Grenzen verschwimmen. Der entscheidende Unterschied ist, wie viel der Assistent erledigt, bevor Sie das Ergebnis sehen: Bei der Autovervollständigung prüfen Sie ein, zwei Zeilen, bei einem Agenten Änderungen in vielen Dateien auf einmal.
Wo Assistenten wirklich Zeit sparen
Assistenten arbeiten am besten bei Aufgaben mit klarem Muster, bei denen Sie schnell sehen, ob das Ergebnis stimmt. Zwei Begriffe begegnen Ihnen dabei oft. Boilerplate ist Standardcode, der in fast jedem Projekt gleich aussieht, etwa die Einstellungen für ein Webformular. Ein Unit-Test ist ein kleines Programm, das eine einzelne Funktion automatisch prüft, zum Beispiel, ob eine Preisberechnung noch die richtige Summe liefert.
| Aufgabe | Wie der Assistent hilft | Was Sie weiter prüfen |
|---|---|---|
| Boilerplate | Schreibt Konfigurationsdateien, Formulare und Routineabfragen für Datenbanken | Ob der Code dem Stil und den Regeln Ihres Projekts folgt |
| Tests | Schlägt Unit-Tests und ungewöhnliche Fälle für vorhandene Funktionen vor | Ob jeder Test das Richtige prüft, nicht nur, ob er besteht |
| Erklärungen | Erklärt fremden Code und Fehlermeldungen Zeile für Zeile | Wichtige Aussagen anhand der offiziellen Dokumentation |
| Kleine Änderungen | Benennt um, teilt auf oder wandelt Code um; schreibt Kommentare und Dokumentation | Den Diff, Zeile für Zeile |
| Prototypen | Baut in Minuten eine erste lauffähige Version einer Idee | Alles, bevor aus dem Prototyp ein Produkt wird |
Erklärungen sind auch dann nützlich, wenn Sie selbst nie Code schreiben. Bevor Sie ein Programm ändern oder ausführen, lassen Sie sich vom Assistenten Zeile für Zeile erklären, was es tut. So lernen Sie schnell eine neue Programmiersprache oder finden sich in einem fremden Projekt zurecht.
Bei Prototypen spielt Vibe Coding seine Stärken aus: Sie beschreiben eine Idee, die KI schreibt den Code, und Sie testen und korrigieren ihn. Unser VibeCoding-Artikel zeigt, wie wir diesen Ansatz für Experimente nutzen und für welche Art von Code wir ihn nicht einsetzen.
Typische Fehler und warum sie entstehen
Ein Assistent schlägt beim Schreiben nichts nach, es sei denn, das Werkzeug gibt ihm eine Websuche oder die Dokumentation. Er erzeugt Code, der richtig aussieht, auf Grundlage der Muster, die er gelernt hat. Meistens klappt das. Manche Fehler tauchen aber immer wieder auf. Das Beispiel unten zeigt drei Arten davon in zehn Zeilen Code.
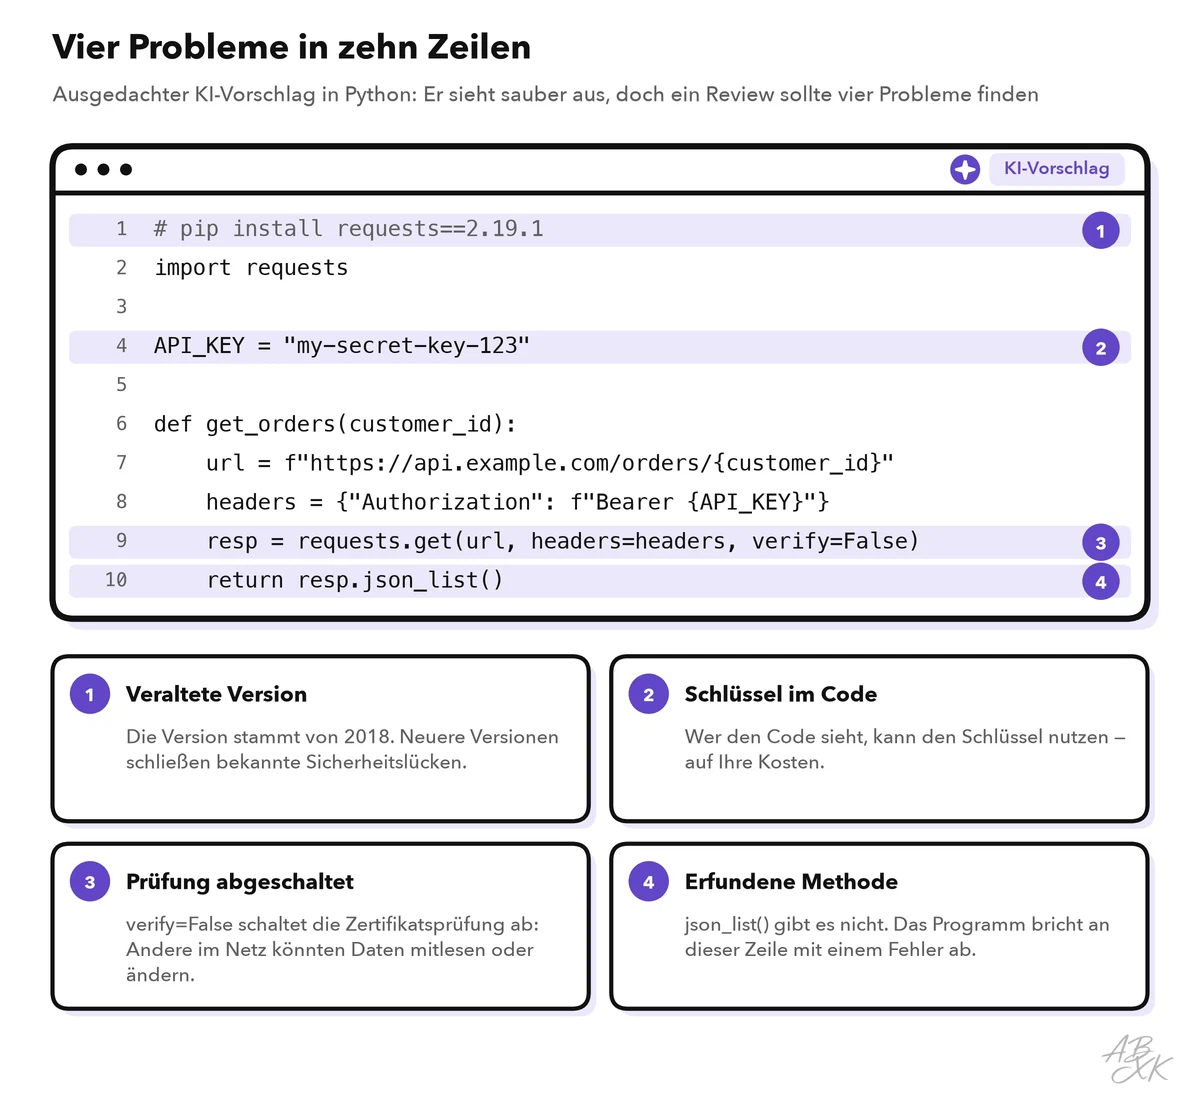
- Erfundene Funktionen und Pakete. Das Modell schreibt einen Namen, der plausibel klingt, aber nicht existiert, wie
json_list()im Beispiel. Das ist eine Halluzination, die Code-Variante eines erfundenen Zitats. Es kann auch ganze Pakete treffen: Der Assistent empfiehlt, eine Bibliothek zu installieren, die nie veröffentlicht wurde. Sicherheitsforscher warnen, dass Angreifer unter solchen erfundenen Namen schädlichen Code veröffentlichen können (Quelle: Spracklen et al., „We Have a Package for You!“, USENIX Security 2025, usenix.org). - Veraltete Bibliotheken. Ein Modell lernt aus Code bis zu einem Stichtag, und vieles davon ist älter. Deshalb legt es womöglich eine alte Version einer Bibliothek fest oder nutzt eine Funktion, die längst entfernt wurde. Die Version im Beispiel stammt von 2018, und neuere Versionen schließen bekannte Sicherheitslücken.
- Sicherheitslücken. Öffentlicher Code enthält unsichere Muster, und Modelle wiederholen sie. Typische Beispiele sind ein API-Schlüssel (ein geheimer Code, der Zugang zu einem kostenpflichtigen Dienst gibt), der im Code steht, eine abgeschaltete Sicherheitsprüfung oder Nutzereingaben, die ungeprüft weitergereicht werden. Eine Studie der Stanford University ergab, dass Menschen mit KI-Assistent weniger sicheren Code schrieben als Menschen ohne – und eher glaubten, ihr Code sei sicher (Quelle: Perry et al., „Do Users Write More Insecure Code with AI Assistants?“, ACM CCS 2023, arxiv.org).
- Plausible, aber falsche Logik. Der Code läuft, tut aber das Falsche: Er übersieht einen Sonderfall, rundet einen Preis falsch oder scheitert an einer leeren Liste. Tests, die derselbe Assistent geschrieben hat, können dasselbe Missverständnis enthalten.
- Fehlender Kontext. Der Assistent sieht nur, was ihm das Werkzeug gibt: oft die geöffnete Datei, manchmal mehr vom Projekt. Er kennt die Regeln Ihres Teams nicht, weiß nicht, warum alter Code so aussieht, wie er aussieht, und auch nicht, worum Ihre Kundschaft wirklich gebeten hat.
Agenten bringen eigene Risiken mit, weil sie handeln, statt nur vorzuschlagen. Ein Agent ändert womöglich Dateien, die Sie nicht genannt haben, oder bringt fehlschlagende Tests zum Bestehen, indem er die Tests ändert statt den Code. Er kann sich auch von Anweisungen in die Irre führen lassen, die in Inhalten versteckt sind, die er liest, etwa auf einer Webseite oder in einem Code-Kommentar. Das nennt man Prompt Injection. Geben Sie Agenten nur die Zugriffe, die sie brauchen, und lassen Sie sie nachfragen, bevor sie Befehle ausführen. Unser Bereich AI Security erklärt diese Risiken ausführlicher.
Wie gut sind Coding-Assistenten? Ein Blick in die Daten
Forschende vergleichen Modelle mit Benchmarks: festen Sammlungen von Testaufgaben mit einer klaren Bewertung. Für Code gehört SWE-bench Verified zu den bekanntesten. Er nutzt echte Probleme aus Open-Source-Projekten in Python, deren Code jeder lesen kann, und das Modell muss den Code so ändern, dass die Tests des Projekts bestehen. Das sind die Spitzenreiter in unseren LLM-Daten:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Claude Opus 4.7 (max) Anthropic | 16.04.2026 | 83,5 % |
| 2 | GPT-5.5 (xhigh) OpenAI | 23.04.2026 | 80,6 % |
| 3 | Gemini 3.5 Flash Google DeepMind | 19.05.2026 | 79,3 % |
| 4 | Claude Opus 4.6 (no thinking) Anthropic | 05.02.2026 | 78,7 % |
| 5 | GLM-5.2 Z.ai (Zhipu AI) | 16.06.2026 | 78,7 % |



500 echte Fehlerberichte aus Open-Source-Projekten in Python, von Menschen geprüft. Das Modell muss den Code so ändern, dass die Tests des Projekts bestehen. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Zwei Hinweise helfen beim Lesen der Tabelle. Erstens sind das Epoch AIs eigene Läufe mit einem festen Aufbau; Anbieter melden mit eigenem Werkzeug oft höhere Werte. Zweitens ist noch nicht jedes neue Modell auf jedem Benchmark getestet, deshalb fehlen hier womöglich einige der neuesten Modelle aus unserer LLM-Datenbank.
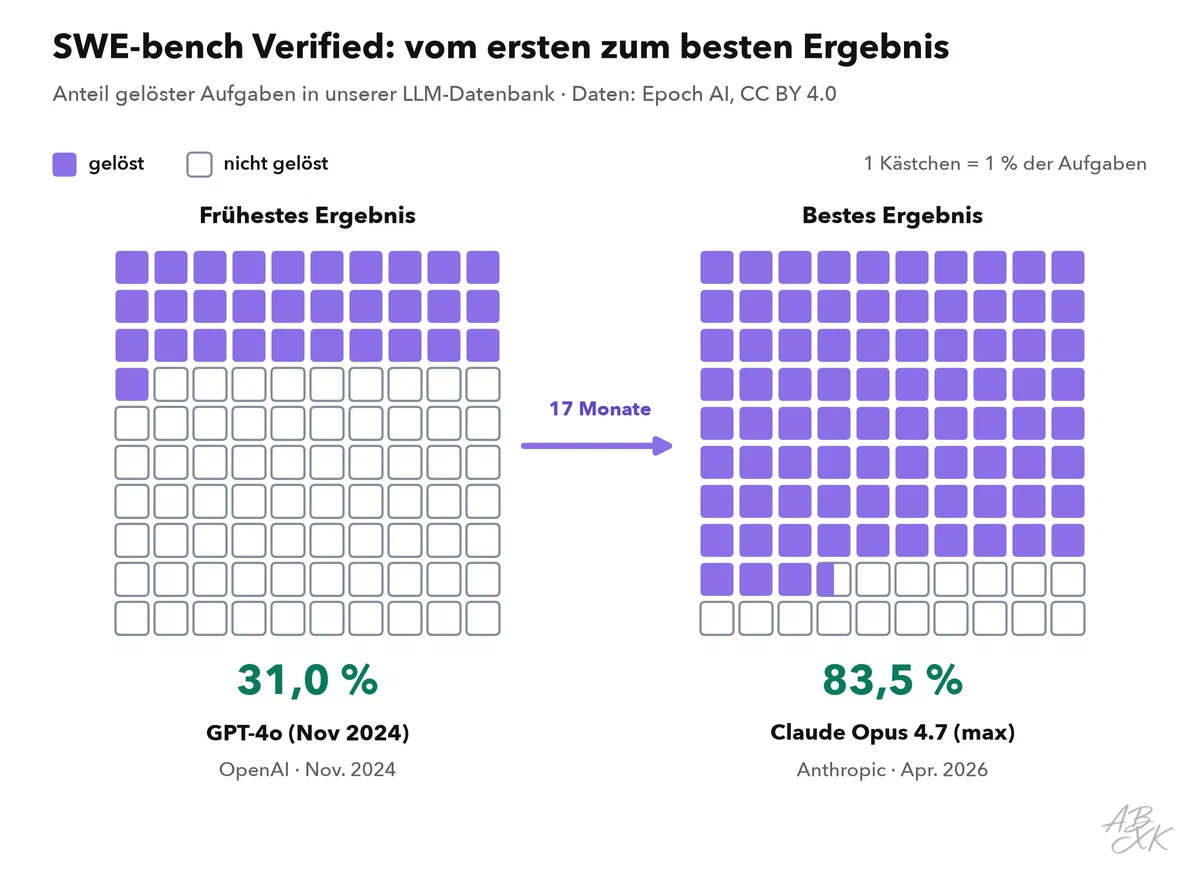
Die Abbildung rückt die Werte ins Verhältnis. Coding-Modelle sind schnell besser geworden. Doch der Benchmark besteht aus kleinen, gut beschriebenen Korrekturen, die Menschen vorab gesichtet haben. Ihr eigenes Projekt ist unübersichtlicher: andere Sprachen, ungeschriebene Regeln, unklare Anforderungen. Ein hoher Wert sagt Ihnen, dass sich ein Modell für einen Versuch lohnt, nicht, dass sein Code stimmt. Level 4 erklärt, wie Coding-Benchmarks funktionieren und wo sie in die Irre führen können, etwa durch fehlerhafte Tests.
Die Prüfung liegt bei Ihnen
Verantwortlich für den Code ist, wer ihn übernimmt, nicht der Assistent. Behandeln Sie KI-Code wie Code von einer neuen Kollegin, die schnell und belesen ist, sich aber manchmal irrt, ohne es zu merken. Wie genau Sie prüfen, hängt von zwei Fragen ab: Was geht kaputt, wenn der Code falsch ist, und wie gut verstehen Sie ihn?
Je mehr Sie dem Tool vertrauen, desto schwerer wird das. In einer Umfrage von Microsoft Research und der Carnegie Mellon University unter 319 Wissensarbeitenden von 2025 gaben Menschen mit mehr Vertrauen in generative KI weniger kritisches Denken an, Menschen mit mehr Vertrauen in die eigenen Fähigkeiten dagegen mehr (Quelle: Lee et al., CHI 2025). Für Code heißt das: Gerade wenn ein Assistent zuverlässig wirkt, lesen Sie weiter mit.
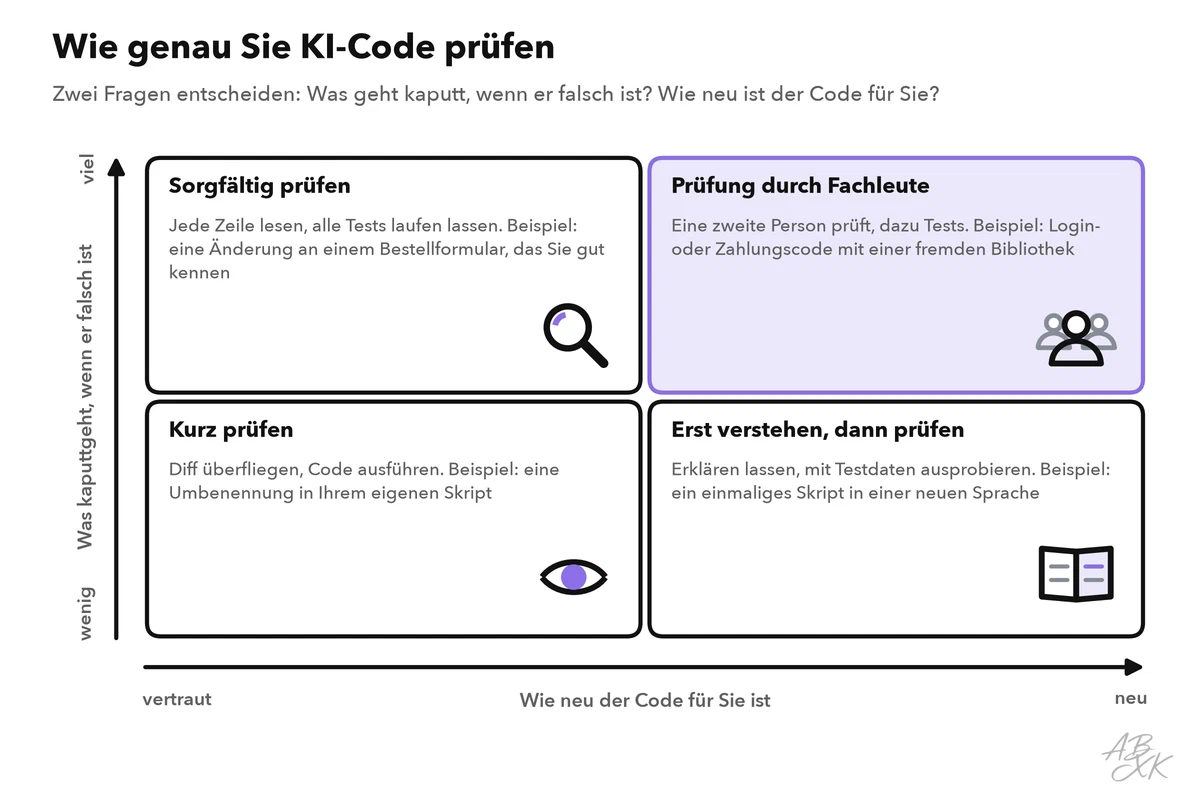
Fünf Gewohnheiten decken die meisten Situationen ab:
- Arbeiten Sie in kleinen Schritten. Bitten Sie um eine Funktion oder eine Änderung auf einmal. Ein kleiner Diff ist leicht zu lesen; ein riesiger verleitet zum Überfliegen.
- Fragen Sie, bevor Sie übernehmen. Lassen Sie sich den Code erklären und die Annahmen auflisten. Passt die Erklärung nicht zum Code, stimmt etwas nicht.
- Führen Sie ihn aus und testen Sie ihn. Lassen Sie Code und Tests laufen, und lesen Sie auch die Tests.
- Prüfen Sie jedes neue Paket. Gibt es das Paket, ist es das gemeinte, und ist die Version aktuell?
- Holen Sie eine zweite Person zur Prüfung dazu, wenn der Code Anmeldungen, Zahlungen oder personenbezogene Daten verarbeitet.
Werkzeuge können einen Teil der Prüfung übernehmen. Laut Anbieter schreibt TestDriver.ai Tests für Pull Requests, führt sie aus und meldet Fehler, bevor eine Änderung übernommen wird. App-Builder stehen am anderen Ende. Laut den Anbietern baut Emergent Web- und Mobil-Apps aus einer Beschreibung in Alltagssprache, und mit Devs.ai bauen Teams Apps und Agenten auf ihren eigenen Daten. Je weniger Code Sie selbst schreiben, desto mehr zählen Ihre Prüfungen. Wir haben diese Werkzeuge nicht getestet.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Level 2 macht aus diesen Gewohnheiten einen vollständigen Coding-Ablauf mit Prüfpunkten.
Checkliste: bevor Sie KI-Code übernehmen
Gehen Sie diese Fragen durch, wann immer Ihnen ein Assistent Code liefert, ob eine Zeile oder einen ganzen Pull Request:
| Frage | Warum sie zählt |
|---|---|
| Kann ich erklären, was jede Zeile tut? | Code, den Sie nicht verstehen, können Sie weder reparieren noch pflegen |
| Läuft er, und bestehen die Tests? Habe ich die Tests gelesen? | Bestandene Tests helfen nur, wenn sie das Richtige prüfen |
| Gibt es alle Funktionen und Pakete, in einer aktuellen Version? | Erfundener und veralteter Code ist ein häufiger Fehler |
| Steht ein Passwort, Schlüssel oder anderes Geheimnis im Code? | Jeder, der den Code sehen kann, kann es nutzen |
| Ist eine Sicherheitsprüfung abgeschaltet, oder werden Nutzereingaben ungeprüft verwendet? | Solche Lücken fallen nicht auf, bis jemand sie angreift |
| Hat die Änderung etwas berührt, worum ich nicht gebeten habe? | Agenten ändern manchmal andere Dateien, Einstellungen oder Tests |