

Viele KI-Apps brauchen aktuelle Daten aus dem Web: Produktpreise, Stellenanzeigen, öffentliche Ausschreibungen, Dokumentationen, Nachrichten. Ein Modell allein liefert sie nicht, denn sein Wissen endet mit dem Trainingsstichtag. Ihre App muss die Daten also selbst beschaffen — und wie sie das tut, entscheidet darüber, wie verlässlich, rechtssicher und wartbar das Ergebnis ist.
Dies ist Teil 2 von Level 3 (Profi). Sie lernen die Reihenfolge der Möglichkeiten (offizielle API, lizenzierte Daten, Scraping), wie ein Scraper arbeitet und welche Regeln gelten: robots.txt, Nutzungsbedingungen, Urheberrecht und DSGVO. Außerdem sehen Sie, wie Sie höflich crawlen, wann Proxys legitim sind und wie Sie bemerken, dass sich eine Quelle ändert. Das ist eine praktische Anleitung, keine Rechtsberatung; ziehen Sie bei echten Projekten Ihre Rechtsabteilung hinzu.
Zuerst die offizielle API
Bevor Sie eine einzige Zeile Scraping-Code schreiben, suchen Sie nach einem offiziellen Zugang. Eine API (Application Programming Interface, Programmierschnittstelle) liefert strukturierte Daten, dokumentierte Felder, angegebene Ratenlimits und klare Bedingungen. Viele Websites bieten außerdem Datenexporte, RSS-Feeds, Sitemaps oder Open-Data-Portale an. Datenanbieter verkaufen lizenzierte Datensätze mit klaren Nutzungsrechten.
Web-Scraping heißt: Ein Programm lädt dieselben Seiten, die ein Browser anzeigt, und liest die Informationen aus dem HTML aus. Das funktioniert, wenn es keinen anderen Weg gibt, ist aber anfällig: Ändert die Website ihr Layout, bricht der Scraper. Rechtlich ist es zudem die unklarste Möglichkeit.
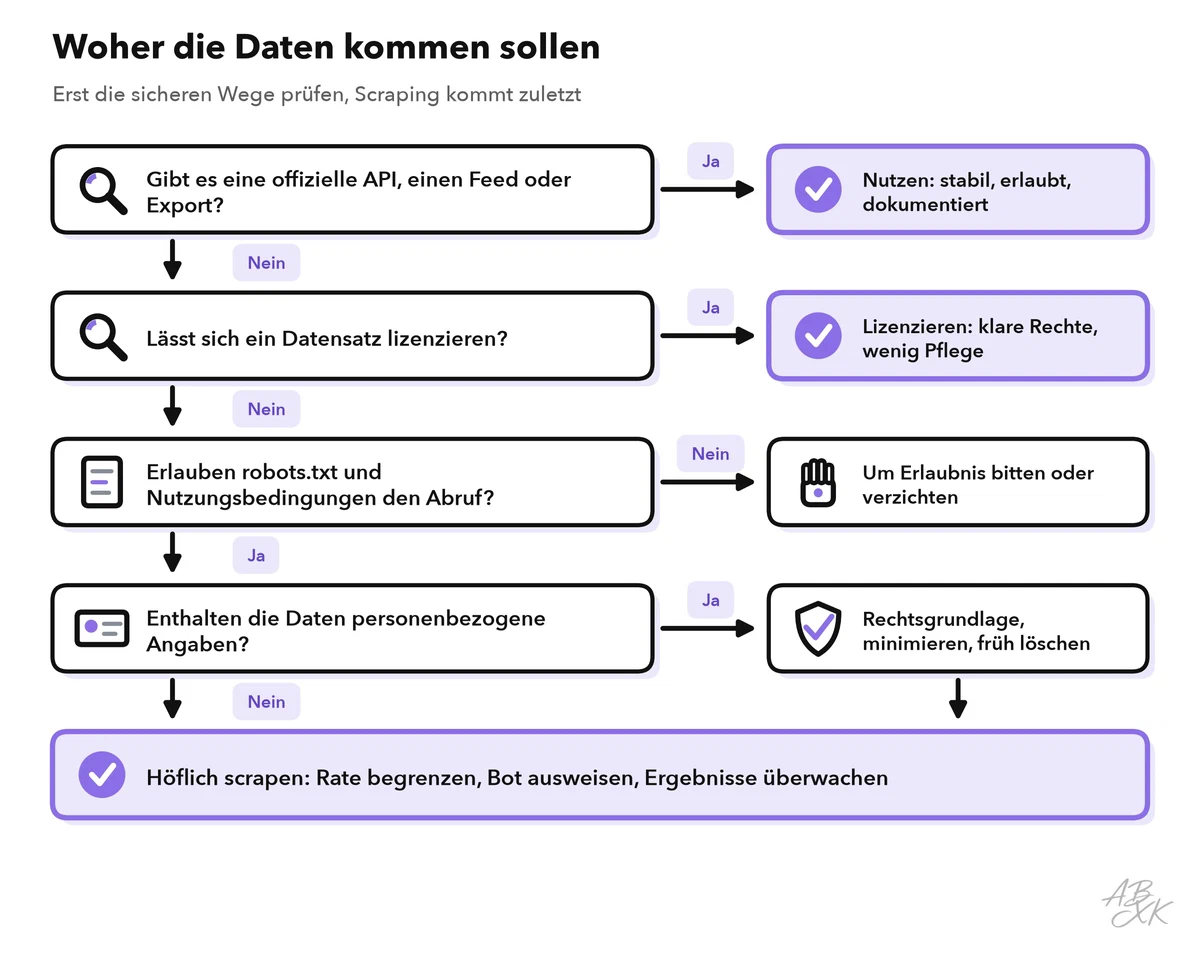
Die Tabelle vergleicht die drei Wege:
| Offizielle API | Lizenzierter Datensatz | Scraping | |
|---|---|---|---|
| Verlässlichkeit | Hoch, versioniert | Hoch, in Lieferungen | Gering, bricht bei Layoutänderungen |
| Rechtliche Klarheit | Klare Bedingungen | Klare Lizenz | Hängt von Bedingungen, Urheberrecht und personenbezogenen Daten ab |
| Aktualität | Live | Je nach Lieferung | So oft, wie Sie crawlen |
| Ihr Aufwand | Gering | Gering | Hoch: bauen, überwachen, reparieren |
So arbeitet ein Scraper
Ein Scraper durchläuft jedes Mal dieselben Schritte:
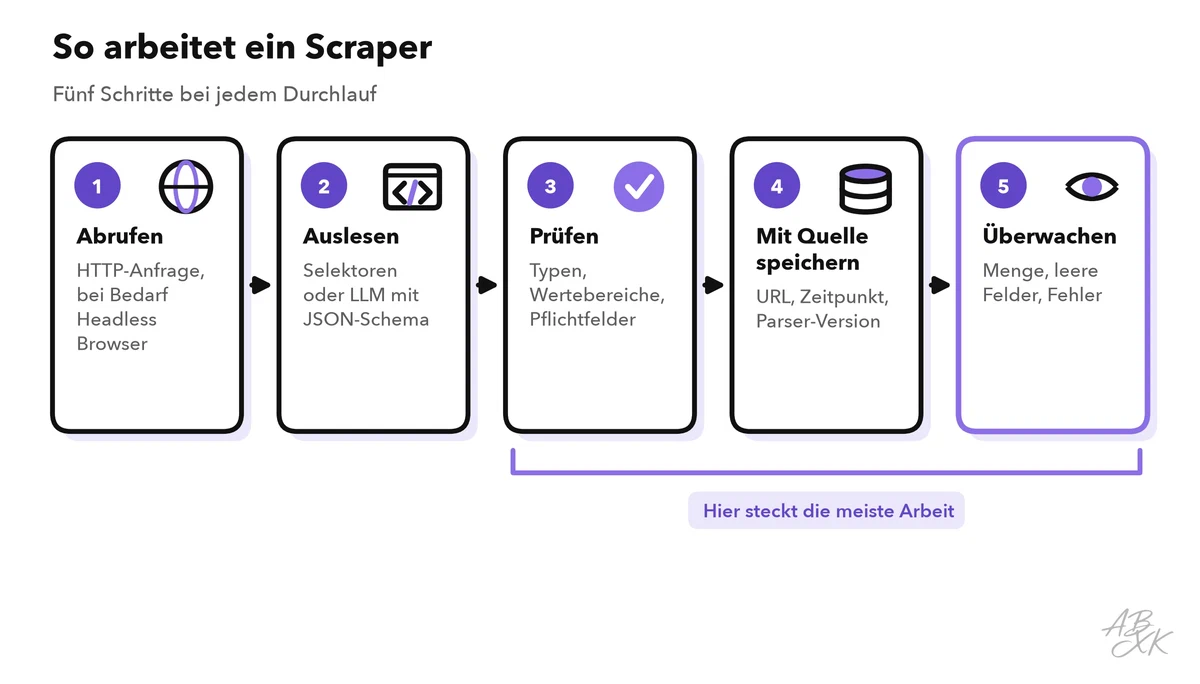
- Abrufen. Ihr Code fordert die Seite per HTTP an. Seiten, die ihre Inhalte per JavaScript nachladen, brauchen einen Headless Browser — einen Browser ohne Fenster, den Ihr Code steuert.
- Auslesen. Selektoren (CSS- oder XPath-Ausdrücke) zeigen auf die Felder, die Sie brauchen: Titel, Preis, Datum.
- Prüfen. Kontrollieren Sie Datentypen, Wertebereiche und Pflichtfelder. Ein Preis von null oder ein leerer Titel ist ein Fehler, keine Information.
- Mit Quelle speichern. Speichern Sie zu jedem Datensatz die URL, den Zeitpunkt des Abrufs und die Version des Parsers. Diese Herkunftsangabe (Provenance) zeigt später, woher eine Angabe stammt — unverzichtbar, wenn eine KI-App sie zitiert.
- Überwachen. Achten Sie auf Fehler, leere Felder und plötzliche Einbrüche der Datenmenge.
LLMs helfen bei Schritt 2. Wenn sich die Layouts unterscheiden, kann ein Modell unübersichtliches HTML in Felder nach einem JSON-Schema übersetzen — die Technik aus strukturierter Ausgabe und Function Calling in Level 2. Prüfen Sie das Ergebnis: Ein Modell füllt ein fehlendes Feld womöglich mit einer plausiblen Erfindung. Erlauben Sie null für fehlende Werte, und validieren Sie jeden Datensatz. In einem Agenten kann die ganze Pipeline zu einem einzigen Tool werden, wie in Teil 1 dieses Levels beschrieben.
Wer die Pipeline nicht selbst bauen will, findet No-Code-Werkzeuge. Nach Angaben des Anbieters liest Browse AI Daten aus Websites aus, überwacht Seiten auf Änderungen und kann eine Website in eine API verwandeln:
Die Regeln: robots.txt, Bedingungen, Urheberrecht und personenbezogene Daten
Vier Regelwerke entscheiden, ob Sie Webdaten erheben und nutzen dürfen. Prüfen Sie sie, bevor Sie bauen, nicht danach.
robots.txt ist eine Textdatei im Hauptverzeichnis einer Website, zum Beispiel example.com/robots.txt. Sie teilt Crawlern mit, welche Pfade sie besuchen dürfen. Das Format ist standardisiert: das Robots Exclusion Protocol (RFC 9309, IETF, 2022). Der Standard selbst sagt, dass diese Regeln keine Form der Zugriffsberechtigung sind; eine Website muss private Inhalte also auf anderem Weg schützen. robots.txt zu respektieren ist das Mindestmaß an gutem Verhalten, und viele Betreiber nutzen die Datei inzwischen, um KI-Crawler auszusperren.
Nutzungsbedingungen können den automatisierten Zugriff oder die Weiterverwendung von Inhalten verbieten. Inhalte hinter einem Login sind besonders heikel: Wer ein Konto anlegt, akzeptiert in der Regel die Bedingungen.
Urheberrecht und Datenbankrechte schützen Texte, Bilder und Datensammlungen, auch wenn sie öffentlich sind. Fakten selbst sind oft frei, die Art, wie sie formuliert und zusammengestellt sind, womöglich nicht. In der EU ist Text- und Data-Mining in vielen Fällen erlaubt. Rechteinhaber können aber widersprechen, bei Online-Inhalten zum Beispiel in maschinenlesbarer Form (Richtlinie (EU) 2019/790, Artikel 4).
Personenbezogene Daten bleiben nach der DSGVO (Datenschutz-Grundverordnung) personenbezogen, auch wenn sie öffentlich sichtbar sind. Sie brauchen eine Rechtsgrundlage und einen klaren Zweck. Sie erheben nur, was Sie brauchen, und löschen rechtzeitig, und die betroffenen Personen behalten ihre Rechte, etwa das Recht auf Löschung.
| Prüfpunkt | Frage | Wenn die Antwort ein Problem ist |
|---|---|---|
| API | Gibt es eine offizielle API, einen Feed oder Export? | Diesen nutzen statt zu scrapen |
| robots.txt | Sperrt sie die Pfade, die Sie brauchen? | Nicht crawlen; den Betreiber fragen |
| Bedingungen | Verbieten sie automatisierten Zugriff oder Weiterverwendung? | Um Erlaubnis bitten oder die Daten lizenzieren |
| Login | Liegt der Inhalt hinter einem Login? | Nicht ohne Erlaubnis scrapen |
| Urheberrecht | Kopieren Sie Texte oder Bilder statt nur Fakten? | Fakten und Links speichern; Widersprüche beachten |
| Personenbezogene Daten | Enthalten Datensätze Namen, E-Mail-Adressen oder Profile? | Rechtsgrundlage, Daten minimieren, früh löschen — oder weglassen |
| Last | Könnte Ihr Crawler die Website bremsen? | Rate senken, außerhalb der Stoßzeiten crawlen |
Höflich crawlen: Ratenlimits und Last
Ein Crawler, der Hunderte Anfragen pro Sekunde schickt, kann eine kleine Website für alle verlangsamen. Höfliches Crawlen schützt die Website und bewahrt Ihren Crawler davor, gesperrt zu werden.
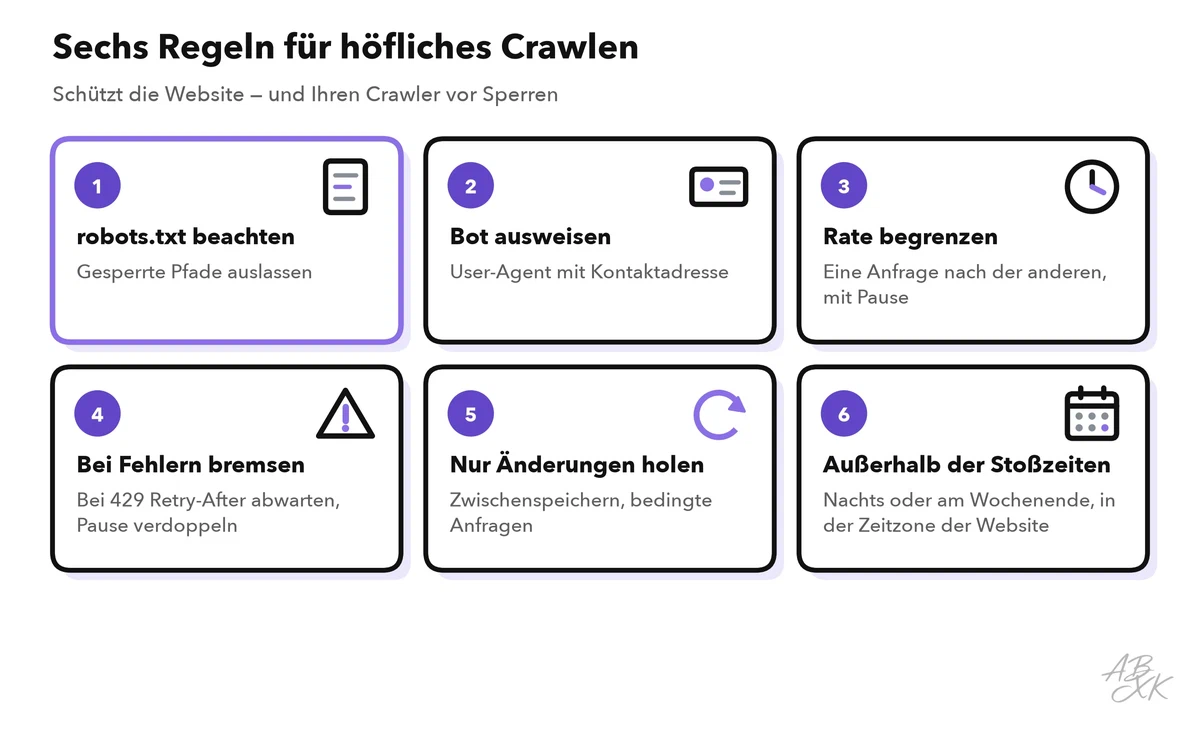
- Bot ausweisen. Senden Sie einen eindeutigen User-Agent mit Kontaktadresse, damit der Betreiber Sie erreichen kann, statt Sie zu sperren.
- Rate begrenzen. Eine Anfrage nach der anderen je Website, mit Pause dazwischen, ist ein sicherer Anfang. Halten Sie Limits ein, die die Website nennt.
- Bei Fehlern zurückhalten. Der HTTP-Status 429 bedeutet „Too Many Requests“, also zu viele Anfragen. Enthält die Antwort einen
Retry-After-Header, warten Sie mindestens so lange. Bei wiederholten Fehlern verdoppeln Sie die Wartezeit. - Zwischenspeichern und nur Änderungen abrufen. Bedingte Anfragen (
If-Modified-Since, ETags) erlauben dem Server die Antwort „nicht geändert“, ohne die Seite erneut zu senden.
Proxys: was sie sind und wann sie legitim sind
Ein Proxy ist ein Server, der Ihre Anfragen weiterleitet. Die Website sieht dann die IP-Adresse des Proxys statt Ihrer eigenen. Rechenzentrums-Proxys laufen in Hosting-Zentren. Residential Proxys leiten den Verkehr über Internetanschlüsse privater Haushalte, oft über Apps oder Software auf den Geräten dieser Menschen. Fragen Sie bei der Wahl eines Anbieters, woher er seine IP-Adressen bezieht und ob die Gerätebesitzer zugestimmt haben.
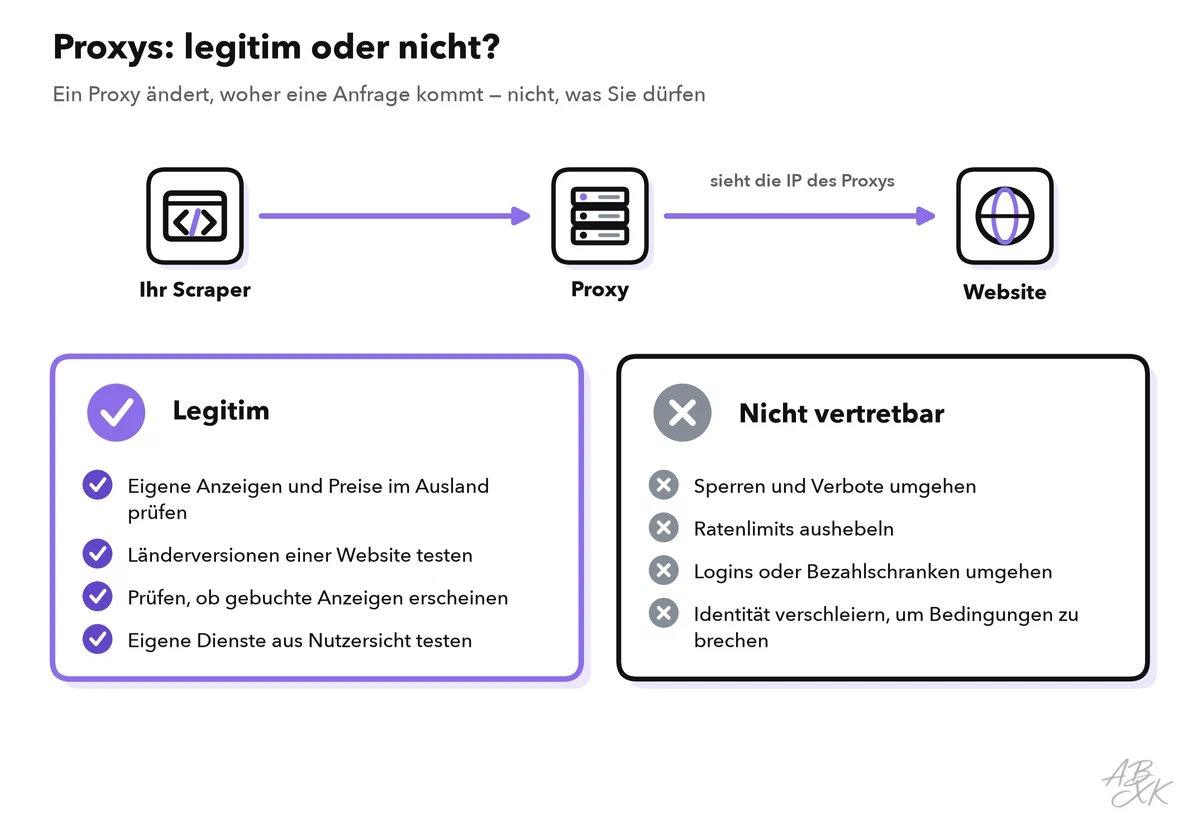
Proxys haben legitime Einsatzzwecke. So können Sie prüfen, wie Ihre eigenen Anzeigen, Preise oder Suchergebnisse in einem anderen Land aussehen. Sie können auch länderspezifische Versionen einer Website testen oder kontrollieren, ob Anzeigen dort erscheinen, wo sie gebucht wurden. Ein Weg um Regeln herum sind Proxys aber nicht. Wer sie nutzt, um eine Sperre, ein Ratenlimit, einen Login oder ein Verbot des Betreibers zu umgehen, macht aus Datenerhebung ein rechtliches Problem.
ThorData aus unserem Vergleich ist ein Proxy-Netzwerk für den Abruf öffentlich zugänglicher Webdaten. Wie unsere Einordnung sagt: Klären Sie die rechtliche Seite des geplanten Abrufs vorher. Pinecone steht am anderen Ende der Pipeline: eine Vektordatenbank, die gesammelte Texte für Suche und Retrieval speichert.


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Datenqualität und Änderungen überwachen
Scraper stürzen selten ab. Sie scheitern leise: Die Website benennt eine CSS-Klasse um, und ab diesem Tag ist Ihr Preisfeld leer. Eine KI-App auf dieser Grundlage antwortet dann selbstsicher aus veralteten oder kaputten Datensätzen.
Richten Sie Prüfungen ein, die bei jedem Durchlauf mitlaufen:
- Menge: Alarm, wenn die Zahl der Datensätze im Vergleich zum letzten Lauf stark sinkt.
- Vollständigkeit: Alarm, wenn der Anteil leerer Felder steigt.
- Plausibilität: Preise, Daten und Mengen bleiben in erwarteten Bereichen.
- Aktualität: das Datum des neuesten Datensatzes je Quelle verfolgen.
- Dubletten: denselben Artikel unter zwei URLs oder denselben Text doppelt erkennen.
Bevor Daten in einen Suchindex wandern, entfernen Sie außerdem Seitenballast wie Menüs, Cookie-Banner und Fußzeilen, damit die Suche die eigentlichen Inhalte findet. Retrieval-Augmented Generation Schritt für Schritt aus Level 2 zeigt, wie der bereinigte Text für ein Modell durchsuchbar wird.
Praxisbeispiel: ein Preisbeobachter für 200 Produktseiten
Ein Einkaufsteam möchte einen KI-Assistenten, der Fragen beantwortet wie „Welcher Lieferant hat den Preis für Artikel X diesen Monat gesenkt?“. So greifen die Schritte von oben ineinander:
- API-Prüfung: Zwei der fünf Lieferanten bieten einen Produkt-Feed. Das Team nutzt diese Feeds und prüft Scraping nur für die anderen drei Shops.
- Regelprüfung: robots.txt erlaubt die Produktseiten aller drei Shops, und die Seiten enthalten keine personenbezogenen Daten. Die Bedingungen eines Shops verbieten automatisierten Zugriff; das Team bittet diesen Shop um einen Feed und scrapt nur die anderen beiden.
- Crawl-Plan: einmal pro Nacht, eine Anfrage alle paar Sekunden je Shop, mit einem User-Agent, der das Team und eine Kontaktadresse nennt.
- Auslesen: Selektoren für Name, Preis und Verfügbarkeit; ein LLM als Rückfallebene mit JSON-Schema für Seiten mit ungewöhnlichem Layout;
nullfür fehlende Werte. - Prüfen und Speichern: Preise müssen positiv sein und in einem plausiblen Bereich liegen; jeder Datensatz behält URL, Zeitpunkt und Parser-Version.
- Überwachung: Alarme bei Mengeneinbrüchen und leeren Feldern, dazu wöchentlich eine Stichprobe von zehn zufälligen Datensätzen im Abgleich mit der Live-Seite.
- Antworten: Der Assistent antwortet nur aus gespeicherten Datensätzen und nennt zu jedem Preis das Datum.
Die Zahlen in diesem Beispiel dienen der Veranschaulichung. Passen Sie die Crawl-Rate an die Größe jeder Website an. Meldet sich ein Betreiber, antworten Sie schnell und passen Ihr Vorgehen an. Ein per E-Mail vereinbarter Feed kann einen Scraper dauerhaft ersetzen.