

Über eine API mieten Sie die Antworten eines Modells. Im Eigenbetrieb läuft das Modell auf Hardware, die Sie kontrollieren. Möglich machen das Modelle mit offenen Gewichten (Open-Weight-Modelle): Ihre trainierten Parameter — die Gewichte — sind veröffentlicht, jeder kann sie herunterladen und ausführen. Mit den Gewichten übernehmen Sie aber auch alle Aufgaben, die sonst der API-Anbieter erledigt: GPUs, Skalierung, Updates, Sicherheit und Inhaltsfilter.
Dies ist Teil 2 von Level 4 (Experte) im Lernpfad AI Development. Sie erfahren, wann sich der Eigenbetrieb lohnt, wie Sie Lizenzen offener Modelle lesen, welche Software aus Gewichten einen Endpunkt macht, wie Sie den GPU-Speicher planen und wie weit offene Modelle in unseren Daten hinter geschlossenen liegen. Der Teil setzt GPU-Infrastruktur für KI aus Level 3 fort.
Wann sich der Eigenbetrieb lohnt
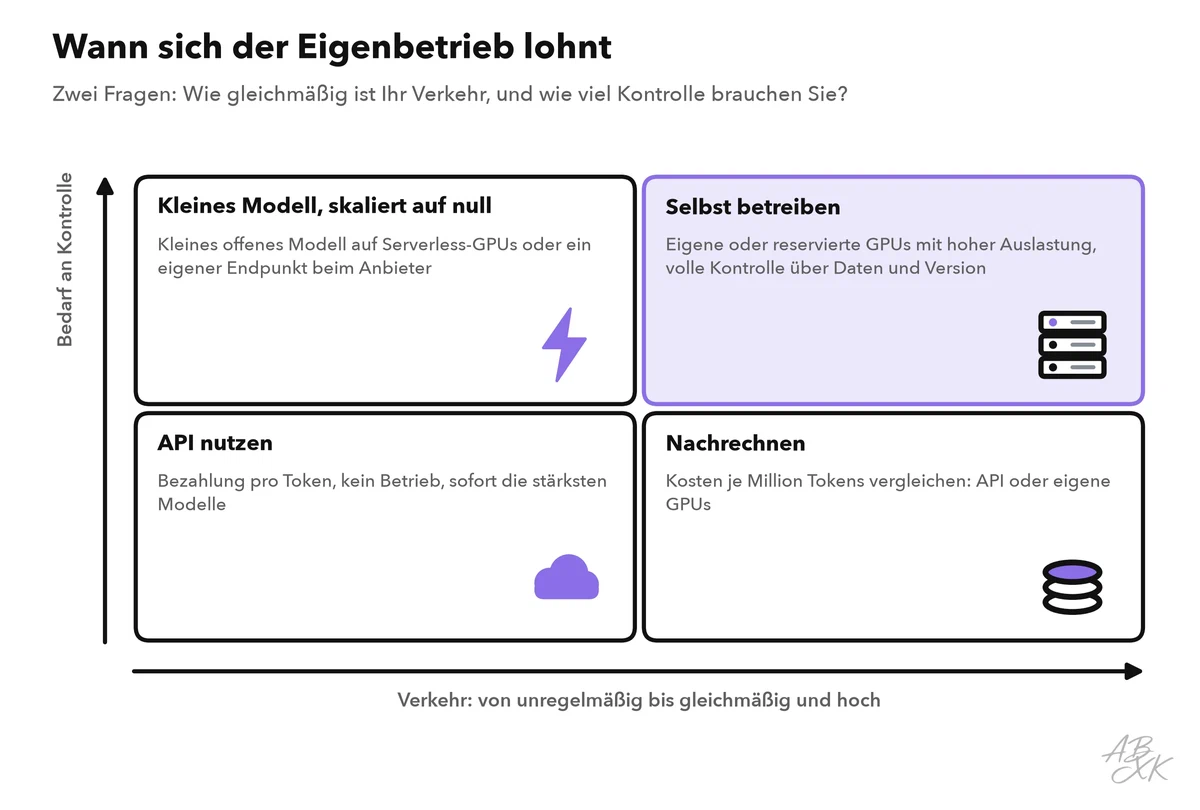
Teams betreiben Modelle aus fünf Gründen selbst:
- Datenhoheit. Prompts und Dokumente verlassen Ihr Netz nie. Das zählt bei Gesundheitsdaten, Rechtsakten und im öffentlichen Sektor.
- Versionshoheit. Das Modell ändert sich nur, wenn Sie es ändern. Kein Anbieter kann es abschalten oder sein Verhalten verändern.
- Anpassung. Sie können die Gewichte feintunen oder kleine Adapter je Aufgabe laden. Level 3 vergleicht Fine-Tuning, RAG und Prompting.
- Kosten bei Masse. Bei gleichmäßig hohem Verkehr erzeugt eine gut ausgelastete GPU Tokens günstiger als eine API. Bei unregelmäßigem Verkehr machen ungenutzte GPUs es teurer.
- Standort. Das Modell läuft dort, wo Sie es brauchen: im eigenen Haus, am Edge oder ganz ohne Internetverbindung.
Der Preis ist der Betrieb. Jemand muss Treiber aktualisieren, den Speicher überwachen, Lastspitzen abfangen und nachts auf Alarme reagieren. Und die stärksten Modelle in unseren Daten haben geschlossene Gewichte — für mehr Kontrolle geben Sie unter Umständen etwas Leistung ab.
Offene Gewichte sind nicht immer Open Source
„Offen“ beschreibt die Gewichte, nicht unbedingt Ihre Rechte. Die Open Source Initiative hat im Oktober 2024 ihre Open Source AI Definition 1.0 veröffentlicht. Sie verlangt mehr als die Gewichte: auch den Code und genaue Angaben zu den Trainingsdaten. Viele bekannte Open-Weight-Modelle erfüllen diese Definition nicht. Für Ihr Projekt zählt vor allem die Lizenz — und die Lizenzen unterscheiden sich stark:
- Übliche Open-Source-Lizenzen wie Apache 2.0 oder MIT erlauben die kommerzielle Nutzung mit wenigen Auflagen. Mistral 7B zum Beispiel erschien unter Apache 2.0, DeepSeek-R1 unter der MIT-Lizenz.
- Eigene Modell-Lizenzen fügen Bedingungen hinzu. Die Lizenz von Metas Llama 2 etwa verlangte von Unternehmen mit mehr als 700 Millionen monatlich aktiven Nutzern, bei Meta eine gesonderte Lizenz zu beantragen (Quelle: Meta, Llama 2 Community License, 2023). Viele eigene Lizenzen enthalten außerdem Nutzungsrichtlinien (Acceptable Use Policy).
- Forschungs- oder nichtkommerzielle Lizenzen schließen die kommerzielle Nutzung ganz aus.
Bevor ein Modell in Produktion geht, beantworten Sie diese Fragen — gemeinsam mit Ihrer Rechtsabteilung:
| Frage | Warum sie zählt |
|---|---|
| Ist kommerzielle Nutzung erlaubt? | Manche Gewichte sind nur für die Forschung freigegeben |
| Gibt es Schwellen für Nutzerzahlen oder Umsatz? | Wachstum kann eine neue Lizenz erfordern |
| Gibt es Nutzungsrichtlinien? | Sie verbieten bestimmte Einsätze und können sich ändern |
| Gibt es Regeln für Nennung oder Namen? | Ihr Produkt braucht vielleicht einen Hinweis oder eine Namensregel |
| Dürfen Sie feingetunte Fassungen weitergeben? | Abgeleitete Modelle können unter dieselbe Lizenz fallen |
| Dürfen Ausgaben andere Modelle trainieren? | Wichtig, wenn Sie Destillation planen |
Prüfen Sie die Lizenz jeder Version: Die Bedingungen können sich von einer Modellgeneration zur nächsten ändern.
Serving-Software: von den Gewichten zum Endpunkt
Gewichte sind nur große Dateien. Um sie bereitzustellen, brauchen Sie einen Stapel Software zwischen GPU und Ihren Apps:
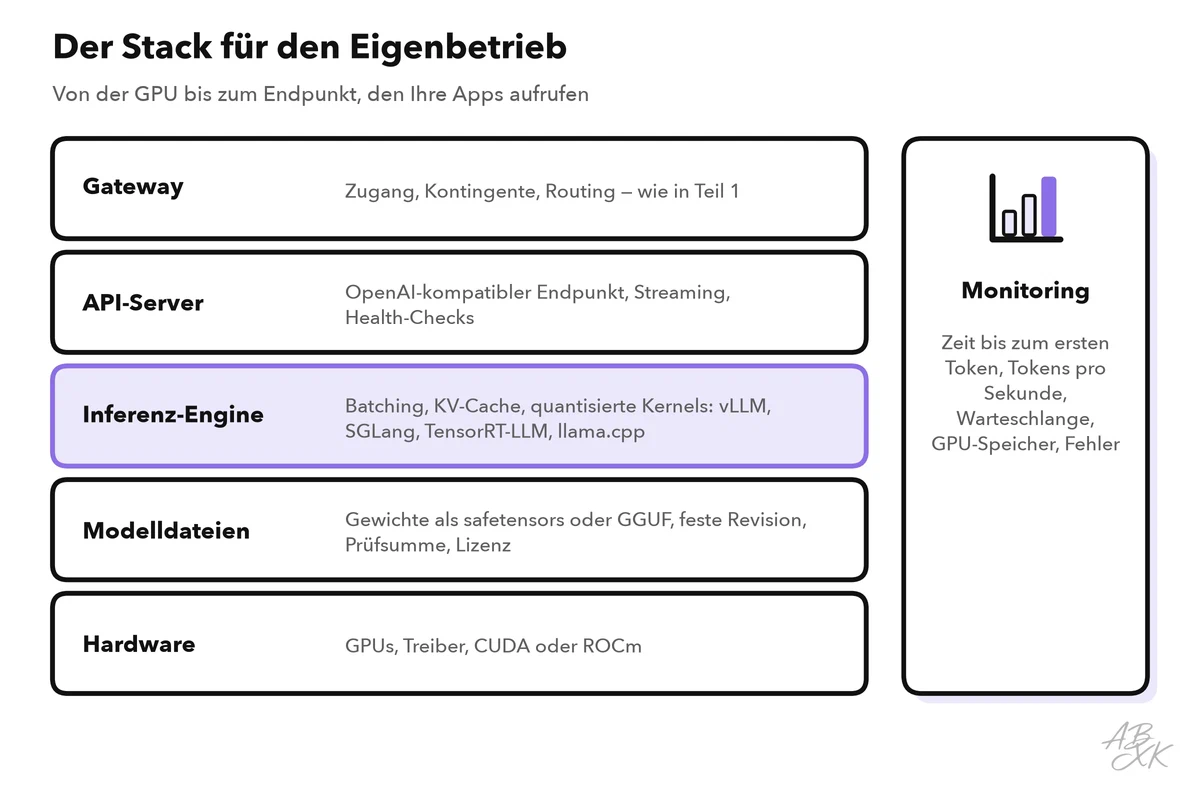
Herzstück ist die Inferenz-Engine. Bekannte Open-Source-Lösungen sind vLLM, SGLang und TensorRT-LLM von NVIDIA für GPU-Server sowie llama.cpp oder Ollama für Laptops und kleine Server. Mehrere davon bieten eine OpenAI-kompatible API, sodass das Gateway aus Teil 1 Ihr eigenes Modell wie jeden anderen Anbieter ansteuern kann. Gute Engines stützen sich auf einige Techniken; die ersten beiden kamen in Level 3 schon kurz vor:
- Continuous Batching: Neue Anfragen steigen bei jedem Generierungsschritt in den laufenden Stapel ein, statt zu warten, bis der ganze Stapel fertig ist. Die Idee stammt aus dem Orca-Paper (Yu et al., OSDI 2022).
- Seitenweiser KV-Cache: Die Engine verwaltet den Speicher für den KV-Cache in kleinen Seiten, wie den virtuellen Speicher eines Betriebssystems. Das spart Verschnitt und bringt mehr parallele Anfragen auf eine GPU (Kwon et al., „PagedAttention“, SOSP 2023, das Paper hinter vLLM).
- Präfix-Caching: Anfragen, die mit demselben Systemprompt beginnen, nutzen die dafür bereits geleistete Arbeit erneut.
- Tensor-Parallelismus: Ein Modell wird auf mehrere GPUs verteilt, wenn es nicht auf eine passt.
- Spekulatives Decoding: Ein kleines Entwurfsmodell schlägt mehrere Tokens vor, das große Modell prüft sie in einem Schritt (Leviathan et al., ICML 2023).
Behandeln Sie Modelldateien wie fremden Code. Bevorzugen Sie das Format safetensors: Es speichert nur Tensoren und einen kleinen Kopfbereich und kann beim Laden keinen Code ausführen, anders als ältere Pickle-Dateien von Python. Legen Sie die genaue Revision fest, und prüfen Sie Prüfsummen vor dem Deployment.
GPU-Speicher planen: Gewichte plus KV-Cache
Level 3 hat Ihnen die Faustregel für die Gewichte gegeben: Parameter × Bytes je Parameter. Im Betrieb entscheidet der KV-Cache, wie viele Nutzer eine GPU bedienen kann. Die Engine führt ihn für jede laufende Anfrage, und er wächst mit jedem Token:
KV-Cache je Token = 2 × Schichten × KV-Köpfe × Kopfgröße × Bytes je Wert
Nehmen Sie ein Beispielmodell mit 8 Milliarden Parametern, 32 Schichten und 8 Key-Value-Köpfen der Größe 128 in 16-Bit-Genauigkeit: 2 × 32 × 8 × 128 × 2 Byte ≈ 0,13 MB je Token. Eine Anfrage mit 8.192 Tokens Kontext braucht damit etwa 1,1 GB. Zweiunddreißig solcher Anfragen gleichzeitig brauchen etwa 34 GB — rund doppelt so viel wie die Gewichte.
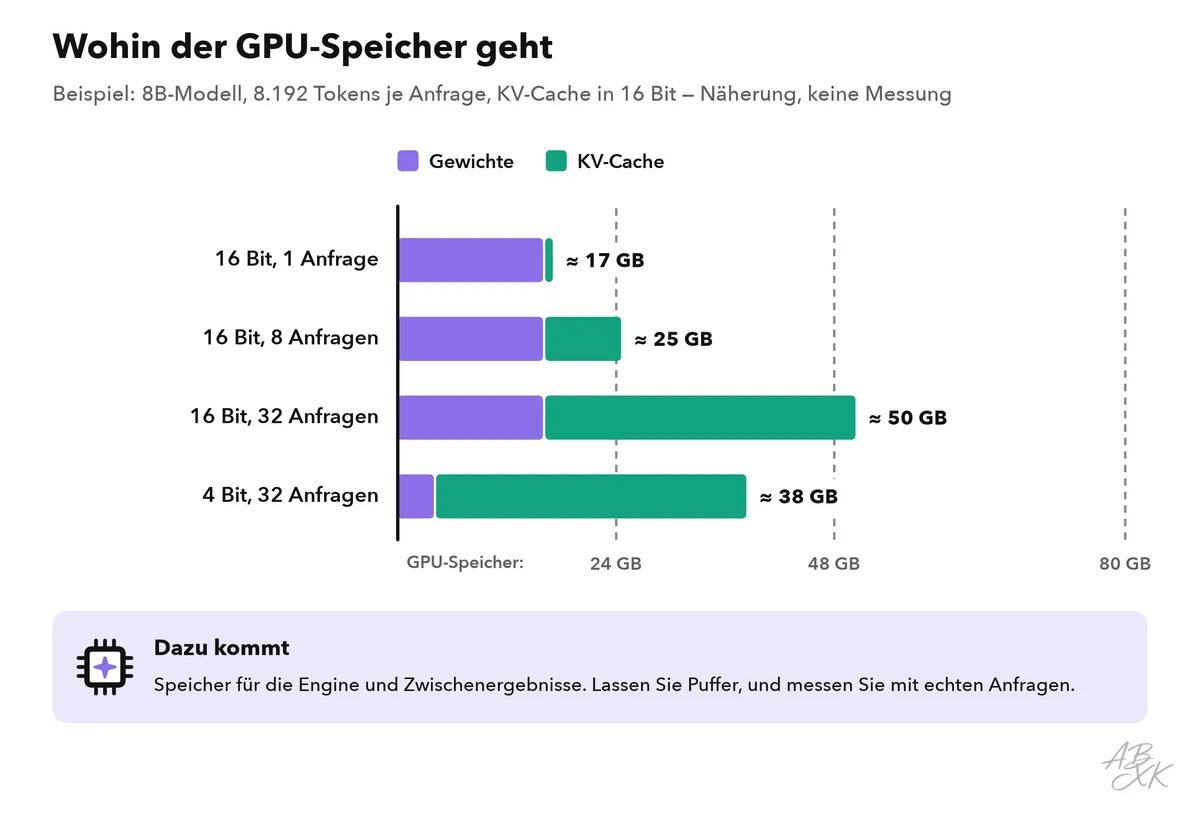
Drei Hebel senken den Speicherbedarf:
- Quantisierung speichert Gewichte mit weniger Bits. Verbreitete Verfahren sind GPTQ (Frantar et al., 2022) und AWQ (Lin et al., 2023) sowie das GGUF-Format von llama.cpp. Manche Engines können auch den KV-Cache in 8 Bit halten. Prüfen Sie die Qualität immer mit Ihrem eigenen Eval-Satz.
- Grouped-Query Attention (Ainslie et al., 2023) lässt mehrere Attention-Köpfe sich Key-Value-Köpfe teilen und verkleinert so den Cache. Sie ist Teil der Modellarchitektur — ein Blick in die Model Card verrät, ob ein Modell sie nutzt.
- Kürzere Kontexte helfen direkt: Eine Grenze für die Gesprächslänge ist zugleich eine Speichergrenze.
Mixture-of-Experts-Modelle (MoE) brauchen besondere Sorgfalt. DeepSeek-V3 zum Beispiel hat insgesamt 671 Milliarden Parameter, aktiv sind je Token aber nur 37 Milliarden (Quelle: DeepSeek-V3 Technical Report, 2024). Der Speicher muss alle aufnehmen, der Rechenaufwand je Token liegt dagegen näher an dem eines deutlich kleineren Modells.
Messen Sie dann: Zeit bis zum ersten Token, Tokens pro Sekunde je GPU und wie viele parallele Anfragen laufen, bevor Ihre Latenzziele reißen. Ein Lasttest mit echten Prompts beantwortet diese Fragen besser als jede Formel.
Der Abstand zur Spitze: was unsere Daten zeigen
Unsere LLM-Datenbank führt 172 Modelle mit offenen und 160 mit geschlossenen Gewichten. Das Diagramm vergleicht den besten Gesamtindex (ECI), den jede Gruppe zu jedem Zeitpunkt erreicht hatte:
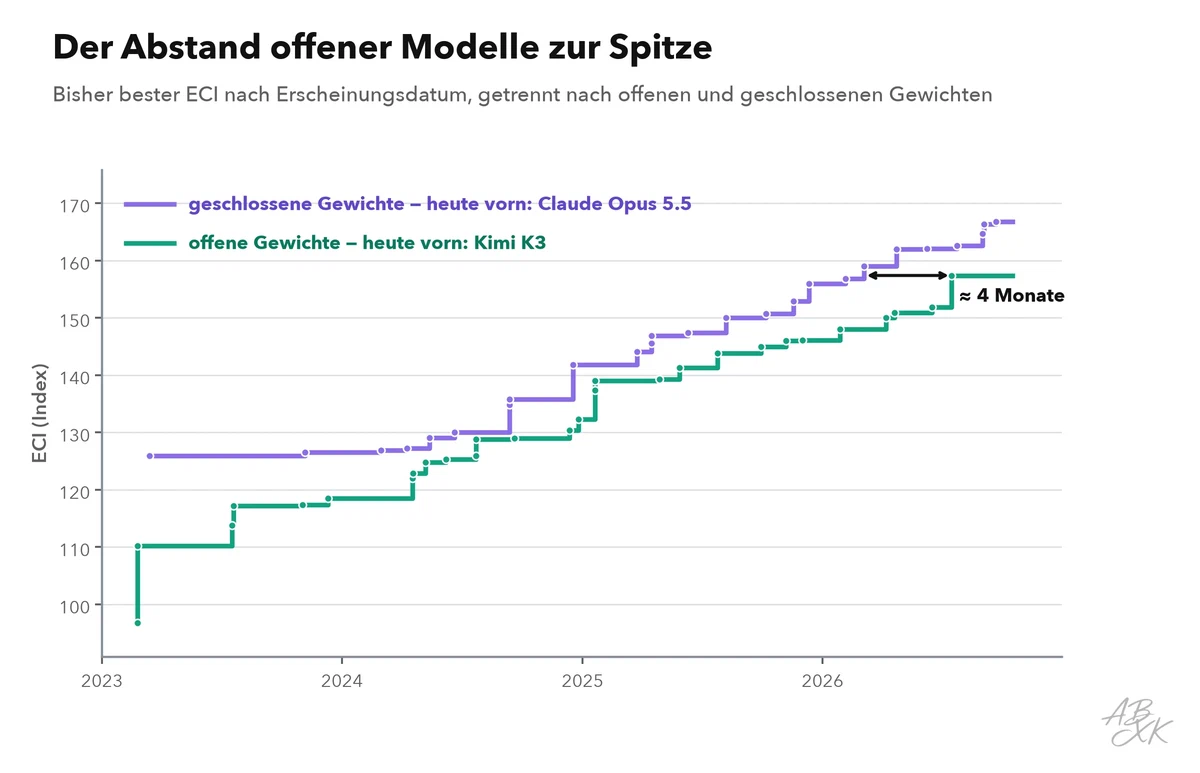
Beide Linien steigen, und die offene folgt der geschlossenen. Der Pfeil zeigt, wie viele Monate früher ein geschlossenes Modell erstmals das Niveau des heute besten offenen Modells erreicht hatte; zu anderen Zeitpunkten gemessen, schwankt dieser Abstand. Das sind einige der stärksten Modelle mit offenen Gewichten in unseren Daten:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Kimi K3 Moonshot | 16.07.2026 | offen | 157,4 | 17 |
| DeepSeek V4.1 Flash DeepSeek | 09.09.2026 | offen | 155,6 | 31 |
| DeepSeek V4 Pro 0813 DeepSeek | 13.08.2026 | offen | 155,3 | 32 |
| GLM-5.3-Flash Z.ai (Zhipu AI) | 20.08.2026 | offen | 153,2 | 45 |
| Qwen 3.8 27B Alibaba | 14.08.2026 | offen | 151,6 | 52 |


ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Lesen Sie den Index mit zwei Einschränkungen. Der ECI misst breite Fähigkeiten über viele Benchmarks; für eine enge Aufgabe wie Klassifizierung oder Extraktion aus Ihren eigenen Dokumenten kann ein kleineres offenes Modell völlig ausreichen. Und die größten offenen Modelle brauchen Server mit mehreren GPUs — prüfen Sie die Größe, bevor Sie Hardware planen. Alle Modelle und Filter finden Sie in unserer LLM-Datenbank.
Checkliste für den Betrieb
Ein Modell zu betreiben ist ein Dienst, kein Download. Planen Sie diese Punkte, bevor die erste Nutzerin kommt:
| Bereich | Was Sie einrichten |
|---|---|
| Zugang | Kein direkter Zugriff auf den Inferenz-Server; aller Verkehr über das Gateway; kein Internetzugang nach außen |
| Versionen | Eine festgelegte Modellrevision; neue Versionen erst nach bestandenen Evals |
| Skalierung | Autoscaling nach Länge der Warteschlange; Reserve, denn ein großes Modell zu laden dauert Minuten |
| Monitoring | Zeit bis zum ersten Token, Tokens pro Sekunde, Wartezeit, GPU-Speicher, Speicherüberläufe |
| Sicherheit | Eigene Eingangs- und Ausgabefilter — eine Schutzschicht des Anbieters gibt es nicht |
| Fallback | Ein API-Modell als Überlauf, wenn Ihre GPUs ausgelastet sind |
| Kosten | Kosten je Million Tokens = GPU-Kosten pro Stunde ÷ Millionen Tokens pro Stunde, bei echter Auslastung |
Vergleichen Sie die Kostenzeile jeden Monat mit derselben Arbeit über eine API; Teil 5 dieses Levels zeigt weitere Wege, Kosten und Latenz zu optimieren. Infrastruktur für diesen Aufbau finden Sie in unserem Vergleich. Nach Angaben der Anbieter ist Runpod eine GPU-Cloud für Training und Betrieb von Modellen mit Abrechnung nach Verbrauch. Plesk ist ein Kontrollpanel für die Server, auf denen die App rund um das Modell läuft. Pinecone ist eine Vektordatenbank für den Fall, dass Ihr Modell aus Ihren Dokumenten antwortet:


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Fangen Sie klein an: ein Modell, eine Aufgabe, eine GPU, mit einer API als Fallback. Verlagern Sie mehr Verkehr auf eigene Hardware erst, wenn Ihre Evals und der monatliche Kostenvergleich beide dafür sprechen.