

Ein Sprachmodell weiß nur, was in seinen Trainingsdaten stand. Ihre Preisliste, Ihr internes Wiki oder die Richtlinie, die sich letzte Woche geändert hat, kennt es nicht. Retrieval-Augmented Generation (RAG, abrufgestützte Textgenerierung) schließt diese Lücke. Bevor das Modell antwortet, sucht Ihre Anwendung die passendsten Passagen in Ihren eigenen Dokumenten und fügt sie dem Prompt hinzu. Das Modell antwortet dann auf Grundlage dieser Passagen und nennt seine Quellen.
Dies ist Teil 2 von Level 2. Er baut auf Embeddings und Vektordatenbanken aus Teil 1 auf. Sie gehen die ganze Pipeline Schritt für Schritt durch und erfahren, wo sie typischerweise bricht, wie Sie sie testen — und wann Sie RAG gar nicht brauchen.
Warum ein Modell Ihre Dokumente braucht
Drei Grenzen machen den Abruf nötig:
- Stichtag. Ein Modell lernt aus Daten bis zu einem bestimmten Datum. Was danach kam, kennt es nicht, solange Sie es nicht mitliefern.
- Kein internes Wissen. Ihre Verträge, Tickets und Produktdaten waren nie Teil seiner Trainingsdaten.
- Selbstsicheres Raten. Kennt ein Modell eine Tatsache nicht, erfindet es womöglich eine plausible Antwort. Das nennt man Halluzination.
Der letzte Punkt lässt sich messen. Der Benchmark SimpleQA Verified stellt kurze Faktenfragen mit genau einer richtigen Antwort, und die Modelle antworten ohne Werkzeuge oder Websuche. Selbst die besten Modelle unserer LLM-Datenbank beantworten nicht alle richtig:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Gemini 4 Argon (high) Google DeepMind | 30.09.2026 | 76,0 % |
| 2 | GPT-6 Astra (max) OpenAI | 03.09.2026 | 75,6 % |
| 3 | GPT-6.1 Sol (max) OpenAI | 29.09.2026 | 73,9 % |
| 4 | Gemini 3.1 Pro Preview Google DeepMind | 19.02.2026 | 73,5 % |
| 5 | Claude Opus 5.5 (max) Anthropic | 22.09.2026 | 72,2 % |



Kurze Faktenfragen mit genau einer richtigen Antwort, beantwortet ohne Hilfsmittel. Zeigt, wie viel ein Modell wirklich weiß — und wie oft es eine Antwort erfindet, statt Nichtwissen zuzugeben. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
RAG macht ein Modell nicht fehlerfrei. Aber es liefert dem Modell die Fakten, die es braucht, und es lässt Nutzer jede Antwort an ihrer Quelle prüfen. Beschrieben haben das Verfahren 2020 Forschende von Facebook AI Research (Quelle: Lewis et al., „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“, NeurIPS 2020, arxiv.org). Heute ist es eines der häufigsten Muster für Assistenten, die Fragen zu Unternehmensdokumenten beantworten.
Die Pipeline im Überblick
Ein RAG-System arbeitet in zwei Phasen. Das Indexieren läuft im Hintergrund, sobald sich Dokumente ändern: Sie laden die Dokumente, zerlegen sie in Chunks, betten die Chunks ein und speichern sie. Das Antworten läuft bei jeder Frage: Sie rufen passende Chunks ab, sortieren sie neu und lassen das Modell eine Antwort mit Quellenangaben schreiben.
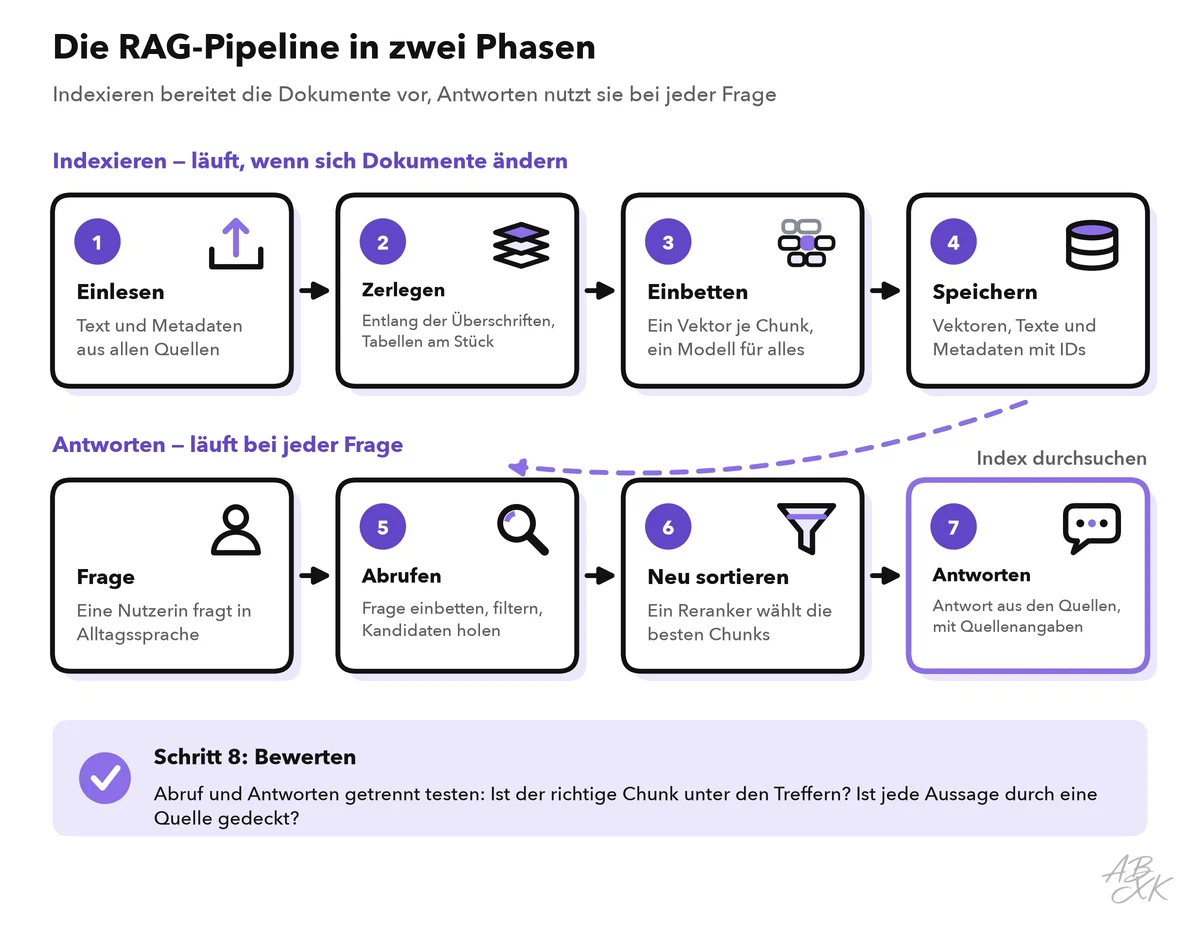
Die nächsten beiden Abschnitte gehen die sieben Schritte einzeln durch. Jeder Schritt hat eine Aufgabe und eigene typische Fehler. Die Bewertung, der achte Schritt, bekommt einen eigenen Abschnitt.
Indexieren: einlesen, zerlegen, einbetten, speichern
1. Einlesen. Sammeln Sie die Dokumente aus ihren Quellen: PDFs, Wiki-Seiten, Artikel aus dem Hilfe-Center, Tickets. Ziehen Sie sauberen Text heraus und entfernen Sie Kopfzeilen, Fußzeilen und Seitenzahlen, die sich auf jeder Seite wiederholen. Behalten Sie die Metadaten: Titel, Link oder Dateipfad, Datum, Verantwortliche und Zugriffsrechte. Lassen Sie Dubletten und veraltete Fassungen weg. Stehen zwei Fassungen einer Richtlinie im Index, zitiert das Modell womöglich die falsche.
2. Zerlegen. Teilen Sie jedes Dokument entlang seiner Struktur in Chunks: Überschriften, Absätze, Listenpunkte. Lassen Sie Tabellen am Stück und wandeln Sie sie in ein einfaches Format wie Markdown um, denn beim Auslesen von PDFs werden Tabellenzeilen oft zu einem Zahlensalat. Stellen Sie jedem Chunk Dokumenttitel und Überschrift voran. Wie Sie die Chunk-Größe wählen, erklärt Teil 1.
3. Einbetten. Wandeln Sie jeden Chunk mit einem Embedding-Modell in einen Vektor um. Nutzen Sie für Chunks und Fragen dasselbe Modell und speichern Sie den Modellnamen beim Index. Tausende Chunks einzubetten ist eine Stapelverarbeitung: Sie läuft einmal und danach nur noch für neue oder geänderte Dokumente.
4. Speichern. Schreiben Sie Vektoren, Chunk-Texte und Metadaten in Ihren Vektorspeicher, mit einer festen ID für jeden Chunk. Ändert sich ein Dokument, ersetzen Sie seine Chunks. Wird es gelöscht, löschen Sie sie ebenfalls.
Drei Tools aus unserem Vergleich passen zu diesen Schritten: eine verwaltete Vektordatenbank für Speicherung und Suche und eine Plattform für KI-Apps auf eigenen Daten. Das dritte ist ein Scraper ohne Code, der laut Anbieter Webseiten auf Änderungen überwacht. Er hilft, wenn Ihre Quellen öffentliche Seiten sind, die im Index aktuell bleiben müssen.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Antworten: abrufen, neu sortieren, generieren
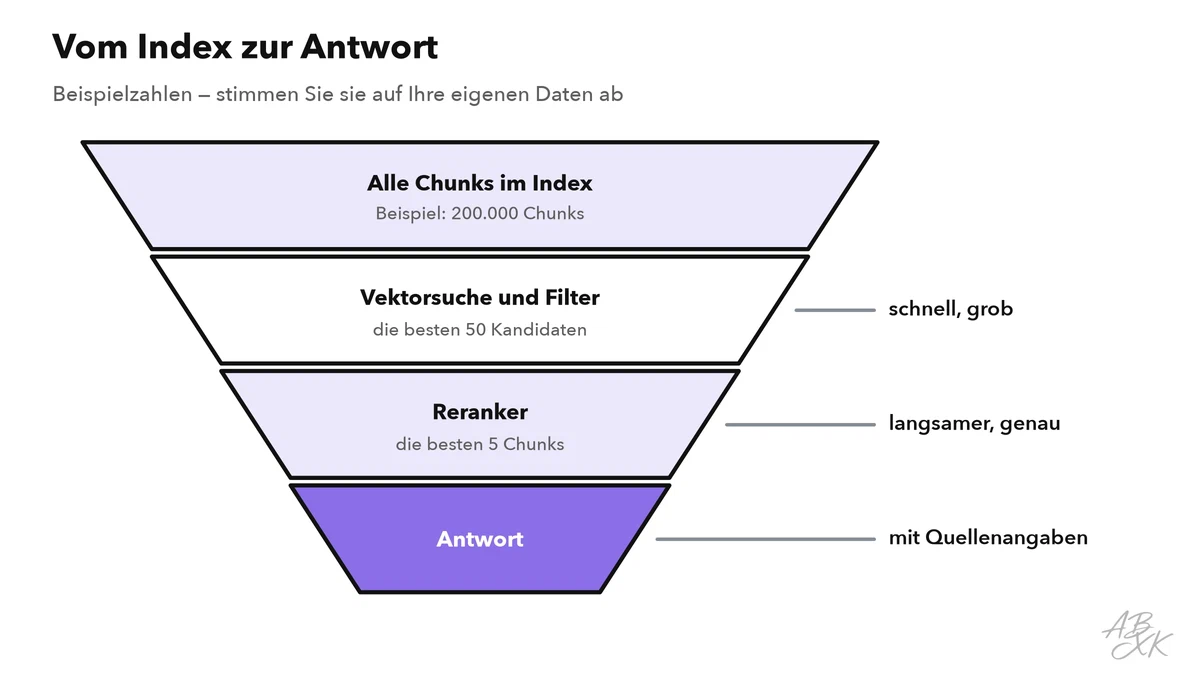
5. Abrufen. Betten Sie die Frage mit demselben Modell ein und suchen Sie im Index die nächstgelegenen Chunks. Holen Sie mehr Kandidaten, als Sie brauchen, zum Beispiel 20 bis 50. Wenden Sie Metadatenfilter vor oder während der Suche an: Sprache, Produkt, Datum und vor allem die Zugriffsrechte der Nutzerin. Zwei Techniken helfen oft:
- Hybride Suche verbindet Vektorsuche mit Stichwortsuche, sodass exakte Begriffe wie Produktcodes gefunden werden.
- Query Rewriting macht aus einer Anschlussfrage eine vollständige Frage. Im Chat bedeutet „Und in Deutschland?“ für sich genommen nichts. Ein kurzer Modellaufruf kann daraus vor der Suche „Wie lange ist die Rückgabefrist für Bestellungen in Deutschland?“ machen.
6. Neu sortieren. Vektorsuche ist schnell, aber grob. Ein Reranker ist ein zweites Modell, das Frage und Kandidaten-Chunk gemeinsam liest und bewertet, wie gut sie zusammenpassen. Das ist genauer, aber langsamer, deshalb sortieren Sie nur die Kandidaten aus Schritt 5 neu. Für den Prompt behalten Sie die besten wenigen, etwa drei bis acht Chunks.
7. Antworten mit Quellen. Jetzt bauen Sie den Prompt. Er enthält klare Regeln, die ausgewählten Chunks mit ihren IDs und die Frage der Nutzerin:
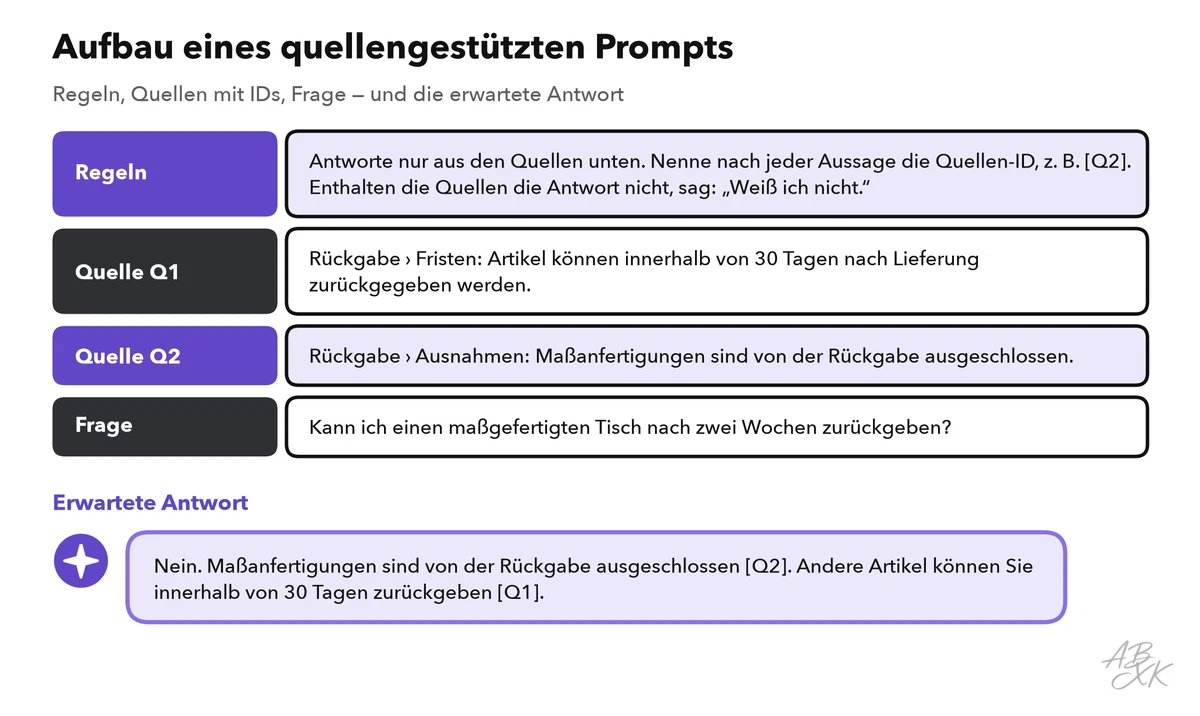
Drei Details machen den Unterschied:
- „Weiß ich nicht“ erlauben. Sagen Sie dem Modell, dass es das offen sagen soll, wenn die Quellen die Antwort nicht enthalten. Ohne diese Regel füllt es Lücken mit allgemeinem Wissen.
- Quellenangaben im Code prüfen. Jede ID, die das Modell zitiert, muss zu einem Chunk gehören, den Sie tatsächlich geschickt haben. Zeigen Sie die zitierten Passagen in Ihrer Oberfläche an, damit Nutzer die Antwort prüfen können.
- Die besten Chunks zuerst, den Prompt fokussiert halten. Sprachmodelle nutzen Informationen am Anfang und am Ende einer langen Eingabe meist besser als Informationen in der Mitte (Quelle: Liu et al., „Lost in the Middle: How Language Models Use Long Contexts“, 2023, arxiv.org).
Abruf und Antworten getrennt bewerten
Ist eine RAG-Antwort falsch, müssen Sie wissen, welcher Schritt versagt hat. Messen Sie die beiden Hälften deshalb getrennt:
- Abruf: Für jede Testfrage wissen Sie, welcher Chunk die Antwort enthält. Ist dieser Chunk unter den besten Treffern? Den Anteil der Fragen, bei denen das so ist, nennt man Trefferquote (Hit Rate) oder Recall@k.
- Antwort: Ist jede Aussage durch die zitierten Chunks gedeckt? Das nennt man Faithfulness (Quellentreue) oder Groundedness. Ist die Antwort richtig und vollständig? Und sagt das Modell „Weiß ich nicht“, wenn die Dokumente die Antwort nicht enthalten?
Versagt der Abruf, verbessern Sie Chunks, Filter oder Suche. Funktioniert der Abruf, sind die Antworten aber falsch, ändern Sie den Prompt oder probieren ein anderes Modell. Teil 4 dieses Levels zeigt, wie Sie solche Testsätze aufbauen und automatisch laufen lassen: KI-Funktionen mit Evals testen.
Typische Fehler und ihre Behebung
Die meisten RAG-Fehler entstehen, bevor das Modell ein einziges Wort schreibt. Die Abbildung zeigt sechs typische Fehler und den Schritt, in dem jeder beginnt:
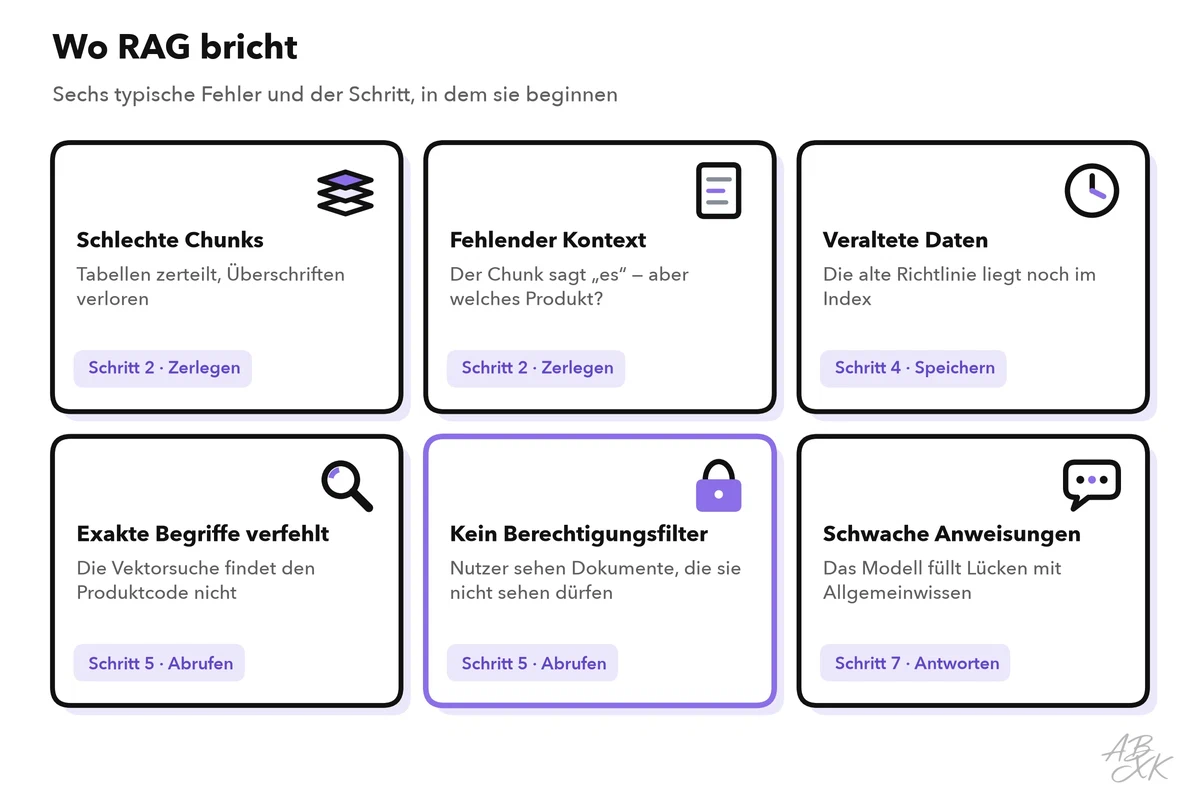
Die Tabelle macht daraus eine Anleitung zur Fehlersuche:
| Symptom | Wahrscheinliche Ursache | Behebung |
|---|---|---|
| Der Antwort fehlen Fakten, die in den Dokumenten stehen | Der richtige Chunk wurde nicht abgerufen | Hybride Suche, Query Rewriting, bessere Chunks |
| Die Antwort verwechselt Produkte oder Versionen | Chunks fehlt Kontext wie Titel oder Produktname | Titel und Überschrift in jeden Chunk; nach Produkt filtern |
| Die Antwort ist veraltet | Der Index wurde nicht aktualisiert; alte Fassungen liegen noch darin | Bei jeder Änderung neu indexieren; alte Fassungen löschen; Datum anzeigen |
| Zahlen aus Tabellen stimmen nicht | Tabellen wurden beim Auslesen zerteilt oder plattgedrückt | Tabellen ganz lassen; in Markdown umwandeln; mit Zahlenfragen testen |
| Das Modell antwortet aus allgemeinem Wissen | Schwache Anweisungen oder nichts Passendes abgerufen | Antworten nur aus den Quellen verlangen; Mindestwert für die Relevanz setzen |
| Nutzer sehen Inhalte, die sie nicht sehen dürfen | Kein Berechtigungsfilter beim Abruf | Nach den Rechten der Nutzer filtern, bevor das Modell Text sieht |
Wann Sie kein RAG brauchen
RAG bringt bewegliche Teile mit: einen Index, der aktuell bleiben muss, eine Suche, die abgestimmt werden will, Quellenangaben, die geprüft werden müssen. Prüfen Sie vor dem Bau, ob ein einfacherer Weg genügt:
| Situation | Besserer Weg |
|---|---|
| Das ganze Wissen passt in den Prompt, etwa ein zehnseitiges Handbuch, das sich selten ändert | Den ganzen Text in den Prompt geben; er passt problemlos ins Kontextfenster aktueller Modelle |
| Sie brauchen einen Stil, einen Ton oder ein Ausgabeformat, kein neues Wissen | Prompting mit Beispielen oder Fine-Tuning bei großen Mengen — der Entscheidungsleitfaden in Level 3 vergleicht beides |
| Die Antwort steht in einer Datenbank, etwa ein Bestellstatus oder Lagerbestände | Das Modell eine Funktion aufrufen lassen, die die Abfrage ausführt: siehe strukturierte Ausgabe und Function Calling |
| Fragen zu Allgemeinwissen | Das Modell allein oder ein Modell mit Websuche |
| Antworten müssen vollständig und exakt sein, etwa bei juristischen Prüfungen | RAG nur als Hilfe, mit menschlicher Prüfung jeder Antwort |