

Ein Prototyp ruft ein Modell mit einem API-Schlüssel auf, und es funktioniert. Ein Produktivsystem bedient Tausende Nutzer, hängt von Anbietern ab, die manchmal langsamer werden oder ausfallen, und muss im Budget bleiben. Den Unterschied macht nicht ein besserer Prompt, sondern die Architektur um das Modell herum: ein kontrollierter Zugang, Caches, Fallbacks, Guardrails und Ziele, die Sie messen können.
Dies ist Teil 1 von Level 4 (Experte) im Lernpfad AI Development. Sie sehen eine Referenzarchitektur, erfahren, was jede Komponente leistet und was sie kostet, und erhalten am Ende eine Checkliste für den Go-live. Der Teil baut auf Observability für LLM-Apps aus Level 3 auf: Betreiben können Sie nur, was Sie sehen.
Eine Referenzarchitektur für LLM-Apps
Die meisten LLM-Systeme im Betrieb landen bei einer ähnlichen Form. Apps rufen Modellanbieter nicht direkt auf. Jede Anfrage läuft durch ein LLM-Gateway (auch AI-Gateway oder Modell-Proxy genannt): einen Dienst zwischen Ihren Apps und allen Modellen. Er prüft, wer anfragt, wendet Limits an, schaut in Caches nach, wählt ein Modell, prüft die Antwort und schreibt das Protokoll.
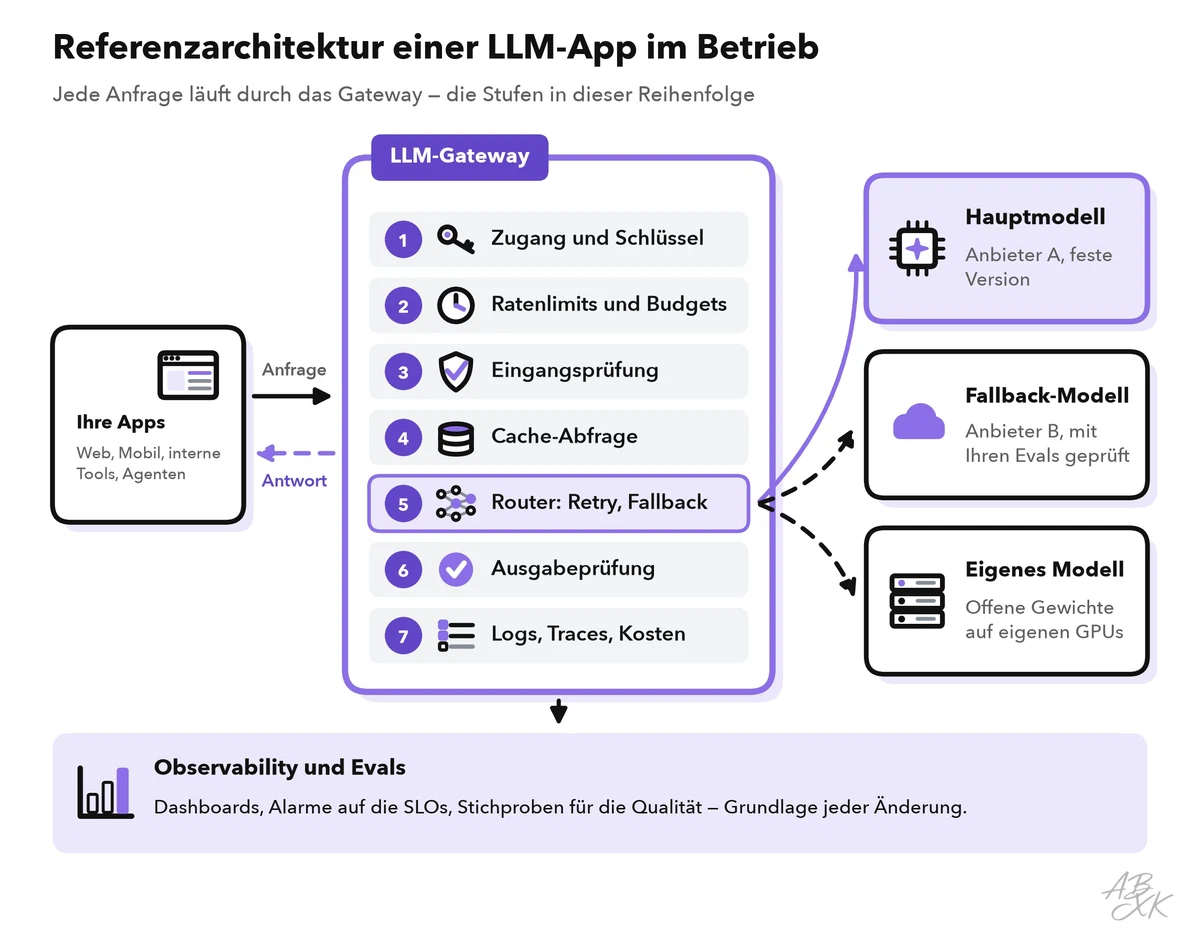
Jede Komponente verhindert eine bestimmte Art von Fehler, und zu jeder gehört eine Kennzahl, die Sie beobachten sollten:
| Komponente | Aufgabe | Verhindert | Kennzahl im Blick |
|---|---|---|---|
| Zugang und Schlüssel | Interne Schlüssel für Apps; Anbieterschlüssel bleiben im Gateway | Abgeflossene Schlüssel, unklare Nutzung | Anfragen je App und Nutzer |
| Ratenlimits und Budgets | Kontingente je Nutzer, Team und Anbieter | Ausufernde Kosten, gesperrte Konten | Abgewiesene Anfragen, Ausgaben pro Tag |
| Cache | Nutzt Antworten oder verarbeitete Prompts erneut | Doppelt bezahlte Arbeit | Trefferquote, Fehltreffer |
| Router und Fallbacks | Wählt das Modell, wiederholt, wechselt den Anbieter | Ausfälle, hängende Anfragen | Fehler und Fallback-Anteil je Anbieter |
| Guardrails | Prüfen Eingabe, Ausgabe und Tool-Aufrufe | Datenabfluss, kaputte Formate | Blockquote, Schemafehler |
| Logs und Evals | Traces, Kosten, Qualitätsstichproben | Unbemerkten Qualitätsverlust | Qualitätswert, Kosten je Aufgabe |
Keiner dieser Bausteine braucht eine besondere Plattform. Das Gateway ist ein kleiner, zustandsloser Dienst auf Ihrem normalen Hosting. Betreiben Sie mindestens zwei Instanzen, damit es nicht selbst zum einzelnen Ausfallpunkt wird. Ein semantischer Cache braucht einen Vektorspeicher, ein selbst betriebenes Fallback-Modell braucht GPUs. In unserem Vergleich hostet Netlify nach Angaben des Anbieters Web-Apps, Pinecone ist eine Vektordatenbank für Suche und Retrieval, und Runpod vermietet GPU-Rechenleistung nach Verbrauch:


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Das Gateway: eine Tür zu allen Modellen
Ohne Gateway kopiert jedes Team Anbieterschlüssel in seinen Code und schreibt eigene Wiederholungslogik. Niemand kennt die Gesamtkosten, und ein neuer Anbieter bedeutet Änderungen in jeder App. Ein Gateway löst das an einer Stelle:
- Eine Schnittstelle. Apps senden ein einheitliches Anfrageformat, das Gateway übersetzt es für jeden Anbieter. Viele Gateways und Modellserver verstehen das Chat-Format von OpenAI; ein neues Modell wird so zur Konfigurationsänderung.
- Schlüssel und Zugang. Apps erhalten interne Schlüssel mit eigenen Rechten. Anbieterschlüssel verlassen das Gateway nie und kommen aus der Umgebung oder einem Secret-Manager.
- Routing-Regeln. Regeln wählen das Modell nach Aufgabe, Kunde oder Region — zum Beispiel gehen Kundendaten aus der EU nur an Endpunkte in der EU.
- Messung. Das Gateway zählt Eingabe- und Ausgabetokens je App, Team und Funktion. Aus einer großen Rechnung werden Kosten, die Sie zuordnen können.
- Ein Protokollformat. Jede Anfrage bekommt eine Trace-ID, die Modellversion und die Prompt-Version.
Der Preis ist ein zusätzlicher Netzwerkschritt. Er kostet meist Millisekunden, während eine Modellantwort Sekunden dauert. Messen Sie ihn trotzdem am 95. Perzentil (p95: der Wert, unter dem 95 Prozent der Anfragen bleiben). Streaming muss ungepuffert durch das Gateway laufen, sonst verlieren Nutzer seinen wichtigsten Vorteil.
Caching: exakter, semantischer und Prompt-Cache
Der günstigste Modellaufruf ist der, den Sie nicht machen. Drei Arten von Caches arbeiten auf unterschiedlichen Ebenen und bringen unterschiedliche Risiken mit:
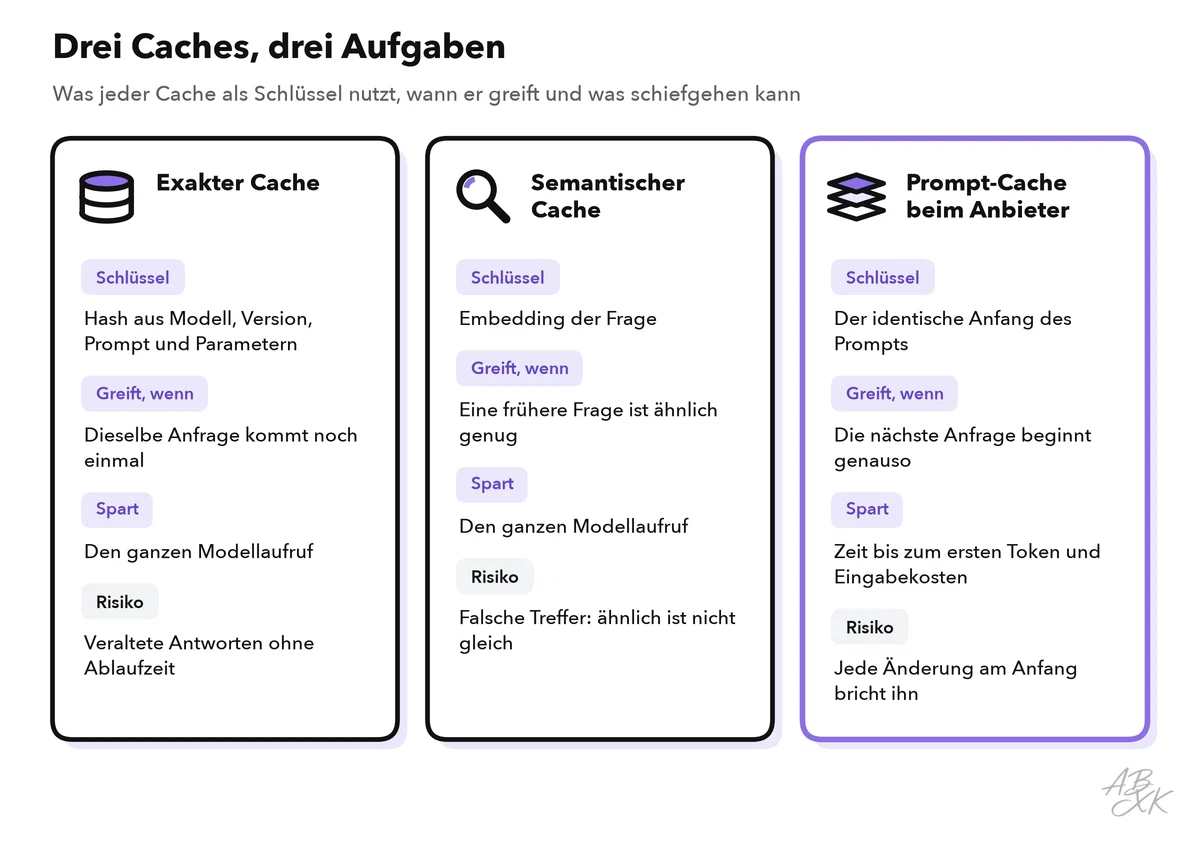
- Ein exakter Cache speichert die ganze Antwort unter einem Hash aus Modell, Modellversion, Prompt und Parametern. Er greift nur, wenn genau dieselbe Anfrage noch einmal kommt: ein FAQ-Knopf, ein Klassifizierungsjob, der erneut läuft, eine Testsuite. Geben Sie Einträgen eine Ablaufzeit, und leeren Sie sie, wenn sich die zugrunde liegenden Dokumente ändern.
- Ein semantischer Cache vergleicht die Bedeutung einer neuen Frage mit früheren Fragen über Embeddings und liefert oberhalb eines Ähnlichkeitsschwellenwerts die gespeicherte Antwort. Er trifft öfter — und kann sich irren. „Wie storniere ich meine Bestellung?“ und „Wie kündige ich mein Abo?“ liegen in der Bedeutung nah beieinander, brauchen aber verschiedene Antworten. Setzen Sie ihn nur für allgemeine Antworten ein, wählen Sie einen strengen Schwellenwert, und prüfen Sie eine Stichprobe der Treffer von Hand.
- Prompt-Caching geschieht beim Anbieter. Mehrere APIs halten den bereits verarbeiteten Anfang eines Prompts — das Präfix — für kurze Zeit vor. Beginnt die nächste Anfrage mit genau demselben Präfix, wird dieser Teil schneller verarbeitet und günstiger abgerechnet. Stellen Sie Gleichbleibendes an den Anfang (Systemprompt, Tool-Definitionen, Beispiele, lange Dokumente) und Wechselndes ans Ende. Ein Zeitstempel ganz oben im Prompt bricht den Cache bei jeder Anfrage.
Teil 5 dieses Levels zeigt, wie Caching, Batching und Modell-Routing zusammenspielen, um Kosten und Latenz zu optimieren.
Timeouts, Wiederholungen und Fallbacks
Modell-APIs scheitern auf zwei Arten: laut, mit einem Fehlercode, und leise, indem sie hängen. Planen Sie für beides mit einer Frist (Deadline) je Anfrage — der längsten Zeit, die eine Nutzerin warten soll —, und teilen Sie sie auf alle Versuche auf:
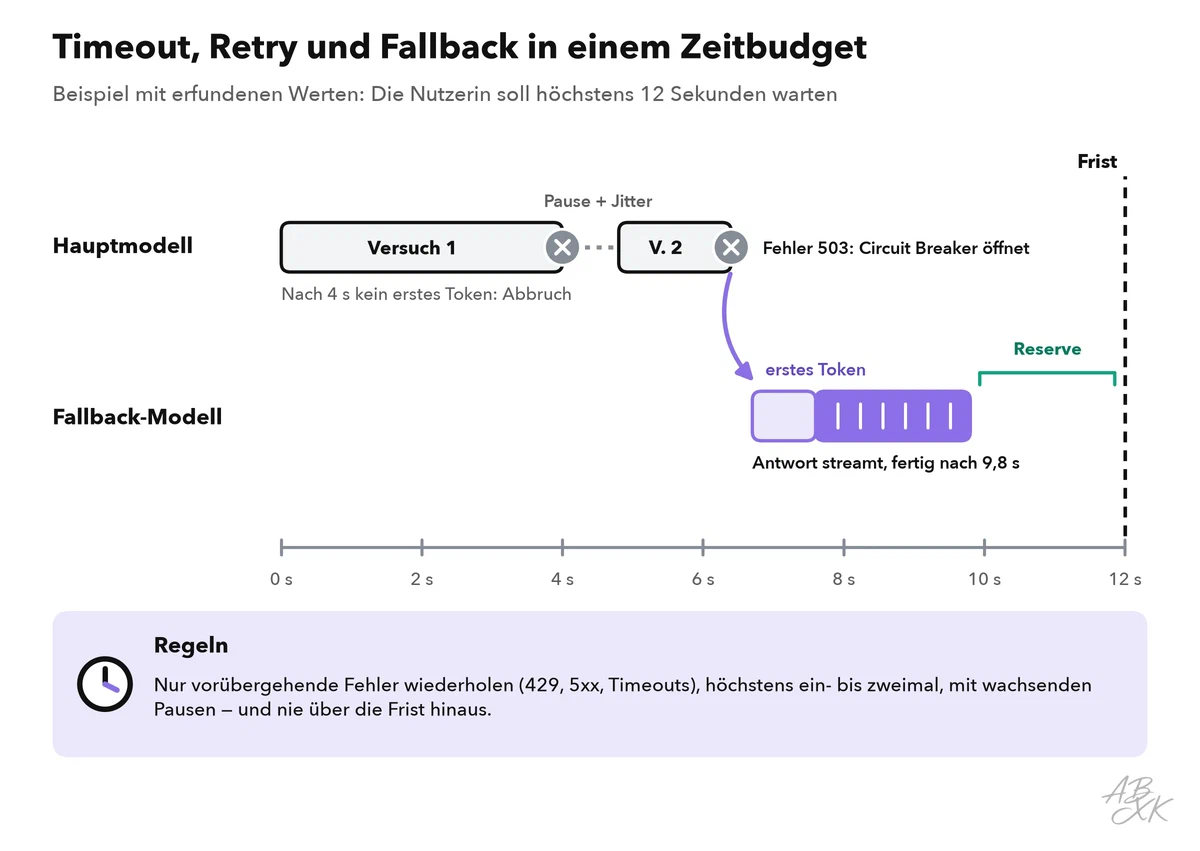
- Timeouts. Beim Streaming ist die Zeit bis zum ersten Token (Time to First Token, TTFT) das nützlichste Signal. Kommt nach einigen Sekunden kein Token, hängt die Anfrage vermutlich — und es bleibt noch Zeit, das Modell zu wechseln.
- Wiederholungen. Wiederholen Sie nur vorübergehende Fehler: HTTP 429 (zu viele Anfragen), 500, 502, 503, 504, Timeouts und Netzwerkfehler. Einen Fehler 400 wiederholen Sie nie unverändert. Warten Sie nach jedem Versuch länger, und fügen Sie einen Zufallsanteil hinzu, den Jitter, damit nicht Tausende Clients im selben Moment erneut anfragen (Quelle: AWS Architecture Blog, „Exponential Backoff and Jitter“, 2015). Schickt der Anbieter einen
Retry-After-Header, halten Sie sich daran. - Budgets für Wiederholungen. Bei einem Ausfall vervielfachen Wiederholungen die Last auf einem System, das ohnehin kämpft. Das SRE-Buch von Google erlaubt höchstens drei Versuche je Anfrage und Wiederholungen nur, solange sie unter 10 Prozent der Anfragen eines Clients bleiben (Quelle: Google, „Site Reliability Engineering“, Kapitel „Handling Overload“, 2016, sre.google).
- Circuit Breaker. Nach wiederholten Fehlern schickt das Gateway für eine Abkühlphase keinen Verkehr mehr an einen Anbieter und lässt dann einzelne Testanfragen durch. Bekannt wurde das Muster durch Michael Nygards Buch „Release It!“ (2007).
Ein Fallback-Modell übernimmt, wenn das Hauptmodell ausfällt. Wählen Sie eines von einem anderen Anbieter — ein Ausfall trifft selten zwei Anbieter gleichzeitig — mit ähnlicher Leistungsfähigkeit. Unsere LLM-Datenbank hilft bei der Suche. Zur Veranschaulichung, nicht als Empfehlung, hier eine Kette aus zwei starken Modellen verschiedener Anbieter, einer leichteren Modellstufe für einen eingeschränkten Betrieb und einem Modell mit offenen Gewichten, das Sie selbst betreiben könnten:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Claude Sonnet 5.5 Anthropic | 28.09.2026 | geschlossen | 164,4 | 6 |
| GPT-6 Sol OpenAI | 22.09.2026 | geschlossen | 162,6 | 8 |
| Gemini 3.8 Flash Google DeepMind | 02.09.2026 | geschlossen | 157,2 | 19 |
| DeepSeek V4.1 Flash DeepSeek | 09.09.2026 | offen | 155,6 | 31 |



ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Ein Fallback hilft nur, wenn er mit Ihren Prompts funktioniert. Lassen Sie Ihren Eval-Satz über jedes Fallback-Modell laufen, bevor Sie sich darauf verlassen, prüfen Sie strukturierte Ausgaben erneut, und führen Sie bei Bedarf eine eigene Prompt-Version je Modell. Ein Modell, das Sie selbst betreiben, kann als letzte Verteidigungslinie dienen; Teil 2 dieses Levels erklärt, wie Sie Modelle mit offenen Gewichten selbst betreiben. Fällt alles aus, bauen Sie kontrolliert ab: Zeigen Sie eine gespeicherte Antwort, bieten Sie eine einfachere Funktion an, oder sagen Sie ehrlich, dass die Funktion gerade nicht verfügbar ist.
Ratenlimits, Streaming und Guardrails
Ratenlimits wirken in zwei Richtungen. Anbieter begrenzen Sie, meist in Anfragen und Tokens pro Minute, und antworten mit HTTP 429, wenn Sie darüber liegen. Begrenzen sollten Sie aber auch Ihre eigenen Nutzer. Ein verbreitetes Verfahren ist der Token-Bucket: Jeder Nutzer hat einen Eimer, der sich mit fester Rate wieder füllt, und jede Anfrage entnimmt etwas daraus. Ist der Eimer leer, folgt eine 429-Antwort mit Retry-After-Header. Ergänzen Sie tägliche Token-Budgets je Nutzer und eine harte Obergrenze für Ausgabetokens. Die OWASP Top 10 für LLM-Anwendungen (2025) führen dieses Risiko als „Unbounded Consumption“: unbegrenzter Verbrauch, der die Kosten treibt oder den Dienst überlastet.
Streaming schickt die Antwort Token für Token, meist als Server-Sent Events. Nutzer sehen die ersten Wörter nach einem Augenblick, statt auf den ganzen Text zu warten. Kosten spart Streaming nicht, und es erschwert zwei Dinge. Erstens müssen Ausgabeprüfungen mit Teiltext arbeiten: Prüfen Sie in Abschnitten, oder halten Sie den ersten Satz zurück, bis eine schnelle Prüfung bestanden ist. Zweitens ist ein Fallback nur vor dem ersten Token einfach — danach hat die Nutzerin schon einen Teil der Antwort gesehen. Brechen Sie die Generierung ab, wenn jemand die Seite verlässt; sonst bezahlen Sie Tokens, die niemand liest.
Guardrails sind Prüfungen rund um das Modell. Eingangsprüfungen begrenzen die Länge, entfernen personenbezogene Daten, wo möglich, und suchen nach Prompt Injection, die auf der OWASP-Liste an erster Stelle steht. Ausgabeprüfungen validieren das Schema, blockieren Regelverstöße und suchen nach abgeflossenen Daten. Tool-Aufrufe durchlaufen in Ihrem Code eine Rechteprüfung. Unser Bereich AI Security erklärt die Angriffe hinter diesen Regeln.
Versionen, Releases und SLOs
Ein Modell hinter einem Alias wie „latest“ kann sich ohne Ankündigung ändern — und mit ihm Ihre Ergebnisse. Legen Sie datierte Modellversionen fest, wo der Anbieter sie anbietet, führen Sie Prompts und Konfiguration in Git, und schreiben Sie alle drei in jeden Trace. Dann behandeln Sie eine Modell- oder Prompt-Änderung wie ein Code-Release:
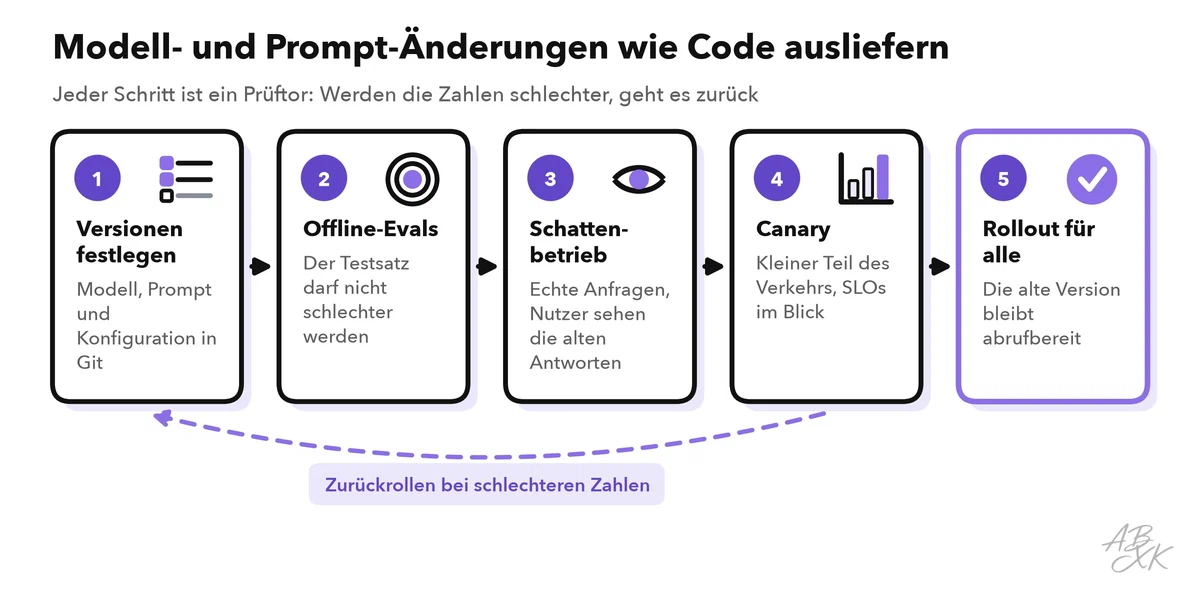
Ihre Evals sind das erste Prüftor: Eine Änderung geht nur live, wenn Ihr Testsatz nicht schlechter wird. Level 2 zeigt, wie Sie KI-Funktionen mit Evals testen. Im Schattenbetrieb (Shadow Mode) beantwortet die neue Version echte Anfragen, Nutzer sehen aber weiter die alten Antworten. Ein Canary-Release schickt danach einen kleinen Teil des Verkehrs an die neue Version, während Sie Ihre Ziele beobachten.
Diese Ziele stammen aus dem Site Reliability Engineering. Ein Service Level Indicator (SLI) ist das, was Sie messen, ein Service Level Objective (SLO) ist das Ziel, und das Fehlerbudget ist das Maß an Fehlern, das dieses Ziel noch zulässt (Quelle: Google, „Site Reliability Engineering“, 2016, sre.google). LLM-Apps brauchen neben den klassischen Zielen auch Ziele für Qualität und Kosten. Die Werte unten sind Beispiele; legen Sie Ihre eigenen anhand von Basismessungen fest:
| SLI | Beispiel-SLO | Eine Verletzung deutet oft auf |
|---|---|---|
| Anfragen mit gültiger Antwort | 99,5 % über 30 Tage | Anbieterausfälle, defekte Fallbacks |
| Zeit bis zum ersten Token, p95 | unter 2 Sekunden | Überlast, langsames Modell, lange Prompts |
| Gesamtdauer, p95 | unter 10 Sekunden | Wiederholungen, zu viele Tool-Schritte |
| Stichproben mit akzeptabler Antwort | mindestens 90 % pro Woche | Modellwechsel, veraltete Dokumente, Drift |
| Kosten je erfolgreicher Aufgabe | im Budget | Längere Prompts, mehr Wiederholungen, falsches Routing |
Messen Sie die Qualität laufend. Lassen Sie einen kleinen Teil des echten Verkehrs von einem LLM-Bewerter oder einem Menschen prüfen, werten Sie Nutzerfeedback aus, und richten Sie einen Alarm ein, wenn das Fehlerbudget schneller aufgebraucht wird als geplant.
Checkliste vor dem Go-live
Nutzen Sie diese Liste in Ihrer Freigaberunde. Jedes „Nein“ ist ein Risiko, das jemand bewusst tragen sollte:
- Anbieterschlüssel liegen nur im Gateway, und jede App hat ihren eigenen internen Schlüssel.
- Es gibt Kontingente je Nutzer und Team, und Budgetwarnungen erreichen einen Menschen.
- Jede Anfrage hat eine Frist, einen TTFT-Timeout und höchstens ein bis zwei Wiederholungen mit Backoff und Jitter.
- Das Fallback-Modell hat denselben Eval-Satz bestanden wie das Hauptmodell, und ein Circuit Breaker ist eingerichtet.
- Cache-Schlüssel enthalten Modellversion, Prompt-Version und Nutzerkreis, und jeder Eintrag läuft ab.
- Eingangs- und Ausgabeprüfungen laufen, und strukturierte Ausgaben werden validiert.
- Modell- und Prompt-Versionen sind festgelegt und stehen in jedem Trace.
- Die SLOs haben Alarme, und die Person in Rufbereitschaft weiß, wie man zurückrollt.
- Ein Lasttest mit realistischen Prompts, auch mit langen Kontexten, lief über der erwarteten Spitzenlast.
- Sie haben den Hauptanbieter in einer Testumgebung abgeschaltet und zugesehen, wie das Fallback übernimmt.
Den letzten Test lassen Teams oft aus. Wiederholen Sie ihn nach jeder größeren Änderung: Ein Fallback, das nie gelaufen ist, scheitert meist genau an dem Tag, an dem Sie es brauchen.