

Im Prototyp schaut niemand auf die Rechnung oder die Uhr. Im großen Maßstab entscheiden beide darüber, ob eine Funktion bleibt: Kleine Kosten je Anfrage werden zu einem großen Monatsposten, und eine langsame Antwort lässt jede Nutzerin warten. Die meisten LLM-Apps verschwenden Tokens und Zeit an denselben wenigen Stellen — deshalb helfen fast überall dieselben wenigen Hebel.
Dies ist Teil 5 von Level 4 (Experte), der letzte Teil unseres Lernpfads AI Development. Sie erfahren, woher Kosten und Latenz kommen, wie Sie die Kosten je erfolgreicher Aufgabe messen, welche Hebel Tokens und Wartezeit sparen und wie eine Routing-Kaskade einfache Anfragen an kleine Modelle schickt. Unser Artikel darüber, wie wir KI-Entwicklungskosten senken, behandelt die Phase des Bauens; dieser Teil behandelt die laufenden Kosten jeder Anfrage.
Wohin Kosten und Zeit in einer Anfrage gehen
APIs rechnen nach Tokens ab, mit einem Satz für die Eingabe und meist einem höheren für die Ausgabe. Viele Reasoning-Modelle erzeugen zusätzlich verborgene Reasoning-Tokens, die in der Regel als Ausgabe abgerechnet werden. Die Zeit folgt einer anderen Logik. Bevor das erste Wort erscheint, liest das Modell die gesamte Eingabe; diese Phase heißt Prefill und bestimmt die Zeit bis zum ersten Token (Time to First Token, TTFT). Danach schreibt es die Antwort Token für Token. Die Zeit je Ausgabetoken (Time per Output Token, TPOT) mal die Zahl der Ausgabetokens macht meist den größten Teil der Gesamtzeit aus.
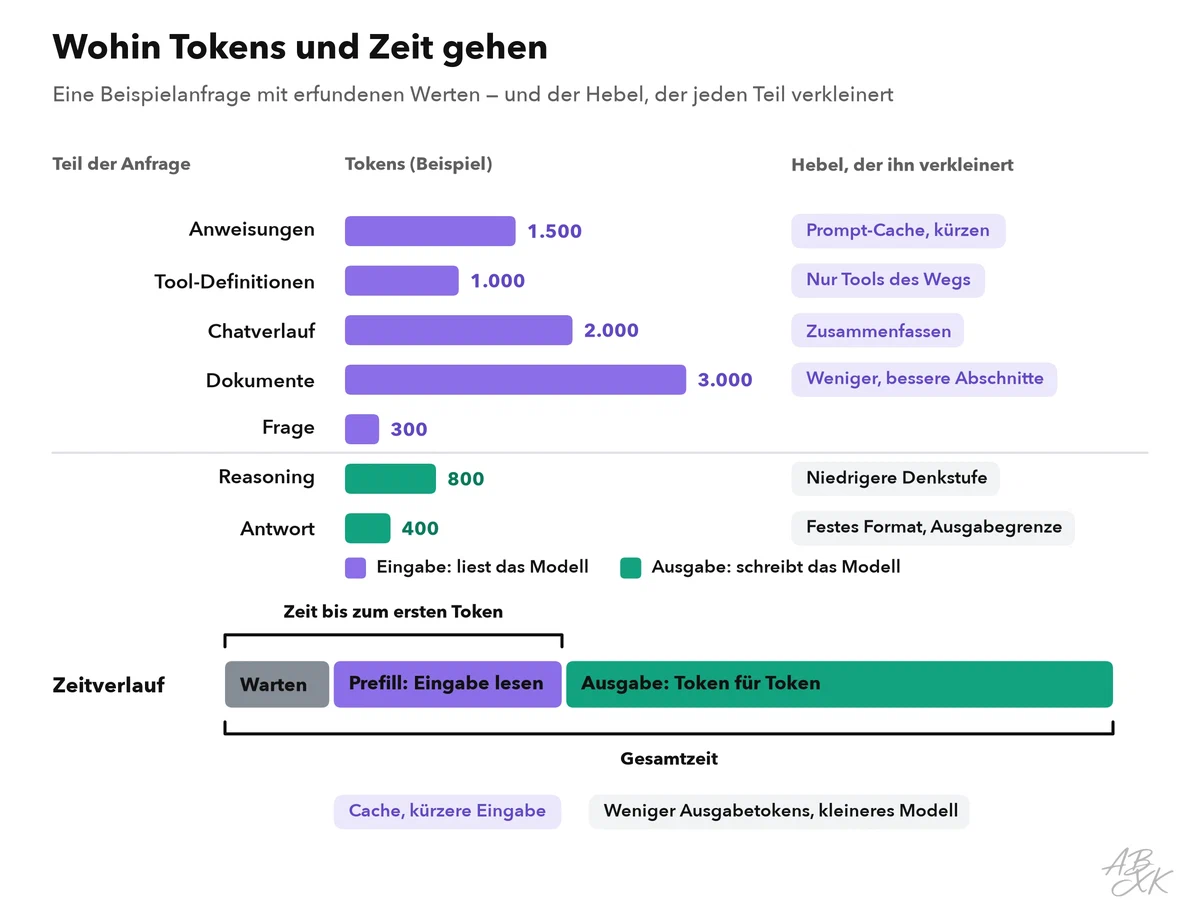
Daraus folgt eine Faustregel: Eingabetokens machen oft den größten Teil der Menge aus, Ausgabetokens den größten Teil der Wartezeit. Der Support-Bot aus Level 0 zeigt die erste Hälfte: Er liest neunmal so viele Tokens, wie er schreibt, meist dieselben Anweisungen und Hilfetexte in jeder Anfrage (siehe APIs, Tokens und Kontextfenster).
Die Kosten je erfolgreicher Aufgabe messen
Bevor Sie etwas ändern, messen Sie eine Basislinie. Der Preis je Token oder je Anfrage ist die falsche Einheit, denn er verbirgt Wiederholungen, Agenten-Schleifen und misslungene Antworten. Die nützliche Einheit sind die Kosten je erfolgreicher Aufgabe: alle Ausgaben für eine Funktion — Modellaufrufe, Wiederholungen, Tool-Aufrufe, Aufrufe eines Bewerters — geteilt durch die Zahl der Aufgaben, die Ihre Qualitätskriterien erfüllt haben. Verfolgen Sie diese Zahl zusammen mit der Erfolgsquote und der p95-Latenz, je Funktion und je Modellversion, und legen Sie eine Mindest-Erfolgsquote fest, die jede Variante erreichen muss.
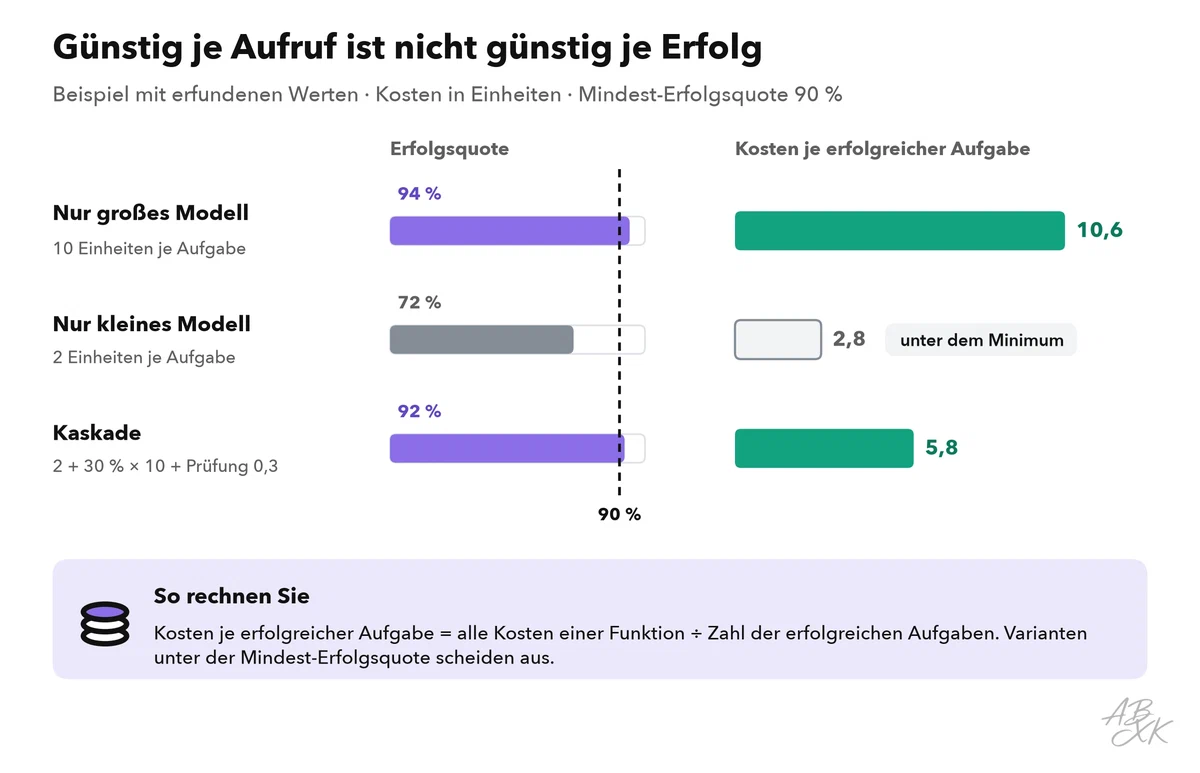
Das Beispiel zeigt zwei Fallen. Das große Modell allein erreicht die Mindest-Erfolgsquote, kostet aber je Erfolg am meisten. Das kleine Modell allein wirkt am günstigsten, verfehlt aber das Minimum — seine niedrige Zahl zählt also nicht. Die Kaskade erreicht das Minimum für deutlich weniger Geld. Solche Ergebnisse finden Sie nur mit Evals und Traces: Level 2 zeigt, wie Sie KI-Funktionen mit Evals testen, und die Traces aus Level 3 liefern die Token-Zahlen.
Weniger Tokens: Budgets, Kompression, kürzere Antworten
Token-Budgets setzen harte Grenzen dort, wo Kosten davonlaufen können: eine Höchstzahl an Ausgabetokens je Anfrage, ein Tagesbudget je Nutzer und eine Höchstzahl an Schritten je Agenten-Aufgabe. Ein Agent in einer Endlosschleife gehört zu den teuersten Fehlern einer LLM-App.
Prompt-Kompression entfernt, was das Modell nicht braucht. Beginnen Sie von Hand: Streichen Sie doppelte Anweisungen, kürzen Sie Beispiele, senden Sie nur die Tool-Definitionen des aktuellen Wegs, fassen Sie lange Chatverläufe zusammen, und holen Sie weniger, aber bessere Dokumentabschnitte. Werkzeuge aus der Forschung gehen weiter: LLMLingua lässt ein kleines Modell unwichtige Tokens streichen und erreichte auf den getesteten Aufgaben bis zu zwanzigfache Kompression bei geringem Qualitätsverlust (Quelle: Jiang et al., „LLMLingua“, EMNLP 2023). Jede Kompression kann genau den einen Satz entfernen, auf den es ankam — prüfen Sie sie deshalb mit Ihrem Eval-Satz.
Kürzere Antworten sparen Kosten und Zeit zugleich. Verlangen Sie ein festes Format, etwa JSON mit festgelegten Feldern oder drei Stichpunkte, und setzen Sie die Ausgabegrenze passend. Bei Reasoning-Modellen wählen Sie die niedrigste Denkstufe, die in Ihren Evals noch besteht.
Arbeit wiederverwenden und warten lassen: Caching und Batching
Teil 1 dieses Levels hat die drei Caches vorgestellt. Auf die Rechnung wirken sie unterschiedlich. Ein Prompt-Cache beim Anbieter rechnet ein wiederholtes Präfix günstiger ab und verkürzt die Zeit bis zum ersten Token. Er lohnt sich, wenn langer, gleichbleibender Inhalt am Anfang steht: Anweisungen, Tool-Definitionen, Beispiele, Dokumente. Ein exakter oder semantischer Cache spart den Modellaufruf ganz, aber nur bei wiederholten Fragen und mit den Risiken aus Teil 1.
Batching tauscht Zeit gegen Geld. Viele Aufgaben brauchen keine Antwort in Sekunden: die nächtliche Klassifizierung, Zusammenfassungen der Tickets von gestern, Embeddings, Eval-Läufe. Mehrere Anbieter, darunter OpenAI, Anthropic und Google, bieten Batch-Schnittstellen: Sie reichen viele Anfragen auf einmal ein, erhalten die Ergebnisse innerhalb eines Zeitfensters von bis zu 24 Stunden und zahlen je Token weniger als bei Live-Anfragen. Auf eigenen GPUs erhöhen größere Batches den Durchsatz, aber jede Anfrage wartet länger. Das DistServe-Paper nennt die nützliche Kennzahl Goodput: die höchste Anfragerate, die ein System bedienen kann, während es seine Latenzziele noch einhält (Quelle: Zhong et al., „DistServe“, OSDI 2024).
Einfache Anfragen an kleine Modelle leiten
Die meisten Anbieter verkaufen ihre Modelle in Größenstufen. Eine kleinere Stufe antwortet schneller, kostet je Token weniger und reicht für viele Anfragen aus. Zwei Familien aus unserer LLM-Datenbank mit je drei Stufen und dem Gesamtindex der Fähigkeiten (ECI):
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Claude Opus 5.5 Anthropic | 22.09.2026 | geschlossen | 166,8 | 1 |
| Claude Sonnet 5.5 Anthropic | 28.09.2026 | geschlossen | 164,4 | 6 |
| Claude Haiku 5.5 Anthropic | 07.10.2026 | geschlossen | 159,0 | 14 |
| GPT-5.4 OpenAI | 05.03.2026 | geschlossen | 156,7 | 23 |
| GPT-5.4 Mini OpenAI | 17.03.2026 | geschlossen | 148,8 | 64 |
| GPT-5.4 Nano OpenAI | 17.03.2026 | geschlossen | 146,1 | 79 |


ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
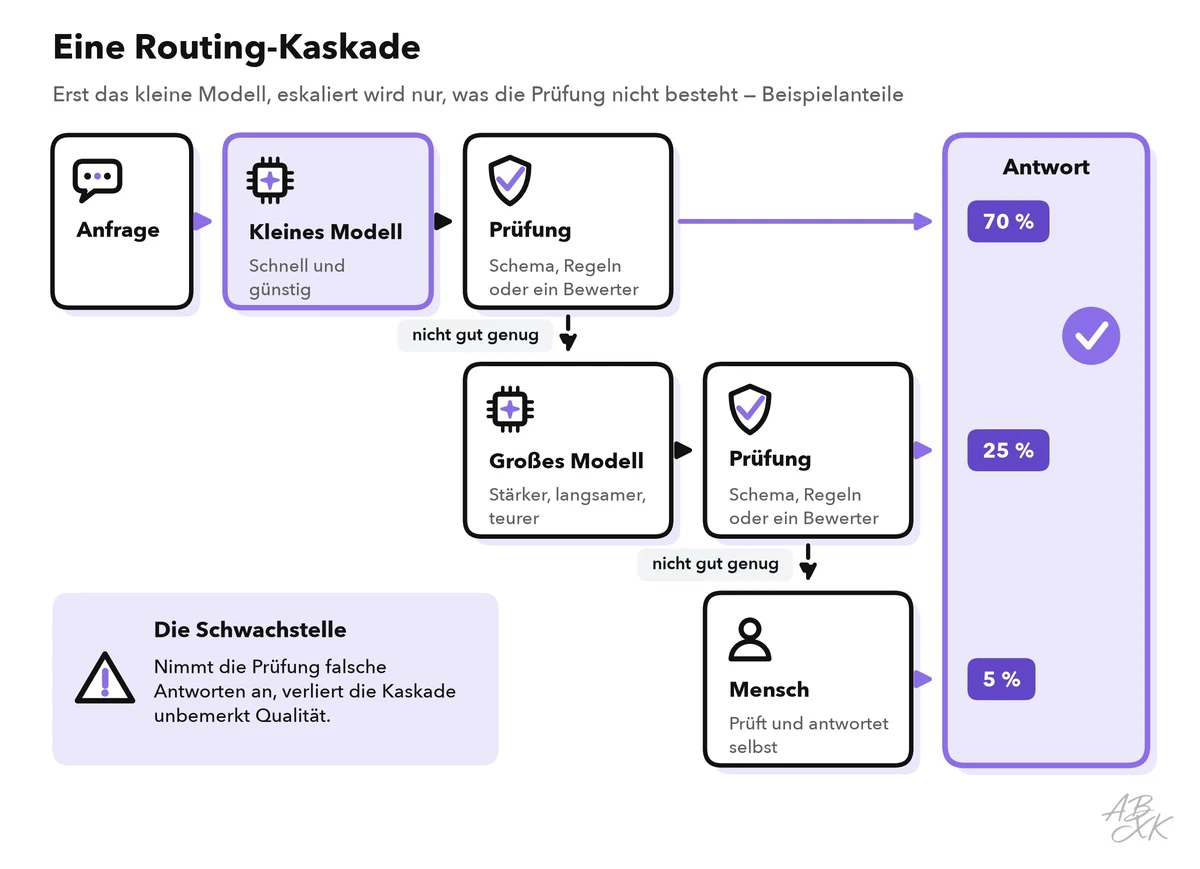
Modell-Routing entscheidet für jede Anfrage, welches Modell antwortet. Die verbreitetste Form ist eine Kaskade: Das kleine Modell beginnt, eine Prüfung entscheidet, ob seine Antwort gut genug ist, und nur der Rest geht weiter an ein größeres Modell.
Die Forschung stützt die Idee. In den Experimenten zu FrugalGPT erreichte eine gelernte Kaskade die Leistung des damals besten Einzelmodells bei bis zu 98 Prozent geringeren Kosten auf den getesteten Aufgaben (Quelle: Chen, Zaharia und Zou, „FrugalGPT“, 2023, arxiv.org). RouteLLM trainierte Router mit Präferenzdaten von Menschen; in einigen Tests senkten sie die Kosten um mehr als die Hälfte, ohne die Qualität der Antworten zu verschlechtern (Quelle: Ong et al., „RouteLLM“, ICLR 2025).
Routing spart mehr als Geld. Weniger Tokens auf großen Modellen bedeuten auch weniger Strom und, über Stromerzeugung und Kühlung, weniger Wasser. Dieser Fußabdruck ist nicht mehr klein: Eine Studie schätzt, dass KI-Systeme 2025 zwischen 32,6 und 79,7 Millionen Tonnen CO₂ verursachten (Quelle: de Vries-Gao, Patterns, Dezember 2025), und laut der Internationalen Energieagentur steigt der Strombedarf von Rechenzentren viermal so schnell wie der aller anderen Sektoren (Quelle: berichtet vom Guardian, März 2026).
Die Prüfung ist die Schwachstelle. Das kann eine Schema-Validierung sein, eine Regel, ein Konfidenzwert oder ein kleines Bewertungsmodell. Nimmt sie falsche Antworten an, spart die Kaskade Geld und verliert unbemerkt Qualität. Eskalierte Anfragen dauern außerdem länger, weil sie zwei Modelle durchlaufen. Bewerten Sie deshalb jeden Weg einzeln, und beobachten Sie die Eskalationsquote: Steigt sie, haben sich Ihr Verkehr oder ein Modell verändert. Für eine enge Aufgabe mit hohem Volumen ist der nächste Schritt die Destillation: Sie trainieren ein kleines Modell mit den Antworten eines großen. Level 3 vergleicht das mit Fine-Tuning, RAG und Prompting; prüfen Sie die Bedingungen des Anbieters, bevor Sie mit seinen Ausgaben trainieren.
Kürzere Wartezeit für Nutzer
Für die Latenz gibt es eigene Hebel. Streaming zeigt die ersten Wörter nach der Zeit bis zum ersten Token, sodass sich das Warten kürzer anfühlt — Gesamtzeit und Kosten bleiben aber gleich. Unabhängige Schritte, etwa mehrere Tool-Aufrufe oder Dokumentabfragen, können parallel statt nacheinander laufen. Arbeit, die nicht von der Frage der Nutzerin abhängt, etwa Zusammenfassungen bekannter Dokumente, lässt sich im Voraus berechnen. Und ein selbst betriebenes Modell kann spekulatives Decoding nutzen, beschrieben in Teil 2 dieses Levels.
Die Tabelle zeigt, was jeder Hebel verändert. Jeder Hebel birgt ein Qualitätsrisiko, deshalb läuft jede Änderung zuerst durch Ihre Evals:
| Hebel | Senkt Kosten | Senkt Latenz | Qualitätsrisiko | Am besten für |
|---|---|---|---|---|
| Token-Budgets, Ausgabegrenzen | Ja | Ja, kürzere Ausgaben | Abgeschnittene Antworten | Jede Funktion, Agenten-Schleifen |
| Prompt-Kompression | Ja, Eingabe | Ja, Zeit bis zum ersten Token | Verlorener Kontext | Lange Prompts, RAG, lange Chats |
| Prompt-Caching | Ja, wiederholte Eingabe | Ja, Zeit bis zum ersten Token | Gering | Lange, gleichbleibende Präfixe |
| Exakter oder semantischer Cache | Ja | Ja, kein Modellaufruf | Veraltete oder falsche Treffer | Wiederholte Fragen |
| Batching | Ja | Nein, Ergebnisse kommen später | Gering | Offline-Aufgaben und Evals |
| Routing und Kaskaden | Ja | Meist; Eskalationen dauern länger | Falsche Antworten werden angenommen | Viele einfache, wenige schwere Anfragen |
| Streaming | Nein | Nur die gefühlte Wartezeit | Gering | Chats und lange Antworten |
| Destillation oder Eigenbetrieb | Ja, bei hohem Volumen | Oft | Engere Fähigkeiten, mehr Betrieb | Enge, häufige Aufgaben |
Die Hebel der Reihe nach angehen
Beginnen Sie mit den Hebeln, die sich günstig ausprobieren und leicht zurücknehmen lassen, und gehen Sie erst zu den schweren über, wenn die Zahlen es verlangen:
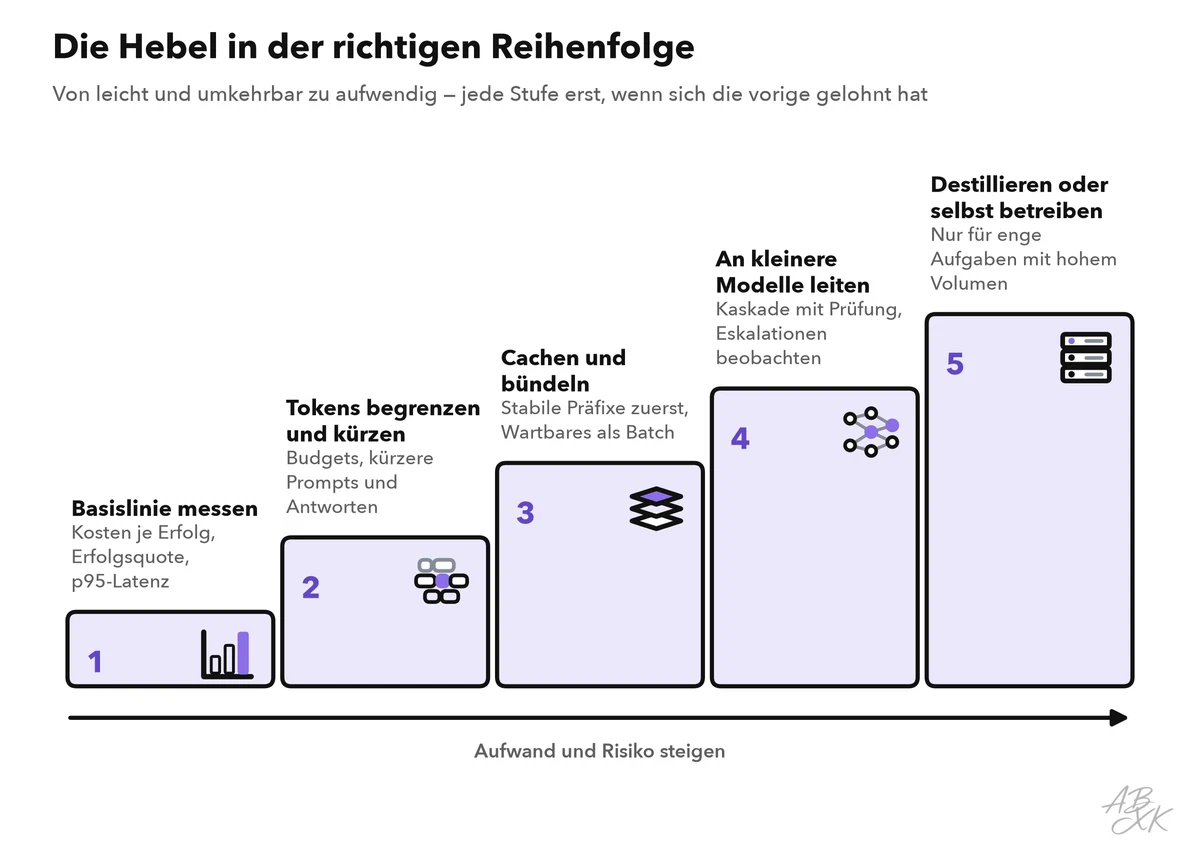
Ändern Sie jeweils nur einen Hebel, und vergleichen Sie die Kosten je erfolgreicher Aufgabe, die Erfolgsquote und die p95-Latenz mit der Basislinie, am besten in einem Canary-Release. Die Infrastruktur für die schwereren Stufen finden Sie in unserem Vergleich. Nach Angaben der Anbieter vermietet Runpod GPUs nach Verbrauch für selbst betriebene oder destillierte Modelle, Pinecone ist eine Vektordatenbank für Retrieval und semantische Caches, und Netlify hostet die Web-App und ihre Serverless-Funktionen:


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.