

Ihre LLM-Funktion ist live. Nutzer stellen Fragen, das Modell antwortet, und die Rechnung wächst. Aber funktioniert die Funktion auch? Klassisches Monitoring sagt Ihnen, dass der Server in weniger als einer Sekunde mit Status 200 geantwortet hat. Es sagt Ihnen nicht, dass die Antwort falsch war, dass eine Prompt-Änderung die Tokens pro Anfrage verdoppelt hat oder dass ein Suchschritt eine ganze Woche lang nichts gefunden hat. Observability (Beobachtbarkeit) heißt: Sie können solche Fragen aus den Daten beantworten, die Ihre App aufzeichnet — ohne zu raten.
Dies ist Teil 5 von Level 3 (Profi). Sie lernen, was Sie bei jeder Anfrage protokollieren und wo der Datenschutz Grenzen setzt, wie Traces Ketten und Agenten sichtbar machen, welche Kennzahlen auf ein Dashboard gehören und welche einen Alarm verdienen, und wie Sie die Qualität mit Stichproben prüfen und Drift bemerken. Evals aus Level 2 testen eine Funktion vor dem Release; Observability beobachtet sie danach.
Warum klassisches Monitoring nicht reicht
LLM-Apps scheitern auf eine Art, die kein Statuscode zeigt:
- Falsch, aber erfolgreich. Eine erfundene Antwort kommt mit Status 200 und normaler Geschwindigkeit an.
- Jede Anfrage kostet etwas anderes. Jede Anfrage hat ihre eigene Zahl an Tokens. Ein längerer Prompt oder ein gesprächigeres Modell treibt die Rechnung hoch, ohne dass ein einziger Fehler auftritt.
- Antworten schwanken. Dieselbe Eingabe kann unterschiedliche Ausgaben liefern; ein einzelner Testlauf beweist wenig.
- Der Boden bewegt sich. Ein Anbieter aktualisiert ein Modell, jemand ändert einen Prompt, Dokumente ändern sich — und das Verhalten verschiebt sich, ohne dass Ihr Code neu ausgeliefert wurde.
- Viele Schritte, eine Antwort. In einer RAG-Kette oder bei einem Agenten hängt die Antwort von mehreren Schritten ab. Ist sie falsch, müssen Sie sehen, welcher Schritt versagt hat.
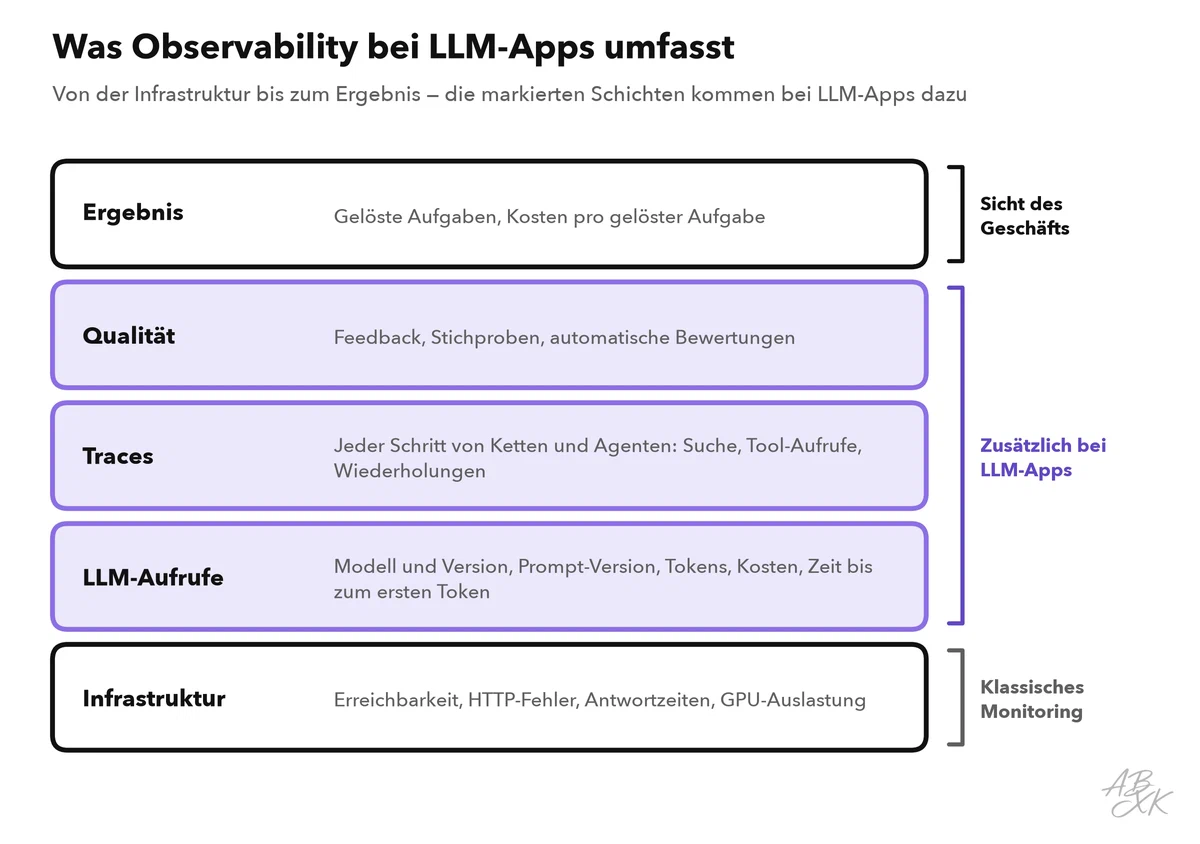
Deshalb hat Observability bei LLM-Apps mehr Schichten als klassisches Monitoring:
Was Sie bei jeder Anfrage protokollieren
Geben Sie jeder Anfrage eine eindeutige ID, und zeichnen Sie jedes Mal dieselben Felder auf. Strukturierte Logs — ein JSON-Objekt pro Ereignis statt Freitext — machen diese Felder durchsuchbar und zählbar:
{
  "request_id": "req_8f2c41",
  "time": "2026-10-16T09:14:03Z",
  "user": "hash:5e1a9c",
  "prompt_version": "support-v14",
  "model": "provider-model-2026-09",
  "input_tokens": 1850,
  "output_tokens": 240,
  "ms_first_token": 1180,
  "ms_total": 3400,
  "sources": ["kb-112", "kb-087"],
  "feedback": null,
  "error": null
}
Die Tabelle erklärt die Felder und wofür Sie sie brauchen:
| Feld | Wozu Sie es brauchen |
|---|---|
| Anfrage-ID, Zeitpunkt | Alle Schritte einer Anfrage verbinden; einen einzelnen Fall schnell finden |
| Modell und Version | Sehen, welches Modell eine Antwort geschrieben hat; Versionen nach einem Update vergleichen |
| Prompt-Version | Änderungen der Qualität mit Änderungen am Prompt verknüpfen |
| Ein- und Ausgabetext | Fehlersuche und Qualitätsprüfung — nur geschwärzt, siehe nächster Abschnitt |
| Ein- und Ausgabe-Tokens | Kosten, und wie voll das Kontextfenster wird |
| Zeit bis zum ersten Token, Gesamtzeit | Wie schnell die App wirkt und wie lange sie wirklich braucht |
| Quellen | Welche Dokumente der Suchschritt geliefert hat, mit ihren Scores |
| Tool-Aufrufe | Welche Tools ein Agent aufgerufen hat, mit Argumenten und Ergebnisstatus |
| Feedback | Daumen hoch oder runter, Kommentare, Korrekturen der Nutzer |
| Fehler und Wiederholungen | Timeouts, Ratenlimits, ungültige Ausgaben, die wiederholt werden mussten |
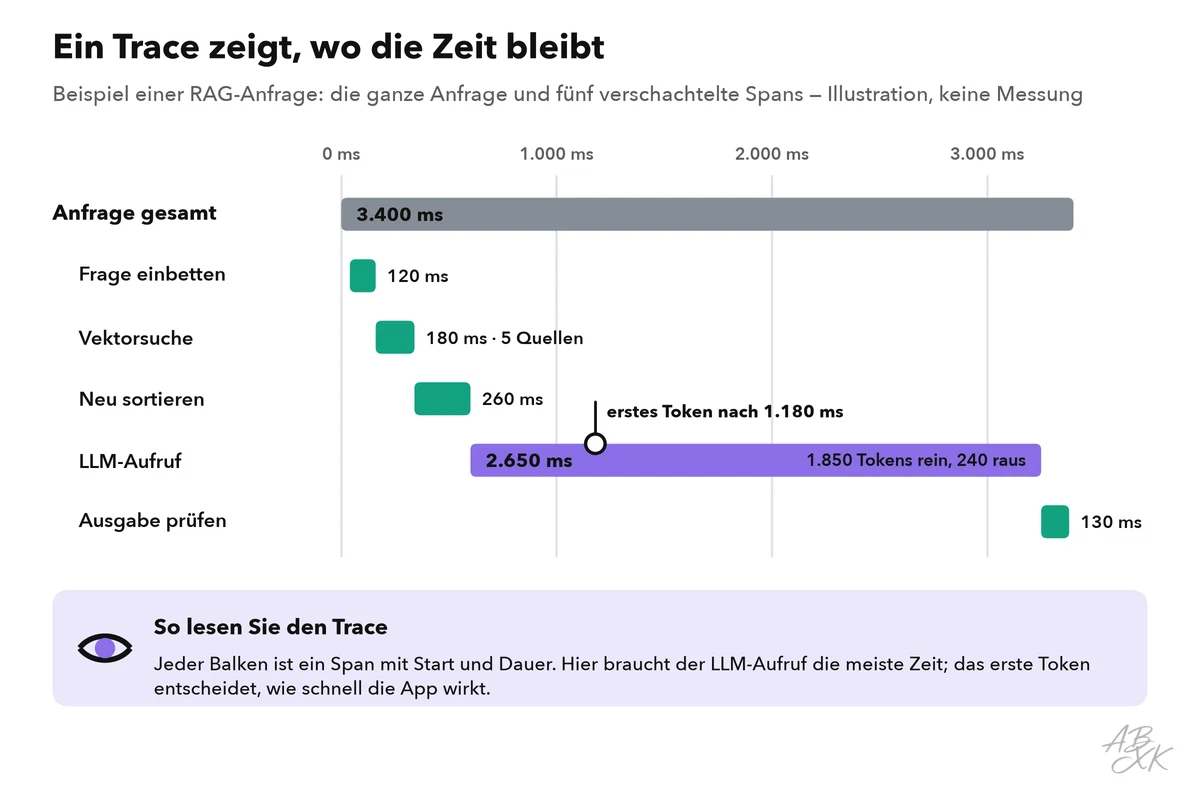
Die Zeit bis zum ersten Token ist die Wartezeit, bis das erste Wort erscheint. Wird die Antwort Wort für Wort gestreamt, entscheidet diese Zahl, wie schnell die App wirkt. Berechnen Sie die Kosten jeder Anfrage aus ihren Tokens und der Preisliste Ihres Anbieters, und speichern Sie sie als Zahl. Dann sind Kosten pro Nutzer, pro Funktion und pro Tag eine einfache Abfrage.
Datenschutz: weniger protokollieren, als Sie könnten
Prompts und Antworten enthalten oft personenbezogene Daten: Namen, E-Mail-Adressen, Bestelldetails, manchmal Gesundheits- oder Finanzangaben. Jedes Log ist eine Kopie dieser Daten. Die DSGVO (Datenschutz-Grundverordnung) verlangt, personenbezogene Daten auf das Notwendige zu beschränken und nicht länger als nötig aufzubewahren. Das sind die Grundsätze der Datenminimierung und der Speicherbegrenzung in Artikel 5.
In der Praxis heißt das:
- Vor dem Speichern schwärzen. Ersetzen Sie E-Mail-Adressen, Telefonnummern, Kundennummern und Namen durch Platzhalter, bevor der Text ins Log gelangt. Muster erkennen feste Formate; Namen brauchen mehr Sorgfalt.
- Nutzer pseudonymisieren. Speichern Sie eine gehashte Nutzer-ID statt des Namens. Solange Sie den Hash einer Person zuordnen können, sind es nach der DSGVO weiterhin personenbezogene Daten; die übrigen Regeln gelten also weiter.
- Zugriff trennen. Kennzahlen darf das ganze Team sehen; ganze Texte liest nur ein kleiner Kreis.
- Texte kurz, Zahlen lange aufbewahren. Löschen Sie zum Beispiel ganze Texte nach 30 Tagen, und behalten Sie aggregierte Kennzahlen ein Jahr. Die tatsächlichen Fristen legen Sie mit Ihrer Datenschutzbeauftragten oder Ihrem Datenschutzbeauftragten fest.
- Nie Geheimnisse protokollieren. API-Schlüssel, Passwörter und Session-Tokens gehören in kein Log.
Wenn Sie Logs an einen externen Observability-Dienst schicken, gelten dort dieselben Regeln. Prüfen Sie, wo er die Daten speichert, und nennen Sie ihn in Ihrer Datenschutzerklärung.
Traces: eine Anfrage durch alle Schritte verfolgen
Ein Trace zeichnet den Weg einer Anfrage durch Ihr System auf. Jeder Schritt darin ist ein Span: ein benanntes Stück Arbeit mit Startzeit, Dauer und Attributen wie dem Modell oder der Zahl der gefundenen Dokumente. Spans sind verschachtelt: Der LLM-Aufruf liegt in der Anfrage, ein Tool-Aufruf in einem Agentenschritt.
Der verbreitete offene Standard dafür ist OpenTelemetry, ein Projekt der Cloud Native Computing Foundation. Er legt herstellerneutral fest, wie Anwendungen Traces, Metriken und Logs aufzeichnen, sodass Sie Werkzeuge wechseln können, ohne Ihren Code umzuschreiben. OpenTelemetry definiert auch Attributnamen für generative KI, etwa gen_ai.request.model und gen_ai.usage.input_tokens. Dieser Teil des Standards ist noch als in Entwicklung markiert; prüfen Sie die aktuellen Namen, bevor Sie darauf aufbauen.
Am wichtigsten sind Traces bei Agenten. Wenn ein Agent in Schleifen läuft, das falsche Tool aufruft oder aufgibt, zeigt der Trace jeden Schritt mit Argumenten und Ergebnissen. Die Fehlerbilder aus Teil 1 dieses Levels werden sichtbar, statt sich hinter einer einzigen Antwort zu verstecken.
Dashboards und Alarme: die Zahlen, die zählen
Ein Dashboard zeigt Trends; ein Alarm ruft einen Menschen. Halten Sie das Dashboard breit und die Alarme wenige. Das sind die wichtigsten Kennzahlen:
| Bereich | Kennzahlen | Typischer Alarm |
|---|---|---|
| Zuverlässigkeit | Fehlerquote, Timeouts, Ratenlimit-Fehler (HTTP 429) | Fehlerquote mehrere Minuten über Ihrer Grenze |
| Tempo | Zeit bis zum ersten Token und Gesamtzeit, als p50 und p95 | p95 über Ihrem Zielwert |
| Kosten | Tokens und Kosten pro Anfrage, pro Nutzer und pro Tag | Tageskosten über Budget; Sprung bei den Tokens pro Anfrage |
| Qualität | Negatives Feedback, gescheiterte Ausgabeprüfungen, leere Suchergebnisse | Mehr negatives Feedback nach einem Release |
| Nutzung | Anfragen pro Stunde, Gesprächslänge, aktive Nutzer | Plötzlicher Einbruch (defekte Funktion) oder Spitze (möglicher Missbrauch) |
p95 ist das 95. Perzentil: 95 Prozent der Anfragen sind schneller als dieser Wert. Durchschnitte verdecken die langsamen Fälle, die Nutzer ärgern; verfolgen Sie deshalb Perzentile. Alarmieren Sie bei dem, was Nutzer spüren — Fehler, Langsamkeit, falsche Antworten — und bei dem, was dem Budget schadet. Jeder Alarm braucht eine verantwortliche Person und einen Link zu Beispiel-Traces. Ein Alarm, auf den niemand reagiert, gewöhnt das Team daran, Alarme zu ignorieren.
Die unterste Schicht deckt Ihr Hosting schon ab. Webserver- und Funktions-Logs zeigen Anfragen, Statuscodes und Fehler, ob Ihre App nun auf einem Server läuft, den Sie mit einem Kontrollpanel wie Plesk verwalten, oder auf einer Plattform wie Netlify. Sie sagen Ihnen, ob die App erreichbar war, nicht, ob die Antwort stimmte. Betreiben Sie ein Modell selbst auf gemieteten GPUs, beobachten Sie zusätzlich GPU-Speicher und Auslastung, wie in Teil 3 dieses Levels beschrieben. Diese drei Tools stammen aus unserem Vergleich der Infrastruktur-Tools:

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Qualität: Stichproben, Feedback und Drift
Feedback von Nutzern ist wertvoll, aber dünn. Meist bewerten nur wenige Nutzer Antworten, und sie sind keine Zufallsstichprobe. Ergänzen Sie zwei weitere Quellen für Qualitätsdaten:
- Zufallsstichproben. Prüfen Sie jede Woche eine zufällige Auswahl von Gesprächen, zum Beispiel 50, mit einer kurzen Rubrik: richtig, vollständig, auf die Quellen gestützt, passender Ton.
- Gezielte Stichproben. Prüfen Sie außerdem Fälle mit negativem Feedback, gescheiterten Ausgabeprüfungen, leeren Suchergebnissen oder ungewöhnlich langen Gesprächen.
Bei größeren Mengen kann ein LLM Stichproben mit derselben Rubrik bewerten. Das heißt LLM-as-Judge (LLM als Richter). Vergleichen Sie seine Bewertungen an einer Teilmenge mit menschlichen Urteilen, bevor Sie sich darauf verlassen.
Drift heißt, dass sich die Qualität mit der Zeit ändert, obwohl niemand die Funktion geändert hat. Dafür gibt es drei übliche Ursachen:
- Die Eingaben ändern sich: neue Produkte, eine neue Kundengruppe, ein saisonales Thema. Beobachten Sie die Mischung der Themen und den Anteil leerer Suchergebnisse.
- Das Modell ändert sich: Anbieter veröffentlichen neue Versionen und stellen alte ein. Legen Sie eine Modellversion fest, wo die API es erlaubt, und lassen Sie Ihre Evals vor jedem Wechsel laufen.
- Ihre Daten ändern sich: Dokumente kommen hinzu, ziehen um oder werden gelöscht, und der Index zieht nach — oder eben nicht.
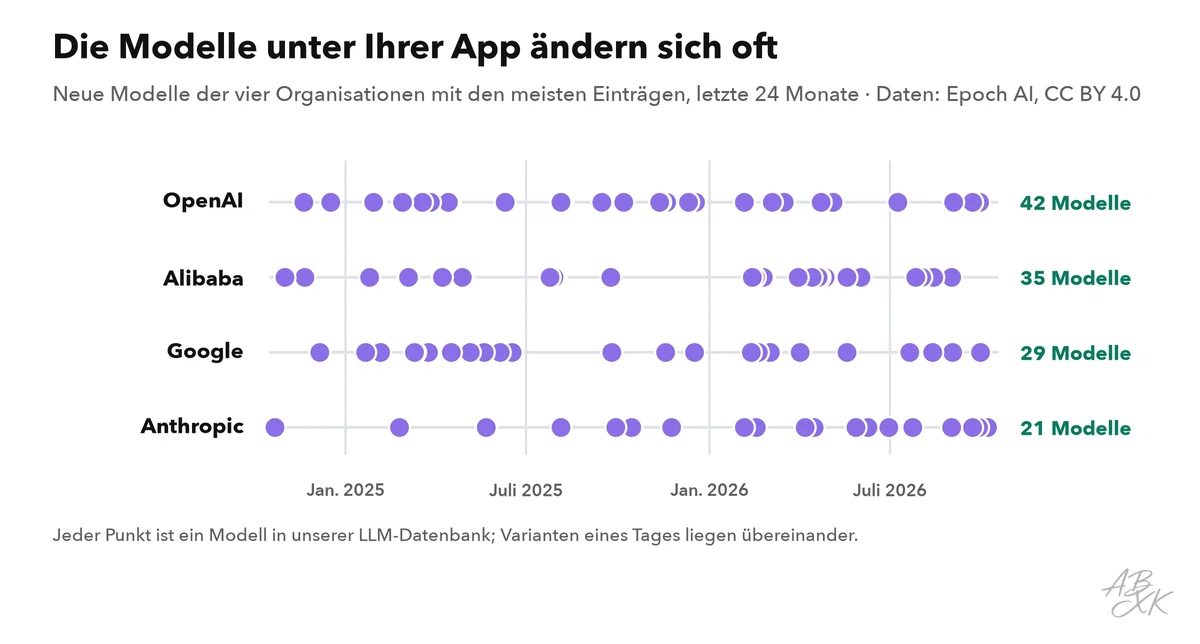
Die zweite Ursache ist kein seltenes Ereignis. Unsere LLM-Datenbank zeigt, wie oft die Organisationen hinter den großen Modellen neue veröffentlichen:
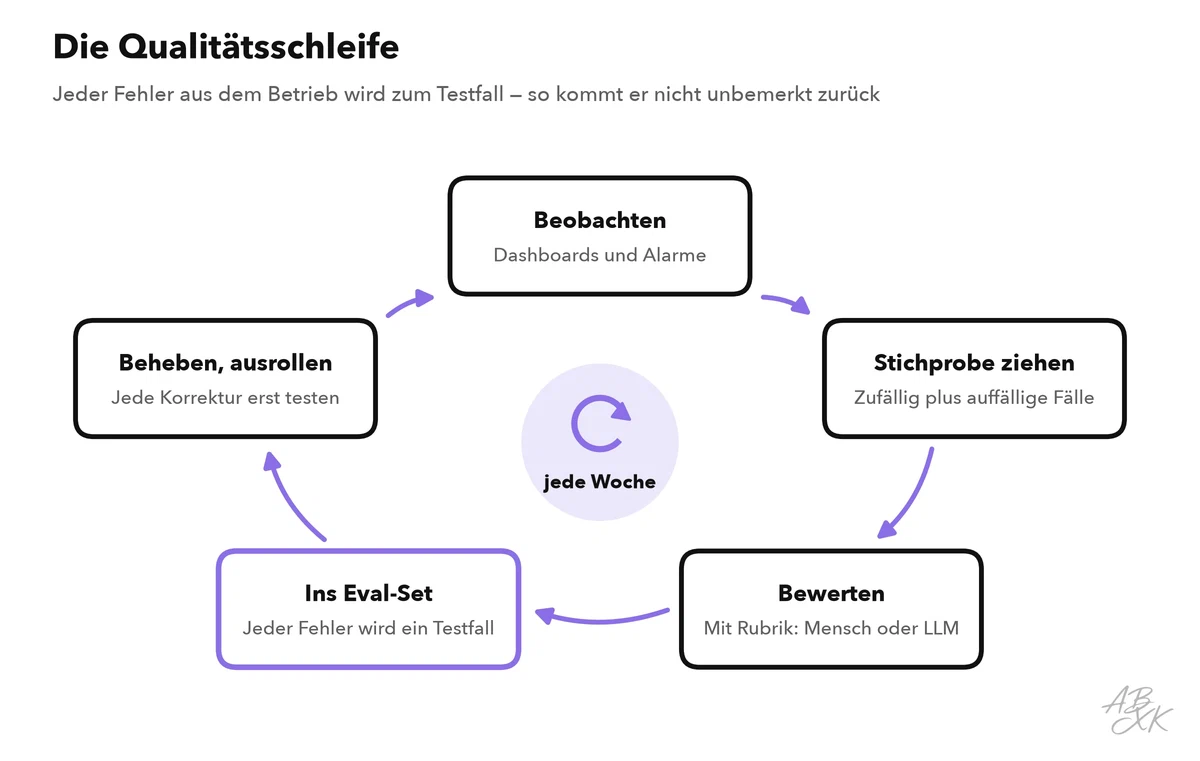
Jeder Fehler, den Sie finden, gehört anschließend in Ihr Eval-Set, damit er nicht unbemerkt zurückkommt. Das schließt die Schleife zwischen Beobachten und Testen:
Checkliste für die erste Woche
Für den Anfang brauchen Sie keine große Plattform. Diese sieben Schritte decken die Grundlagen ab:
- IDs und strukturierte Logs für jede Anfrage, mit den Feldern aus der Tabelle — und Schwärzung ab dem ersten Tag.
- Versionen von Modell und Prompt in jedem Log-Eintrag.
- Tracing für jeden Schritt von Ketten und Agenten, zum Beispiel mit OpenTelemetry.
- Ein Dashboard mit Fehlerquote, p95-Zeit, Tokens und Kosten pro Tag sowie negativem Feedback.
- Drei Alarme: Fehlerquote, Tageskosten und negatives Feedback.
- Eine wöchentliche Stichprobe mit Rubrik; Fehler wandern ins Eval-Set.
- Aufbewahrungsregeln: kurz für ganze Texte, länger für Zahlen, dokumentiert in Ihrer Datenschutzerklärung.