

Ein Agent mit guten Tools kann viel leisten. Manche Aufgaben sind aber zu breit für ein Kontextfenster, oder sie brauchen unterschiedliche Fähigkeiten und Rechte. Dann teilen Teams die Arbeit auf: Ein Agent plant, mehrere recherchieren parallel, ein weiterer prüft das Ergebnis. Gut gemacht, steigt die Qualität. Schlecht gemacht, vervielfachen sich Kosten, Fehler und Verwirrung.
Dies ist Teil 3 von Level 4 (Experte) im Lernpfad AI Development. Sie lernen vier bewährte Muster kennen, erfahren, wann mehrere Agenten helfen und wann sie schaden, wie sich Fehler und Kosten aufschaukeln, wie Sie einen Multi-Agenten-Lauf nachverfolgen und wo Menschen prüfen müssen. Der Teil baut auf KI-Agenten mit Tools, Schleifen und Gedächtnis aus Level 3 auf.
Was ein System zum Multi-Agenten-System macht
Ein Multi-Agenten-System besteht aus mehreren Agenten mit jeweils eigenen Anweisungen, eigenem Kontext, eigenen Tools und Rechten, die einander Arbeit übergeben. Entweder koordiniert Ihr Code sie über feste Wege, oder ein Agent entscheidet zur Laufzeit, wer was erledigt. Anthropic nennt die erste Form einen Workflow und die zweite einen Agenten im engeren Sinn (Quelle: Anthropic, „Building effective agents“, 2024). Viele Systeme, die als Multi-Agenten-System gelten, sind eigentlich Workflows — oft eine gute Nachricht, denn feste Wege lassen sich leichter testen.
Mehrere Agenten können echte Vorteile bringen:
- Saubere Kontexte. Jeder Agent sieht nur, was seine Teilaufgabe braucht, statt eines überquellenden Kontexts.
- Parallele Arbeit. Unabhängige Teilaufgaben laufen gleichzeitig, das verkürzt die Wartezeit.
- Spezialisierung. Jede Rolle bekommt eigenen Prompt, eigene Tools und bei Bedarf ein eigenes Modell.
- Geringste Rechte. Ein Recherche-Agent darf lesen, aber nichts verschicken; schreiben darf nur einer.
- Unabhängige Prüfung. Ein zweiter Agent mit eigenen Anweisungen prüft die Arbeit des ersten.
Zwei offene Protokolle verbinden die Teile. Das Model Context Protocol (MCP), von Anthropic im November 2024 veröffentlicht, vereinheitlicht, wie Agenten auf Tools und Daten zugreifen. Das Protokoll Agent2Agent (A2A), von Google im April 2025 vorgestellt, beschreibt, wie Agenten verschiedener Systeme Aufgaben austauschen.
Vier bewährte Muster
Die meisten echten Systeme bestehen aus wenigen Grundmustern:
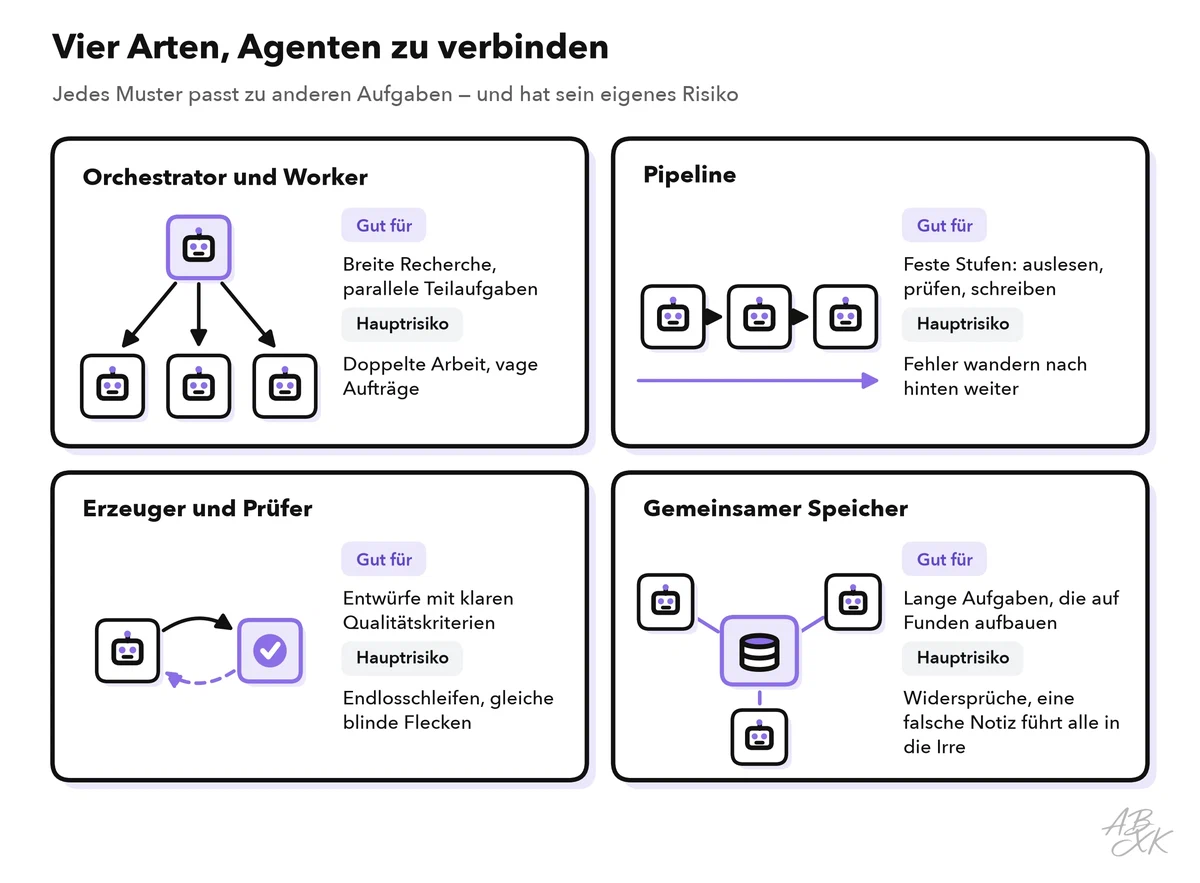
Die Tabelle nennt die vier Muster und ergänzt die Debatte, eine Forschungsvariante des Prüfer-Musters:
| Muster | Gut für | Hauptrisiko | Kontrolle |
|---|---|---|---|
| Orchestrator und Worker | Breite Recherche, parallele Teilaufgaben | Doppelte Arbeit, vage Aufträge | Ein genauer Auftrag je Worker: Ziel, Ausgabeformat, Grenzen, Tools |
| Pipeline | Feste Stufen wie auslesen, prüfen, schreiben | Fehler wandern nach hinten weiter | Schema-Validierung zwischen den Stufen |
| Erzeuger und Prüfer | Entwürfe mit klaren Qualitätskriterien | Endlosschleifen, gleiche blinde Flecken | Rundenlimit; Bewertungsraster oder anderes Modell für den Prüfer |
| Debatte oder Abstimmung | Schwierige Fragen mit überprüfbarer Antwort | Kosten wachsen mit jedem Agenten; Einigung auf eine falsche Antwort | Nur dort, wo Ihre Evals einen Gewinn zeigen |
| Gemeinsamer Speicher | Lange Aufgaben, die auf Funden aufbauen | Widersprüchliche Einträge; eine falsche Notiz führt alle in die Irre | Nur einer schreibt, versionierte Einträge mit Quellen |
Am besten dokumentiert ist das Muster aus Orchestrator und Workern. Im Recherchesystem von Anthropic plant ein Lead-Agent die Recherche, startet Subagenten, die parallel suchen, und führt ihre Funde zusammen. Mit Claude Opus 4 als Lead und Claude Sonnet 4 als Subagenten übertraf es einen einzelnen Agenten mit Claude Opus 4 auf Anthropics interner Recherche-Evaluation um 90,2 Prozent. Die Analyse erklärt auch einen großen Teil des Gewinns: Auf einem Browsing-Benchmark erklärte allein der Token-Verbrauch 80 Prozent der Unterschiede in den Ergebnissen. Mehrere Agenten funktionieren also zum Teil deshalb, weil sie parallel mehr Tokens einsetzen können (Quelle: Anthropic, „How we built our multi-agent research system“, 2025).
In einer Debatte antworten mehrere Instanzen eines Modells, lesen die Antworten der anderen und überarbeiten ihre eigene über mehrere Runden. In Experimenten von Forschenden des MIT und von Google Brain verbesserte das die faktische Genauigkeit und das logische Schließen (Quelle: „Improving Factuality and Reasoning in Language Models through Multiagent Debate“, 2023, arxiv.org).
Wann mehrere Agenten helfen — und wann sie schaden
Zwei Fragen entscheiden: Wie viele Teile der Aufgabe können parallel laufen, und wie unabhängig sind diese Teile?
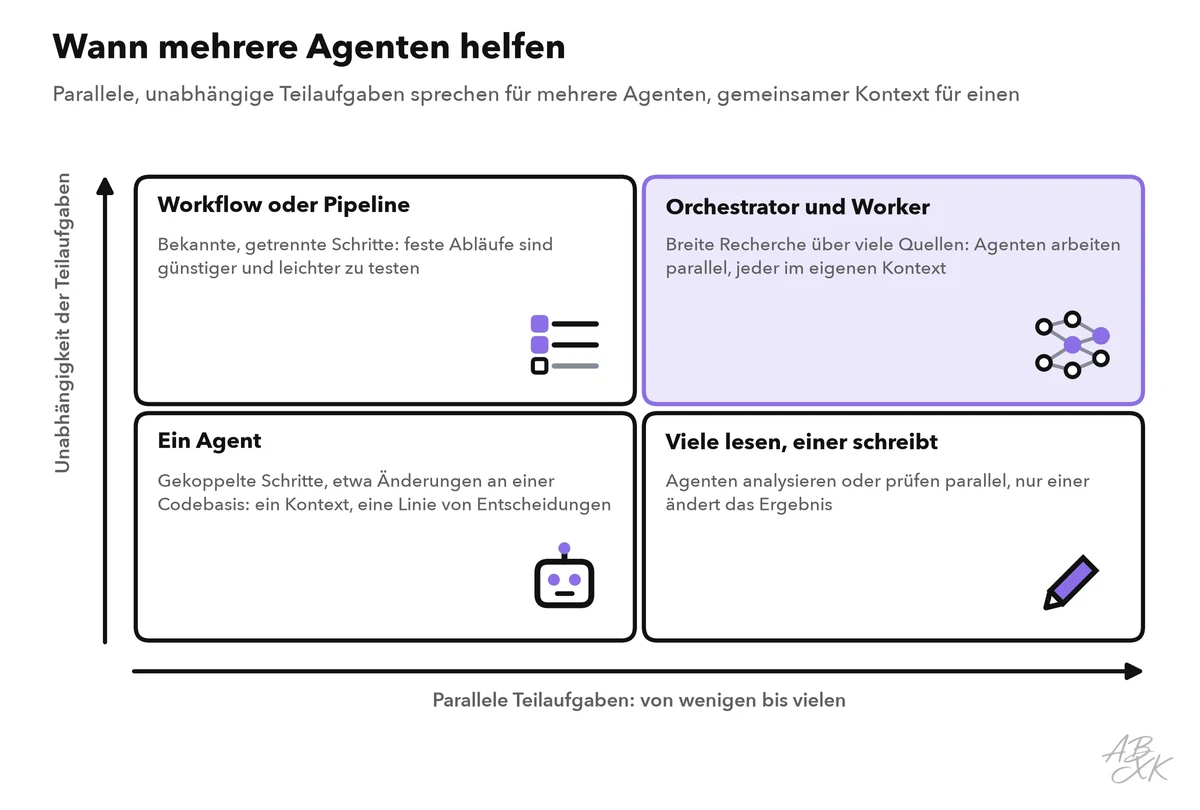
Eng gekoppelte Arbeit ist die klassische Falle. Anthropic weist darauf hin, dass die meisten Programmieraufgaben weniger echt parallele Teile enthalten als Recherche. Cognition, der Hersteller des Coding-Agenten Devin, argumentiert, dass jede Aktion verdeckte Entscheidungen zu Stil, Namen oder Sonderfällen enthält. Parallele Agenten, die die Entscheidungen der anderen nicht sehen, liefern dann Teile, die nicht zusammenpassen (Quelle: Cognition, „Don’t Build Multi-Agents“, 2025). 2026 berichtete dasselbe Unternehmen, dass Multi-Agenten-Aufbauten heute am besten funktionieren, wenn Schreibvorgänge in einem einzigen Strang bleiben („writes stay single-threaded“): Mehrere Agenten dürfen analysieren oder prüfen, aber nur einer ändert den Code (Quelle: Cognition, „Multi-Agents: What’s Actually Working“, 2026).
Die Forschung bestätigt, dass die Koordination selbst eine Fehlerquelle ist. Eine Studie zu verbreiteten Multi-Agenten-Frameworks ordnete 14 Fehlerarten drei Kategorien zu: schwache Systementwürfe und Aufgabenbeschreibungen, mangelnde Abstimmung zwischen den Agenten sowie unzureichende Prüfung und fehlerhaftes Beenden (Quelle: Cemri et al., „Why Do Multi-Agent LLM Systems Fail?“, 2025, arxiv.org). Daraus folgt die Regel: Beginnen Sie mit einem Agenten, messen Sie eine Basislinie mit Ihrem Eval-Satz, und fügen Sie Agenten nur hinzu, wenn der gemessene Gewinn die Mehrkosten rechtfertigt.
Fehler und Kosten schaukeln sich auf
Jeder Schritt und jede Übergabe kann scheitern. Gelingt jeder Schritt unabhängig in 95 Prozent der Fälle, gelingt eine Kette aus zehn Schritten nur noch in etwa 60 Prozent der Fälle:
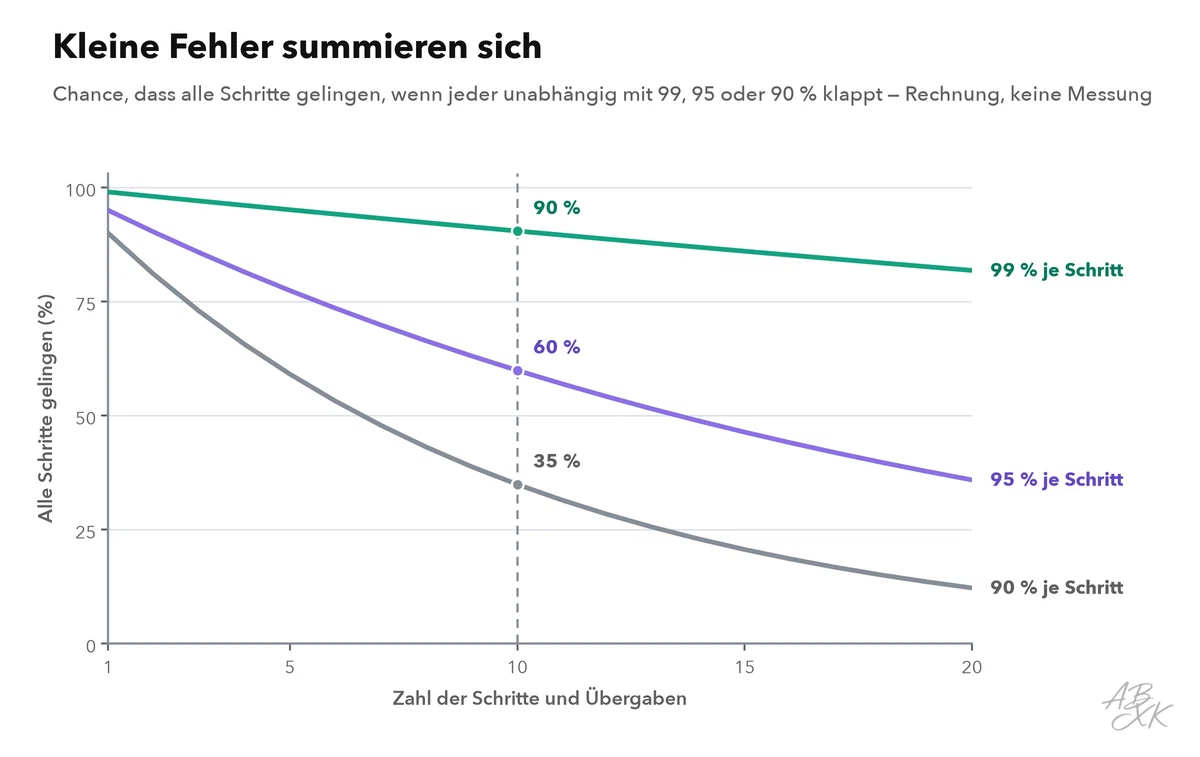
Echte Fehler sind nicht völlig unabhängig, die Richtung stimmt aber: Lange Ketten brauchen Prüfungen zwischen den Schritten. Validieren Sie jede Übergabe gegen ein Schema, lassen Sie einen Schritt erst selbst wiederholen, bevor die ganze Aufgabe neu startet, und speichern Sie Zwischenergebnisse, damit ein Lauf fortgesetzt werden kann.
Auch die Kosten schaukeln sich auf. Jeder Agent liest seinen eigenen Kontext, und viele lesen erneut, was andere geschrieben haben. In Anthropics Daten verbrauchten Agenten etwa viermal so viele Tokens wie Chat-Interaktionen, Multi-Agenten-Systeme etwa 15-mal so viele (Quelle: Anthropic, 2025, siehe oben). Legen Sie ein Token-Budget je Aufgabe und je Agent fest, und erwägen Sie leichtere Modelle für Worker mit einfachen Aufgaben.
Halten Sie die Aufgabe jedes Workers klein. Der METR-Zeithorizont misst die Länge der Aufgaben, die ein Modell in etwa der Hälfte der Versuche löst — Aufgaben dieser Länge scheitern also noch in jedem zweiten Fall. Das sind die aktuellen Spitzenreiter in unseren Daten:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Claude Mythos Preview (Early) Anthropic | 07.04.2026 | 17 Std. 25 min |
| 2 | Claude Opus 4.6 (unknown thinking) Anthropic | 05.02.2026 | 11 Std. 59 min |
| 3 | Gemini 3.1 Pro Preview Google DeepMind | 19.02.2026 | 6 Std. 24 min |
| 4 | GPT-5.2 (high) OpenAI | 11.12.2025 | 5 Std. 52 min |
| 5 | GPT-5.3 Codex OpenAI | 05.02.2026 | 5 Std. 50 min |



Die Länge der Aufgaben, die ein Modell in etwa der Hälfte der Fälle richtig löst — gemessen daran, wie lange ein menschlicher Experte dafür braucht. Die Zahl ist eine Dauer, kein Punktwert: Ein längerer Horizont heißt, das Modell kann länger selbstständig arbeiten. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Geben Sie Workern Aufgaben, die deutlich kürzer sind als dieser Horizont, und lassen Sie den Orchestrator viele kurze Erfolge zusammensetzen, statt auf einen langen zu hoffen.
Einen Multi-Agenten-Lauf nachverfolgen
Scheitert eine Multi-Agenten-Aufgabe, müssen Sie wissen, welcher Agent welchen Auftrag bekam, was er tat und was er zurückgab. Zeichnen Sie jede Aufgabe als einen Trace auf, mit einem Span für jeden Agenten und jeden Tool-Aufruf und einem Verweis auf den Eltern-Span:
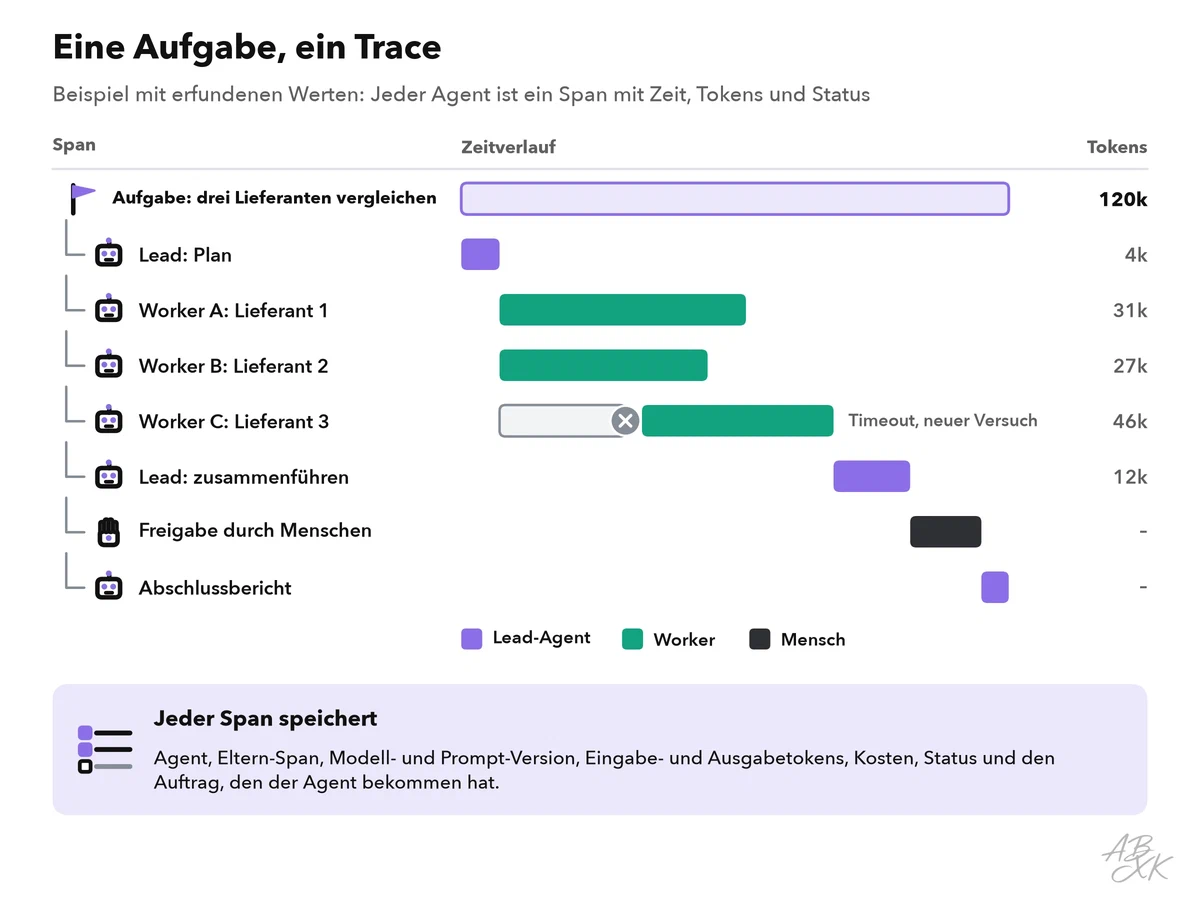
Das Projekt OpenTelemetry hat semantische Konventionen für generative KI. Sie vereinheitlichen Attribute wie den Modellnamen und die Token-Zahlen, sodass Traces aus verschiedenen Frameworks in ein Werkzeug passen. Level 3 zeigt, wie Sie Observability für LLM-Apps aufsetzen. Bei Multi-Agenten-Systemen beobachten Sie je Aufgabe vier Zahlen: Erfolgsquote, Kosten je erfolgreicher Aufgabe, Zahl der Übergaben und wiederholte Schleifen. Bewerten Sie das System dann als Ganzes und je Rolle; Level 2 zeigt, wie Sie KI-Funktionen mit Evals testen.
Prüfpunkte für Menschen
Mehr Agenten bedeuten mehr Aktionen, die niemand in Echtzeit verfolgt. Setzen Sie Menschen dort ein, wo ein Fehler teuer wird:
- Vor dem Auffächern: Den Plan freigeben, bevor der Orchestrator Dutzende Worker startet.
- Vor Aktionen nach außen: Senden, Bezahlen, Löschen oder Ausrollen braucht immer eine Freigabe.
- Beim Ergebnis: Bei folgenreichen Ergebnissen zeichnet ein Mensch die Antwort ab.
- Bei Uneinigkeit: Finden Erzeuger und Prüfer nicht zusammen, eskalieren Sie, statt weiter zu kreisen.
Agenten reichen sich auch Inhalte weiter. Ein Worker, der Webseiten liest, kann versteckte Anweisungen in den Kontext des Orchestrators tragen — eine Form von Prompt Injection. Behandeln Sie jedes Worker-Ergebnis als Daten, nie als Anweisung, und geben Sie Workern nur Leserechte. Unser Bereich AI Security erklärt den Angriff.
Checkliste für den Entwurf
Beantworten Sie diese Fragen, bevor Sie bauen:
| Frage | Eine gute Antwort |
|---|---|
| Würde ein Agent mit besseren Tools genügen? | Sie haben eine Basislinie mit einem Agenten auf demselben Eval-Satz gemessen |
| Sind die Teilaufgaben unabhängig? | Ja — oder nur ein Agent schreibt |
| Hat jede Übergabe einen Vertrag? | Ziel, Eingaben, Ausgabeschema, Grenzen |
| Wo liegen die Grenzen? | Höchstzahl an Agenten, Runden und Tokens je Aufgabe |
| Wo prüfen Menschen? | Den Plan, Aktionen nach außen, das Endergebnis |
| Sehen Sie alles? | Ein Trace je Aufgabe, ein Span je Agent |
Die Orchestrierung müssen Sie nicht selbst programmieren. Nach Angaben der Anbieter baut MindStudio KI-Agenten ohne Code, Turbotic erstellt Automatisierungen aus einer Beschreibung in Alltagssprache, mit Devs.ai bauen und betreiben Teams Agenten auf eigenen Daten, und Dry Ground AI erledigt Routinearbeit über angebundene Tools:
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Egal mit welcher Plattform: Messen Sie weiter. Ein Multi-Agenten-System verdient seinen Platz nur, wenn es die Basislinie mit einem Agenten bei der Qualität je Kosteneinheit schlägt.