

Die meisten Teile dieses Lernpfads nutzen fertige Modelle: Sie schicken Text an ein großes Sprachmodell (LLM) und bekommen eine Antwort zurück. Hinter jedem dieser Modelle steckt maschinelles Lernen, und dieselben Ideen stecken in Spamfiltern, Produktempfehlungen und der Kamera an der Selbstbedienungskasse. Früher oder später begegnen Ihnen Begriffe wie Klassifikation, neuronales Netz, RNN oder YOLO — in einer Stellenanzeige, einem Tutorial oder einer Produktbeschreibung.
Dieser Artikel ist Teil 6, der letzte Teil von Level 0 in unserem Lernpfad AI Development. Sie lernen, wie ein Modell aus Beispielen lernt, was Klassifikation bedeutet, wie ein neuronales Netz in einfachen Worten funktioniert, welchen vier Modellfamilien Sie begegnen, wofür Frameworks wie TensorFlow da sind und wann Sie all das statt einer LLM-API brauchen. Mathematik oder Code brauchen Sie für diesen Teil nicht.
Lernen aus Beispielen statt aus Regeln
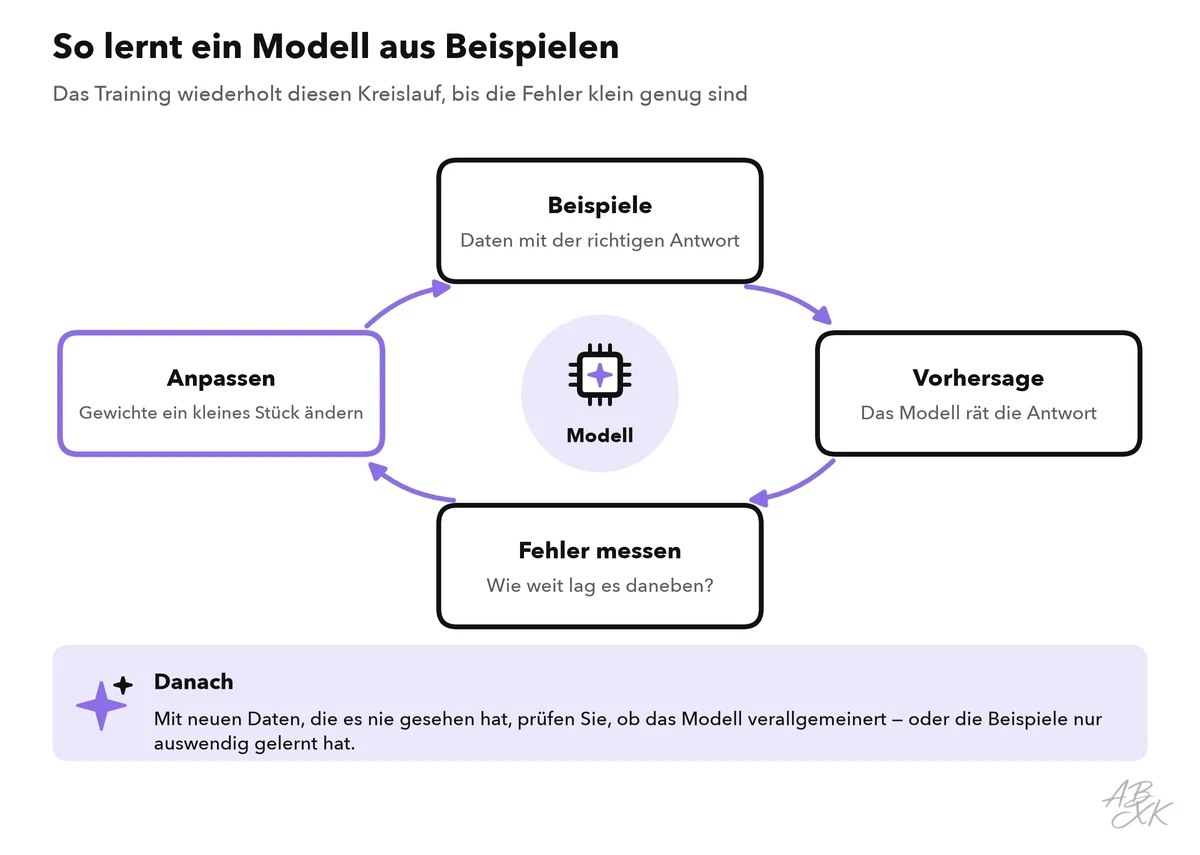
Klassische Software folgt Regeln, die ein Mensch geschrieben hat: „Enthält die E-Mail das Wort Lotterie, verschiebe sie in den Spam.“ Maschinelles Lernen dreht das um. Sie geben dem Computer viele Beispiele mit der richtigen Antwort, und er findet die Regeln selbst. Das Ergebnis ist ein Modell: ein Programm mit Millionen einstellbarer Zahlen, den Gewichten, das eine Eingabe in eine Ausgabe verwandelt.
Gelernt wird in einer Schleife. Das Modell gibt für ein Beispiel eine Vorhersage ab, eine Formel misst, wie weit es danebenlag, und die Gewichte ändern sich ein kleines Stück, damit die nächste Vorhersage besser wird. Nach vielen Durchgängen über Tausende Beispiele werden die Fehler klein. Das ist das Training. Das fertige Modell auf neue Daten anzuwenden heißt Inferenz — dafür zahlen Sie, wenn Sie eine LLM-API aufrufen.
Es gibt drei Hauptarten des Lernens:
- Überwachtes Lernen: Jedes Beispiel hat die richtige Antwort, das Label. „Diese E-Mail ist Spam, diese nicht.“ Die meisten Anwendungen im Unternehmen funktionieren so.
- Unüberwachtes Lernen: Die Beispiele haben keine Labels. Das Modell findet Gruppen oder Muster selbst, etwa Kunden, die ähnlich einkaufen.
- Bestärkendes Lernen: Das Modell probiert Handlungen aus und bekommt Belohnung oder Strafe, wie einen Punktestand im Spiel. LLMs werden teilweise so nachtrainiert, mit menschlichen Rückmeldungen zu ihren Antworten.
Klassifikation: die Aufgabe, die Ihnen am häufigsten begegnet
Klassifikation heißt, eine Eingabe einer von mehreren festen Gruppen zuzuordnen, den Klassen. Ist diese E-Mail Spam oder nicht? Welche Abteilung bekommt dieses Support-Ticket? Ist diese Zahlung Betrug? Klassifikation ist die häufigste Aufgabe des maschinellen Lernens im Unternehmen, weil so viele Entscheidungen eine Wahl zwischen wenigen Möglichkeiten sind.
Ein Klassifikationsmodell wählt nicht nur eine Klasse. Es gibt für jede Klasse eine Wahrscheinlichkeit aus, etwa „Spam: 0,93“. Wo die Grenze liegt, entscheiden Sie. Eine niedrige Grenze fängt mehr Spam ab, blockiert aber auch mehr echte E-Mails; eine hohe lässt mehr Spam durch. Um ein Klassifikationsmodell zu beurteilen, schauen Sie auf mehr als eine Zahl:
| Aufgabe | Was das Modell ausgibt | Beispiel |
|---|---|---|
| Klassifikation | Eine Klasse aus mehreren | Spam oder nicht; Ticket geht an Buchhaltung, Technik oder Vertrieb |
| Regression | Eine Zahl | Der Preis eines Gebrauchtwagens; der Umsatz der nächsten Woche |
| Clustering | Gruppen, die vorher niemand festgelegt hat | Kundensegmente mit ähnlichem Kaufverhalten |
| Objekterkennung | Objekte im Bild, jedes mit einem Rahmen | Produkte auf einem Regalfoto, Personen in einem Kamerabild |
| Generierung | Neuer Text, neue Bilder oder neuer Ton | Eine Antwort auf eine Frage, ein Produktfoto, ein Sprechertext |
- Genauigkeit (Accuracy) ist der Anteil aller Vorhersagen, die stimmten. Sie kann täuschen: Ist nur 1 % aller Zahlungen Betrug, ist ein Modell, das immer „kein Betrug“ sagt, zu 99 % genau — und nutzlos.
- Präzision (Precision) fragt: Von allen E-Mails, die das Modell als Spam markiert hat, wie viele waren wirklich Spam?
- Trefferquote (Recall) fragt: Von allen echten Spam-Mails, wie viele hat das Modell erkannt?
Neuronale Netze in einfachen Worten
Ein neuronales Netz ist ein Modell aus vielen kleinen Einheiten, lose angelehnt an Nervenzellen. Jede Einheit nimmt Zahlen auf, multipliziert sie mit ihren Gewichten, addiert sie und gibt das Ergebnis weiter. Die Einheiten sitzen in Schichten: eine Eingabeschicht für die Daten, verborgene Schichten in der Mitte und eine Ausgabeschicht mit der Antwort. Ein Netz mit vielen verborgenen Schichten heißt tief — daher der Begriff Deep Learning.
Stark werden neuronale Netze, weil die frühen Schichten einfache Muster lernen und die späteren sie kombinieren. In einem Bildmodell reagieren die ersten Schichten auf Kanten und Farben, die mittleren auf Formen wie Räder oder Augen und die letzten auf ganze Objekte. Niemand programmiert diese Schritte; sie entstehen im Training.
Vier Modellfamilien, denen Sie begegnen
Neuronale Netze gibt es in verschiedenen Bauweisen, und jede passt zu einer anderen Art von Daten. Klassische Modelle ohne neuronales Netz sind für viele Tabellen weiterhin die beste Wahl.
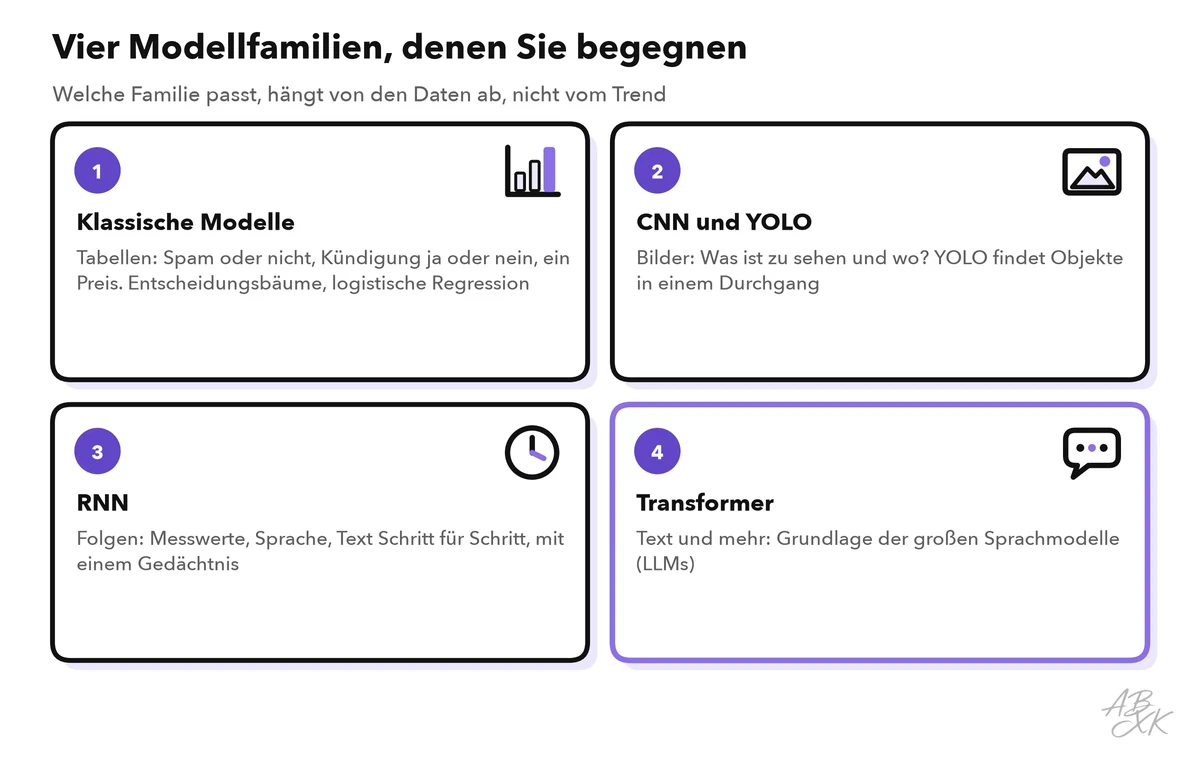
- Klassische Modelle wie Entscheidungsbäume und logistische Regression arbeiten mit Tabellen aus Zeilen und Spalten: Kundendaten, Zahlungen, Messwerte. Sie lernen schnell, brauchen wenig Daten und lassen sich gut erklären.
- Faltende neuronale Netze (CNN) betrachten Bilder durch kleine Fenster, die über das Bild wandern. YOLO („You Only Look Once“) ist eine bekannte Familie von Modellen zur Objekterkennung, die auf dieser Idee aufbaut: Sie findet alle Objekte eines Bildes in einem einzigen Durchgang und zieht um jedes einen Rahmen — schnell genug für Live-Video (Quelle: Redmon et al., „You Only Look Once“, CVPR 2016, arxiv.org).
- Rekurrente neuronale Netze (RNN) lesen eine Folge Schritt für Schritt und tragen ein Gedächtnis von Schritt zu Schritt mit — passend für Sprache, Messreihen und Text. Eine verbesserte Form namens LSTM merkt sich längere Abschnitte (Quelle: Hochreiter und Schmidhuber, „Long Short-Term Memory“, Neural Computation 1997).
- Transformer betrachten alle Teile eines Textes zugleich und lernen, welche Wörter zusammenhängen. Nach 2017 haben sie RNN bei den meisten Sprachaufgaben abgelöst (Quelle: Vaswani et al., „Attention Is All You Need“, NeurIPS 2017, arxiv.org). Fast jedes große Sprachmodell baut darauf auf. Unsere LLM-Datenbank führt 343 Sprachmodelle mit ihren Benchmark-Ergebnissen.
Frameworks: TensorFlow, PyTorch und der Rest
Niemand schreibt die Mathematik eines neuronalen Netzes von Hand. Frameworks erledigen das: Sie beschreiben die Schichten, das Framework übernimmt das Training auf Grafikkarten (GPUs). TensorFlow von Google und PyTorch, entstanden bei Meta, sind die beiden großen; PyTorch dominiert in der Forschung, beide laufen im Betrieb. Für klassische Modelle auf Tabellen ist in Python scikit-learn die übliche Wahl.
Ein typisches erstes TensorFlow-Tutorial trainiert ein kleines Netz darauf, handgeschriebene Ziffern aus dem Datensatz MNIST zu erkennen — in wenigen Dutzend Zeilen Code. Das ist eine gute Übung, um die Trainingsschleife aus diesem Teil in Aktion zu sehen. Cloud-Plattformen wie Amazon SageMaker, Google Vertex AI oder Azure Machine Learning betreiben dieselben Frameworks auf gemieteter Hardware, sodass Sie mit maschinellem Lernen auf AWS oder einer anderen Cloud beginnen können, ohne GPUs zu kaufen. Wie Sie Rechenleistung mieten, zeigt GPU-Infrastruktur für KI in Level 3.
Wann Sie das brauchen — und wann eine LLM-API reicht
Für die meisten KI-Funktionen in Apps trainieren Sie heute gar kein Modell. Sie rufen ein LLM über eine API auf, wie in Ihrem ersten LLM-API-Aufruf in Level 1. Ein eigenes Modell lohnt sich, wenn Sie viele gelabelte Beispiele haben, eine enge Aufgabe millionenfach wiederkehrt oder Daten Ihre Server nicht verlassen dürfen.
| Ihre Aufgabe | Meist die bessere Wahl | Warum |
|---|---|---|
| Support-Tickets auf fünf Abteilungen verteilen | Ein LLM mit klaren Anweisungen, später ein kleines Klassifikationsmodell | Schnell gestartet; ein trainiertes Modell ist bei großen Mengen günstiger |
| Betrug in Zahlungsdaten erkennen | Ein klassisches Modell auf der Tabelle | Braucht Tempo und Erklärbarkeit und arbeitet mit Zahlen, nicht mit Text |
| Produkte auf Regalfotos zählen | Ein Modell zur Objekterkennung wie YOLO | Findet und verortet viele Objekte je Bild, in Echtzeit |
| Fragen zu Ihren Dokumenten beantworten | Ein LLM mit Retrieval (RAG) | Nutzt Ihre Texte ganz ohne Training |
| Maschinenausfälle aus Sensordaten vorhersagen | Ein klassisches Modell oder ein Folgenmodell | Arbeitet mit Zeitreihen; dafür sind LLMs nicht gebaut |
Wenn Sie sich entscheiden, ein Modell anzupassen, beginnen Sie mit der Entscheidungshilfe Fine-Tuning, RAG oder Prompting in Level 3. Sie hilft Ihnen, den günstigsten funktionierenden Weg zu wählen, bevor Sie auch nur ein Trainingsbeispiel sammeln.