

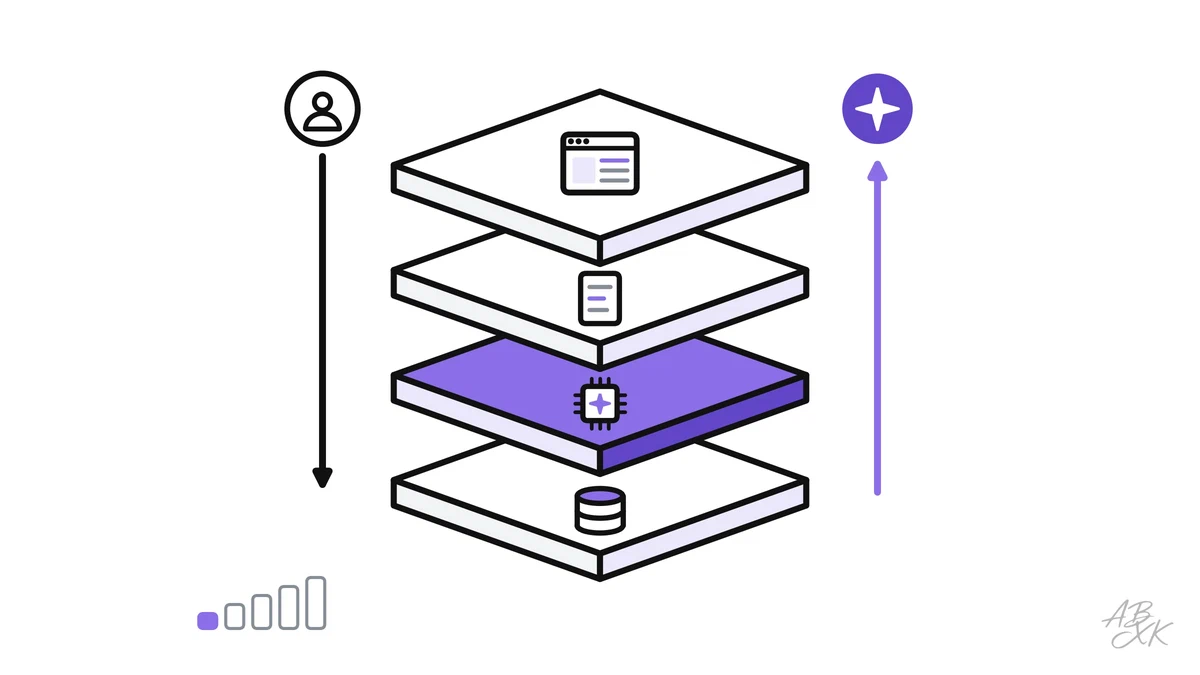
Sie stellen dem Support-Chat eines Onlineshops eine Frage und bekommen eine hilfreiche Antwort. Es wirkt, als spräche ein einziges kluges Programm mit Ihnen. Tatsächlich arbeiten sieben Teile zusammen, und nur einer davon ist das KI-Modell. Der Rest ist gewöhnliche Software, die entscheidet, was das Modell zu sehen bekommt und was mit seiner Antwort geschieht.
Dies ist Teil 2 von Level 0 unseres Lernpfads AI Development. Teil 1 hat einen Onlineshop beschrieben, der auf einem fertigen Modell einen Support-Assistenten aufbaut. Jetzt schauen Sie in eine solche App hinein: Sie lernen ihre sieben Teile kennen und verfolgen eine Kundenfrage durch alle Stationen. Programmierkenntnisse brauchen Sie dafür nicht.
Die sieben Teile einer KI-App
Fast jede KI-App besteht aus denselben sieben Teilen — ob Support-Bot, Schreibhilfe oder E-Mail-Sortierer. Die Namen stammen aus der Softwareentwicklung, die Ideen dahinter sind einfach.
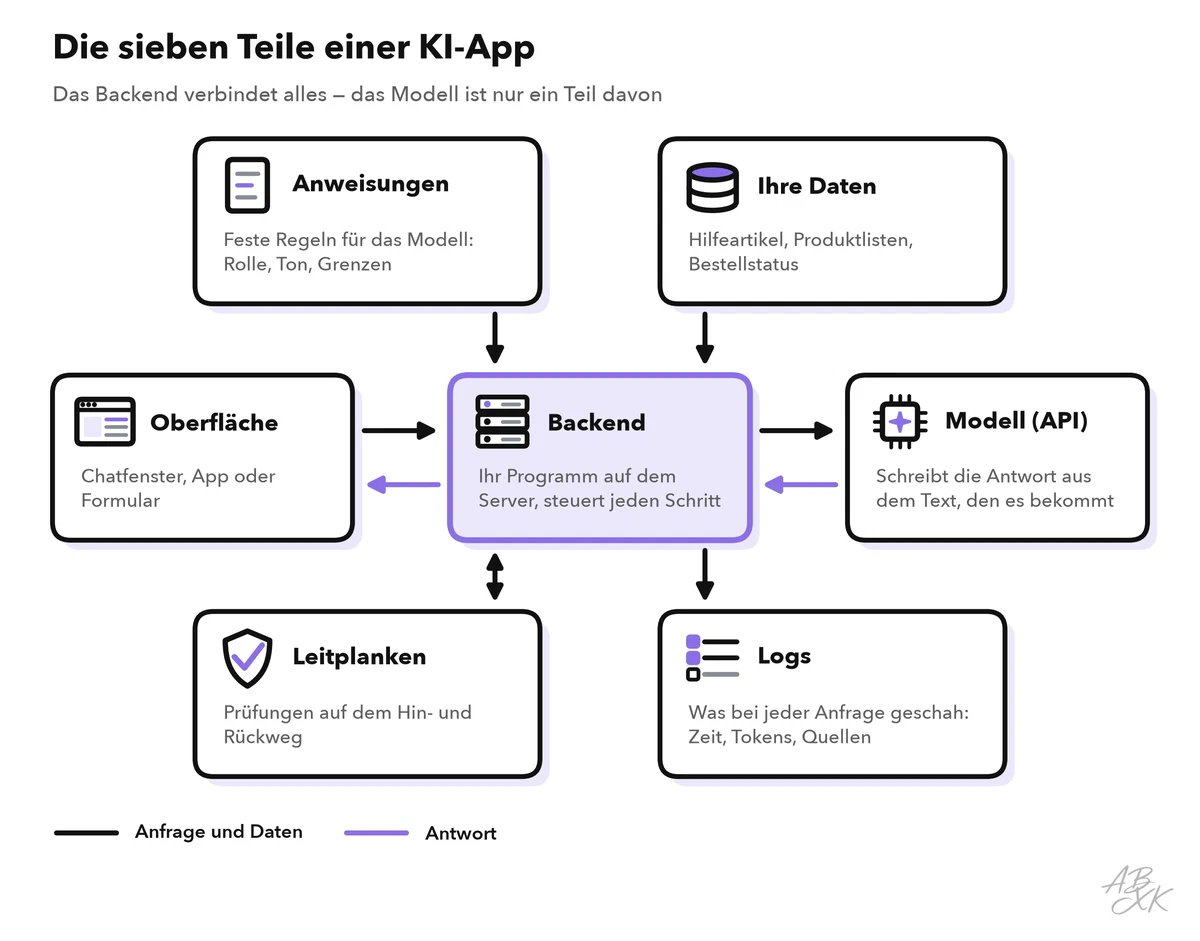
Die Oberfläche (englisch User Interface, kurz UI) ist das, was Menschen sehen und bedienen: ein Chatfenster, ein Formular oder eine Schaltfläche in einer App. Das Backend ist Ihr Programm auf einem Server. Es nimmt jede Anfrage entgegen, sammelt, was das Modell braucht, und entscheidet, was mit der Antwort geschieht. Nutzer sehen das Backend nie — deshalb gehören Geheimnisse wie der API-Schlüssel dorthin. Eine API (Application Programming Interface, eine Programmierschnittstelle) ist die Tür, durch die ein Programm mit einem anderen spricht. Ihr Backend schickt Text an die API des Anbieters und bekommt Text zurück.
| Teil | Was er tut | Im Support-Bot |
|---|---|---|
| Oberfläche | Nimmt die Eingabe entgegen und zeigt das Ergebnis | Chatfenster auf der Website des Shops |
| Backend | Steuert jeden Schritt zwischen Nutzer und Modell | Ein kleines Programm auf dem Server des Shops |
| Anweisungen | Feste Regeln für das Modell: Rolle, Ton, Grenzen | „Antworten Sie nur auf Basis unserer Hilfeartikel.“ |
| Modell über API | Schreibt die Antwort aus dem Text, den es bekommt | Ein Sprachmodell eines Anbieters |
| Ihre Daten | Fakten, die das Modell nicht kennen kann | Hilfeartikel, Rückgaberegeln, Bestellstatus |
| Leitplanken | Prüfen Eingabe und Ausgabe anhand von Regeln | Kartennummern entfernen, falsche Zusagen stoppen |
| Logs | Halten fest, was bei jeder Anfrage geschah | Frage, genutzte Quellen, Tokens, Antwortzeit |
Sie müssen nicht jeden Teil selbst bauen. Hosting-Plattformen stellen die Oberfläche bereit, Vektordatenbanken speichern Ihre Daten so, dass sie sich nach Bedeutung durchsuchen lassen, und GPU-Clouds betreiben Modelle auf gemieteter Hardware. No-Code-Plattformen vereinen mehrere Teile an einem Ort. Hier sind vier Beispiele aus unserem Tool-Vergleich für AI Development, jeweils mit der Beschreibung des Anbieters:


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Das Modell ist nur ein Teil
Einsteiger halten das Modell oft für die App. In der Praxis hat das Modell eine eng umrissene Aufgabe: Es liest den Text, den es bekommt, und schreibt eine Antwort. Alles darum herum ist Aufgabe Ihrer App.
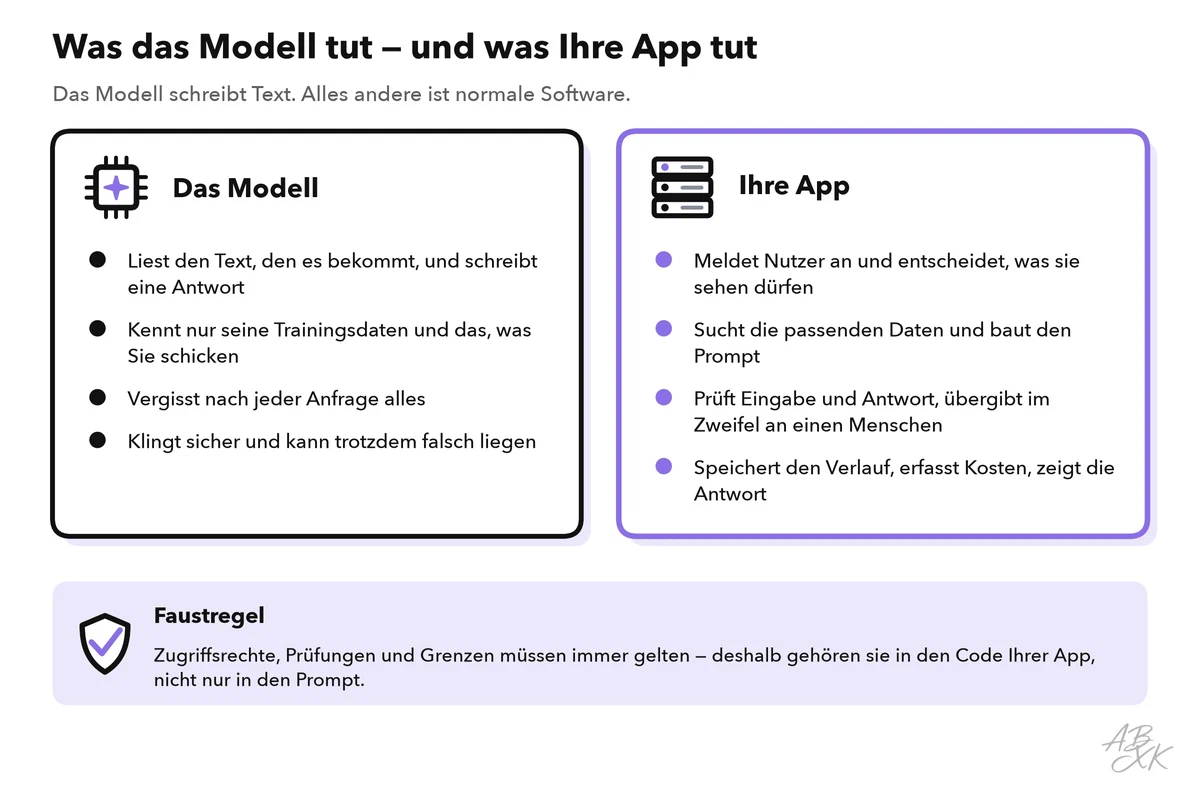
Zwei Tatsachen erklären, warum die anderen Teile nötig sind:
- Das Modell vergisst. Bei einer typischen Chat-API erinnert sich das Modell nicht an frühere Aufrufe. Ihr Backend schickt die Anweisungen, die passenden Daten und den bisherigen Gesprächsverlauf bei jeder Anfrage erneut mit.
- Das Modell rät, wenn es etwas nicht weiß. Steht die Rückgaberegel nicht im Text, den es bekommt, erfindet es womöglich eine, die plausibel klingt. Das nennt man Halluzination. Ihre Daten und Ihre Prüfungen sind die Abwehr dagegen.
Das Modell selbst ist austauschbar. Ihr Backend nennt das Modell bei jedem API-Aufruf, also können Sie zu einem anderen wechseln, ohne den Rest der App neu zu bauen. Testen müssen Sie trotzdem erneut, denn jedes Modell antwortet ein wenig anders. Unsere LLM-Datenbank führt 343 Modelle mit Erscheinungsdatum und Testergebnissen. Davon haben 172 offene Gewichte (Open Weights). Die Modelldateien sind veröffentlicht, Sie können diese Modelle also auch auf eigener oder gemieteter Hardware betreiben. Hier einige aktuelle Modelle verschiedener Anbieter:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Claude Sonnet 5.5 Anthropic | 28.09.2026 | geschlossen | 164,4 | 6 |
| GPT-6 Luna OpenAI | 22.09.2026 | geschlossen | 156,3 | 28 |
| Gemini 3.8 Flash Google DeepMind | 02.09.2026 | geschlossen | 157,2 | 19 |
| Kimi K3 Moonshot | 16.07.2026 | offen | 157,4 | 17 |




ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Eine Frage, von Anfang bis Ende
Verfolgen wir eine Anfrage durch den Support-Bot eines Onlineshops für Outdoor-Ausrüstung. Eine Kundin tippt: „Kann ich meine Wanderschuhe noch zurückgeben? Ich habe sie vor drei Wochen bekommen.“ Das passiert danach:
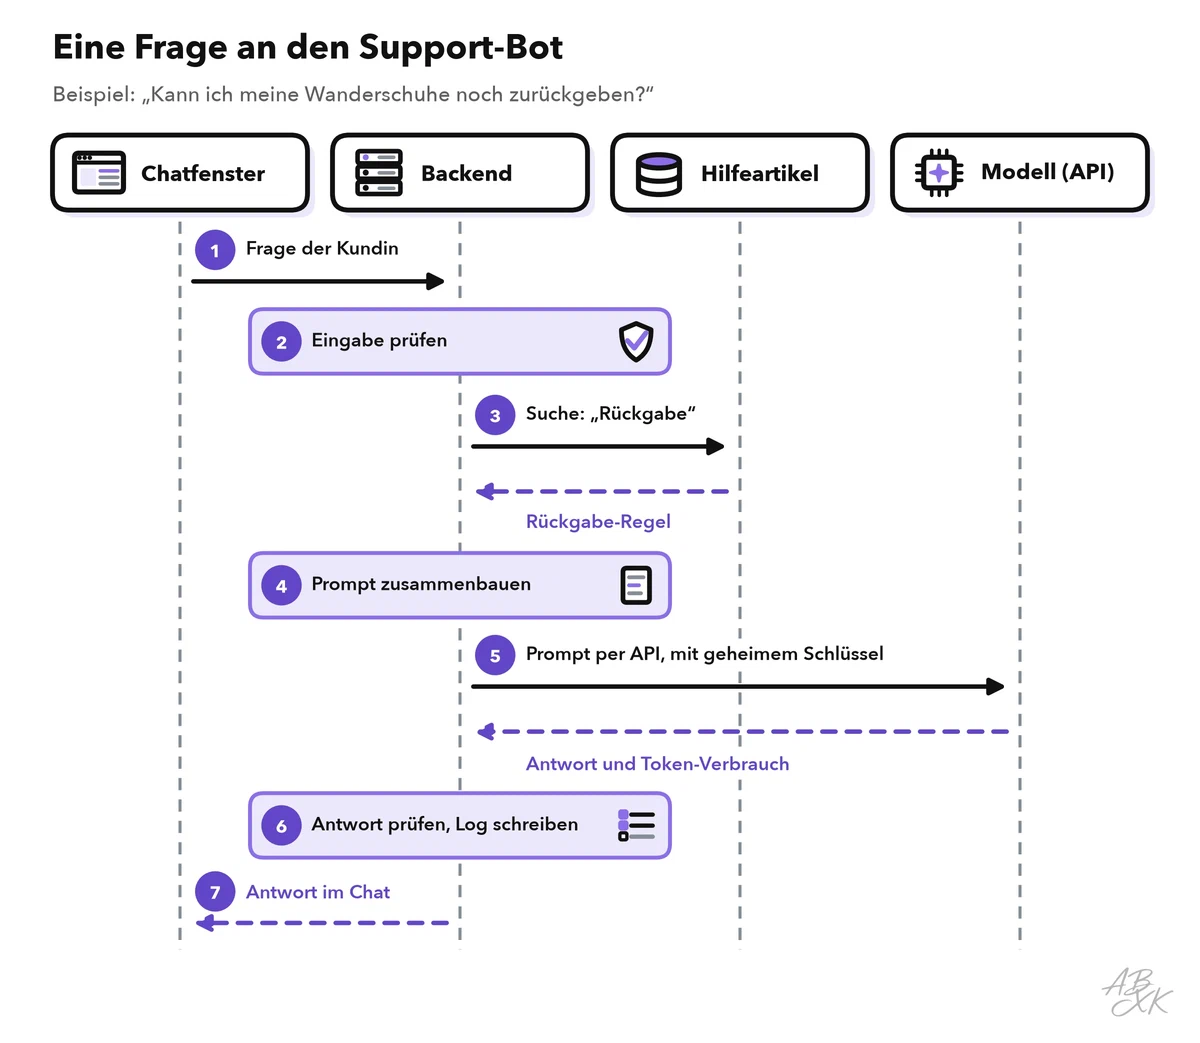
- Die Oberfläche schickt die Frage. Das Chatfenster übergibt den Text an das Backend, zusammen mit einer Kennung für dieses Gespräch.
- Das Backend prüft die Eingabe. Eine erste Leitplanke blockiert leere oder sehr lange Nachrichten. Außerdem entfernt sie Daten, die nicht in einen Prompt gehören, etwa eine Kreditkartennummer.
- Das Backend durchsucht Ihre Daten. Es sucht in den Hilfeartikeln des Shops nach „Rückgabe“ und bekommt den Abschnitt mit der Rückgaberegel zurück.
- Das Backend baut den Prompt. Es fügt die Anweisungen, den Abschnitt, den bisherigen Chat und die neue Frage zusammen.
- Das Backend ruft das Modell auf. Es schickt den Prompt und den geheimen API-Schlüssel an die API des Anbieters. Das Modell schreibt die Antwort und gibt sie mit der Zahl der verbrauchten Tokens zurück. Tokens sind die kleinen Textstücke, die Modelle lesen und schreiben; Anbieter rechnen pro Token ab.
- Das Backend prüft die Antwort und schreibt das Log. Hält sich die Antwort an die Regel? Verspricht sie etwas, das der Shop nicht anbietet? Schlägt die Prüfung fehl, schickt das Backend eine sichere Standardantwort oder übergibt den Chat an einen Menschen.
- Die Oberfläche zeigt die Antwort. Die Kundin liest, dass ungetragene Artikel innerhalb von 30 Tagen nach Lieferung zurückgegeben werden können — sie hat also noch Zeit.
Der ganze Ablauf dauert meist nur wenige Sekunden, und das Schreiben des Modells ist in der Regel der langsamste Teil. Deshalb zeigen viele Chatfenster die Antwort Wort für Wort, während sie entsteht. Das nennt man Streaming.
Erst den passenden Abschnitt nachschlagen und das Modell dann daraus antworten lassen: Dieses Muster heißt Retrieval-Augmented Generation (RAG). Level 2 erklärt RAG Schritt für Schritt.
Was das Modell wirklich bekommt
Die Kundin hat einen Satz getippt. Das Modell bekommt viel mehr: alles, was das Backend in Schritt 4 zusammengestellt hat.
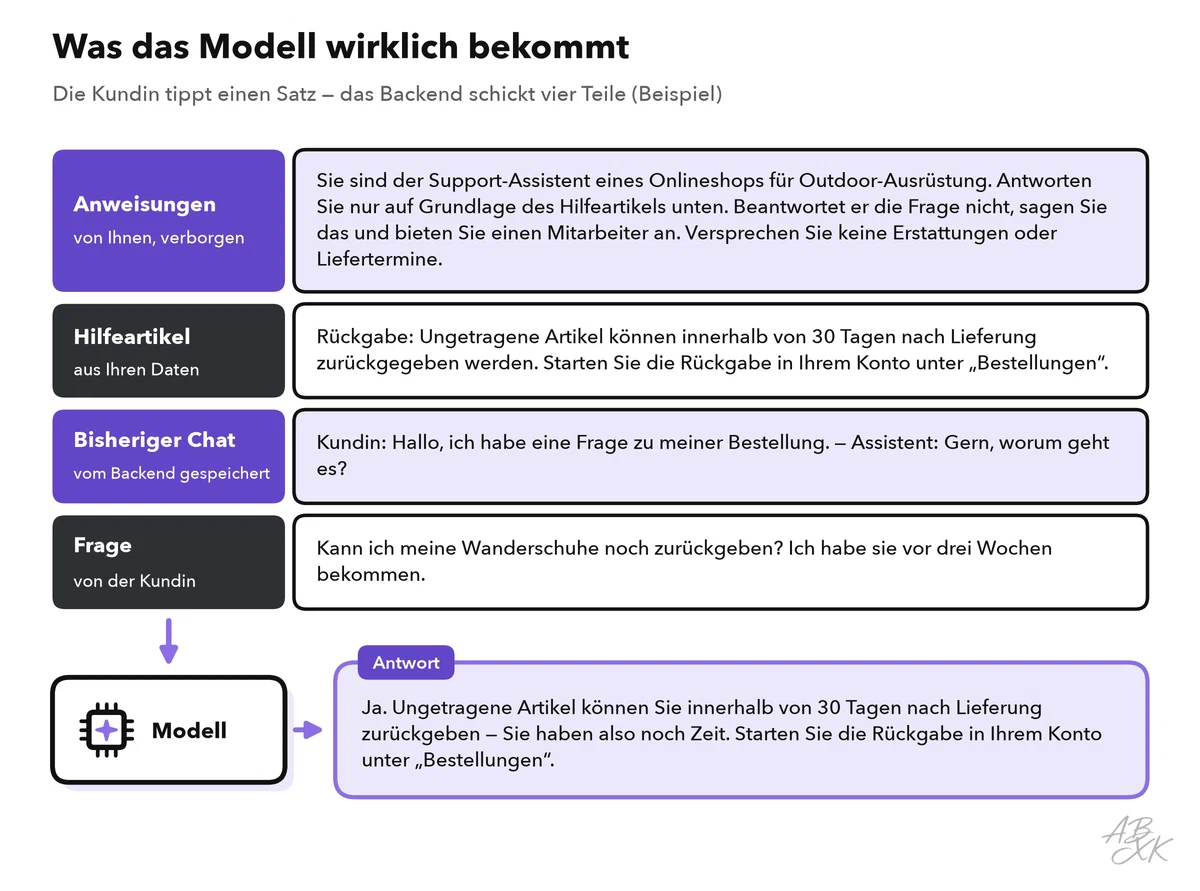
Drei Dinge fallen auf:
- Die Kundin sieht weder die Anweisungen noch den Hilfeartikel. Beides ist Teil Ihrer App. Die Anweisungen heißen oft System-Prompt.
- Die Fakten stammen aus Ihren Daten, nicht aus dem Gedächtnis des Modells. Ändert der Shop seine Rückgaberegel, aktualisiert er nur den Hilfeartikel. Der Bot antwortet ab dann richtig, ganz ohne neues Training.
- Jeder Teil kostet Tokens. Außerdem kann jedes Modell pro Anfrage nur eine begrenzte Textmenge verarbeiten, das Kontextfenster. Ein gutes Backend schickt, was die Frage braucht, nicht alles, was es hat. Teil 3 dieses Levels erklärt APIs, Tokens und Kontextfenster.
Leitplanken und Logs: die Teile, die Einsteiger vergessen
Eine Demo funktioniert ohne Leitplanken und Logs. Eine echte App mit echten Kunden nicht.
Leitplanken (englisch Guardrails) sind Prüfungen und Grenzen rund um das Modell. Sie wirken an drei Stellen:
- Vor dem Modell: Begrenzen Sie die Länge, blockieren Sie Missbrauch und entfernen Sie personenbezogene Daten, die das Modell nicht braucht.
- Rund um Ihre Daten: Geben Sie dem Modell nur, was der aktuelle Nutzer sehen darf. Könnte ein Support-Bot alle Bestellungen lesen, würde eine geschickte Frage womöglich die Adresse einer Kundin einem anderen Kunden verraten. Das Backend, nicht das Modell, entscheidet, welche Bestelldaten in den Prompt kommen — und erst, nachdem sich die Kundin angemeldet hat.
- Nach dem Modell: Prüfen Sie die Antwort, bevor jemand sie sieht, etwa auf Zusagen, die der Shop nicht macht, oder auf Links, die es nicht gibt. Im Zweifel übernimmt ein Mensch.
Manche Nutzer werden auch versuchen, den Bot von seinen Regeln abzubringen, etwa mit einer Nachricht, die ihn auffordert, seine Anweisungen zu ignorieren. Das nennt man Prompt Injection. Anweisungen allein verhindern das nicht zuverlässig, deshalb muss der Schutz aus der App selbst kommen: begrenzte Daten, begrenzte Aktionen und Prüfungen im Code. Unser Bereich AI Security behandelt die Abwehr ausführlicher.
Logs (Protokolle) halten fest, was bei jeder Anfrage geschah: Zeit, Modell, Tokens, Antwortzeit, genutzte Quellen und Bewertungen der Nutzer. Mit Logs finden Sie heraus, warum der Bot falsch geantwortet hat, was ein Gespräch kostet und ob ein neuer Prompt etwas verbessert oder verschlechtert hat. Logs enthalten oft personenbezogene Daten. Speichern Sie deshalb nur, was Sie brauchen, beschränken Sie, wer sie lesen darf, und löschen Sie sie nach einer festen Frist.
Übung: Nehmen Sie eine KI-App auseinander, die Sie schon nutzen
Wählen Sie eine KI-Funktion, die Sie verwenden: einen Support-Chat, die KI-Schaltfläche in Ihrem E-Mail-Programm oder einen Schreibassistenten. Versuchen Sie, diese Fragen dafür zu beantworten. Sie werden nicht jede Antwort finden — und genau das gehört zur Lektion: Die meisten Teile einer KI-App sind im Backend verborgen.
| Frage | Der Teil, den sie zeigt |
|---|---|
| Wo tippe ich, und wo erscheint die Antwort? | Oberfläche |
| Bleibt die Funktion beim Thema oder lehnt sie manche Anfragen ab? | Anweisungen und Leitplanken |
| Weiß sie Dinge, die ein allgemeiner Chatbot nicht wüsste, etwa meine Bestellungen oder Firmendokumente? | Ihre Daten |
| Nennt sie das Modell oder den Anbieter? | Modell über API |
| Kann ich Antworten bewerten oder frühere Chats sehen? | Logs und gespeicherter Verlauf |