

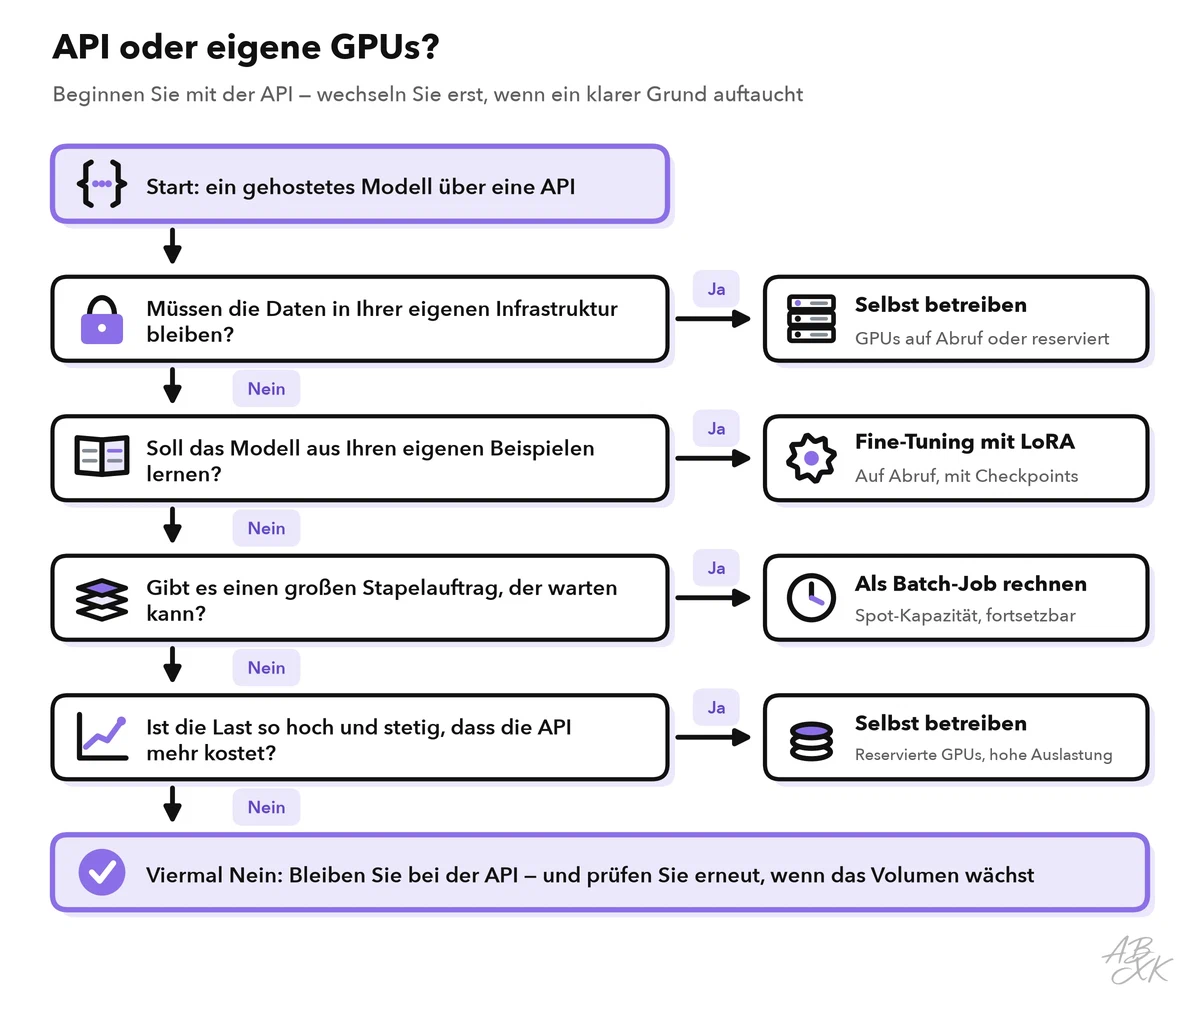
Die meisten KI-Apps kommen nie mit einer GPU in Berührung. Sie rufen ein Modell über eine API auf, und der Anbieter betreibt die Hardware. Das ändert sich, wenn Sie ein Modell per Fine-Tuning anpassen, ein Modell mit offenen Gewichten selbst betreiben oder Millionen Dokumente in einem Durchlauf verarbeiten. Dann mieten Sie Rechenleistung — und die Rechnung hängt von Entscheidungen ab, die Sie treffen, bevor der erste Job startet.
Dies ist Teil 3 von Level 3 (Profi). Sie lernen, wann Sie wirklich GPUs brauchen, wie Sie den GPU-Speicher aus der Modellgröße abschätzen, welche Mietform zu welcher Last passt und wie Sie die Auslastung hoch und die Kosten im Griff halten. Wir erklären die Kostenlogik, keine Preise.
Wann Sie GPUs brauchen — und wann nicht
Eine GPU (Graphics Processing Unit, also ein Grafikprozessor) hat Tausende kleiner Rechenkerne und sehr schnellen Speicher. Deshalb eignet sie sich für die Matrizenrechnungen in neuronalen Netzen. Der Speicher auf der Karte heißt VRAM, und er entscheidet, welche Modelle Sie ausführen können.
Eigene GPUs, gemietet oder gekauft, brauchen Sie in vier Situationen:
- Fine-Tuning: Sie trainieren ein Modell mit offenen Gewichten auf Ihren eigenen Beispielen weiter. Manche Anbieter passen auch ausgewählte geschlossene Modelle als Dienst für Sie an; dann sind die GPUs deren Sache. Teil 4 dieses Levels hilft bei der Wahl zwischen Fine-Tuning, RAG und Prompting.
- Selbstbetrieb: Daten dürfen Ihre Infrastruktur nicht verlassen, oder Sie brauchen volle Kontrolle über die Modellversion.
- Batch-Jobs: Sie berechnen Embeddings für ein großes Archiv oder ordnen Millionen Datensätze ein, und die gleichmäßige Last hält die GPU beschäftigt.
- Training von Grund auf: außerhalb von Forschungslaboren und großen Unternehmen selten.
Keine GPUs brauchen Sie, wenn Sie einen Prototyp bauen, wenn wenige oder unregelmäßige Anfragen kommen oder wenn das beste Modell für Ihre Aufgabe nur über eine API verfügbar ist. Eine gehostete API macht aus Fixkosten Kosten pro Anfrage, und um Updates, Skalierung und Ausfälle kümmert sich jemand anderes. Mit eigenen GPUs wandert diese Arbeit zu Ihrem Team: Treiber- und Sicherheitsupdates, Monitoring, Reserven für Lastspitzen und ein Plan für den Tag, an dem eine Maschine ausfällt.
Modelle mit offenen Gewichten sind die üblichen Kandidaten für den Selbstbetrieb. Unsere LLM-Datenbank führt 172 Modelle mit offenen Gewichten, mit Erscheinungsdatum und Testergebnissen. Offene Gewichte bedeuten nicht immer freie Nutzung: Manche Lizenzen schränken die kommerzielle Nutzung ein oder stellen andere Bedingungen. Lesen Sie deshalb die Lizenz, bevor Sie auf einem Modell aufbauen.
GPU-Speicher: eine Faustregel
Die erste Frage lautet, ob das Modell in den GPU-Speicher passt. Für die Gewichte des Modells liefert eine einfache Formel eine gute Schätzung:
Speicher für die Gewichte (GB) ≈ Parameter (in Milliarden) × Bytes je Parameter
Jeder Parameter belegt in 16-Bit-Genauigkeit (FP16 oder BF16) 2 Bytes, in 8 Bit 1 Byte und in 4 Bit etwa ein halbes Byte. Gewichte mit weniger Bits zu speichern, heißt Quantisierung. Sie spart Speicher und beschleunigt oft die Inferenz, kann aber etwas Qualität kosten. Testen Sie sie deshalb an Ihrer eigenen Aufgabe.
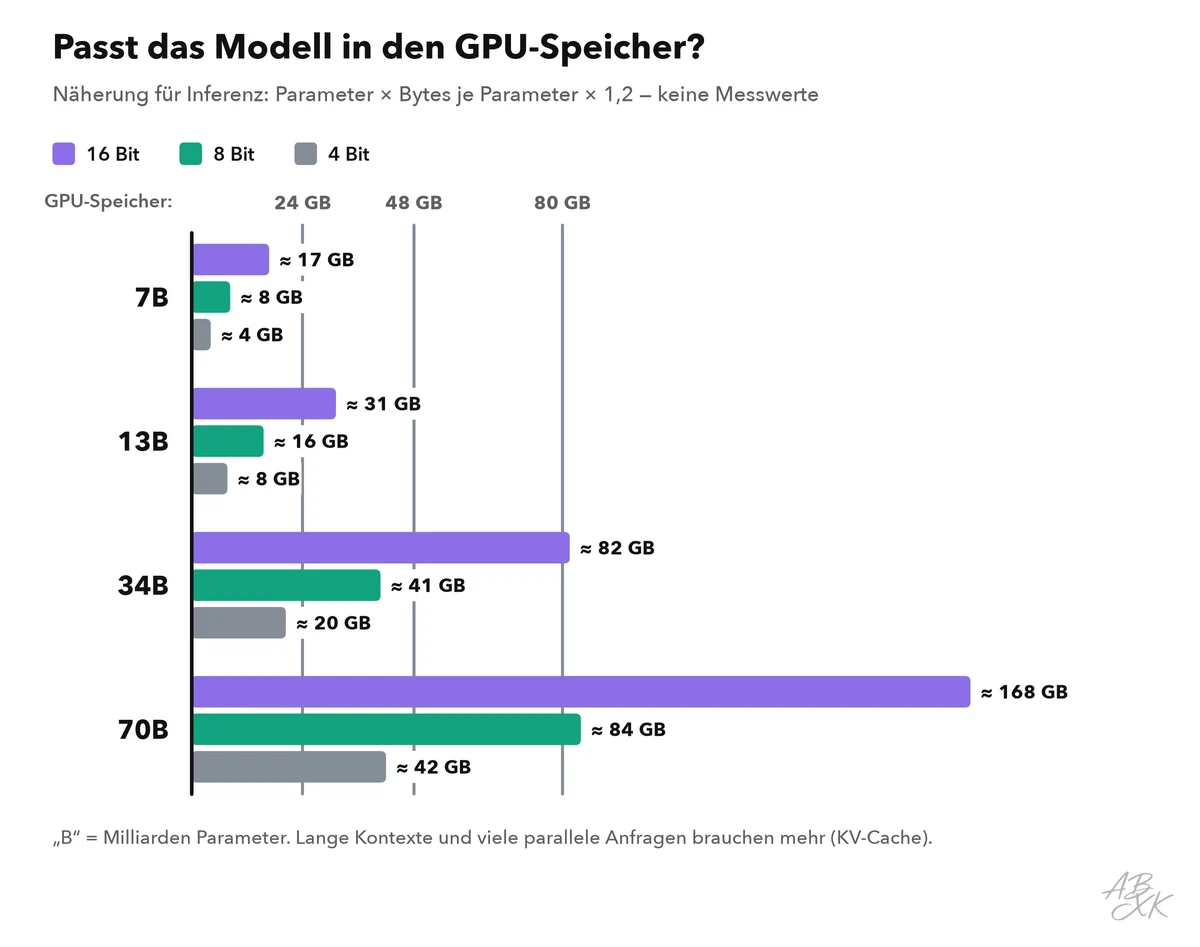
Für die Inferenz, also die Nutzung des Modells, reicht der Platz für die Gewichte nicht. Der KV-Cache speichert Zwischenergebnisse für den Text, den das Modell schon verarbeitet hat, damit es sie nicht für jedes neue Token neu berechnen muss. Er wächst mit der Kontextlänge und mit der Zahl der Anfragen, die parallel laufen. Für eine schnelle Prüfung empfiehlt EleutherAI, für die Inferenz etwa das 1,2-Fache des Speichers der Gewichte einzuplanen (Quelle: EleutherAI, „Transformer Math 101“, 2023, blog.eleuther.ai). Das genügt für kurze Prompts und wenige parallele Anfragen. Lange Kontexte und viele gleichzeitige Nutzer können deutlich mehr brauchen.
| Modellgröße | 16 Bit | 8 Bit | 4 Bit | Volles Fine-Tuning (~16 Bytes je Parameter) |
|---|---|---|---|---|
| 7B | ~14 GB | ~7 GB | ~3,5 GB | ~112 GB |
| 13B | ~26 GB | ~13 GB | ~6,5 GB | ~208 GB |
| 34B | ~68 GB | ~34 GB | ~17 GB | ~544 GB |
| 70B | ~140 GB | ~70 GB | ~35 GB | ~1.120 GB |
Die Tabelle zeigt grobe Näherungen, nur für die Gewichte; „B“ steht für Milliarden (englisch billion) Parameter. Viele verbreitete GPUs haben 24, 48 oder 80 GB Speicher, die neuesten Rechenzentrumsmodelle mehr. Das Diagramm schlägt die 20 Prozent für die Inferenz auf und zeigt, welche Kombinationen passen:
Training braucht weit mehr. Volles Fine-Tuning mit dem verbreiteten Adam-Optimierer in gemischter Genauigkeit (Mixed Precision) braucht etwa 16 Bytes je Parameter für Gewichte, Gradienten und Optimiererzustände (Quelle: Rajbhandari u. a., „ZeRO“, Microsoft, 2020). Dazu kommen die Aktivierungen, die Zwischenergebnisse jedes Trainingsschritts. Deshalb nutzen die meisten Teams LoRA (Low-Rank Adaptation): Das Basismodell bleibt eingefroren, und nur kleine Adapter-Matrizen werden trainiert (Quelle: Hu u. a., „LoRA“, Microsoft, 2021). QLoRA geht einen Schritt weiter und lädt das Basismodell in 4 Bit. Die Autoren haben damit ein Modell mit 65 Milliarden Parametern auf einer einzigen GPU mit 48 GB per Fine-Tuning angepasst (Quelle: Dettmers u. a., „QLoRA“, 2023).
Vier Wege, GPUs zu mieten
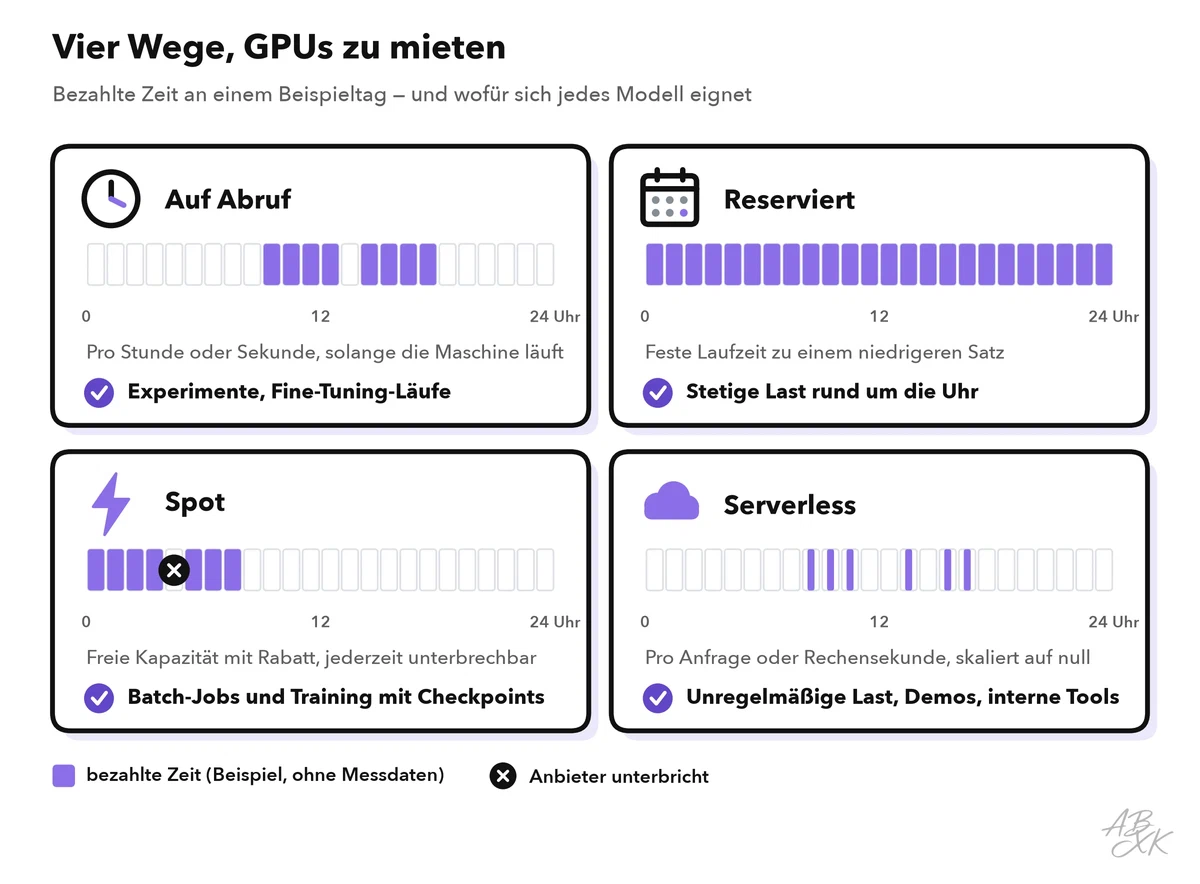
GPU-Clouds bieten verschiedene Abrechnungsmodelle. Welches passt, hängt davon ab, wie planbar Ihre Last ist.
| Abrechnungsmodell | So zahlen Sie | Passt für | Achten Sie auf |
|---|---|---|---|
| Auf Abruf (On-Demand) | Pro Stunde oder Sekunde, solange die Maschine läuft | Experimente, Fine-Tuning-Läufe, unregelmäßige Jobs | Sie zahlen auch, wenn die GPU nichts tut |
| Reserviert | Feste Zusage für einen Zeitraum, zu einem niedrigeren Satz | Stetige Last rund um die Uhr | Sie zahlen für Kapazität, die Sie nicht nutzen |
| Spot / unterbrechbar | Freie Kapazität mit Rabatt | Batch-Jobs und Training mit Checkpoints | Der Anbieter kann die Maschine jederzeit stoppen |
| Serverless | Pro Anfrage oder Sekunde Rechenzeit; skaliert auf null | Unregelmäßige Last, Demos, interne Tools | Kaltstarts: Ein großes Modell zu laden, dauert |
Ein Checkpoint speichert den Stand eines Trainingslaufs in regelmäßigen Abständen. So kann ein unterbrochener Job weiterlaufen, statt von vorn zu beginnen. Ohne Checkpoints ist Spot-Kapazität ein Glücksspiel.
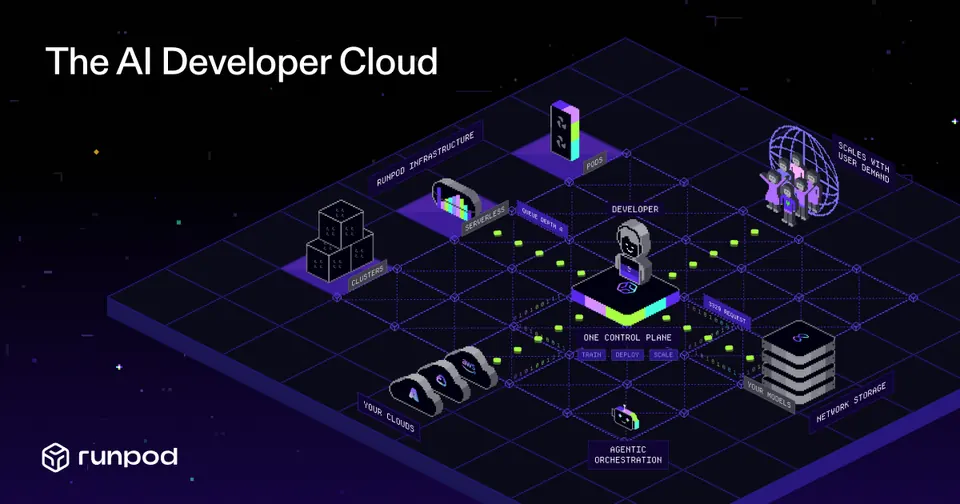
Runpod aus unserem Vergleich der Infrastruktur-Tools ist eine GPU-Cloud dieser Art. Nach Angaben des Anbieters bietet sie GPUs auf Abruf und serverlose Rechenleistung, abgerechnet nach Nutzung:
Auslastung: die Zahl, die über Ihre Kosten entscheidet
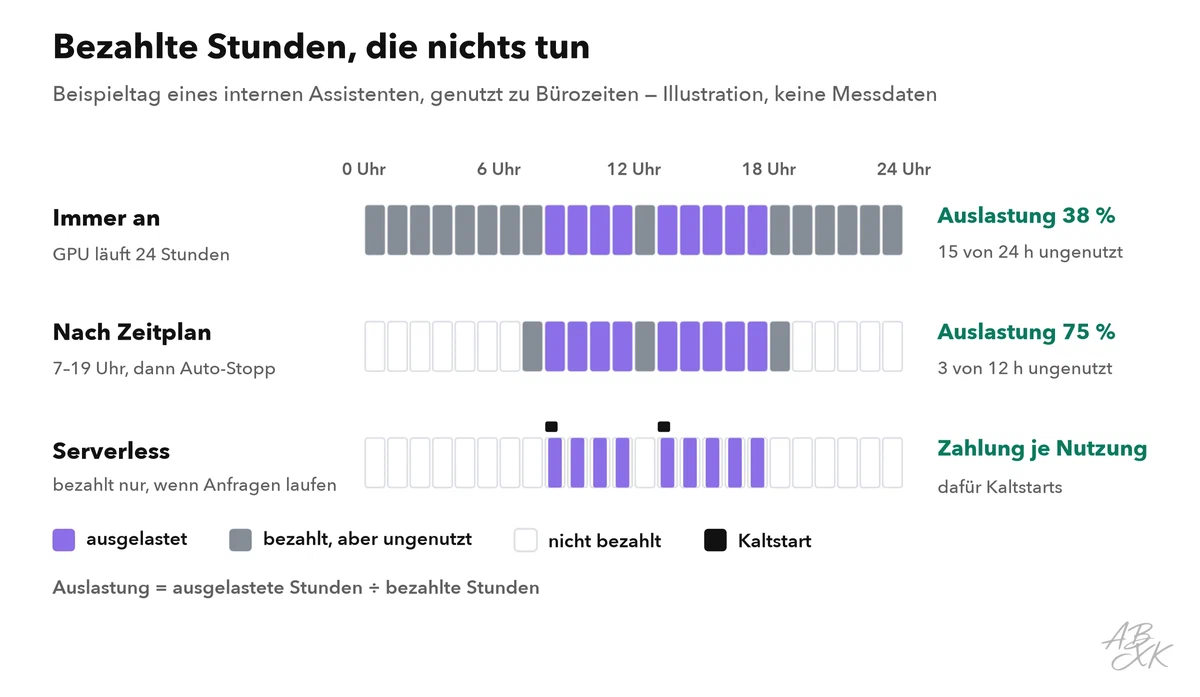
Die Auslastung ist der Anteil der bezahlten GPU-Zeit, der nützliche Arbeit leistet. Bei stundenweiser Abrechnung kostet eine untätige GPU so viel wie eine beschäftigte. Stellen Sie sich einen internen Assistenten vor, der auf einer GPU im Dauerbetrieb läuft, aber nur zu Bürozeiten Anfragen bekommt: Die meisten bezahlten Stunden bleiben ungenutzt.
Drei Hebel erhöhen die Auslastung:
- Batching: Die GPU verarbeitet mehrere Anfragen gleichzeitig. Der Durchsatz steigt, und jede einzelne Anfrage wartet etwas länger. Open-Source-Inferenzserver wie vLLM nehmen neue Anfragen fortlaufend in einen Batch auf, der gerade verarbeitet wird. Außerdem legen sie den KV-Cache in kleinen Blöcken ab, sodass mehr Anfragen in denselben Speicher passen (Quelle: Kwon u. a., „PagedAttention“, SOSP 2023).
- Passende Größe: Ein 7B-Modell in 4 Bit braucht nicht die größte GPU. Wählen Sie die kleinste Karte, auf die das Modell mit Reserve passt.
- Zeitplanung: Lassen Sie Batch-Jobs nachts auf denselben GPUs laufen, und stoppen Sie Maschinen außerhalb der Arbeitszeit.
Messen Sie, was Sie für Ihr Geld bekommen: GPU-Auslastung und Speicherbelegung (zum Beispiel mit dem Tool nvidia-smi), Tokens pro Sekunde, Anfragen pro Stunde und Wartezeit in der Warteschlange. Die wichtigste betriebswirtschaftliche Zahl sind die Kosten pro Anfrage oder pro erfolgreich erledigter Aufgabe: die Kosten einer Stunde geteilt durch die Anfragen, die die GPU in dieser Stunde bedient hat. Vergleichen Sie diesen Wert jeden Monat mit den Kosten derselben Arbeit über eine API. Unser Artikel So senken wir KI-Entwicklungskosten zeigt weitere Hebel.
Praxisbeispiel: ein nächtlicher Batch-Job auf einer gemieteten GPU
Ein Support-Team ordnet jedes neue Ticket nach Thema und Dringlichkeit ein. Heute schickt die App jedes Ticket an eine gehostete API. Inzwischen kommen Zehntausende Tickets pro Nacht, die Aufgabe ist eng umrissen, und niemand braucht das Ergebnis innerhalb von Sekunden. Damit ist sie ein guter Kandidat für eine gemietete GPU. Das Team prüft das in sechs Schritten:
- Ausgangswert: die Genauigkeit an 300 Tickets messen, die Menschen von Hand eingeordnet haben, dazu die Kosten pro 1.000 Tickets mit der bisherigen API.
- Kandidatenmodell: ein Modell mit offenen Gewichten und etwa 8 Milliarden Parametern, getestet mit demselben Prompt. Ist der Prompt allein nicht genau genug, folgt Fine-Tuning mit LoRA; Teil 4 dieses Levels vergleicht die Möglichkeiten.
- Speicher: 8 Milliarden × 1 Byte in 8 Bit ≈ 8 GB, plus etwa 20 Prozent ≈ 10 GB. Eine GPU mit 24 GB lässt Platz für Batching.
- Abrechnungsmodell: Der Job läuft einmal pro Nacht und kann beim letzten fertigen Ticket weitermachen. Spot-Kapazität oder GPUs auf Abruf mit Auto-Stopp passen beide; eine ständig laufende GPU passt nicht.
- Messen: Tickets pro Stunde auf der GPU. Kosten pro 1.000 Tickets = Kosten pro Stunde ÷ Tickets pro Stunde × 1.000.
- Entscheiden: Gewechselt wird nur, wenn die Genauigkeit bei den 300 Test-Tickets mindestens so gut ist wie vorher und die Kosten pro 1.000 Tickets deutlich niedriger liegen — einschließlich der Stunden, die das Team in den Betrieb steckt.
Die Zahlen in diesem Beispiel dienen der Veranschaulichung; entscheiden müssen Ihre eigenen Messungen. Behalten Sie die API in den ersten Wochen als Rückfallebene, damit eine gescheiterte Nacht keine Tickets unbearbeitet lässt.
Checkliste zur Kostenkontrolle
Bevor Sie Ihre erste GPU mieten, richten Sie diese Kontrollen ein:
- Budget und Warnungen je Projekt, mit einem harten Limit, wo der Anbieter eines unterstützt.
- Auto-Stopp für untätige Maschinen und Entwicklungsumgebungen.
- Labels an jeder Ressource, damit Sie sehen, welches Projekt welche Kosten verursacht.
- Speicher aufräumen: Volumes und Snapshots kosten weiter Geld, auch wenn die GPU aus ist.
- Checkpoints für jeden Trainingslauf, der länger als eine Stunde dauert.
- Quantisierung testen, bevor Sie eine größere GPU wählen.
- Trennung: Website und Datenbank bleiben auf normalem Hosting, nur das Modell kommt auf GPUs.
- Ein monatlicher Vergleich der Kosten pro Aufgabe mit einer gehosteten API.
Punkt 7 wird leicht übersehen. Die Web-App um ein Modell herum — Frontend, Benutzerkonten, Datenbank — läuft problemlos auf normalem Hosting, etwa auf einem Server, den Sie mit einem Kontrollpanel wie Plesk verwalten, oder auf einer Plattform wie Netlify. Nur der Inferenzdienst braucht die GPU, und der Leitfaden zum Selbstbetrieb in Level 4 zeigt, wie Sie ihn im Produktivbetrieb führen.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.