

Ihre KI-Funktion gibt falsche Antworten, ignoriert Ihr Format oder klingt überhaupt nicht nach Ihrem Unternehmen. Dafür gibt es drei Lösungswege. Sie können bessere Anweisungen schreiben (Prompting). Sie können dem Modell bei jeder Anfrage die passenden Dokumente mitgeben (Retrieval-Augmented Generation, RAG). Oder Sie trainieren das Modell mit eigenen Beispielen weiter (Fine-Tuning). Fine-Tuning klingt oft nach der gründlichen Lösung. In der Praxis macht es beim Aufbau und bei jeder Änderung die meiste Arbeit — und oft löst es das falsche Problem.
Dies ist Teil 4 von Level 3 (Profi). Sie lernen, was jede Methode verändert, welche Daten und welche Pflege sie braucht und wie die drei zusammenspielen. Ein Entscheidungsablauf und eine Tabelle mit Beispielen helfen bei der Wahl. Der Teil baut auf Prompt-Design für Entwickler aus Level 1 und RAG Schritt für Schritt aus Level 2 auf.
Drei Hebel an derselben Anfrage
Jede Antwort eines Sprachmodells hängt von zwei Dingen ab: was das Modell mit der Anfrage bekommt und was es im Training gelernt hat. Die drei Methoden setzen an verschiedenen Stellen an:
- Prompting ändert die Anweisungen: Systemprompt, Regeln, Beispiele und Ausgabeformat. Die Änderung wirkt ab der nächsten Anfrage.
- RAG ändert das Wissen in der Anfrage. Ihre App durchsucht Ihre Dokumente und fügt die passendsten Passagen in den Prompt ein. Das Modell selbst bleibt gleich.
- Fine-Tuning ändert das Modell. Sie trainieren es mit Paaren aus Eingabe und gewünschter Ausgabe weiter, und seine Gewichte — die Zahlen, die es im Training gelernt hat — verändern sich.
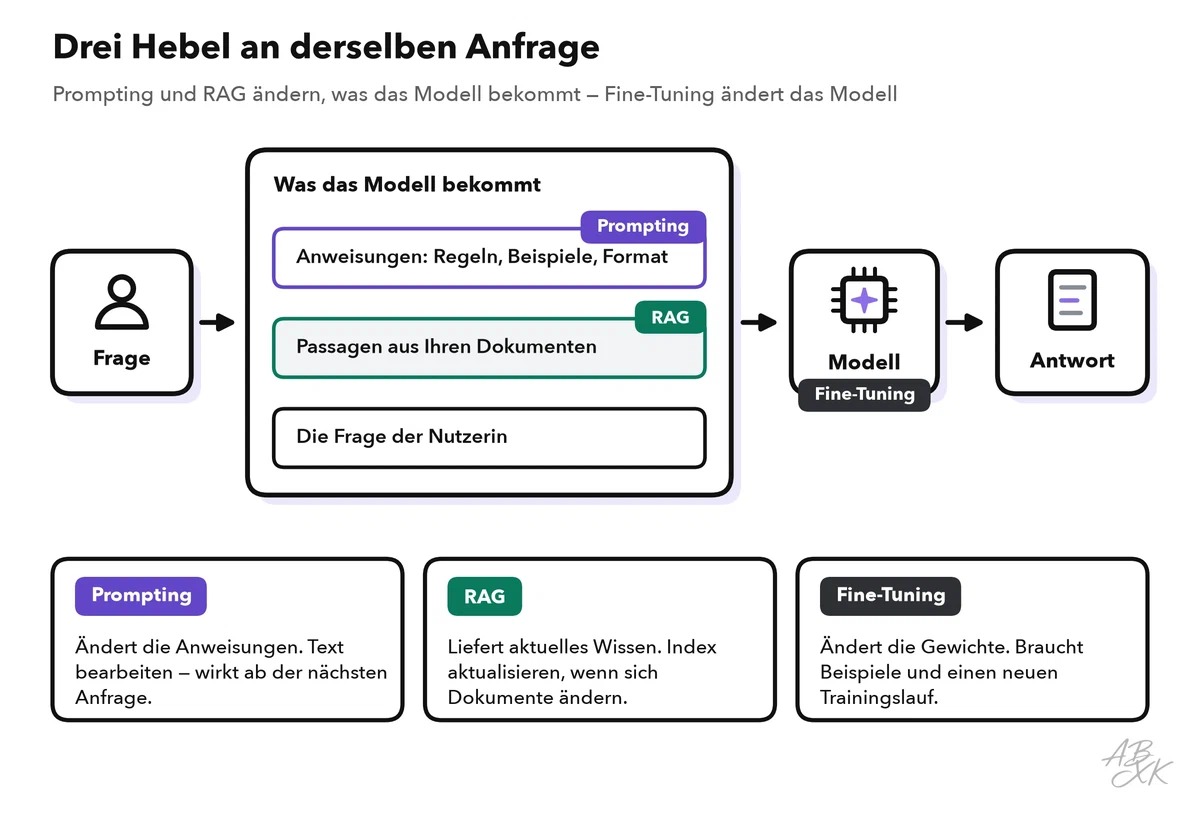
Dieser Unterschied erklärt die meisten Entscheidungen. Anweisungen und Wissen reisen mit jeder Anfrage mit, deshalb können Sie sie jederzeit ändern. Was ein Modell durch Fine-Tuning lernt, steckt in ihm selbst. Das kostet pro Anfrage keine zusätzlichen Tokens, aber jede Änderung braucht einen neuen Trainingslauf.
Fine-Tuning lehrt Verhalten, keine Fakten
Ein häufiger Fehler: Ein Modell wird per Fine-Tuning trainiert, damit es die eigenen Dokumente „kennt“. Die Forschung zeigt, warum das selten klappt. Eine Studie von Microsoft verglich zwei Wege, einem Modell Wissen beizubringen: RAG und Fine-Tuning auf den Dokumenten selbst. RAG schnitt besser ab als Fine-Tuning, sowohl bei Fakten, die das Modell schon gesehen hatte, als auch bei völlig neuen (Quelle: Ovadia u. a., „Fine-Tuning or Retrieval?“, EMNLP 2024). Eine zweite Studie fand heraus, dass Modelle neue Fakten durch Fine-Tuning nur langsam lernen — und dass sie danach eher halluzinieren (Quelle: Gekhman u. a., „Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?“, EMNLP 2024).
Stark ist Fine-Tuning dort, wo Prompts an ihre Grenzen kommen:
- Ein festes Format oder ein fester Stil, der über Tausende Anfragen halten muss, etwa eine Ticket-Notiz mit immer denselben fünf Feldern.
- Eine enge, sich wiederholende Aufgabe, etwa Texte in Kategorien einordnen oder Felder auslesen. Hier kann ein kleines Modell mit Fine-Tuning ein großes Allzweckmodell ersetzen.
- Kürzere Prompts: Verhalten, das lange Anweisungen und viele Beispiele brauchte, wandert ins Modell, und jede Anfrage braucht weniger Tokens.
- Verhalten, das sich schwer beschreiben, aber leicht zeigen lässt, etwa wie Ihr Support-Team eine Anfrage höflich ablehnt.
Riesige Datenmengen brauchen Sie nicht, aber gute Daten. In der LIMA-Studie trainierten Forschende von Meta ein großes Modell mit nur 1.000 sorgfältig ausgewählten Beispielen nach und erzielten starke Ergebnisse (Quelle: Zhou u. a., „LIMA: Less Is More for Alignment“, NeurIPS 2023). Saubere, einheitliche Beispiele zählen mehr als eine große Zahl unordentlicher.
Was jede Methode braucht und kostet
Die drei Methoden unterscheiden sich in Daten, Aufwand und Pflege:
| Prompting | RAG | Fine-Tuning | |
|---|---|---|---|
| Was sich ändert | Anweisungen in jeder Anfrage | Wissen in jeder Anfrage | Die Gewichte des Modells |
| Nötige Daten | Eine klare Aufgabe und einige Beispiele | Ihre Dokumente, aktuell gehalten | Viele einheitliche Paare aus Eingabe und gewünschter Ausgabe |
| Aufwand zum Start | Gering | Mittel: Index und Suchpipeline | Hoch: Daten sammeln, trainieren, bewerten |
| Laufende Kosten | Lange Prompts verbrauchen mehr Tokens | Suche plus längere Prompts | Trainingsläufe; Hosting bei offenen Gewichten |
| Wenn sich etwas ändert | Prompt bearbeiten | Index aktualisieren | Neu trainieren |
| Kann Quellen nennen | Nur aus Text im Prompt | Ja, aus den abgerufenen Passagen | Nein |
| Typischer Fehler | Lange Prompts mit widersprüchlichen Regeln | Falsche oder fehlende Passagen | Lernt Fehler aus den Daten; verliert allgemeine Fähigkeiten |
Die letzte Zeile braucht eine Erklärung. Ein Modell, das stark auf eine enge Aufgabe trainiert wird, kann bei anderen Aufgaben schlechter werden. Das heißt katastrophales Vergessen (Catastrophic Forgetting). LoRA, die Methode, die nur kleine Adapter-Matrizen trainiert, erhält mehr von den allgemeinen Fähigkeiten des Basismodells als volles Fine-Tuning — lernt dafür aber auch weniger von der neuen Aufgabe (Quelle: Biderman u. a., „LoRA Learns Less and Forgets Less“, TMLR 2024).
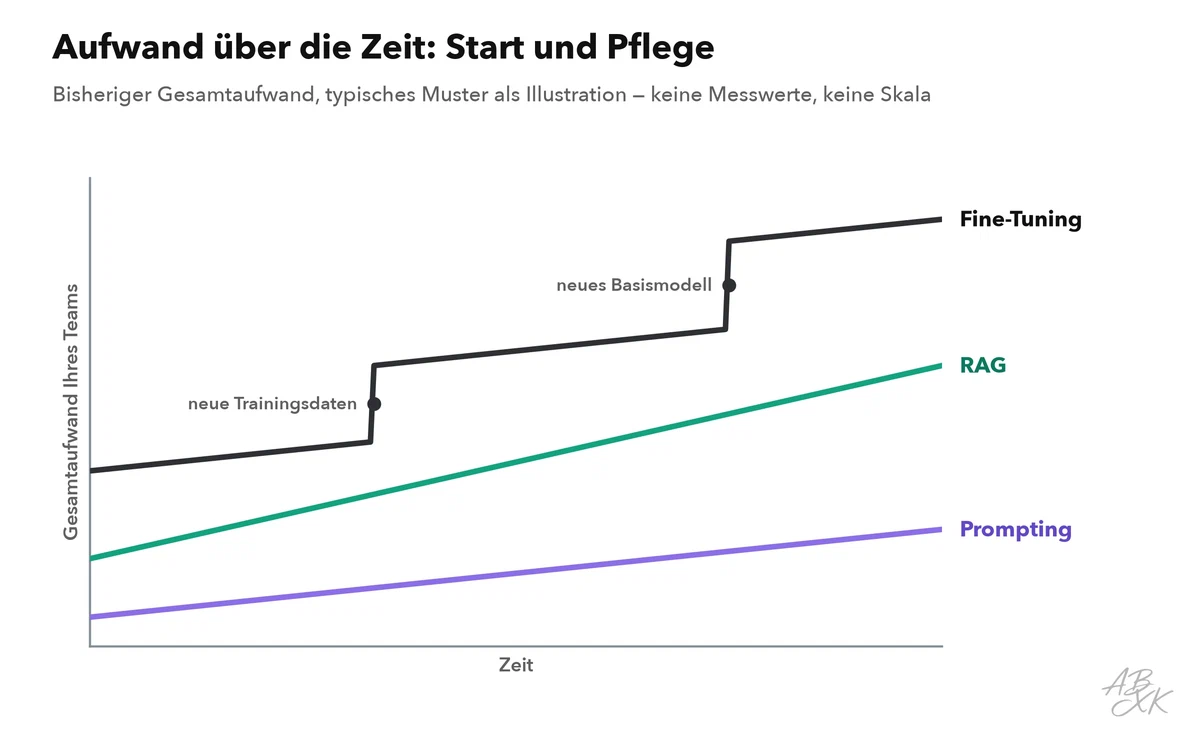
Auch über die Zeit unterscheidet sich der Aufwand. Prompting bleibt leicht änderbar. RAG braucht stetige Pflege für den Index. Fine-Tuning macht zu Beginn die meiste Arbeit, und die Arbeit kommt zurück, sobald sich Ihre Daten oder das Basismodell ändern:
Für RAG brauchen Sie eine Vektordatenbank, für das Fine-Tuning eines Modells mit offenen Gewichten GPUs. In unserem Vergleich ist Pinecone nach Angaben der Anbieter eine Vektordatenbank für Suche und Retrieval, und Runpod vermietet GPUs zum Trainieren und Betreiben von Modellen. Devs.ai ist eine Plattform, auf der Teams KI-Apps und Agenten mit ihren eigenen Daten bauen:


Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Mit Prompting beginnen, dann diagnostizieren
Die Reihenfolge zählt mehr als die Methode. Beginnen Sie mit dem günstigsten Hebel, und gehen Sie erst weiter, wenn Ihre Tests ein konkretes Problem zeigen. Bevor Sie etwas ändern, bauen Sie ein kleines Eval-Set: typische Eingaben mit den Antworten, die Sie erwarten, wie in KI-Funktionen mit Evals testen beschrieben. Ohne ein solches Set können Sie nicht erkennen, ob eine Änderung geholfen hat.
Sammeln Sie dann Antworten, die schiefgegangen sind, und sortieren Sie sie nach Ursache. Jede Ursache zeigt auf einen Hebel:
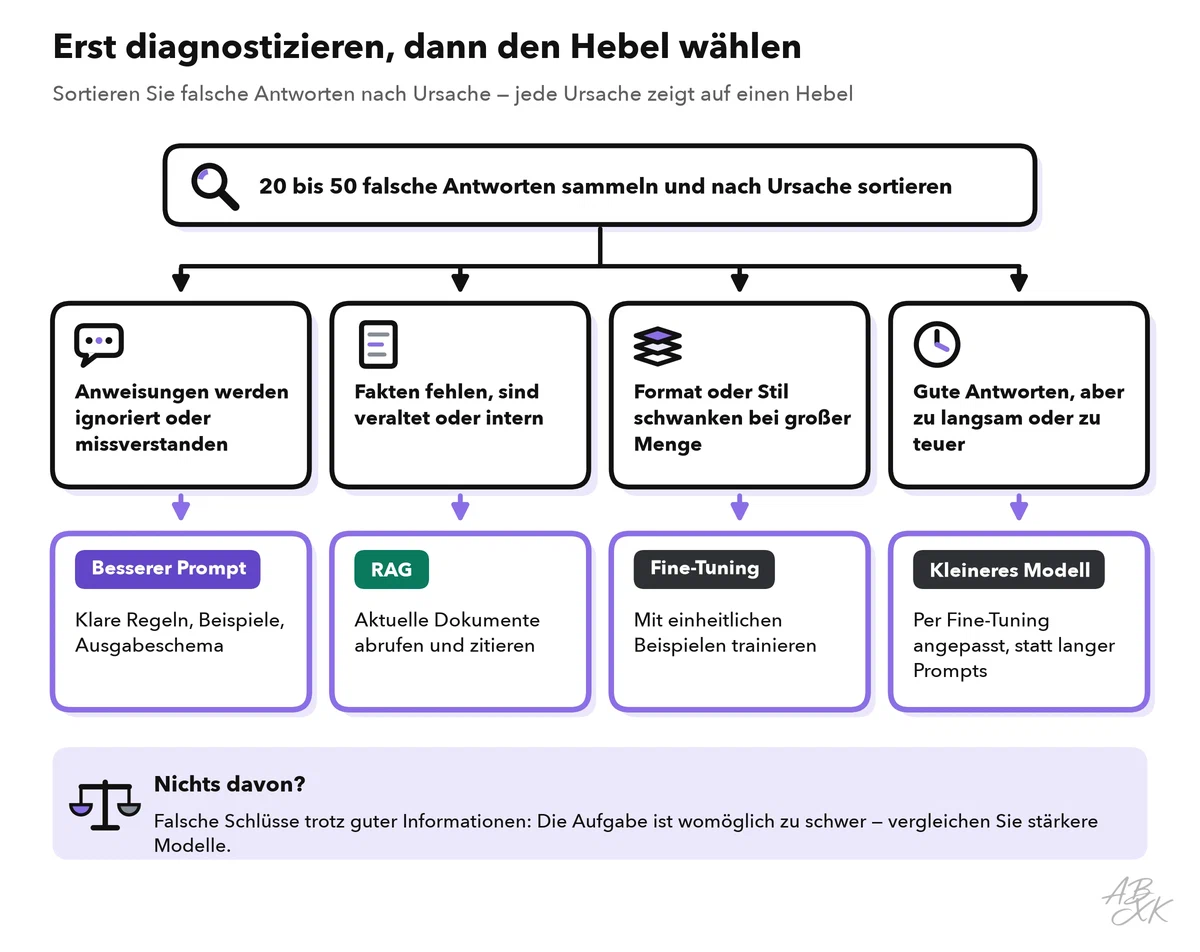
- Anweisungen ignoriert oder missverstanden? Verbessern Sie den Prompt: klarere Regeln, Beispiele, ein Ausgabeschema. Viele APIs erzwingen auf Wunsch auch ein JSON-Format, wie in Strukturierte Ausgabe und Function Calling gezeigt.
- Fakten fehlen, sind veraltet oder intern? Ergänzen Sie RAG. Das Modell braucht die Information im Moment der Anfrage.
- Format oder Stil schwanken über viele Anfragen, obwohl der Prompt klar ist? Jetzt lohnt sich ein Test mit Fine-Tuning.
- Gute Antworten, aber zu langsam oder zu teuer? Passen Sie ein kleineres Modell per Fine-Tuning an die Aufgabe an, damit es den langen Prompt nicht mehr braucht.
- Falsche Schlüsse trotz guter Informationen? Die Aufgabe ist womöglich zu schwer für das Modell. Vergleichen Sie stärkere Modelle in unserer LLM-Datenbank.
Fine-Tuning in der Praxis: geschlossene oder offene Modelle
Fine-Tuning geht auf zwei Wegen. Manche Anbieter bieten Fine-Tuning ausgewählter geschlossener Modelle als Dienst an: Sie laden Beispiele hoch, und der Anbieter trainiert und betreibt Ihre Version. Ein Modell mit offenen Gewichten trainieren Sie selbst — meist mit LoRA auf gemieteten GPUs — und betreiben das Ergebnis auch selbst. Teil 3 dieses Levels zeigt, wie Sie GPUs dafür dimensionieren und mieten.
Kleinere Modelle mit offenen Gewichten sind ein üblicher Ausgangspunkt, weil sie schnell trainieren und mit QLoRA auf eine einzige gemietete GPU passen. Die Zahl mit dem „B“ im Namen gibt ungefähr die Größe in Milliarden Parametern an. Einige Beispiele aus unserer LLM-Datenbank:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Llama 3.1-8B Meta AI | 23.07.2024 | offen | 116,6 | 215 |
| Qwen3.5-9B Alibaba | 24.02.2026 | offen | 139,4 | 124 |
| gpt-oss-20b OpenAI | 05.08.2025 | offen | 137,8 | 132 |
| Qwen 3.8 27B Alibaba | 14.08.2026 | offen | 151,6 | 52 |
| Gemma 4 31B IT Google DeepMind | 02.04.2026 | offen | 142,9 | 102 |



ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Prüfen Sie vor dem Start zwei Dinge. Die Lizenz entscheidet, ob Sie das Modell per Fine-Tuning anpassen und das Ergebnis kommerziell nutzen dürfen. Und die Testergebnisse des Basismodells setzen die Obergrenze: Fine-Tuning formt, wie ein Modell nutzt, was es schon gelernt hat. Aus einem schwachen Modell macht es kein starkes.
Ein Sonderfall ist die Destillation: Sie trainieren ein kleines Modell mit den Antworten eines großen, damit das kleine eine enge Aufgabe günstiger übernimmt. Prüfen Sie vorher die Bedingungen des Anbieters des großen Modells, denn manche verbieten, seine Ausgaben zum Training anderer Modelle zu nutzen.
Kombinieren: ein Assistent, drei Schichten
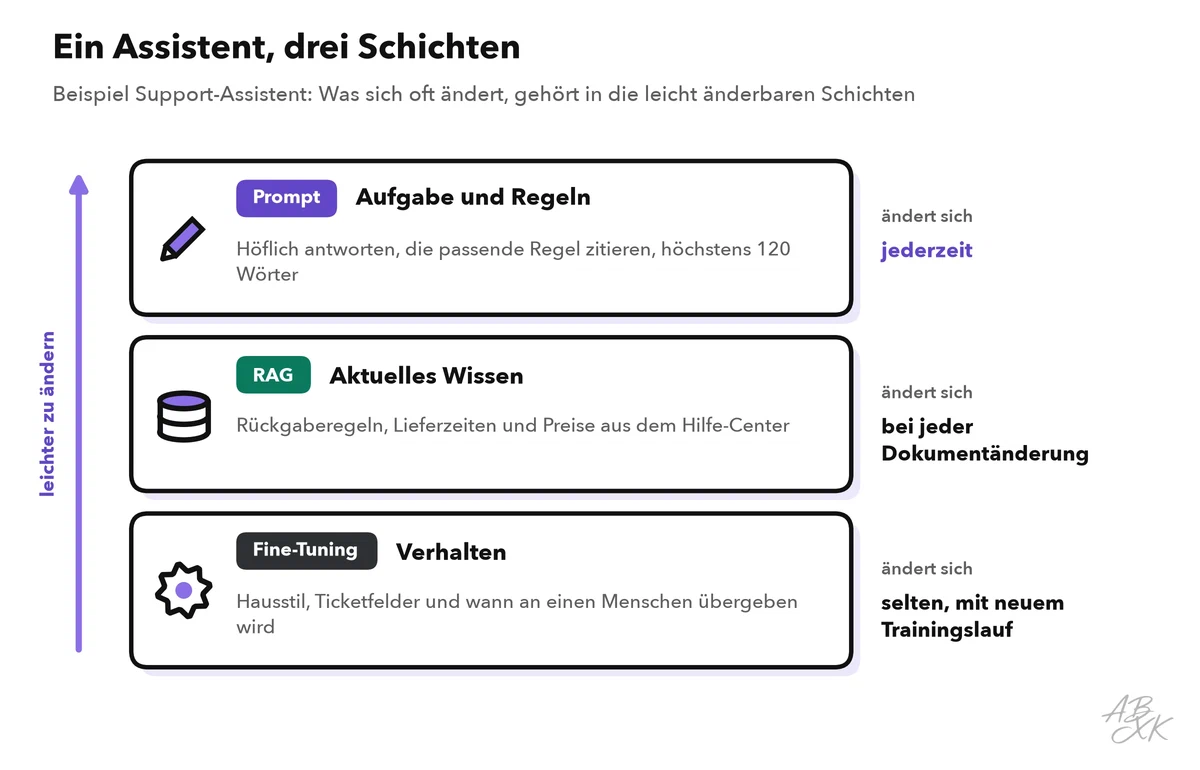
Die Methoden sind keine Konkurrenten. Viele Systeme im Produktivbetrieb nutzen alle drei, jede für den Teil, den sie am besten kann. Eine nützliche Regel: Was sich oft ändert, gehört in die Schichten, die sich leicht ändern lassen.
Fine-Tuning kann RAG sogar verbessern. Forschende der UC Berkeley trainierten Modelle mit Fragen samt abgerufenen Dokumenten, darunter auch unpassende. Die Modelle lernten, die richtige Passage zu zitieren und die Ablenkungen zu übergehen (Quelle: Zhang u. a., „RAFT“, UC Berkeley, 2024). Das ist ein fortgeschrittener Schritt. Gehen Sie ihn erst, wenn ein funktionierendes RAG-System die gelieferten Passagen noch falsch verwendet.
Entscheidungstabelle mit Beispielen
Nutzen Sie diese Tabelle als Ausgangspunkt; das letzte Wort hat Ihr Eval-Set.
| Situation | Erste Wahl | Warum |
|---|---|---|
| Ein Support-Bot soll nach aktuellen Rückgabe- und Versandregeln antworten | RAG | Die Fakten ändern sich, und Antworten sollen die Regel zitieren |
| Antworten müssen immer gültiges JSON mit festen Feldern sein | Prompting mit Schema | Strukturierte Ausgabe erzwingt das Format ohne Training |
| 50.000 Tickets pro Tag sollen in 12 Kategorien sortiert werden | Kleines Modell mit Fine-Tuning | Enge Aufgabe, große Menge, geringere Kosten pro Anfrage |
| Produkttexte sollen nach Ihrer Marke klingen | Prompting mit Beispielen | Fine-Tuning erst, wenn der Ton über viele Texte schwankt |
| Fragen zu einem zehnseitigen Handbuch, das sich selten ändert | Prompting | Das ganze Handbuch passt ins Kontextfenster |
| Ein interner Assistent braucht Ihren Hausstil und aktuelle Dokumente | Fine-Tuning plus RAG | Verhalten aus dem Training, Fakten aus dem Retrieval |
| Ein Modell gibt rechtliche oder medizinische Fakten falsch wieder | RAG mit Prüfung durch Fachleute | Fine-Tuning würde die Fakten nicht verlässlich machen |
| Ein langer Prompt mit vielen Beispielen macht jede Anfrage langsam und teuer | Kleineres Modell mit Fine-Tuning | Die Beispiele wandern in die Gewichte |
Wie auch immer Sie sich entscheiden: Halten Sie Prompts, die Dokumente hinter Ihrem Index und die Trainingsdaten unter Versionskontrolle. Dann können Sie jede Veränderung der Qualität auf den Hebel zurückführen, der sie ausgelöst hat.