

Eine Kundin tippt „Bekomme ich mein Geld zurück?“ in Ihr Hilfe-Center. Die Antwort steht in einem Artikel namens „Rückerstattung“, doch die Stichwortsuche findet nichts — die beiden Texte haben kein Wort gemeinsam. Embeddings lösen dieses Problem. Sie verwandeln Text in Zahlen, die seine Bedeutung erfassen. So findet Software Texte, die dasselbe meinen, auch wenn die Wörter verschieden sind.
Dies ist Teil 1 von Level 2 (Fortgeschritten) in unserem Lernpfad AI Development. Sie lernen, was ein Embedding ist, wie Ähnlichkeitssuche funktioniert, was eine Vektordatenbank beiträgt und welche Einstellungen in der Praxis zählen. Teil 2 baut daraus eine RAG-Pipeline Schritt für Schritt.
Embeddings machen Bedeutung zu Koordinaten
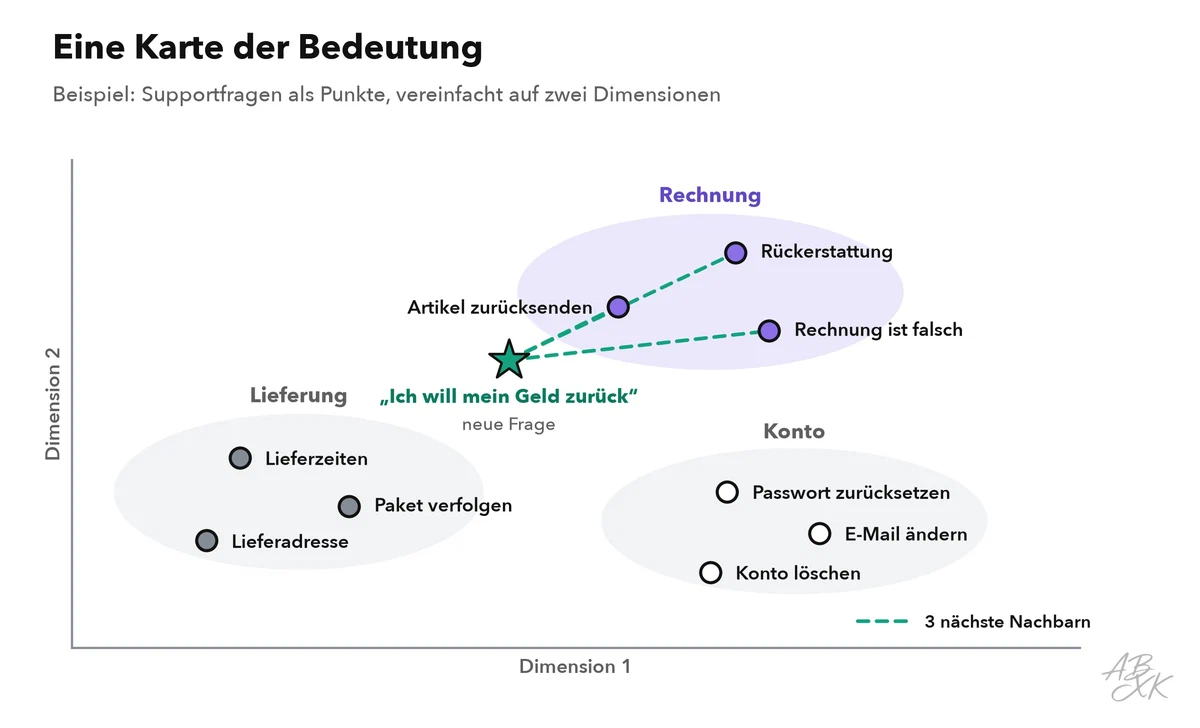
Ein Embedding ist eine Liste von Zahlen, ein sogenannter Vektor, den ein Embedding-Modell für ein Stück Text berechnet. Übliche Embedding-Modelle liefern einige Hundert bis einige Tausend Zahlen pro Text. Sie können diese Zahlen als Koordinaten lesen: Jeder Text wird zu einem Punkt in einem Raum mit entsprechend vielen Dimensionen. Texte mit ähnlicher Bedeutung landen nah beieinander, Texte ohne Bezug weit auseinander.
Hunderte Dimensionen kann sich niemand vorstellen, deshalb presst die Abbildung die Idee in zwei. Jeder Punkt ist eine kurze Supportfrage. Dem Modell hat niemand gesagt, zu welchem Thema eine Frage gehört. Die Gruppen entstehen, weil ähnliche Fragen ähnliche Zahlen bekommen.
Drei Eigenschaften zählen in der Praxis:
- Ein Modell pro Index. Vektoren verschiedener Embedding-Modelle liegen in verschiedenen Räumen. Dokumente und Suchanfragen müssen Sie mit demselben Modell einbetten. Wechseln Sie das Modell, betten Sie alles neu ein.
- Bedeutung schlägt Wortlaut. „Geld zurück“ und „Rückerstattung“ landen nah beieinander. Mit einem mehrsprachigen Embedding-Modell landet auch das englische „refund“ dort.
- Ähnlich heißt nicht wahr. „Die Gebühr wird erstattet“ und „Die Gebühr wird nicht erstattet“ handeln vom selben Thema, deshalb können ihre Vektoren sehr nah beieinanderliegen. Embeddings finden verwandten Text. Fakten prüfen sie nicht.
So funktioniert die Ähnlichkeitssuche
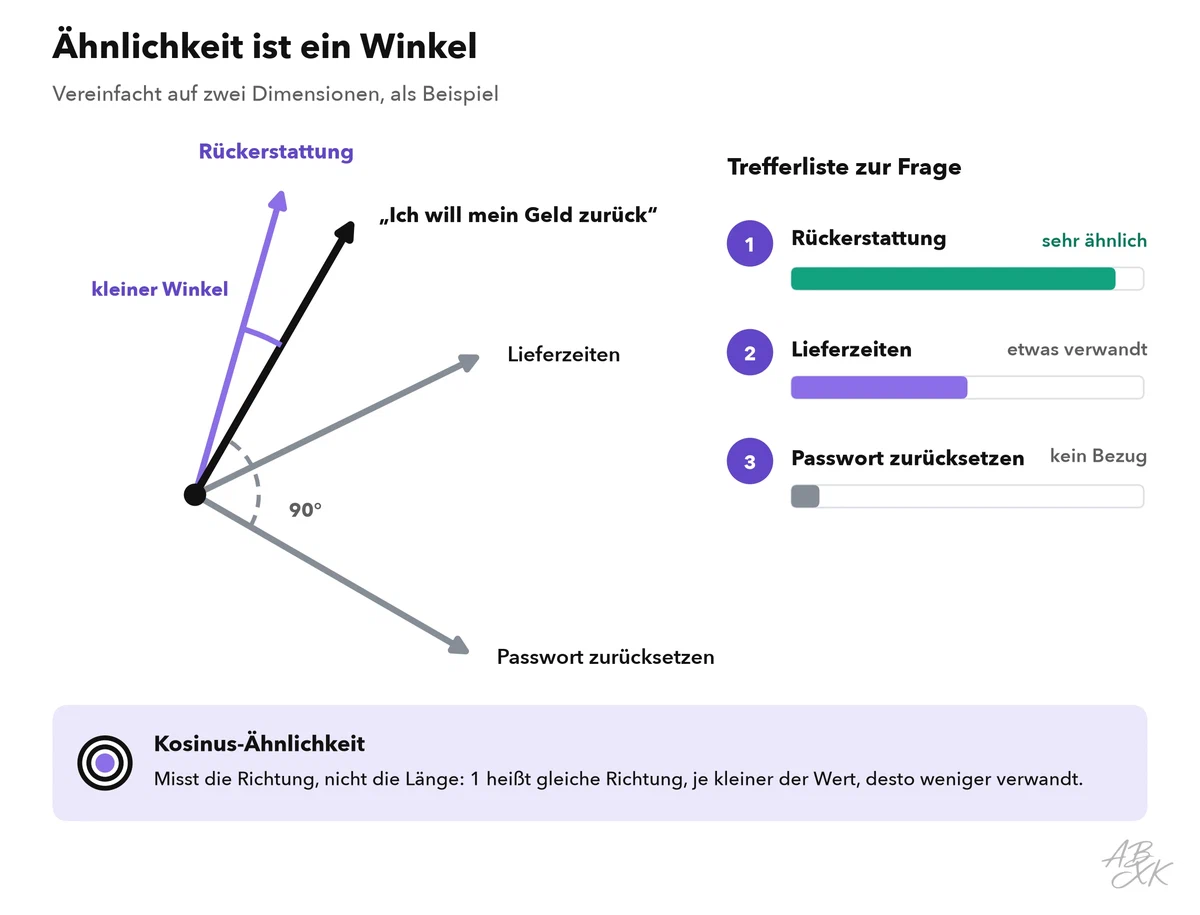
Für die Suche betten Sie die Frage mit demselben Modell ein und vergleichen ihren Vektor mit den gespeicherten Vektoren. Die nächstgelegenen sind die besten Treffer. Fachleute nennen das Nearest-Neighbor-Suche (Suche nach den nächsten Nachbarn). Die Zahl der gewünschten Treffer heißt Top-k, zum Beispiel die besten 5.
„Nah“ wird meist mit der Kosinus-Ähnlichkeit gemessen. Sie vergleicht die Richtung zweier Vektoren, also den Winkel zwischen ihnen. Der Wert 1 bedeutet dieselbe Richtung. Je niedriger der Wert, desto weniger haben die Texte miteinander zu tun. Manche Modelle sind für andere Maße gebaut, etwa das Skalarprodukt oder den euklidischen Abstand. Nutzen Sie das Maß, das die Dokumentation Ihres Modells empfiehlt.
Daraus folgen zwei Regeln für die Praxis:
- Werte sind relativ. Ein Wert wie 0,8 bedeutet bei verschiedenen Modellen Verschiedenes. Übernehmen Sie nie einen Schwellenwert aus einem Blogbeitrag. Finden Sie Ihren eigenen, indem Sie echte Fragen testen.
- Exakte Begriffe brauchen Hilfe. Produktcodes, Namen und Fehlernummern wie „E-4012“ verschwimmen in einem Vektor leicht. Viele Systeme kombinieren die Vektorsuche deshalb mit klassischer Stichwortsuche. Das heißt hybride Suche.
Hier ist die ganze Idee in wenigen Zeilen Python. embed() steht für eine beliebige Embedding-API oder ein lokales Modell:
import numpy as np

def cosine(a, b):
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))

docs = ["Rückerstattungen sind innerhalb von 30 Tagen möglich.",
        "Der Versand dauert 2 bis 4 Werktage.",
        "Ihr Passwort setzen Sie unter Einstellungen zurück."]
doc_vectors = [embed(d) for d in docs]        # einmal, beim Aufbau des Index

question = embed("Bekomme ich mein Geld zurück?")  # dasselbe Modell für die Frage!
scores = [cosine(question, v) for v in doc_vectors]
best = scores.index(max(scores))
print(docs[best])  # -> "Rückerstattungen sind innerhalb von 30 Tagen möglich."
Was eine Vektordatenbank beiträgt
Bei einigen Tausend Texten kann Ihr Programm die Frage einfach mit jedem Vektor vergleichen. Bei Millionen Vektoren und vielen Nutzern wird das zu langsam. Eine Vektordatenbank speichert die Vektoren und baut einen Index für die Approximate Nearest Neighbor Search (ANN), die näherungsweise Suche nach den nächsten Nachbarn. Der Index findet fast die besten Treffer, und zwar viel schneller als ein vollständiger Vergleich. Der Preis ist ein kleiner Verlust an Recall (Trefferquote): Hin und wieder entgeht ihm ein guter Treffer. Verbreitet sind graphbasierte Indizes (HNSW) und clusterbasierte (IVF). Bei den meisten Datenbanken lässt sich das Verhältnis von Tempo und Recall einstellen.
Eine Vektordatenbank speichert mehr als Zahlen. Jeder Datensatz hat meist vier Teile:
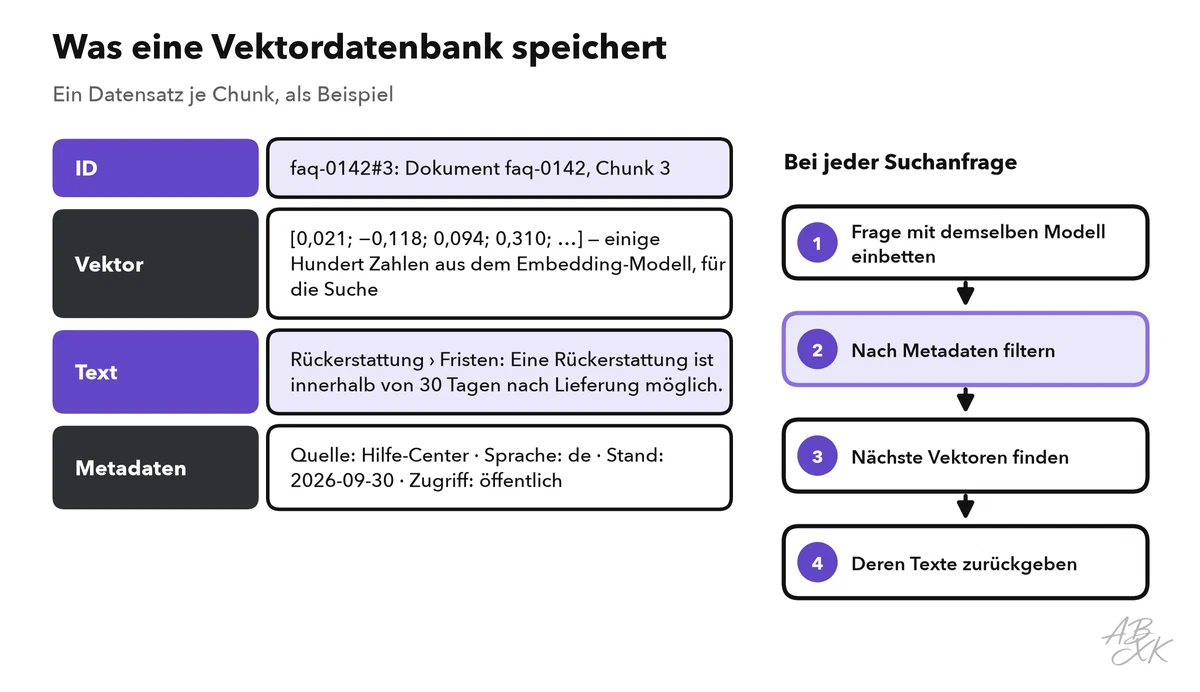
Erst die Metadaten machen eine Vektordatenbank im echten Produkt nützlich. Mit Metadatenfiltern durchsuchen Sie nur deutsche Texte, nur Dokumente aus diesem Jahr oder nur Dokumente, die die aktuelle Nutzerin sehen darf. Der letzte Filter ist der wichtigste. Ignoriert die Suche Berechtigungen, kann eine KI-Funktion vertrauliche Inhalte der falschen Person zeigen.
Eine eigene Datenbank brauchen Sie nicht immer. Die Tabelle hilft bei der Wahl:
| Situation | Gute Wahl | Warum |
|---|---|---|
| Prototyp oder kleiner Datenbestand (Tausende Chunks) | Suche im Arbeitsspeicher Ihrer Anwendung | Kein zusätzlicher Dienst nötig |
| Ihre Daten liegen schon in PostgreSQL | Eine Vektor-Erweiterung wie pgvector | Eine Datenbank, Vektoren neben Ihren übrigen Daten |
| Millionen Vektoren, viele Anfragen, wenig Zeit für den Betrieb | Eine verwaltete Vektordatenbank wie Pinecone | Der Anbieter betreibt Index und Skalierung |
| Sie wollen die Pipeline nicht selbst bauen | Eine Plattform für KI-Apps auf eigenen Daten wie Devs.ai | Apps und Agenten auf Ihren Daten, laut Anbieter |
Pinecone steht in unserem Tool-Vergleich für AI Development als verwaltete Vektordatenbank:
Manche Teams betreiben ein Open-Source-Embedding-Modell selbst, etwa um Modell und Version voll im Griff zu haben. Kleine Embedding-Modelle laufen auf einer gewöhnlichen CPU. Für große Stapelverarbeitungen vermieten GPU-Clouds wie Runpod Rechenleistung nach Nutzung, so der Anbieter.
Chunk-Größe: wie viel Text in einen Vektor gehört
Lange Dokumente werden in Chunks (Abschnitte) zerlegt, und jeder Chunk bekommt einen eigenen Vektor. Ein einziger Vektor für ein 40-seitiges Handbuch würde alle Themen zu einem Punkt verwischen. Außerdem braucht das Modell, das später die Antwort schreibt, kurze, passende Passagen statt ganzer Dateien.
Die Größe eines Chunks ist eine Abwägung:
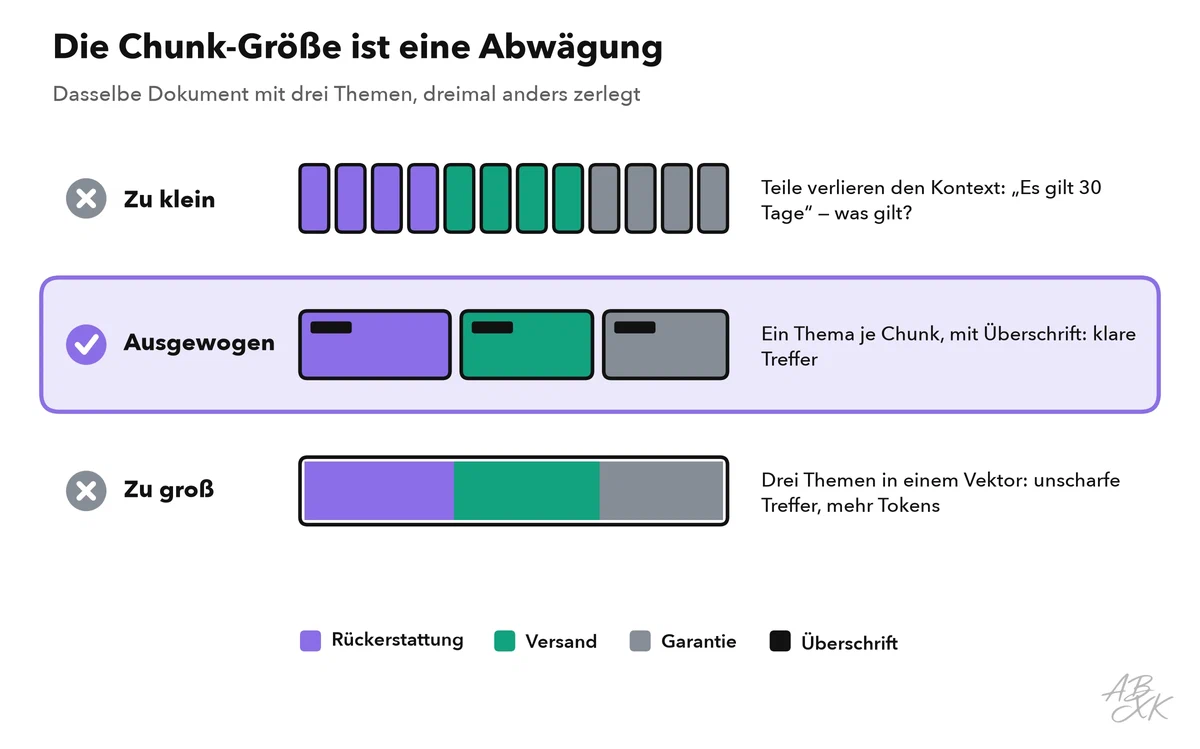
- Zu klein: Ein Chunk wie „Es gilt 30 Tage“ hat seinen Kontext verloren. Was gilt?
- Zu groß: Ein Chunk über Rückerstattung, Versand und Garantie bekommt einen unscharfen Vektor. Er passt ein wenig zu vielen Fragen und zu keiner richtig gut. Außerdem kostet er mehr Tokens, wenn Sie ihn später an ein Modell schicken.
Ein praktischer Startpunkt: Zerlegen Sie entlang der Struktur des Dokuments (Überschriften, Absätze, Listenpunkte), zielen Sie auf einige Hundert Tokens pro Chunk und lassen Sie benachbarte Chunks um ein, zwei Sätze überlappen. Stellen Sie jedem Chunk Dokumenttitel und Überschrift voran. Dann wird aus „Es gilt 30 Tage“ der Text „Rückerstattung › Fristen: Es gilt 30 Tage“. Testen Sie mit echten Fragen und justieren Sie nach. Sind Tokens neu für Sie, lesen Sie zuerst APIs, Tokens und Kontextfenster aus Level 0.
Wo Embeddings über Chatbots hinaus helfen
Bekannt sind Embeddings vor allem als Teil von RAG, wo sie die Passagen finden, die ein Chatbot braucht. Sie lösen aber viele weitere Aufgaben, ganz ohne Text zu erzeugen:
| Einsatz | Wie Embeddings helfen | Beispiel |
|---|---|---|
| Semantische Suche | Findet Treffer nach Bedeutung statt nach Stichwort | Hilfe-Center, Intranet, Produktsuche |
| Dubletten erkennen | Sehr nahe Vektoren bedeuten fast gleichen Inhalt | Tickets zusammenführen, die denselben Fehler beschreiben |
| Empfehlungen | Zeigt Inhalte nahe an dem, was jemand gerade gelesen hat | „Ähnliche Artikel“ unter einem Blogbeitrag |
| Clustering | Gruppiert Tausende Texte nach Themen | Kundenfeedback nach Themen sortieren |
| Klassifikation | Vergleicht einen neuen Text mit gelabelten Beispielen | Ein Ticket an Buchhaltung oder Support leiten |
| Ausreißer finden | Texte weit weg von jeder Gruppe fallen auf | Ungewöhnliche Anfragen in einer Warteschlange erkennen |
Fehler, die sich später rächen
Die meisten Probleme mit Embeddings zeigen sich in keiner Demo. Sie tauchen Wochen später auf, wenn sich Daten ändern oder der Index wächst. Diese sechs sind die häufigsten:
| Fehler | Was passiert | Besser |
|---|---|---|
| Embedding-Modell wechseln ohne neuen Index | Fragen und Dokumente liegen in verschiedenen Räumen; die Treffer wirken zufällig | Modellnamen beim Index speichern; nach einem Wechsel alles neu einbetten |
| Sich allein auf Vektoren verlassen | Produktcodes, Namen und Fehlernummern gehen unter | Stichwortsuche ergänzen (hybride Suche) |
| Vektoren ohne Metadaten speichern | Keine Filter für Sprache, Datum oder Berechtigungen | Quelle, Datum, Sprache und Zugriffsgruppe zu jedem Chunk speichern |
| Einen Schwellenwert für die Ähnlichkeit übernehmen | Zu viele oder zu wenige Treffer | Schwellenwerte mit Ihren eigenen Fragen bestimmen |
| Änderungen und Löschungen vergessen | Veraltete oder gelöschte Inhalte tauchen weiter auf | Vektoren aktualisieren oder löschen, sobald sich die Quelle ändert |
| Vektoren für harmlose Zahlen halten | Sensibler Text lässt sich teilweise zurückgewinnen | Vektoren schützen wie den Originaltext |
Der letzte Punkt überrascht viele Entwickler. In einer Studie haben Forschende die meisten kurzen Testtexte exakt aus ihren Embeddings rekonstruiert (Quelle: Morris et al., „Text Embeddings Reveal (Almost) As Much As Text“, EMNLP 2023, arxiv.org). Ist ein Text vertraulich, ist es sein Vektor also auch. Speichern Sie beides nur in Diensten, die Ihr Unternehmen für diese Art von Daten freigegeben hat.