

Ihr Skript aus Teil 1 läuft auf Ihrem Laptop. Damit andere es nutzen können, muss es im Internet laufen — ohne dass Ihr API-Schlüssel offenliegt, ohne Einladung zum Missbrauch und ohne böse Überraschung auf der Rechnung. Software so auf einen Server zu bringen, dass Menschen sie erreichen, nennt man Deployment.
Dies ist Teil 5 und damit der letzte Teil von Level 1 unseres Lernpfads AI Development. Sie richten die einfachste solide Architektur für eine kleine KI-Web-App ein: eine statische Seite und eine Serverless-Funktion. Sie erfahren, wo der API-Schlüssel liegt, wie Sie Anfragen und Kosten begrenzen, wie Sie Ihre eigene Domain mit HTTPS nutzen und was Sie nach dem Start beobachten. Die Anleitung baut auf Ihrem ersten LLM-API-Aufruf auf und auf den Teilen einer KI-App aus Level 0.
Die Architektur: eine statische Seite und eine Funktion
Eine kleine KI-Web-App braucht nur zwei eigene Teile:
- Das statische Frontend: HTML-, CSS- und JavaScript-Dateien, die der Server unverändert ausliefert — Ihre Seite mit dem Chatfenster. Hosting-Plattformen liefern solche Dateien meist über ein CDN (Content Delivery Network) aus: Server an vielen Orten, die Kopien Ihrer Dateien nah bei Ihren Besuchern bereithalten.
- Eine Serverless-Funktion: ein kleines Stück Backend-Code, das die Plattform nur dann ausführt, wenn eine Anfrage eintrifft. Einen Server verwalten Sie nicht. Die Plattform startet die Funktion, betreibt so viele Kopien wie nötig und beendet sie wieder. Nur diese Funktion kennt den API-Schlüssel und spricht mit dem Modell.
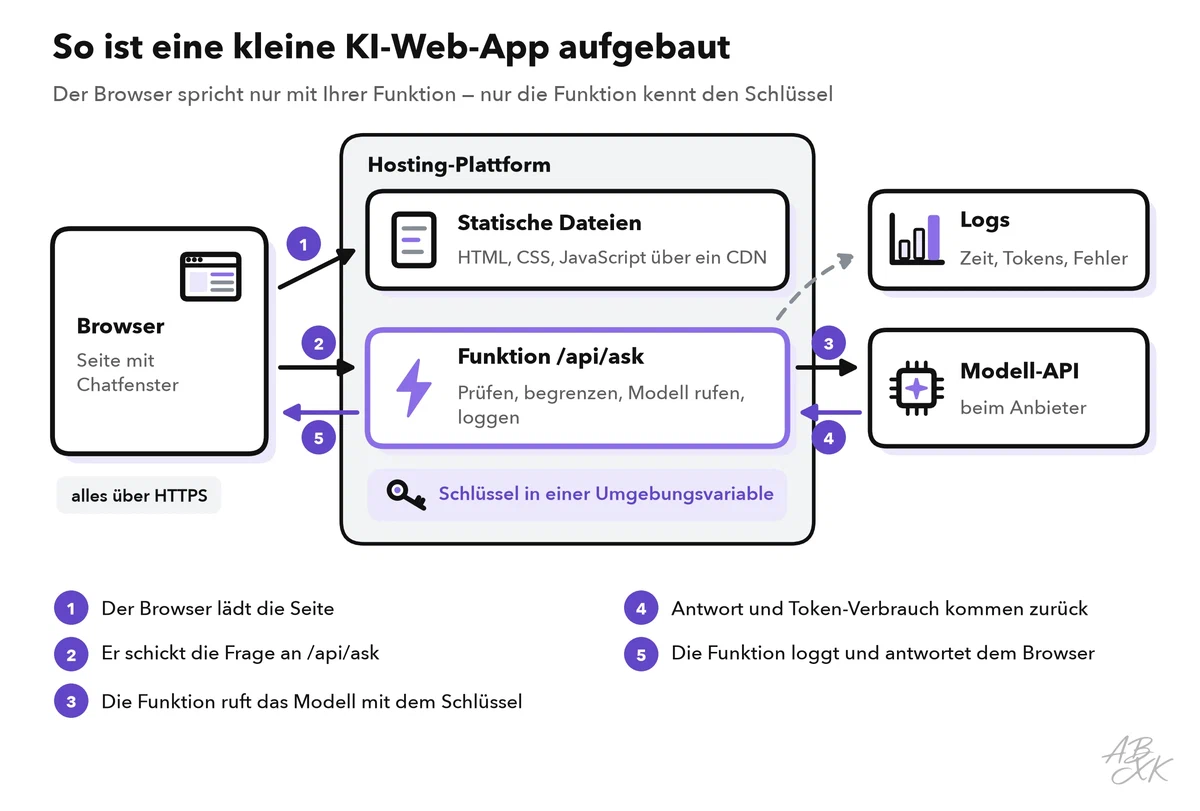
Der Browser spricht nie direkt mit dem Modellanbieter. Alles, was im Browser läuft, kann jeder Besucher lesen — ein Schlüssel in der Seite wäre schnell gefunden. Beide Teile können auch an anderen Orten laufen. Das sind die drei üblichen Wege:
| Weg | Was Sie selbst betreuen | Passt, wenn |
|---|---|---|
| Hosting-Plattform mit Funktionen | Ihren Code und die Einstellungen | Kleine Apps und Prototypen mit wenig bis mittlerem Verkehr |
| Eigener Server mit Kontrollpanel | Server, Updates, Sicherheit und Zertifikate | Sie betreiben schon Server oder brauchen volle Kontrolle |
| GPU-Cloud für ein eigenes Modell | Zusätzlich den Modellserver | Sie betreiben ein Modell mit offenen Gewichten statt der API eines Anbieters |
Laut den Anbietern ist Netlify eine Plattform zum Bauen, Ausliefern und Hosten von Websites und Web-Apps. Plesk ist ein Kontrollpanel für Websites, DNS und Datenbanken auf dem eigenen Server. Runpod ist eine GPU-Cloud zum Betreiben von KI-Modellen, abgerechnet nach Nutzung. Weitere Optionen führt unser Tool-Vergleich. Wir haben diese Tools nicht getestet.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Schritt 1: Die Funktion schreiben
Die Funktion nimmt die Frage entgegen, prüft sie, ruft das Modell auf und schickt nur die Antwort zurück. Das Beispiel folgt dem Format von Netlify Functions, die mit den standardisierten Web-Objekten Request und Response arbeiten. Andere Plattformen nutzen sehr ähnlichen Code, nur der Speicherort der Datei und einige Einstellungen unterscheiden sich.
// netlify/functions/ask.mjs
const SYSTEM_PROMPT = "Sie beantworten Fragen zu unserem Coworking-Space. ...";
const reply = (body, status = 200) => Response.json(body, { status });

export default async (req) => {
  if (req.method !== "POST") return reply({ error: "Bitte POST verwenden." }, 405);

  // 1. Eingabe prüfen, bevor etwas Geld kostet
  const body = await req.json().catch(() => null);
  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question || question.length > 1000) {
    return reply({ error: "Bitte stellen Sie eine Frage mit höchstens 1.000 Zeichen." }, 400);
  }

  // 2. Anfragen pro Besucher begrenzen (siehe Schritt 3)

  // 3. Modell aufrufen: Schlüssel und Modell aus der Umgebung, Token-Grenze, Timeout
  const started = Date.now();
  let status = 0;
  let data = null;
  try {
    const res = await fetch("https://api.example.com/v1/chat", {
      method: "POST",
      headers: {
        "Authorization": `Bearer ${process.env.LLM_API_KEY}`,
        "Content-Type": "application/json",
      },
      body: JSON.stringify({
        model: process.env.LLM_MODEL,
        messages: [
          { role: "system", content: SYSTEM_PROMPT },
          { role: "user", content: question },
        ],
        max_tokens: 300,
      }),
      signal: AbortSignal.timeout(20000),   // nach 20 Sekunden aufgeben
    });
    status = res.status;
    data = await res.json();
  } catch {
    // Timeout, Netzfehler oder eine Antwort, die kein JSON ist
  }

  // 4. Antwort prüfen (Feldnamen wie in Teil 1; sie unterscheiden sich je nach Anbieter)
  const answer = data?.output?.[0]?.text;
  const ok = status === 200 && typeof answer === "string" && answer !== "";

  // 5. Protokollieren, was für Fehler und Kosten nötig ist, aber nicht die Frage; dann antworten
  console.log(JSON.stringify({ status, ok, ms: Date.now() - started, usage: data?.usage }));
  if (!ok) return reply({ error: "Der Assistent ist gerade nicht erreichbar." }, 502);
  return reply({ answer });
};

export const config = { path: "/api/ask" };
Die Seite ruft nur diese Funktion auf, nie den Anbieter:
const res = await fetch("/api/ask", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ question }),
});
const { answer, error } = await res.json();
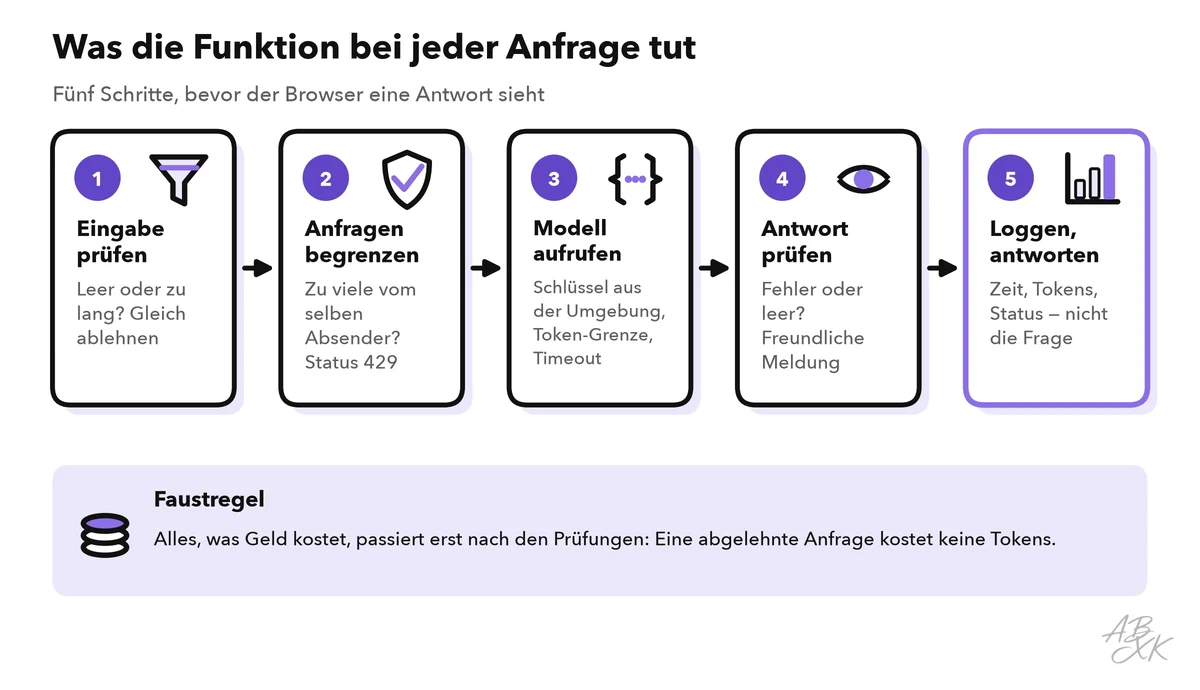
Zwei Details zählen in der Praxis. Erstens bleiben Fehlermeldungen an den Browser allgemein. Details wie der Fehlertext des Anbieters gehören in Ihre Logs, nicht auf den Bildschirm. Zweitens begrenzen Plattformen, wie lange eine Funktion laufen darf. Bei Netlify darf eine normale Funktion laut Dokumentation 60 Sekunden laufen. Ihr eigenes Timeout sollte deutlich kürzer sein, damit Sie noch eine freundliche Meldung schicken können.
Schritt 2: Den Schlüssel in einer Umgebungsvariable ablegen
Legen Sie in den Einstellungen Ihrer Hosting-Plattform die Umgebungsvariablen LLM_API_KEY und LLM_MODEL an. Die Funktion liest sie zur Laufzeit, sodass keiner der beiden Werte in Ihrem Code steht. Bei Netlify zum Beispiel setzen Sie sie im Dashboard oder über die Kommandozeile, und ein geänderter Wert gilt ab dem nächsten Deploy.
- Nie gehört der Schlüssel ins Repository, in den Frontend-Code, in Logs oder in Fehlermeldungen.
- Nutzen Sie einen eigenen Schlüssel für diese App und getrennte Schlüssel für Test und Betrieb. Dann können Sie einen Schlüssel widerrufen, ohne alles andere anzuhalten.
- Widerrufen Sie einen öffentlich gewordenen Schlüssel sofort, erstellen Sie einen neuen und veröffentlichen Sie erneut.
Schritt 3: Kosten und Missbrauch bremsen
Ihre Funktion hat eine öffentliche Adresse. Jeder kann sie aufrufen — nicht nur Ihre Seite, sondern auch Skripte und Bots —, und jeder Aufruf kostet Sie Tokens. Die OWASP Top 10 für LLM-Anwendungen 2025 führen dieses Risiko als „Unbounded Consumption“, also unbegrenzten Verbrauch. Dazu gehören Angriffe, die gezielt Ihre Rechnung in die Höhe treiben sollen, manchmal „Denial of Wallet“ genannt (Quelle: OWASP Gen AI Security Project, genai.owasp.org). Mehrere Bremsen hintereinander halten das Risiko klein:
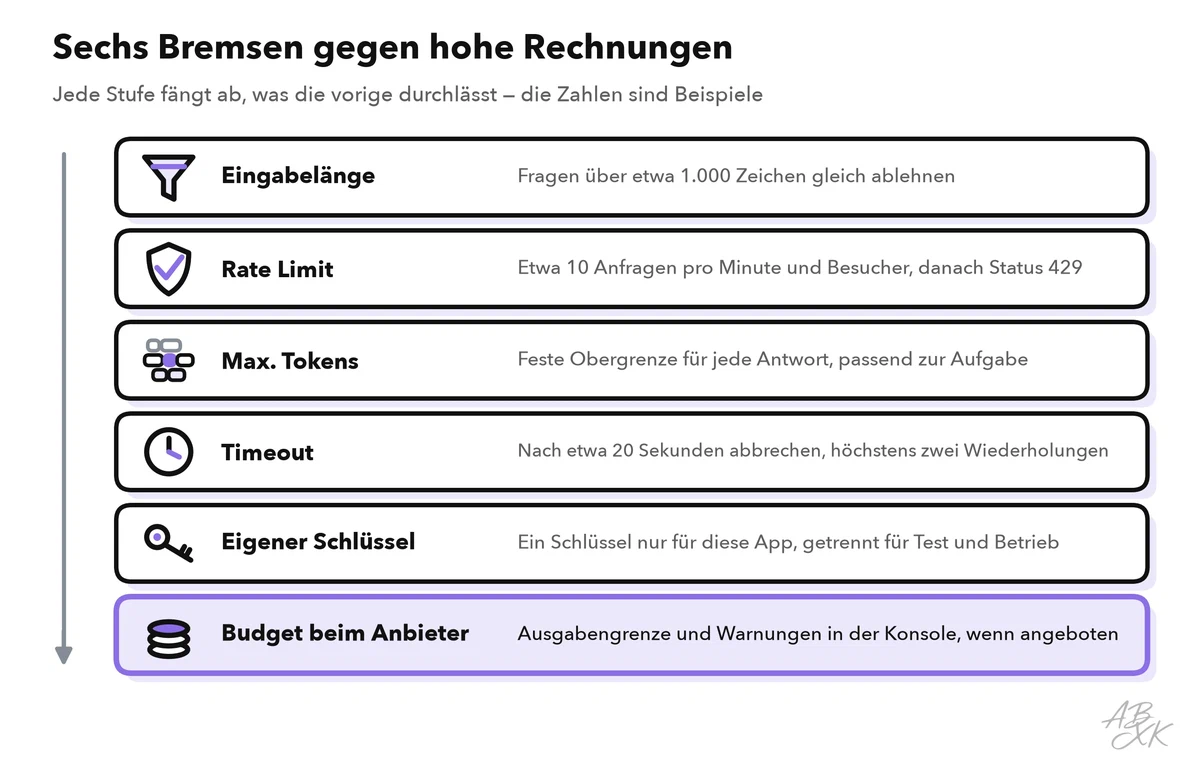
Ein Rate Limit begrenzt, wie viele Anfragen ein Besucher in einer bestimmten Zeit schicken darf, zum Beispiel zehn pro Minute. Eine Serverless-Funktion kann in mehreren getrennten Kopien laufen, die keinen gemeinsamen Speicher haben. Ein einfacher Zähler im Code funktioniert deshalb nicht. Nutzen Sie eine Rate-Limit-Einstellung Ihrer Plattform, falls es eine gibt, oder zählen Sie Anfragen in einer kleinen gemeinsamen Datenbank, etwa einem Key-Value-Speicher. Über dem Limit antwortet die Funktion mit Status 429, wie Sie ihn aus Teil 1 kennen. Nutzen viele Menschen Ihre App, hilft zusätzlich ein Login oder eine Bot-Prüfung vor der Funktion. Unser Bereich AI Security behandelt Missbrauch und Abwehr ausführlicher.
Die letzte Bremse sitzt beim Anbieter. Viele Modellanbieter erlauben in ihrer Konsole eine Ausgabengrenze oder Warnungen. Richten Sie beides ein, bevor Sie den Link teilen.
Schritt 4: Die eigene Domain mit HTTPS nutzen
HTTPS verschlüsselt die Verbindung zwischen Browser und App. Browser warnen vor Seiten ohne HTTPS. Die meisten Hosting-Plattformen geben jedem Projekt von Anfang an eine Adresse mit HTTPS, etwa eine Subdomain der Plattform.
Ihre eigene Domain tragen Sie in den Einstellungen der Plattform ein. Die Plattform zeigt Ihnen dann die DNS-Einträge, die Sie bei Ihrem Domain-Anbieter anlegen, oft einen CNAME- oder einen A-Eintrag. DNS ist das Adressbuch des Internets: Es übersetzt einen Domainnamen in die Adresse eines Servers. Änderungen können eine Weile brauchen, bis sie überall ankommen. Sobald die Domain auf die Plattform zeigt, beantragt die Plattform ein Zertifikat für HTTPS, oft bei der gemeinnützigen Zertifizierungsstelle Let’s Encrypt, und erneuert es automatisch. Zertifikate laufen nach einer festen Zeit ab, deshalb ist die automatische Erneuerung wichtig. Betreiben Sie einen eigenen Server, prüfen Sie, dass auch Ihr Kontrollpanel Zertifikate automatisch erneuert.
Schritt 5: Logs und Kosten nach dem Start beobachten
Jede console.log-Zeile Ihrer Funktion erscheint in den Funktions-Logs der Plattform. Protokollieren Sie, was Sie brauchen, um Fehler zu finden und Kosten zu steuern: Zeit, Status, Dauer, Token-Verbrauch sowie Modell- und Prompt-Version. Protokollieren Sie nicht standardmäßig vollständige Fragen und Antworten, denn sie können personenbezogene Daten enthalten. Brauchen Sie Beispiele für Qualitätsprüfungen, informieren Sie Ihre Nutzer, behalten Sie nur wenige und löschen Sie sie nach einer festen Frist.
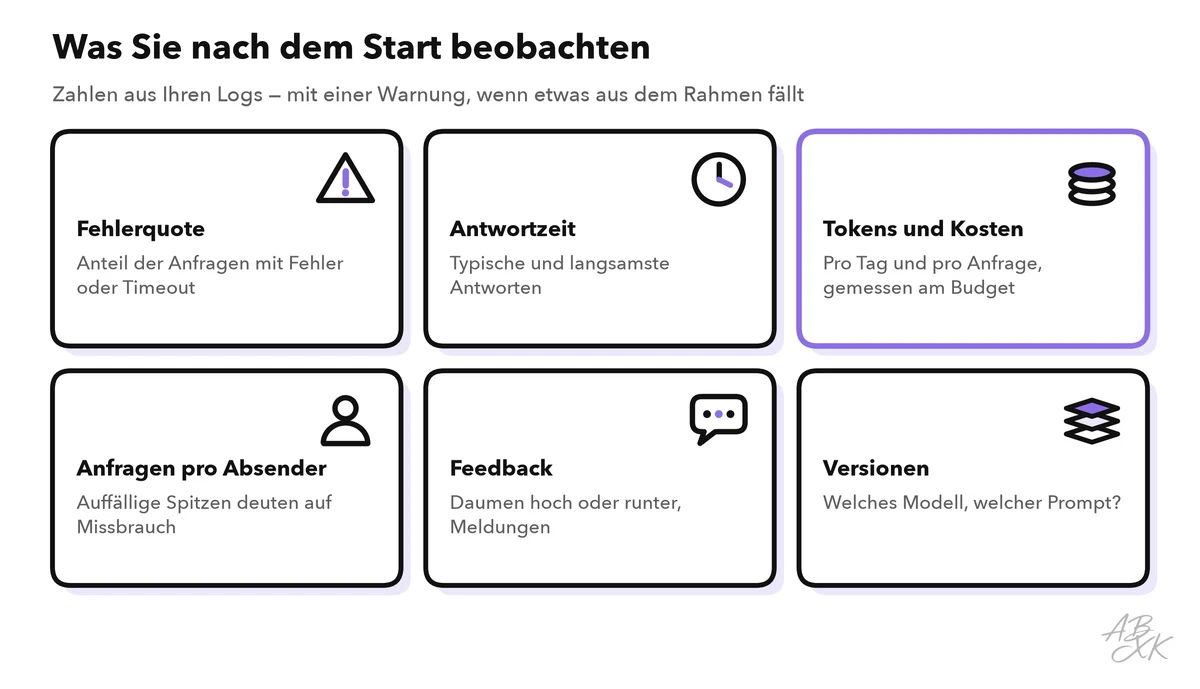
Sehen Sie sich in den ersten Wochen täglich Fehler und Kosten an. Richten Sie danach Warnungen ein, etwa wenn die Fehlerquote springt oder die Tageskosten eine selbst gewählte Grenze überschreiten. Level 3 erklärt Observability für LLM-Apps — Logs, Traces, Dashboards und Qualitätsprüfungen — ausführlich.
Checkliste für den Start
Gehen Sie diese Liste durch, bevor Sie den Link teilen, und erneut, wenn Sie Modell, Prompt oder Hosting ändern:
| Bereich | Prüfen |
|---|---|
| Schlüssel | Nur in Umgebungsvariablen; ein eigener Schlüssel für diese App; nicht im Repository, in der Seite oder in den Logs |
| Eingabe | Leere und zu lange Fragen werden vor dem Modellaufruf abgelehnt |
| Grenzen | Rate Limit pro Besucher, maximale Tokens und ein Timeout unter dem Limit der Plattform |
| Kosten | Ausgabengrenze und Warnungen beim Anbieter; Token-Verbrauch pro Tag in Ihren Logs sichtbar |
| Fehler | Freundliche Meldungen für Nutzer; keine internen Details in Antworten |
| Datenschutz | Nutzer wissen, dass sie mit einer KI sprechen; Ihre Datenschutzerklärung nennt den Modellanbieter; keine vollständigen Texte in den Logs ohne Grund |
| Domain | HTTPS funktioniert unter jeder Adresse; das Zertifikat wird automatisch erneuert |
| Zurückrollen | Sie wissen, wie Sie zum vorherigen Deploy zurückkehren; viele Plattformen bewahren frühere Versionen dafür auf |
| Verantwortung | Eine Person liest die Warnungen und entscheidet, was bei einem Problem passiert |