

Ein neues Modell erscheint, und die Ankündigung zeigt einen Coding-Wert ein paar Punkte über der Konkurrenz. Sollte Ihr Team wechseln? Die Zahl allein beantwortet das nicht. Sie müssen wissen, welche Aufgaben dahinterstehen, wie das Ergebnis zustande kam und wie stark es zufällig schwanken kann.
Dies ist Teil 4 von Level 4 (Experte) im Lernpfad AI Development. Sie erfahren, was SWE-bench Verified, Aider Polyglot und Terminal-Bench messen, wie ihre Aufgaben bewertet werden, wo die Zahlen täuschen und wie Sie aus Ihrem eigenen Repository einen kleinen Benchmark bauen. Den ersten dieser Benchmarks hat Level 0 in Was KI-Coding-Assistenten tun vorgestellt; die Methoden hier bauen auf KI-Funktionen mit Evals testen aus Level 2 auf.
Was ein Coding-Benchmark misst
Ein Coding-Benchmark ist ein fester Satz von Programmieraufgaben mit einer automatischen Prüfung, fast immer Tests. Der Wert ist der Anteil gelöster Aufgaben, meist mit einem Versuch je Aufgabe (pass@1). Zwei weitere Begriffe sind für alles Folgende wichtig. Das Harness, auch Scaffold genannt, ist die Software um das Modell herum: Es gibt dem Modell Werkzeuge wie eine Shell oder einen Datei-Editor, steuert die Schleife und begrenzt Schritte und Zeit. Kontamination heißt, dass Aufgaben oder ihre Lösungen in den Trainingsdaten des Modells steckten.
Die drei Benchmarks aus unseren LLM-Daten prüfen verschiedene Arten von Arbeit:
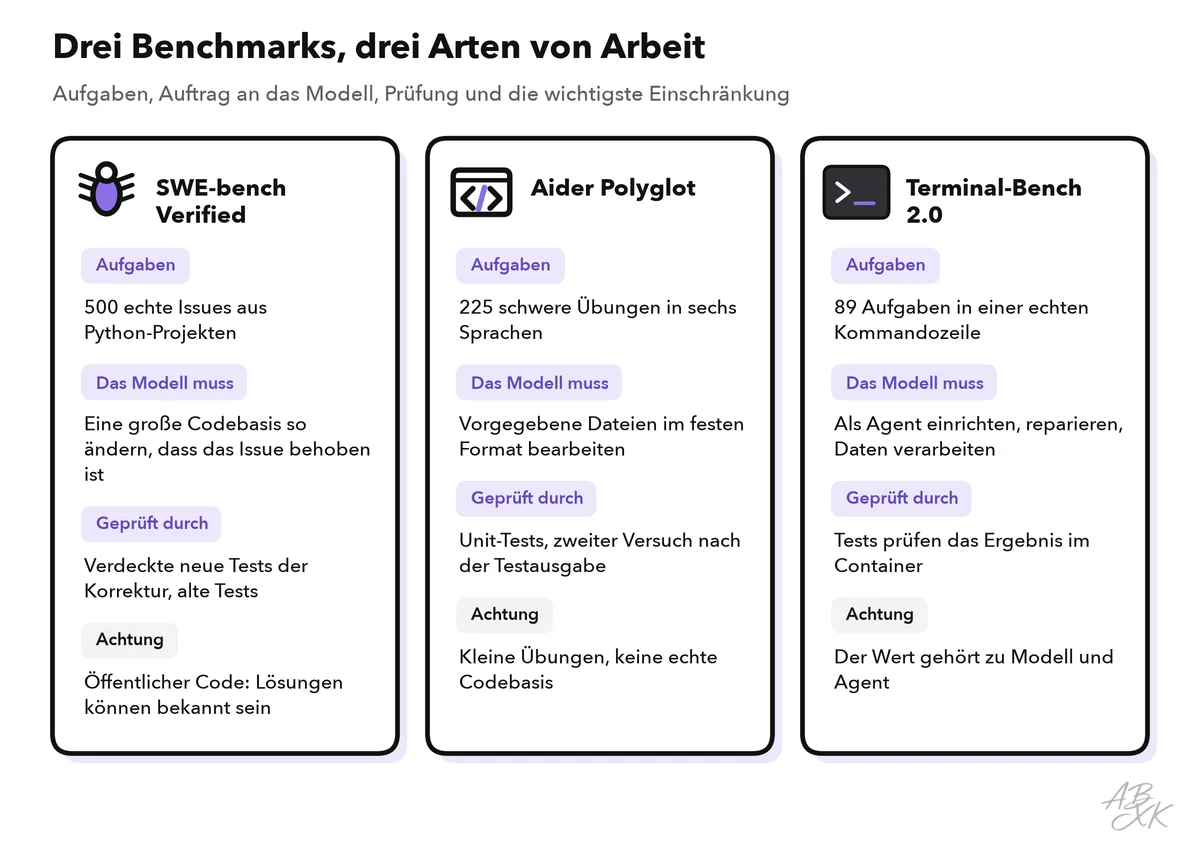
Keiner von ihnen misst, was eine gelöste Aufgabe kostet, wie lange sie dauert oder ob Ihre Kolleginnen und Kollegen den Code warten können. Denken Sie daran, wann immer Sie eine Rangliste lesen.
SWE-bench Verified: echte Fehlerberichte, verdeckte Tests
SWE-bench wurde 2023 vorgestellt (Quelle: Jimenez et al., „SWE-bench: Can Language Models Resolve Real-World GitHub Issues?“, ICLR 2024). Es enthält 2.294 Aufgaben aus echten GitHub-Issues in 12 verbreiteten Python-Repositories. Jede Aufgabe gibt dem Modell den Text des Issues und das Repository im Zustand vor der Korrektur. Das Modell, meist in einem Agenten-Harness, ändert den Code und gibt einen Patch ab: seine Änderung als Diff. Dann entscheiden zwei Gruppen von Tests:
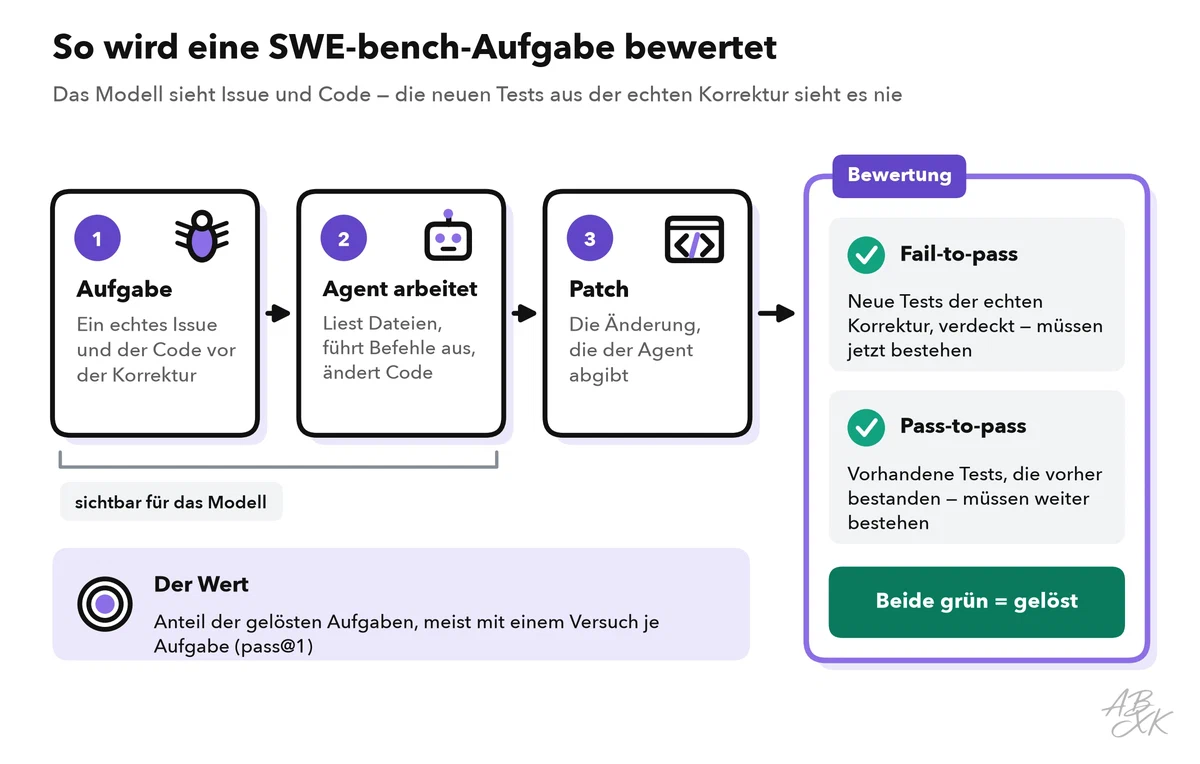
- Fail-to-pass-Tests kamen mit der echten Korrektur: Sie scheiterten davor und bestanden danach. Sie bleiben für das Modell verdeckt, und sein Patch muss sie zum Bestehen bringen.
- Pass-to-pass-Tests sind vorhandene Tests, die schon vor der Korrektur bestanden. Sie müssen weiter bestehen, damit der Patch nichts anderes kaputt macht.
Nur wenn beide Gruppen bestehen, gilt die Aufgabe als gelöst (resolved). Der ursprüngliche Satz hatte eine Schwäche: Manche Issues waren zu vage, um sie zu lösen, und manche Tests lehnten gültige Lösungen ab. Im August 2024 veröffentlichte OpenAI deshalb SWE-bench Verified. Dafür sichteten 93 Softwareentwicklerinnen und -entwickler mit Python-Erfahrung 1.699 Aufgaben auf vage Beschreibungen und unfaire Tests; die 500 Aufgaben von SWE-bench Verified haben diese Prüfung bestanden. Die Prüfer schätzten auch den Aufwand für eine erfahrene Entwicklerin: 196 Aufgaben dauern weniger als 15 Minuten, nur 45 länger als eine Stunde (Quelle: OpenAI, „Introducing SWE-bench Verified“, 2024, openai.com). Der Benchmark misst also kleine, gut beschriebene Korrekturen, nicht den Entwurf einer neuen Funktion.
In unseren Daten stammen alle Ergebnisse für SWE-bench Verified aus Epoch AIs eigenen Läufen mit einem festen Harness. Dadurch sind sie untereinander vergleichbar — und oft niedriger als die Zahlen in Ankündigungen der Anbieter:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Claude Opus 4.7 (max) Anthropic | 16.04.2026 | 83,5 % |
| 2 | GPT-5.5 (xhigh) OpenAI | 23.04.2026 | 80,6 % |
| 3 | Gemini 3.5 Flash Google DeepMind | 19.05.2026 | 79,3 % |
| 4 | Claude Opus 4.6 (no thinking) Anthropic | 05.02.2026 | 78,7 % |
| 5 | GLM-5.2 Z.ai (Zhipu AI) | 16.06.2026 | 78,7 % |



500 echte Fehlerberichte aus Open-Source-Projekten in Python, von Menschen geprüft. Das Modell muss den Code so ändern, dass die Tests des Projekts bestehen. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Aider Polyglot und Terminal-Bench
Aider Polyglot: Code in sechs Sprachen ändern
Die Macher des Open-Source-Coding-Tools Aider haben den Polyglot-Benchmark im Dezember 2024 veröffentlicht. Er nutzt Übungen der Lernplattform Exercism in C++, Go, Java, JavaScript, Python und Rust. Von 697 Übungen behält er die 225, die damals höchstens drei von sieben führenden Modellen lösen konnten (Quelle: Aider, „o1 tops aider’s new polyglot leaderboard“, 2024, aider.chat). Das Modell muss die vorgegebenen Dateien in einem festen Bearbeitungsformat ändern. Scheitern die Unit-Tests, sieht es deren Ausgabe und bekommt einen zweiten Versuch. Neben dem Anteil gelöster Übungen meldet die Rangliste, wie oft ein Modell das Bearbeitungsformat richtig verwendet hat. Das zählt für jedes Tool, das KI-Änderungen automatisch übernimmt.
Was Aider Polyglot nicht abdeckt: Die Übungen sind klein und in sich geschlossen, es gibt keine große Codebasis zu verstehen, und die Lösungen sind öffentlich. Diese Ergebnisse stammen aus der Aider-Rangliste, gesammelt von Epoch AI:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | GPT-5 (high) OpenAI | 07.08.2025 | 88,0 % |
| 2 | o3-pro OpenAI | 10.06.2025 | 84,9 % |
| 3 | Gemini 2.5 Pro Preview (Jun 2025) Google DeepMind | 05.06.2025 | 83,1 % |
| 4 | o3 (high) OpenAI | 16.04.2025 | 81,3 % |
| 5 | Grok 4 xAI | 09.07.2025 | 79,6 % |
225 schwierige Programmieraufgaben in C++, Go, Java, JavaScript, Python und Rust. Misst, ob ein Modell vorhandenen Code korrekt ändern kann — mit einem zweiten Versuch nach Sicht der Testausgabe. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Terminal-Bench: ein Agent in einer echten Kommandozeile
Terminal-Bench stammt von der Stanford University und dem Laude Institute. Version 2.0 vom November 2025 enthält 89 Aufgaben. Jede Aufgabe hat eine eigene Umgebung in einem Container, eine von Menschen geschriebene Referenzlösung und Tests, die das Ergebnis prüfen (Quelle: Merrill et al., „Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces“, 2026, arxiv.org). Der Agent muss Software einrichten, ein System reparieren oder Daten verarbeiten: Arbeit, die viele Befehle hintereinander braucht.
Hier gehört der Wert zu einem Paar: einem Modell und der Agenten-Software, die es steuert. Dasselbe Modell kann mit zwei Agenten ganz unterschiedlich abschneiden. Unsere Tabelle zeigt das beste Ergebnis je Modell:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | GPT-5.5 OpenAI | 23.04.2026 | 84,7 % |
| 2 | GPT-5.4 OpenAI | 05.03.2026 | 81,8 % |
| 3 | Gemini 3.1 Pro Google DeepMind | 19.02.2026 | 80,2 % |
| 4 | Claude Opus 4.7 Anthropic | 16.04.2026 | 80,2 % |
| 5 | Claude Opus 4.6 Anthropic | 05.02.2026 | 79,8 % |
Aufgaben, die ein Agent in einer echten Kommandozeile lösen muss: Software einrichten, ein System reparieren, Daten verarbeiten. Der Wert gehört zu einem Modell samt Agenten-Software; wir zeigen das beste Ergebnis je Modell. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Nicht jedes neue Modell wird auf jedem Benchmark getestet. Die neuesten Modelle unserer LLM-Datenbank können in diesen Tabellen daher fehlen.
Wie schnell die Bestwerte stiegen
Das Diagramm zeigt den Bestwert jedes Benchmarks im Zeitverlauf: das beste Ergebnis in unseren Daten, nach dem Erscheinungsdatum der Modelle.
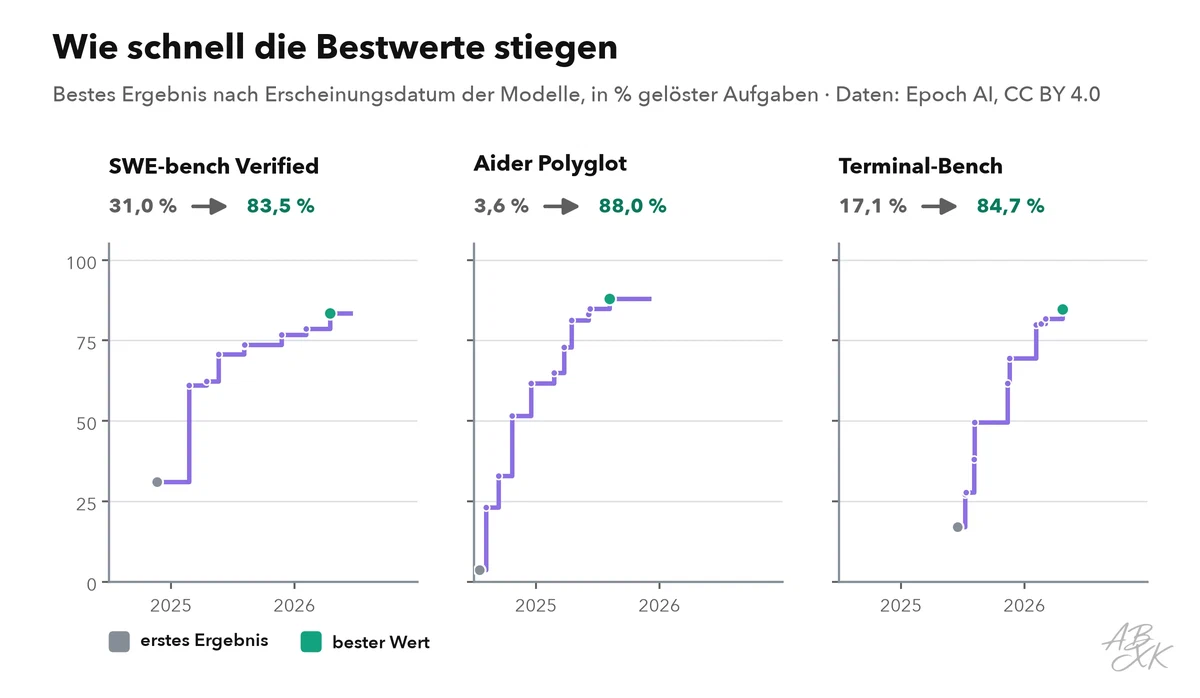
Daraus folgen drei Lehren. Erstens stiegen die Ergebnisse auf allen drei Benchmarks innerhalb weniger Monate steil an; ein Bestwert von vor einem Jahr sagt wenig über die Modelle von heute. Zweitens trennt ein Benchmark nahe seiner Obergrenze die Modelle nicht mehr: Die letzten ungelösten Aufgaben sind oft die mit fehlerhaften Tests. Drittens heißt eine endende Linie nicht, dass der Fortschritt stoppte. Sie heißt, dass noch niemand den Benchmark mit neueren Modellen ausgeführt hat.
Wo die Zahlen täuschen
Kontamination und fehlerhafte Tests. Die Aufgaben von SWE-bench stammen aus öffentlichen Repositories, und auch die Korrekturen sind öffentlich. Im Februar 2026 hörte OpenAI auf, Ergebnisse für SWE-bench Verified zu veröffentlichen. Das Unternehmen hatte die Aufgaben geprüft, an denen Modelle oft scheiterten: Bei mindestens 59,4 Prozent davon waren die Tests fehlerhaft und konnten korrekte Lösungen ablehnen. Außerdem konnten Spitzenmodelle die ursprüngliche Korrektur oder den Text des Issues aus der Kennung der Aufgabe und einem kurzen Hinweis wiedergeben (Quelle: OpenAI, „Why we no longer evaluate SWE-bench Verified“, 2026, openai.com). OpenAI empfahl daraufhin SWE-bench Pro von Scale AI. Im Juli 2026 schätzte das Unternehmen, dass auch bei SWE-bench Pro etwa 30 Prozent der Aufgaben fehlerhaft sind, und zog die Empfehlung zurück. Die Begründung gilt für jeden so gebauten Benchmark: Issues und Pull Requests wurden für die Zusammenarbeit von Menschen geschrieben, nicht als in sich geschlossene Testaufgaben (Quelle: OpenAI, „Separating signal from noise in coding evaluations“, 2026, openai.com).
Unterschiedliche Harnesses. Die Zahl eines Anbieters und eine unabhängige Zahl für dasselbe Modell sind oft nicht vergleichbar. Anbieter nutzen unter Umständen ein eigenes Harness, mehr Versuche oder mehr Rechenleistung. Anthropic etwa meldete für Claude 3.7 Sonnet ein Ergebnis auf SWE-bench Verified mit dem Standardaufbau und ein deutlich höheres mit einem eigenen Scaffold (Quelle: Anthropic, „Claude 3.7 Sonnet and Claude Code“, 2025, anthropic.com). Lesen Sie die Fußnoten, bevor Sie vergleichen.
Zufall. Jeder Benchmark ist eine Stichprobe von Aufgaben. Je weniger Aufgaben, desto stärker kann ein Wert zufällig schwanken:
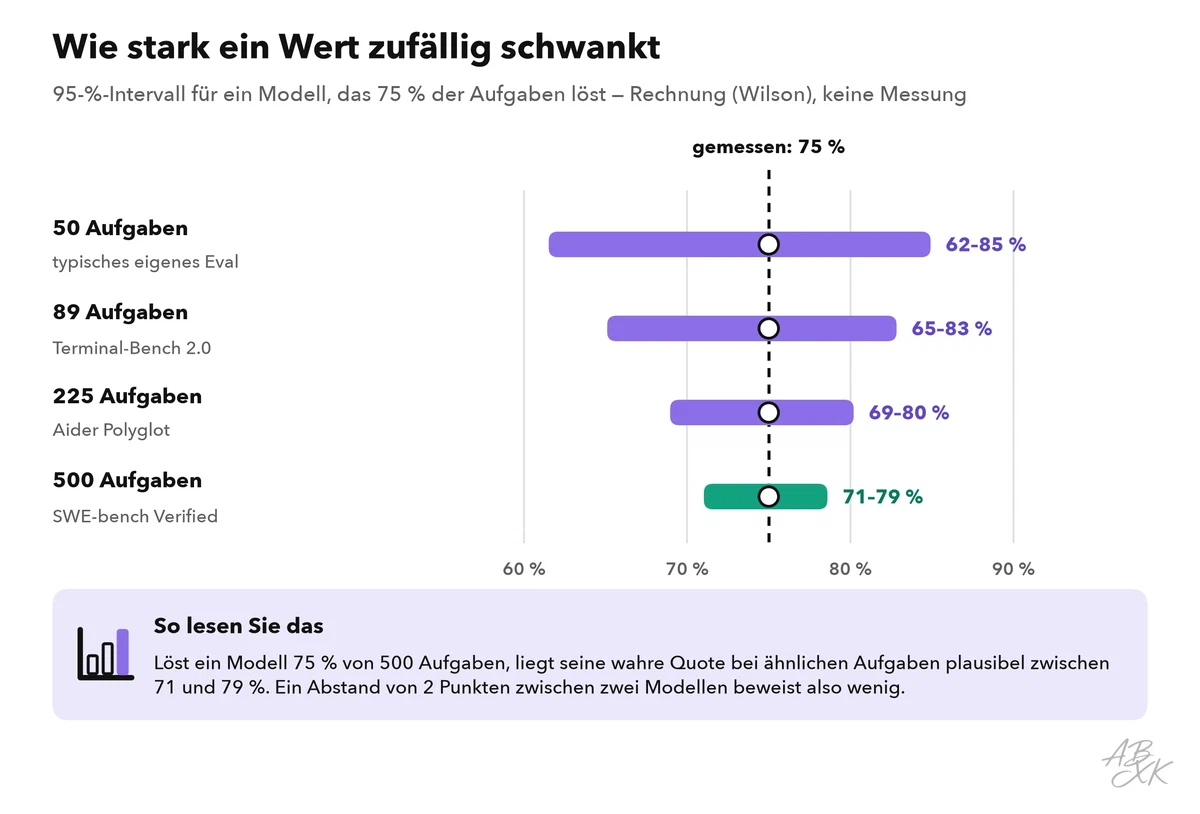
Bei 500 Aufgaben können zwei Modelle, die 2 Punkte auseinanderliegen, gleich gut sein. Bei den 50 Aufgaben eines typischen eigenen Evals zählen nur große Unterschiede. Evan Miller von Anthropic empfiehlt, Fehlerbalken anzugeben und Modelle auf denselben Aufgaben zu vergleichen, Frage für Frage (Quelle: Miller, „Adding Error Bars to Evals“, 2024, arxiv.org).
Die Tabelle nennt die Fallen und was Sie prüfen sollten, bevor Sie einer Zahl trauen:
| Falle | Was passiert | Was Sie prüfen |
|---|---|---|
| Kontamination | Das Modell hat Aufgaben oder Korrekturen im Training gesehen | Sind die Aufgaben öffentlich? Gibt es Ergebnisse auf neuen, unveröffentlichten Aufgaben? |
| Fehlerhafte Tests | Korrekte Lösungen scheitern, falsche bestehen | Wurde der Aufgabensatz geprüft? Wie nah liegt der Bestwert an der Obergrenze? |
| Harness | Zahlen der Anbieter nutzen andere Werkzeuge, Versuche oder Rechenleistung | Wer hat getestet, mit welchem Harness und wie vielen Versuchen? |
| Zufall | Kleine Abstände entstehen durch die Auswahl der Aufgaben | Wie viele Aufgaben? Gibt es Fehlerbalken? |
| Fehlende Kosten | Der Wert ignoriert Tokens, Zeit und Prüfaufwand | Was kostet eine gelöste Aufgabe, und wie lange dauert sie? |
| Fehlende Modelle | Nicht jedes Modell lief auf jedem Benchmark | Ist das Modell, das Sie interessiert, überhaupt in den Daten? |
Ihr Repository ist der eigentliche Test
Öffentliche Benchmarks sind ein guter erster Filter: Sie zeigen, welche Modelle einen Test wert sind. Die Entscheidung gehört einem eigenen Benchmark aus Ihrem Code, nach demselben Prinzip wie SWE-bench:
- Aufgaben sammeln. Nehmen Sie kürzlich geschlossene Issues mit einer gemergten Korrektur und Tests. Fünfzig sind ein brauchbarer Anfang, mehr ist besser. Neue Aufgaben stecken mit geringerer Wahrscheinlichkeit in den Trainingsdaten eines Modells.
- Die Umgebung einfrieren. Bereiten Sie für jede Aufgabe einen Container vor, mit dem Repository im Commit vor der Korrektur und allem, was die Tests brauchen.
- Die entscheidenden Tests verbergen. Entfernen Sie die Tests, die mit der Korrektur kamen, und heben Sie sie als Fail-to-pass-Tests für die Bewertung auf. Die vorhandene Testsuite dient als Pass-to-pass-Tests.
- Ihr echtes Harness verwenden. Lassen Sie jedes Kandidatenmodell in dem Agenten oder IDE-Tool laufen, das Ihr Team tatsächlich nutzt, mit denselben Grenzen. Führen Sie jede Aufgabe mehrmals aus.
- Mehr messen als die Erfolgsquote. Erfassen Sie die Kosten je gelöster Aufgabe, die Zeit, die Größe des Diffs und für eine Stichprobe das Urteil einer Reviewerin: Würden Sie das mergen?
- Aufgabe für Aufgabe vergleichen. Schauen Sie auf die Aufgaben, bei denen sich die Modelle unterscheiden, nicht nur auf die Summen.
Die Kosten je gelöster Aufgabe trennen Modelle oft deutlicher als die Erfolgsquote. Teil 5 dieses Levels zeigt, wie Sie die Kosten je erfolgreicher Aufgabe messen und senken. Welches Modell auch gewinnt: Sein Code durchläuft weiter die Prüftore Ihres KI-gestützten Coding-Workflows.
Tools können bei Teilen davon helfen. Nach Angaben des Anbieters führt TestDriver.ai Pull Requests in einer Desktop-Sandbox aus und baut Regressionstests — hilfreich, wenn alten Issues Tests fehlen. Stehen offene Coding-Modelle auf Ihrer Liste, kann eine GPU-Cloud wie Runpod sie für den Test betreiben. App-Builder wie Emergent schreiben ebenfalls Code mit KI-Modellen; ihre Ergebnisse verdienen dieselben Prüfungen. Wir haben diese Tools nicht getestet.

Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.