

Bei Ihrem ersten API-Aufruf stand in der Anfrage ein Platzhalter als Modell. In einer echten App gehört genau dieses Feld zu Ihren wichtigsten Entscheidungen. Es bestimmt die Qualität der Antworten, wie lange Nutzer warten und was jede Anfrage kostet. Die Auswahl ist groß: Allein unsere LLM-Datenbank führt 343 Modelle.
Dies ist Teil 4 von Level 1 unseres Lernpfads AI Development. Sie erfahren, welche Kriterien zählen und wie sie gegeneinander wirken. Außerdem sehen Sie, was offene und geschlossene Gewichte für Ihre App bedeuten und wie Sie eine Shortlist mit Ihren eigenen Daten testen. Hilfreich sind die Grundlagen zu Tokens und Kontextfenstern aus Level 0.
Mit der Aufgabe beginnen, nicht mit einer Rangliste
Ranglisten zeigen, welches Modell im Schnitt über viele Tests am stärksten ist. Ihre App braucht etwas anderes: ein Modell, das Ihre Aufgabe gut genug, schnell genug und zu tragbaren Kosten erledigt — und das unter Ihren Datenregeln. Das ist oft nicht das Modell an der Spitze einer Rangliste.
Notieren Sie deshalb zwei Dinge, bevor Sie sich ein einziges Modell ansehen:
- Die Aufgabe in einem Satz, zum Beispiel „Kundenfragen auf Deutsch und Englisch aus unseren Hilfeartikeln beantworten“.
- Die harten Anforderungen: Bedingungen, die ein Modell erfüllen muss, sonst scheidet es aus. Müssen die Daten in der EU oder auf Ihren eigenen Servern bleiben? Welche Sprachen? Wie lang sind die Eingaben? Laden Nutzer Bilder oder PDF-Dateien hoch? Wie schnell muss die Antwort beginnen?
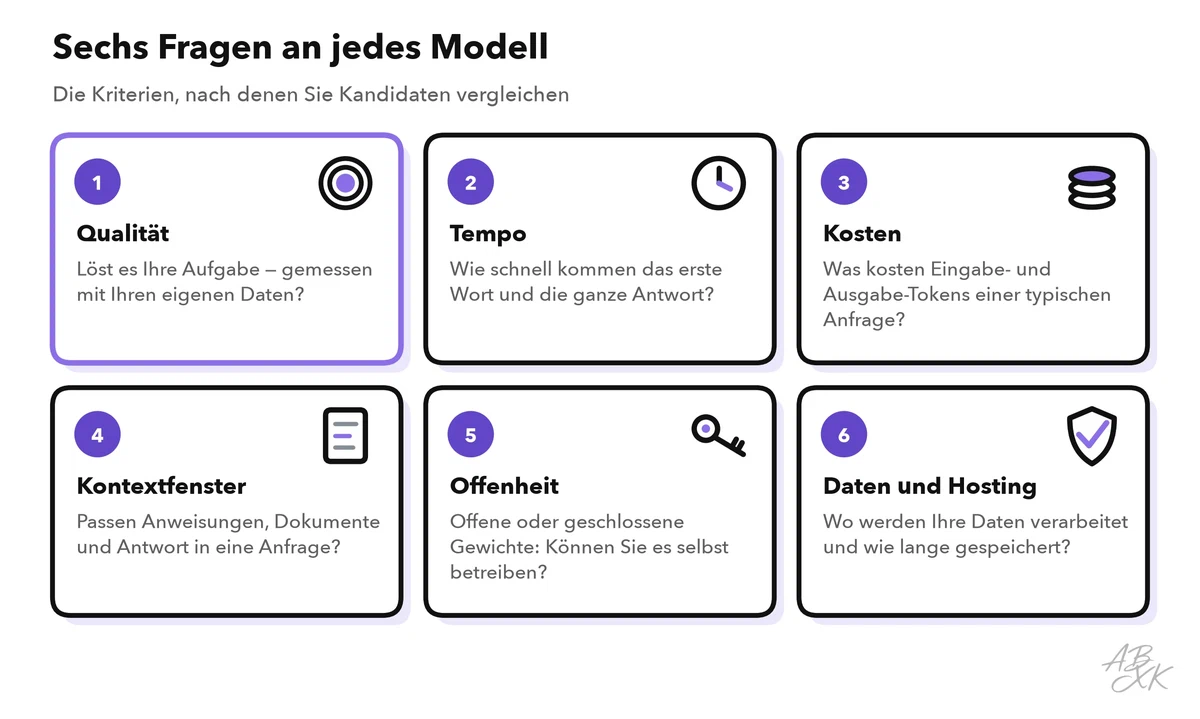
Mit diesen Notizen stellen Sie jedem Kandidaten dieselben sechs Fragen:
Qualität, Tempo und Kosten ziehen in verschiedene Richtungen
Qualität heißt: Wie gut löst ein Modell Ihre Aufgabe? Allgemeine Benchmarks geben einen ersten Eindruck. Einen guten Überblick bietet der Epoch Capabilities Index (ECI), der die Ergebnisse vieler Benchmarks zu einer Zahl je Modell zusammenführt. Das sind die aktuellen Spitzenreiter in unseren Daten:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | Claude Opus 5.5 Anthropic | 22.09.2026 | 166,8 |
| 2 | GPT-6 Astra OpenAI | 03.09.2026 | 166,4 |
| 3 | GPT-6.1 Sol OpenAI | 29.09.2026 | 166,3 |
| 4 | Claude Fable 5.1 Anthropic | 01.09.2026 | 164,7 |
| 5 | Gemini 4 Argon Google DeepMind | 30.09.2026 | 164,6 |
| 6 | Claude Sonnet 5.5 Anthropic | 28.09.2026 | 164,4 |
| 7 | Claude Opus 5 Anthropic | 24.07.2026 | 162,6 |
| 8 | GPT-6 Sol OpenAI | 22.09.2026 | 162,6 |



Fasst die Ergebnisse von mehr als 50 Benchmarks zu einer Zahl je Modell zusammen, sodass sich Modelle vergleichen lassen, auch wenn sie nie auf denselben Benchmarks geprüft wurden. Ein Index, kein Prozentwert: Epoch AI skaliert ihn so, dass Claude 3.5 Sonnet bei 130 und GPT-5 bei 150 steht. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Ein hoher Rang zeigt, dass ein Modell allgemein stark ist. Er zeigt nicht, wie gut es mit Ihren Support-Tickets, Ihren Produktdaten oder Ihrer Sprache umgeht. Das zeigt nur ein Test mit Ihren eigenen Eingaben — wie er funktioniert, erklärt der letzte Abschnitt.
Tempo, auch Latenz genannt, hat zwei Teile. Die Zeit bis zum ersten Token gibt an, wie lange es dauert, bis die Antwort beginnt. Die Ausgabegeschwindigkeit gibt an, wie viele Tokens pro Sekunde das Modell danach schreibt. Große Modelle und Reasoning-Modelle, die ein Problem vor der Antwort Schritt für Schritt durcharbeiten, sind oft langsamer. Mit Streaming sehen Nutzer die Antwort, während sie entsteht, und das Warten fühlt sich kürzer an.
Kosten hängen an den Tokens jeder Anfrage. APIs rechnen Eingabe- und Ausgabe-Tokens getrennt ab, mit unterschiedlichen Preisen je Modell. Ein größeres Modell kostet pro Token meist mehr, und Reasoning erzeugt zusätzliche Ausgabe-Tokens, die Sie ebenfalls bezahlen. Vergleichen Sie die Kosten einer typischen Anfrage mit Ihren eigenen Token-Zahlen, nicht nur die Preisliste.
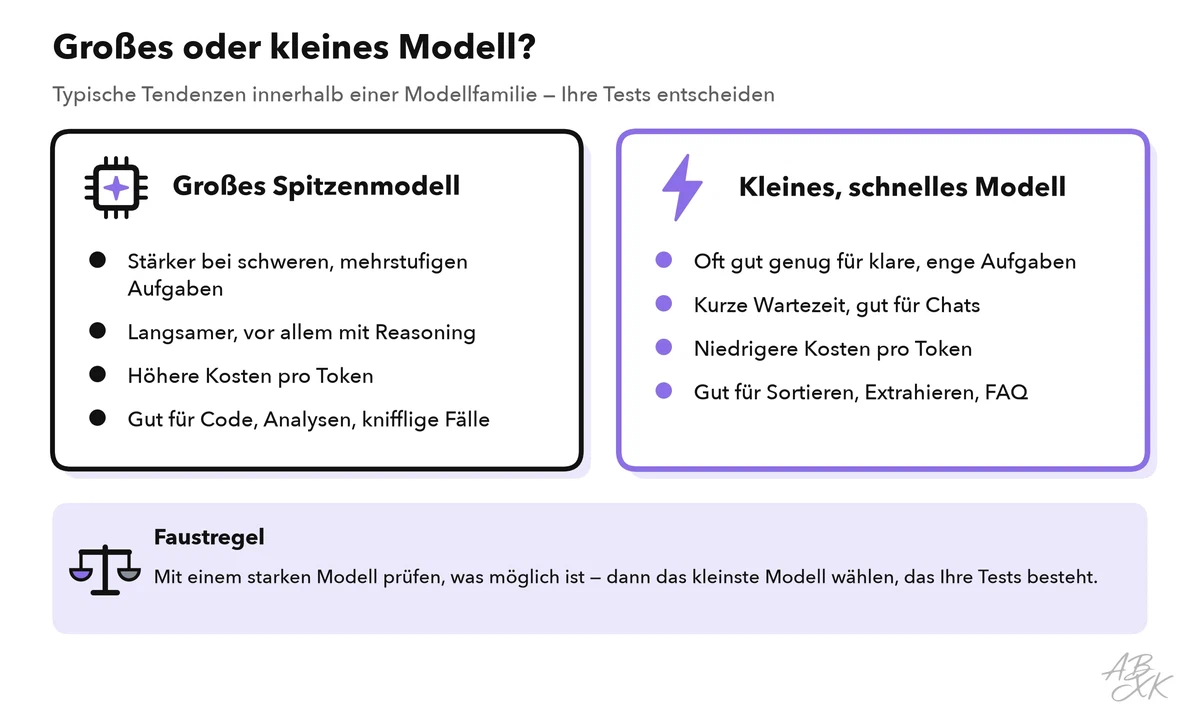
Innerhalb einer Modellfamilie hängen diese drei Kriterien meist zusammen: Das größere Modell ist stärker, langsamer und teurer.
Das Kontextfenster ist das vierte Kriterium: Es muss Ihre Anweisungen, Dokumente, den Gesprächsverlauf und die Antwort aufnehmen. Ein größeres Fenster ist nicht automatisch besser, denn jedes Token, das Sie schicken, kostet Geld und Zeit.
Offene oder geschlossene Gewichte
Die Gewichte sind die Zahlen, die ein Modell im Training gelernt hat. Bei offenen Gewichten (Open Weights) sind die Modelldateien veröffentlicht. Sie können das Modell auf eigener Hardware oder auf gemieteten GPUs betreiben, und viele Hosting-Dienste bieten solche Modelle auch über eine API an. Bei geschlossenen Gewichten nutzen Sie das Modell nur über die API oder die App des Anbieters. In unserer Datenbank haben 172 Modelle offene Gewichte, 160 sind geschlossen.
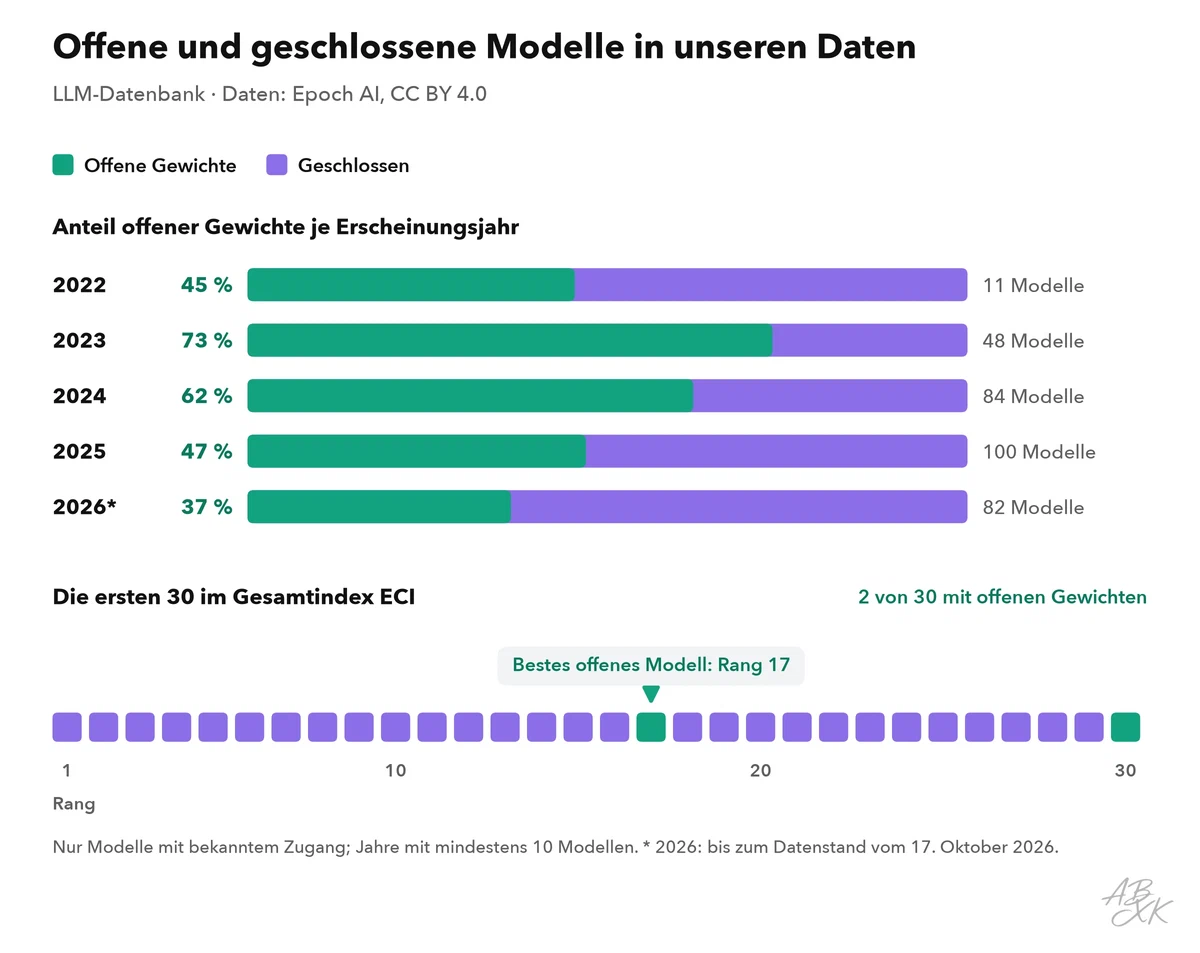
Die Abbildung zeigt zwei Blicke auf dieselben Daten: welcher Anteil der neuen Modelle in unserer Datenbank in jedem Jahr mit offenen Gewichten erschienen ist und wo Modelle mit offenen Gewichten in der Gesamtwertung stehen. Unsere Datenbank führt Modelle mit veröffentlichten Testergebnissen. Sie zeigt also diese Modelle, nicht jedes Modell auf dem Markt. Hier einige starke Modelle mit offenen Gewichten aus unseren Daten:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Kimi K3 Moonshot | 16.07.2026 | offen | 157,4 | 17 |
| DeepSeek V4.1 Flash DeepSeek | 09.09.2026 | offen | 155,6 | 31 |
| DeepSeek V4 Pro 0813 DeepSeek | 13.08.2026 | offen | 155,3 | 32 |
| GLM-5.3-Flash Z.ai (Zhipu AI) | 20.08.2026 | offen | 153,2 | 45 |
| Qwen 3.8 27B Alibaba | 14.08.2026 | offen | 151,6 | 52 |


ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Eine Angabe wie 27B im Modellnamen nennt meist die Zahl der Parameter, hier 27 Milliarden. Als grobe Orientierung gilt: Mehr Parameter brauchen mehr GPU-Speicher und mehr Rechenleistung.
Bei der Wahl zwischen beiden Gruppen geht es um Kontrolle und Aufwand:
| Offene Gewichte | Geschlossene Gewichte | |
|---|---|---|
| Wo das Modell läuft | Wo Sie entscheiden: eigene Server, GPU-Cloud, Hosting-Dienst | Beim Anbieter |
| Ihre Daten | Können in Ihrer eigenen Umgebung bleiben | Gehen an den Anbieter, nach dessen Bedingungen |
| Versionen | Sie behalten die Dateien, so lange Sie wollen | Der Anbieter aktualisiert Versionen und stellt sie ein |
| Anpassen | Fine-Tuning auf eigener Hardware möglich | Nur, wo der Anbieter es anbietet |
| Aufwand | Sie betreiben, skalieren und sichern alles selbst — oder bezahlen einen Hoster | Gering: Ein API-Schlüssel genügt |
| Lizenz | Unterschiedlich; manche Lizenzen schränken bestimmte Nutzungen ein | Festgelegt in den Nutzungsbedingungen des Anbieters |
„Offene Gewichte“ heißt nicht immer „Open Source“. Manche Lizenzen begrenzen die kommerzielle Nutzung, stellen Bedingungen für sehr große Dienste oder verlangen, dass Sie das Modell nennen. Lesen Sie die Lizenz, bevor Sie auf einem Modell aufbauen. Wenn Sie ein Modell mit offenen Gewichten selbst betreiben möchten, vermietet eine GPU-Cloud wie Runpod laut Anbieter die Hardware, abgerechnet nach Nutzung. Level 3 erklärt, wann sich gemietete GPUs lohnen.
Fragen, bevor Sie sich festlegen
Benchmarks beantworten keine Fragen zu Daten und Betrieb. Die Antworten finden Sie in der Dokumentation des Anbieters, in seinen Nutzungsbedingungen und im Vertrag zur Auftragsverarbeitung:
| Frage | Warum sie zählt |
|---|---|
| Werden Ihre API-Eingaben zum Training genutzt? | Eingaben können Kundendaten oder Geschäftsgeheimnisse enthalten |
| Wo werden die Daten verarbeitet und gespeichert? | Manche Datenregeln verlangen eine Region, etwa die EU |
| Wie lange werden Ein- und Ausgaben aufbewahrt? | Kürzere Speicherung bedeutet weniger Risiko |
| Gibt es einen Vertrag zur Auftragsverarbeitung (AVV)? | Nach der DSGVO braucht ihn jeder Anbieter, der personenbezogene Daten in Ihrem Auftrag verarbeitet (Artikel 28) |
| Können Sie eine feste Modellversion nutzen, und wann wird sie eingestellt? | Eine stille Änderung oder eine Abschaltung kann Ihre App lahmlegen |
| Kann das Modell, was Ihre App braucht? | Zum Beispiel JSON-Ausgabe, Tool Calling, Bilder oder Ihre Sprachen |
Die Shortlist mit eigenen Daten testen
Jetzt grenzen Sie die Auswahl ein. Streichen Sie jedes Modell, das eine harte Anforderung verfehlt, und wählen Sie zwei bis vier Kandidaten unterschiedlicher Größe — am besten von mindestens zwei Anbietern. Dann testen Sie alle mit demselben Prompt.
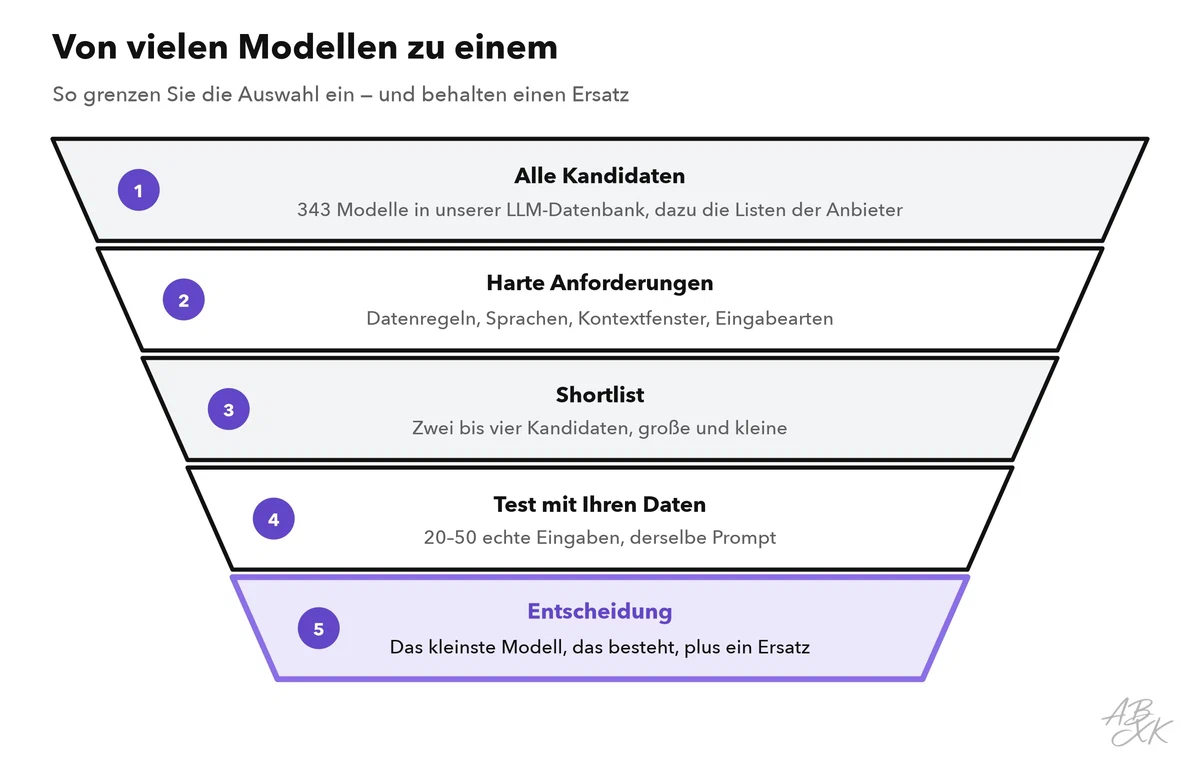
- Sammeln Sie 20 bis 50 echte Eingaben und notieren Sie zu jeder das erwartete Ergebnis. Nehmen Sie leichte, typische und knifflige Fälle auf. Wenn Sie Ihre Prompts wie in Teil 2 versionieren, haben Sie ein solches Testset bereits.
- Lassen Sie jeden Kandidaten laufen, mit demselben Prompt und denselben Einstellungen, und halten Sie Antwort, Zeit und Tokens jeder Anfrage fest.
- Bewerten Sie die Antworten. Markieren Sie jede als richtig oder falsch, oder nutzen Sie eine einfache Skala. Level 2 macht daraus automatisierte Evals.
- Berechnen Sie die Kosten pro 1.000 Anfragen aus den Token-Zahlen und den aktuellen Preisen des Anbieters.
- Entscheiden Sie. Wählen Sie das kleinste oder günstigste Modell, das Ihre Qualitätsschwelle erreicht. Behalten Sie den Zweitplatzierten als Ersatzmodell (Fallback) für Ausfälle, am besten von einem anderen Anbieter.
Ein kurzes Skript erledigt die Schritte 2 und 4 für Sie. Es nutzt die Anfrage aus Teil 1 und schreibt je Antwort eine Zeile in eine CSV-Datei, die Sie in einer Tabellenkalkulation öffnen können:
import csv
import os
import time

import requests

URL = "https://api.example.com/v1/chat"                  # Endpunkt Ihres Anbieters
HEADERS = {"Authorization": f"Bearer {os.environ['LLM_API_KEY']}"}
CANDIDATES = ["model-large", "model-medium", "model-small"]  # Modell-IDs aus der Doku
SYSTEM = open("prompts/faq_v3.txt").read()               # derselbe Prompt für jedes Modell

with open("tests.csv", newline="") as f:                 # Spalten: question, expected
    tests = list(csv.DictReader(f))

with open("results.csv", "w", newline="") as f:
    out = csv.writer(f)
    out.writerow(["model", "question", "expected", "answer", "seconds", "tokens_in", "tokens_out"])
    for model in CANDIDATES:
        for t in tests:
            start = time.perf_counter()
            r = requests.post(URL, headers=HEADERS, timeout=60, json={
                "model": model,
                "messages": [{"role": "system", "content": SYSTEM},
                             {"role": "user", "content": t["question"]}],
                "max_tokens": 400,
            })
            r.raise_for_status()
            data = r.json()                              # Aufbau wie in Teil 1; je nach Anbieter anders
            out.writerow([model, t["question"], t["expected"], data["output"][0]["text"],
                          round(time.perf_counter() - start, 2),
                          data["usage"]["input_tokens"], data["usage"]["output_tokens"]])
Wiederholen Sie jeden Test mehrmals, wenn die Antworten schwanken, und sehen Sie sich die langsamsten Antworten an, nicht nur den Durchschnitt. Ein Modell, das meist schnell ist, aber manchmal viel länger braucht, kann Ihre Nutzer trotzdem verärgern.
Welches Modell für welche App: eine Entscheidungstabelle
Ihre Testergebnisse entscheiden, doch diese Tabelle gibt Ihnen einen sinnvollen Ausgangspunkt für die Shortlist:
| Ihre App | Beginnen Sie mit | Achten Sie auf |
|---|---|---|
| Antworten aus Ihren Dokumenten (FAQ, Support) | Einem kleinen oder mittelgroßen Modell mit genug Kontext für Ihre Textstellen | Viele falsche Antworten stammen aus der Suche, nicht vom Modell — prüfen Sie zuerst die Textstellen |
| Sortieren, Verschlagworten, Daten als JSON extrahieren | Einem kleinen, schnellen Modell | Grenzfälle; das JSON im Code prüfen |
| Entwürfe und Zusammenfassungen, die Menschen überarbeiten | Einem mittelgroßen Modell | Ton und Länge; ein Mensch prüft weiterhin |
| Hilfe beim Programmieren, komplexe Analysen, mehrstufige Agenten | Einem Modell weit oben in der Gesamtwertung | Zeit und Kosten pro Aufgabe |
| Live-Chat oder Sprache mit kurzen Antworten | Einem schnellen Modell, mit Streaming | Zeit bis zum ersten Token |
| Daten, die auf Ihren Servern bleiben müssen | Einem Modell mit offenen Gewichten auf eigener oder gemieteter Hardware | Lizenzbedingungen; Aufwand für den GPU-Betrieb |
| Lange Verträge oder Handbücher | Einem Modell mit großem Kontextfenster — oder stattdessen einer Suche in Ihren Dokumenten | Kosten pro Anfrage; Details, die in langen Eingaben untergehen |
Prüfen Sie Ihre Wahl von Zeit zu Zeit erneut. Neue Modelle erscheinen häufig, und Anbieter stellen ältere Versionen ein. Weil Testset und Skript schon existieren, ist die Prüfung eines neuen Kandidaten eine Sache von einer Stunde, kein Projekt.