

Die meisten KI-Apps betreiben gar kein Sprachmodell selbst. Sie schicken Text an ein Modell bei einem Anbieter und bekommen Text zurück. Drei Begriffe prägen diesen Austausch: die API, über die jede Anfrage läuft, die Tokens, in denen das Modell jedes Stück Text zählt, und das Kontextfenster, das begrenzt, wie viel Text in eine Anfrage passt. Zusammen entscheiden sie, was Ihre App kann, wie schnell sie antwortet und was sie kostet.
Dies ist Teil 3 von Level 0 unseres Lernpfads AI Development. Programmierkenntnisse brauchen Sie nicht. Sie lernen, was eine API und ein API-Schlüssel sind, wie aus Text Tokens werden, was in ein Kontextfenster passt, warum Anbieter Ihre Anfragen begrenzen und warum Sie pro Token bezahlen. Teil 2 hat die Teile einer KI-App gezeigt. Dieser Teil schaut genau auf die Grenze zwischen Ihrer App und dem Modell.
Was eine API ist
Teil 1 hat eine API (Application Programming Interface, eine Programmierschnittstelle) als fest vereinbarten Weg beschrieben, auf dem zwei Programme Daten austauschen. Bei einem Sprachmodell ist die API eine Webadresse beim Anbieter, der sogenannte Endpunkt (Endpoint). Dorthin schickt Ihre App eine Anfrage (Request): welches Modell antworten soll, Ihre Anweisungen und den Text der Nutzerin oder des Nutzers. Der Anbieter führt das Modell aus und schickt eine Antwort (Response) zurück: den Text des Modells und dazu Angaben zur Anfrage, etwa die Zahl der verbrauchten Tokens.
Dieselben Modelle kennen Sie vielleicht aus Chat-Apps. Die API ist ein zweiter Zugang, gebaut für Programme statt für Menschen:
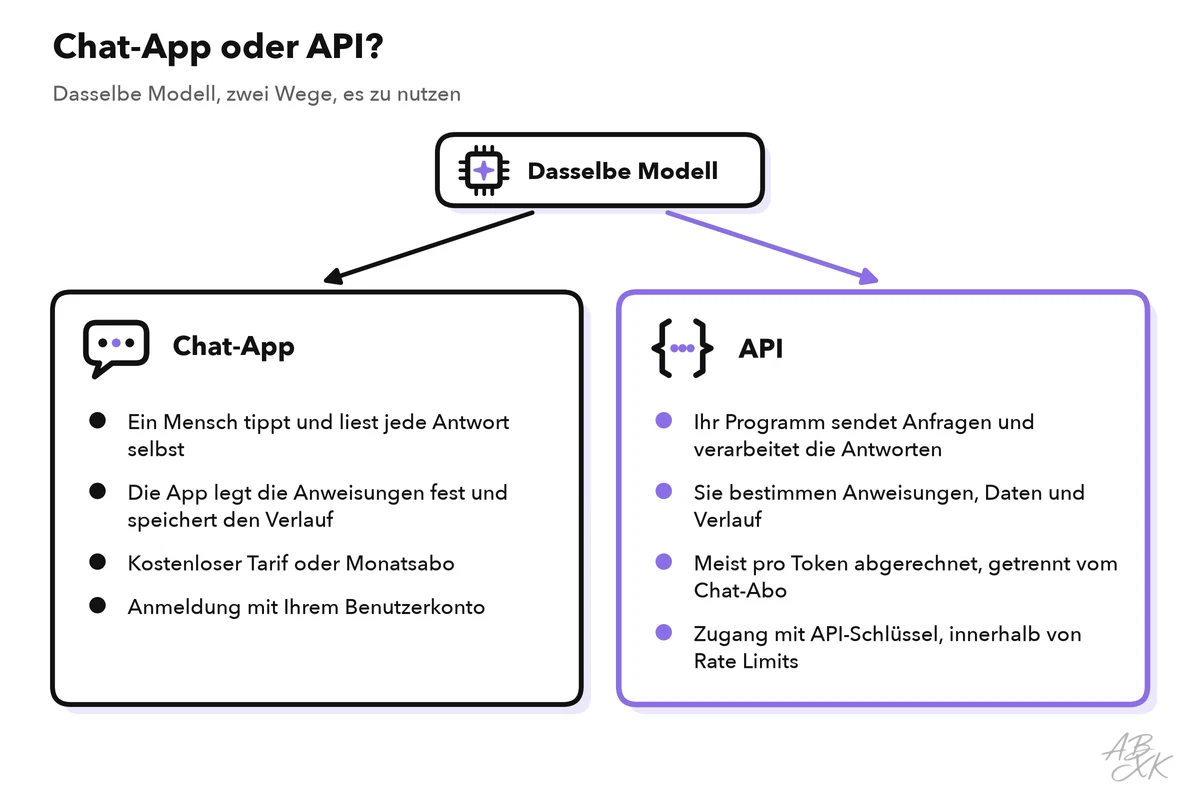
Ein Unterschied zählt von Anfang an. Wie Teil 2 gezeigt hat, erinnert sich das Modell bei einer typischen Chat-API nicht an Ihre früheren Anfragen. Eine Chat-App speichert den Verlauf für Sie. Über die API muss Ihre App dagegen bei jeder Anfrage alles mitschicken, was das Modell braucht: die Anweisungen, die passenden Daten und die bisherigen Nachrichten.
Nicht jedes Modell lässt sich herunterladen. Von den 343 Modellen in unserer LLM-Datenbank sind 160 geschlossen: Sie nutzen sie nur über eine API oder eine App. 172 haben offene Gewichte. Diese Modelle können Sie selbst betreiben, wenn die Lizenz Ihre Nutzung erlaubt, und viele Hosting-Dienste bieten sie ebenfalls über eine API an. Einige aktuelle Modelle aus beiden Gruppen:
| Modell | Erschienen | Gewichte | ECI | Rang |
|---|---|---|---|---|
| Claude Opus 5.5 Anthropic | 22.09.2026 | geschlossen | 166,8 | 1 |
| GPT-6.1 Sol OpenAI | 29.09.2026 | geschlossen | 166,3 | 3 |
| Gemini 3.8 Flash Google DeepMind | 02.09.2026 | geschlossen | 157,2 | 19 |
| Grok 4.6 xAI | 12.08.2026 | geschlossen | 156,3 | 27 |
| Kimi K3 Moonshot | 16.07.2026 | offen | 157,4 | 17 |
| DeepSeek V4.1 Flash DeepSeek | 09.09.2026 | offen | 155,6 | 31 |




ECI = Epoch Capabilities Index, ein Gesamtwert über viele Benchmarks; Rang unter allen Modellen mit ECI. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Wenn Sie ohne Code bauen, schicken Plattformen wie MindStudio diese API-Anfragen für Sie. Die Regeln für Tokens und Limits gelten im Hintergrund trotzdem.
API-Schlüssel: Das Geheimnis bleibt auf dem Server
Ein API-Schlüssel (API Key) ist eine lange, geheime Zeichenfolge, die Ihr Konto ausweist. Sie erzeugen ihn in der Konsole des Anbieters, dem Web-Dashboard Ihres Kontos. Der Anbieter prüft den Schlüssel bei jeder Anfrage. Jede Anfrage mit Ihrem Schlüssel zählt gegen Ihre Limits und landet auf Ihrer Rechnung, ganz gleich, wer sie geschickt hat. Behandeln Sie einen Schlüssel wie ein Passwort.
Der Schlüssel gehört ins Backend, den Teil Ihrer App, der auf einem Server läuft. Der Browser oder die mobile App spricht mit Ihrem Backend, und nur das Backend spricht mit dem Anbieter des Modells. Auf dem Server liegt der Schlüssel in einer Umgebungsvariable (Environment Variable): einer Einstellung außerhalb Ihres Codes, die Ihr Programm beim Ausführen liest. Hosting-Plattformen wie Netlify bieten Umgebungsvariablen für serverseitige Funktionen an, sodass der Schlüssel nie in Ihrem Code steht.
| Richtig | Falsch |
|---|---|
| Den Schlüssel in einer Umgebungsvariable oder einem Secret Manager (einem Tresor für Schlüssel und Passwörter) auf dem Server ablegen | Den Schlüssel in den Code schreiben oder in eine Datei, die mit dem Code gespeichert wird |
| Das Modell aus Ihrem Backend aufrufen | Das Modell mit Ihrem Schlüssel aus einer Webseite oder einer mobilen App aufrufen, wo jeder ihn auslesen kann |
| Einen Schlüssel je App und je Umgebung anlegen, etwa für Test und Live-Betrieb | Einen Schlüssel für alle Projekte und Kollegen teilen |
| In der Konsole des Anbieters ein Budgetlimit und Warnungen zum Verbrauch einrichten, falls es sie gibt | Ungewöhnlichen Verbrauch erst bemerken, wenn die Rechnung kommt |
Tokens: So zählen Modelle Text
Sprachmodelle lesen weder Buchstaben noch ganze Wörter. Sie lesen Tokens: Textstücke aus einem festen Vokabular mit Zehntausenden Einträgen oder mehr. Ein kleines Programm, der Tokenizer, zerlegt Ihren Text in diese Stücke und ersetzt jedes Stück durch seine Nummer im Vokabular. Das Modell rechnet nur mit diesen Nummern. Auch seine Antwort entsteht als Folge von Token-Nummern, die danach wieder in Text übersetzt werden.
Ein häufiges kurzes Wort ist meist ein einziges Token, oft zusammen mit dem Leerzeichen davor. Seltene oder lange Wörter, Zahlen und Code werden in mehrere Stücke zerlegt:
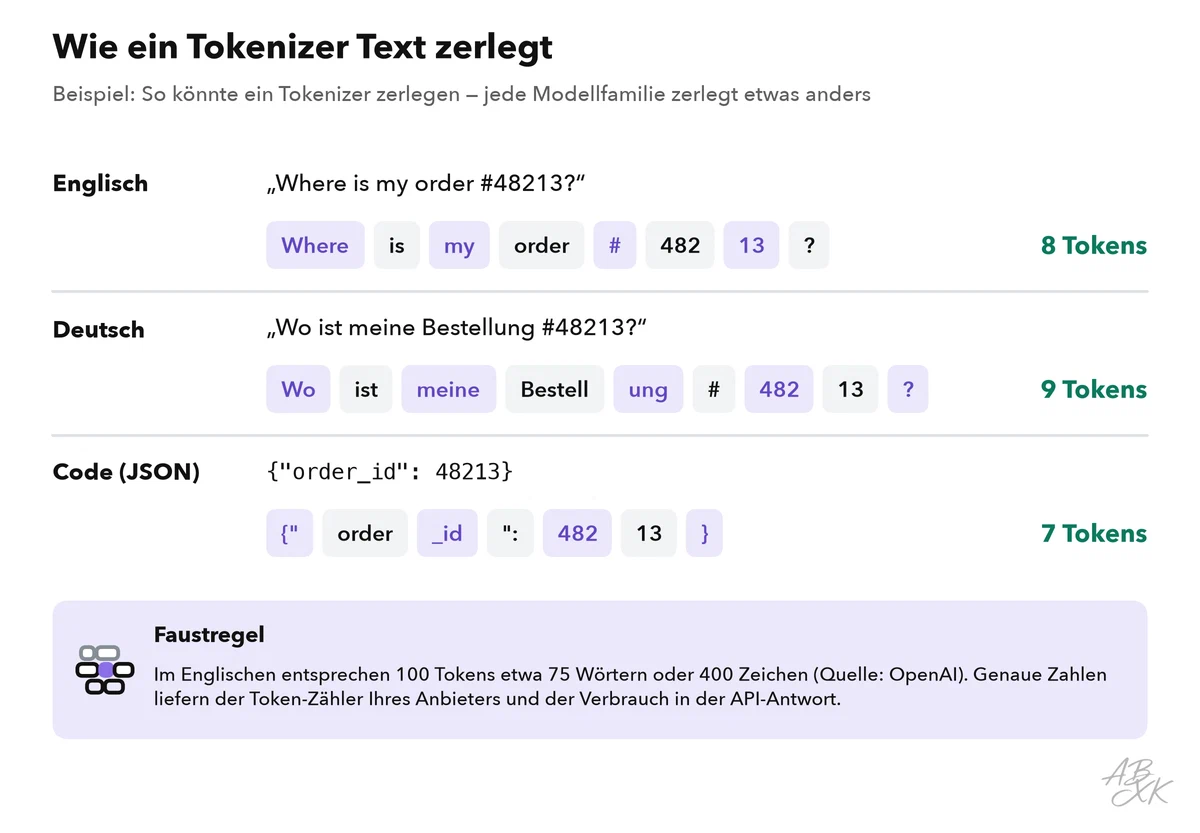
Für Schätzungen hilft eine Faustregel: Im Englischen entsprechen 100 Tokens etwa 75 Wörtern, und ein Token entspricht etwa vier Zeichen (Quelle: OpenAI Help Center, help.openai.com). Andere Texte brauchen für denselben Inhalt meist mehr Tokens:
| Text | Wirkung auf die Zahl der Tokens |
|---|---|
| Englischer Alltagstext | Die Grundlage der Faustregel |
| Deutsch und viele andere Sprachen | Oft mehr Tokens für dieselbe Aussage |
| Bestellnummern, Beträge, Datumsangaben | In mehrere kurze Stücke zerlegt |
| Code und JSON | Klammern, Anführungszeichen und Leerzeichen zählen mit |
| Bilder, Audio, PDF-Dateien | Werden ebenfalls in Tokens umgerechnet, oft viele pro Datei |
Tokenizer unterscheiden sich zwischen Modellfamilien, deshalb kann derselbe Text bei jedem Modell eine andere Zahl von Tokens ergeben. Genaue Zahlen liefert der Token-Zähler Ihres Anbieters, oder Sie lesen den Token-Verbrauch in der API-Antwort ab.
Eingabe-Tokens und Ausgabe-Tokens
Jede Anfrage hat zwei Seiten, und der Anbieter zählt beide:
- Eingabe-Tokens (Input Tokens) sind alles, was Sie schicken: Anweisungen, frühere Nachrichten, Dokumente wie ein Hilfeartikel und die neue Frage.
- Ausgabe-Tokens (Output Tokens) sind alles, was das Modell schreibt. Das Modell erzeugt sie eines nach dem anderen, deshalb dauert eine lange Antwort länger als eine kurze. Eine Einstellung namens maximale Ausgabe-Tokens (Max Output Tokens) begrenzt die Länge. Erreicht das Modell diese Grenze, bricht die Antwort ab.
Viele neuere Modelle „denken“ außerdem, bevor sie antworten. Diese Reasoning-Tokens sind oft nicht sichtbar, zählen aber bei vielen Anbietern als Ausgabe-Tokens und erscheinen auf Ihrer Rechnung.
Weil sich eine typische Chat-API nicht an frühere Anfragen erinnert, wächst die Eingabe im Lauf eines Gesprächs. Jede neue Anfrage trägt den ganzen Verlauf erneut mit:
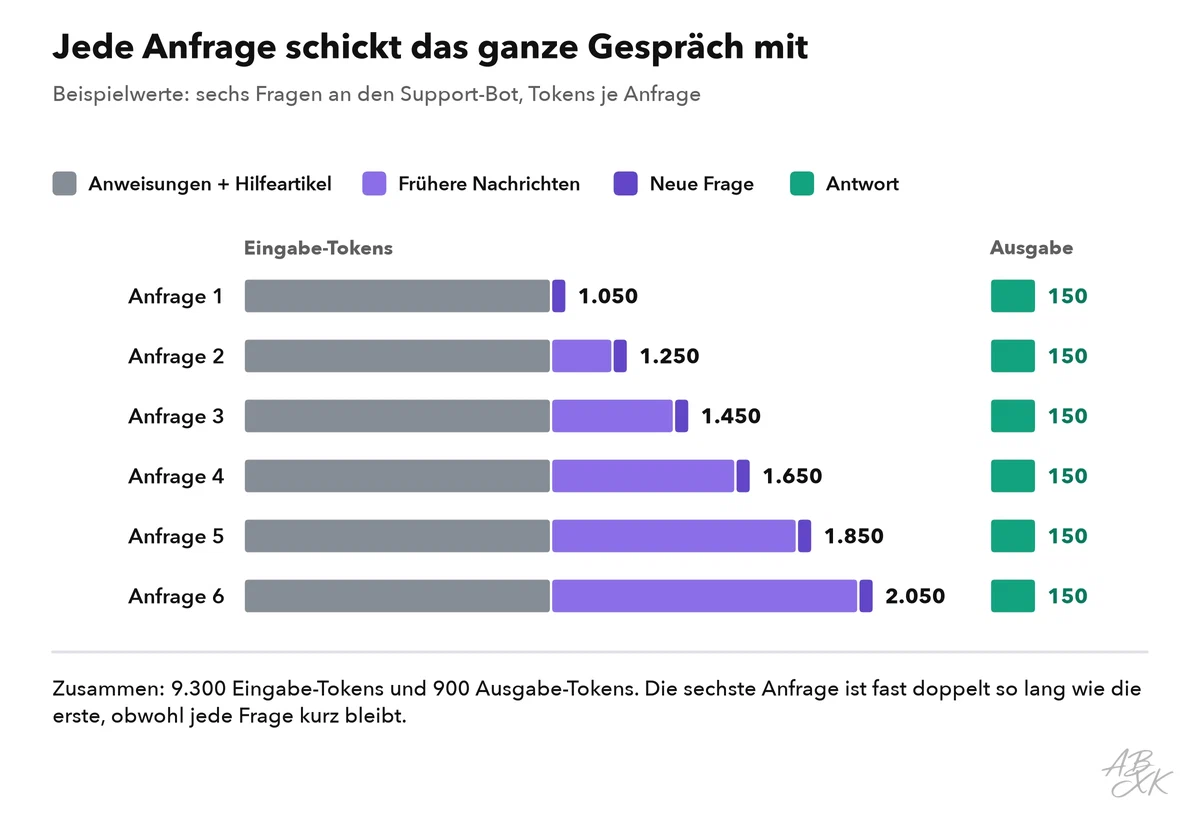
In diesem Beispiel trägt die sechste Anfrage fast doppelt so viele Eingabe-Tokens wie die erste, obwohl die Fragen der Kundin kurz bleiben. Lange Chats werden mit jeder Runde langsamer und teurer. Irgendwann passen sie nicht mehr ins Kontextfenster.
Das Kontextfenster: die Grenze einer Anfrage
Das Kontextfenster (Context Window) ist die größte Zahl von Tokens, die ein Modell in einer Anfrage verarbeiten kann: Eingabe und Ausgabe zusammen. Stellen Sie es sich als Kasten mit fester Größe vor. Zuerst kommen Anweisungen, Dokumente, Chatverlauf und Frage hinein. Die Antwort muss in den Platz passen, der übrig bleibt.
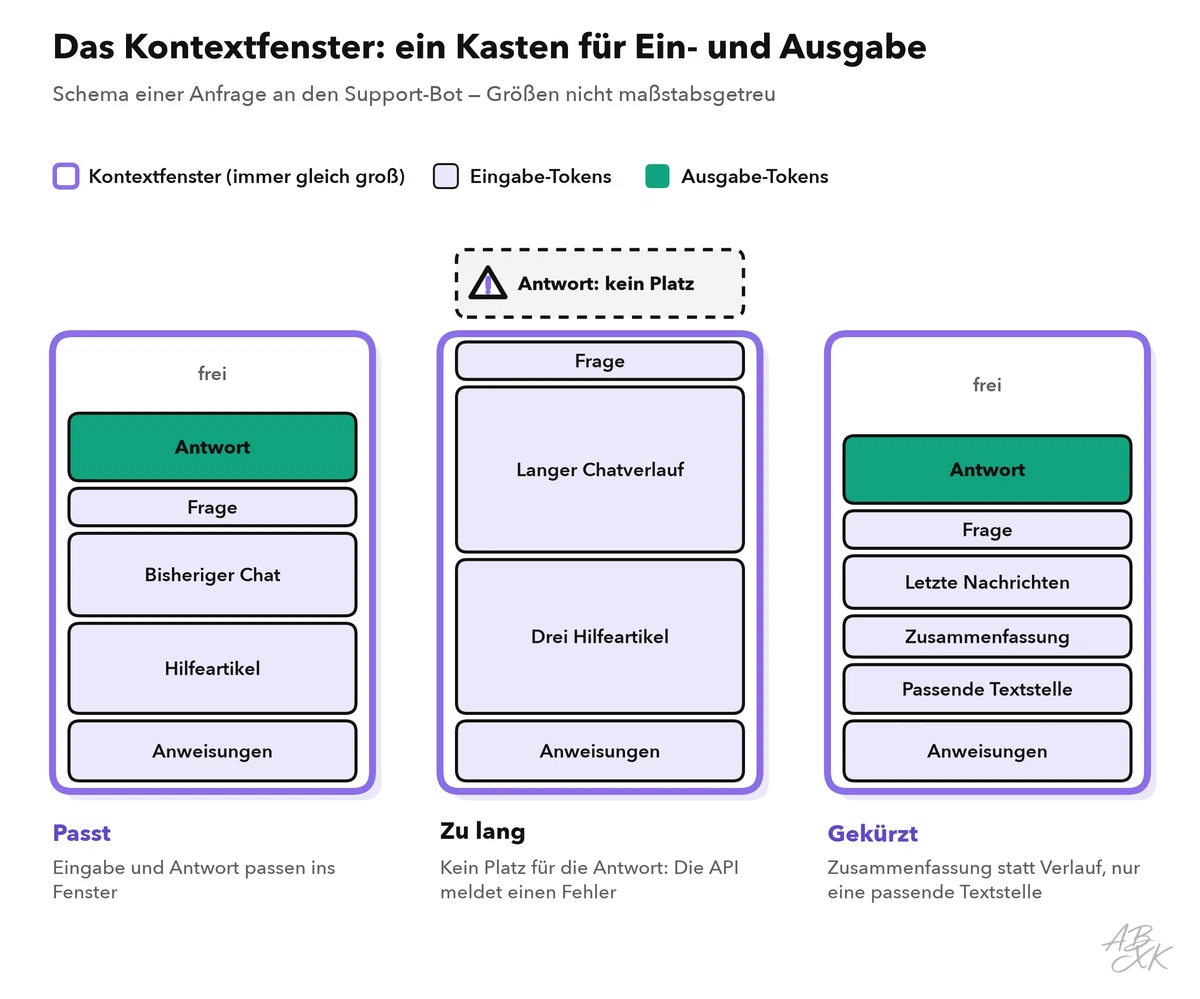
Jedes Modell hat sein eigenes Kontextfenster. Der Anbieter nennt es auf der Modellseite, oft zusammen mit einer niedrigeren Grenze nur für die Ausgabe. Passen die Eingabe und der für die Antwort reservierte Platz nicht hinein, lehnt die API die Anfrage meist mit einer Fehlermeldung ab. Viele Chat-Apps lösen das für Sie, etwa indem sie alte Nachrichten weglassen oder kürzen. In Ihrer eigenen App entscheiden Sie, was passiert. Drei übliche Strategien:
- Nur die letzten Nachrichten behalten. Schicken Sie die letzten Runden mit und lassen Sie die ältesten weg.
- Zusammenfassen. Ersetzen Sie den älteren Teil des Chats durch eine kurze Zusammenfassung.
- Nachschlagen statt kopieren. Legen Sie Ihre Dokumente in einem Suchindex ab, etwa in einer Vektordatenbank wie Pinecone, und schicken Sie nur die Textstellen mit, die zur Frage passen. Level 2 erklärt diese Methode, Retrieval-Augmented Generation, Schritt für Schritt.
Ein größeres Fenster ist nicht automatisch besser. Jedes Token, das Sie schicken, kostet Geld und Zeit, und Modelle nutzen nicht alle Teile einer langen Eingabe gleich gut. Eine Studie fand heraus, dass Modelle Informationen übersehen können, die in der Mitte einer langen Eingabe stehen (Quelle: Liu et al., „Lost in the Middle: How Language Models Use Long Contexts“, 2023, arxiv.org). Schicken Sie, was die Aufgabe braucht, nicht alles, was Sie haben.
Rate Limits: Wie viel Sie pro Minute schicken dürfen
Anbieter schützen ihre Server mit Rate Limits: Obergrenzen dafür, wie viel ein Konto in einem bestimmten Zeitraum schicken darf. Am häufigsten sind Anfragen pro Minute (Requests per Minute, RPM) und Tokens pro Minute (Tokens per Minute, TPM). Manche Anbieter setzen zusätzlich Tageslimits oder zählen Eingabe- und Ausgabe-Tokens getrennt. Das Limit, das Sie zuerst erreichen, bremst Sie aus.
| Limit | Was es zählt | Wann Sie es erreichen |
|---|---|---|
| Anfragen pro Minute (RPM) | Aufrufe, egal wie lang sie sind | Viele kurze Anfragen, etwa beim Sortieren Tausender kurzer E-Mails |
| Tokens pro Minute (TPM) | Tokens aller Aufrufe zusammen | Wenige lange Anfragen, etwa Zusammenfassungen langer PDF-Dateien |
| Tageslimits | Anfragen oder Tokens pro Tag | Große Stapelaufträge, die stundenlang laufen |
Überschreiten Sie ein Limit, antwortet die API mit dem HTTP-Statuscode 429 („Too Many Requests“). Ihre App sollte dann warten und es erneut versuchen, mit jedem Mal etwas länger. Level 1 zeigt dieses Muster in Ihrem ersten LLM-API-Aufruf.
Limits unterscheiden sich von Konto zu Konto. Viele Anbieter ordnen Konten in Stufen ein, die mit Nutzung und Zahlungshistorie steigen, und zeigen die aktuellen Limits in der Konsole. Viele schicken außerdem mit jeder Antwort mit, wie viele Anfragen und Tokens Ihnen noch bleiben. So kann Ihre App langsamer werden, bevor sie an ein Limit stößt.
Warum APIs pro Token abrechnen: ein Rechenbeispiel
Tokens messen die Arbeit eines Modells: Es muss jedes Eingabe-Token verarbeiten und jedes Ausgabe-Token erzeugen. Deshalb rechnen Anbieter die API-Nutzung pro Token ab. Preise gelten meist pro Million Tokens, mit einem Preis für die Eingabe und einem für die Ausgabe, und Ausgabe-Tokens kosten in der Regel mehr. Ein Chat-Abo deckt die API-Nutzung meist nicht ab. Manche Anbieter berechnen weniger für Eingaben, die sich in vielen Anfragen wiederholen (Prompt Caching), oder für Aufträge, die warten können (Batch-Verarbeitung). Betreiben Sie ein Modell mit offenen Gewichten selbst, etwa in einer GPU-Cloud wie Runpod, zahlen Sie für GPU-Zeit statt für Tokens. Level 3 erklärt, wann sich gemietete GPUs lohnen.
Bevor Sie die Kosten eines Projekts schätzen, schlagen Sie diese Angaben für Ihr Modell nach:
| Was Sie nachschlagen | Wo Sie es finden | Was es Ihnen sagt |
|---|---|---|
| Kontextfenster | Modellseite des Anbieters | Wie viel Eingabe und Ausgabe in eine Anfrage passen |
| Maximale Ausgabe-Tokens | Modellseite | Die längstmögliche Antwort |
| Preis pro Million Eingabe- und Ausgabe-Tokens | Preisseite | Was eine Anfrage kostet |
| Rate Limits Ihrer Stufe | Konsole oder Seite zu den Limits | Wie viele Anfragen und Tokens Sie pro Minute schicken können |
| Token-Zähler | Dokumentation oder Konsole | Wie viele Tokens Ihre eigenen Texte ergeben |
Nun zur Schätzung. Hier ist der Support-Bot aus Teil 2, mit Beispielwerten für eine Anfrage:
| Teil der Anfrage | Tokens (Beispiel) |
|---|---|
| Anweisungen | 400 |
| Hilfeartikel (etwa 450 englische Wörter) | 600 |
| Bisheriger Chat (Durchschnitt) | 300 |
| Frage der Kundin | 50 |
| Eingabe pro Anfrage | 1.350 |
| Ausgabe: die Antwort | 150 |
Bei 2.000 Fragen am Tag liest der Bot 2,7 Millionen Eingabe-Tokens und schreibt 0,3 Millionen Ausgabe-Tokens pro Tag. In einem Monat mit 30 Tagen sind das etwa 81 Millionen Eingabe- und 9 Millionen Ausgabe-Tokens. Multiplizieren Sie diese Zahlen mit den aktuellen Preisen Ihres Anbieters pro Million Tokens, und Sie haben eine erste Schätzung.
Das Beispiel zeigt auch, wohin die Tokens gehen. Der Bot liest neunmal so viele Tokens, wie er schreibt, und die meisten davon sind Anweisungen und Hilfetext, die mit jeder Anfrage erneut mitgehen. Dort setzen Sie zuerst an, wenn Sie sparen wollen. Level 4 zeigt, wie Sie Kosten und Antwortzeit im großen Maßstab optimieren.