

Ein KI-Coding-Assistent schreibt eine Funktion in wenigen Minuten. Das Tempo ist nicht das Problem. Das Problem ist Code, den niemand wirklich geprüft hat: ein API-Schlüssel in einer Konfigurationsdatei, ein Paket, das es nicht gibt, ein Test, den der Agent stillschweigend geändert hat, damit er besteht. Ein guter Workflow behält das Tempo und ergänzt Gates: Prüfstellen, die jede Änderung passieren muss, bevor sie weiterkommt.
Dies ist Teil 5 von Level 2 in unserem Lernpfad AI Development. Er macht aus den Gewohnheiten aus Was KI-Coding-Assistenten tun einen wiederholbaren Ablauf: planen, erzeugen, prüfen, testen, committen. Sie lernen, wie Sie einen Assistenten einweisen, warum kleine Diffs und Tests zuerst wichtig sind, welche automatischen Prüfungen Secrets und riskante Pakete finden und wie Sie KI-geschriebenen Code mit einer Checkliste prüfen.
Fünf Schritte, fünf Gates
Jede Änderung durchläuft dieselben fünf Schritte. Jeder Schritt endet mit einem Gate: einer Frage, die mit Ja beantwortet sein muss. Lautet die Antwort Nein, geht die Änderung zurück, meist zum Erzeugen, manchmal bis zum Plan.
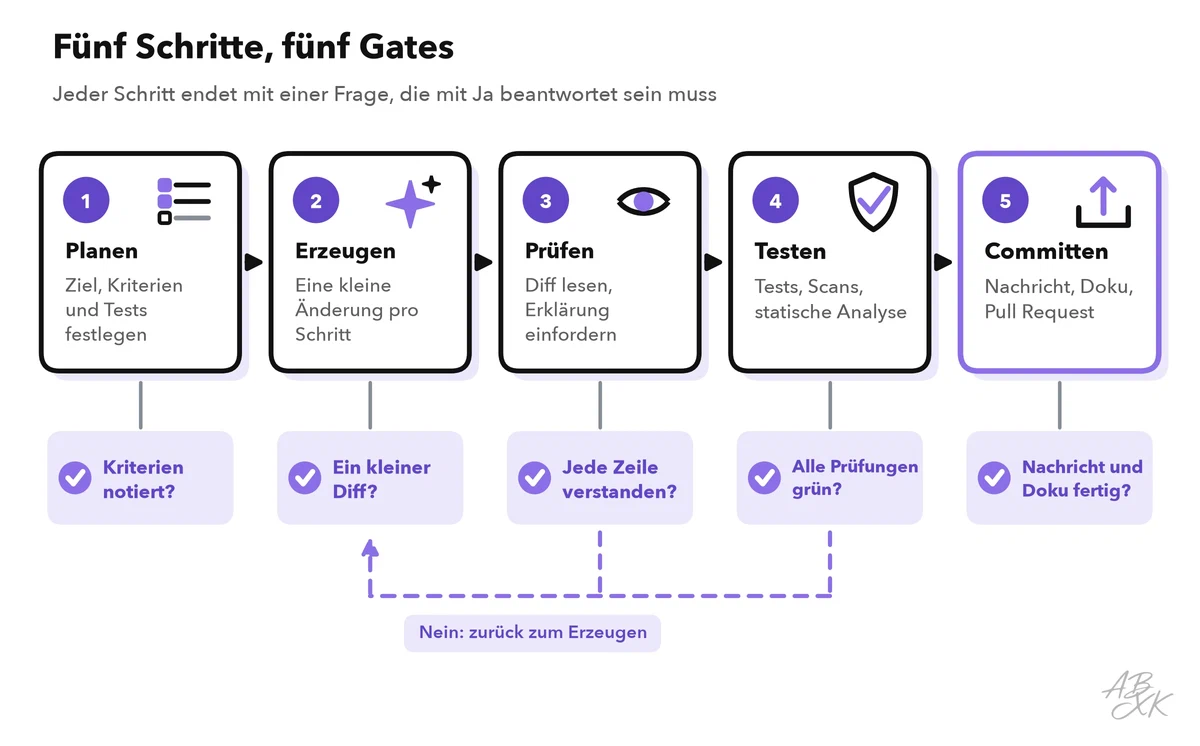
Die Gates sind keine Bürokratie. Googles DORA-Forschung weist in dieselbe Richtung: Arbeiten in kleinen Schritten verstärkt den positiven Einfluss von KI auf die Produktleistung, und häufige Commits verstärken ihren positiven Einfluss auf die individuelle Effektivität (Quelle: DORA AI Capabilities Model, Google Cloud, 2025, cloud.google.com).
Dieser Workflow gilt für Code, der ausgeliefert wird. Für schnelle Experimente können lockerere Regeln genügen: Unser VibeCoding-Artikel zeigt, wie wir mit KI Prototypen bauen — und warum Prototypen nicht in Produktion gehen.
Planen: erst die Aufgabe, dann der Prompt
Viel schlechter KI-Code beginnt mit einer vagen Anfrage. Bevor Sie den Assistenten öffnen, schreiben Sie die Aufgabe auf wie ein Ticket für eine neue Kollegin. Fünf Teile genügen:
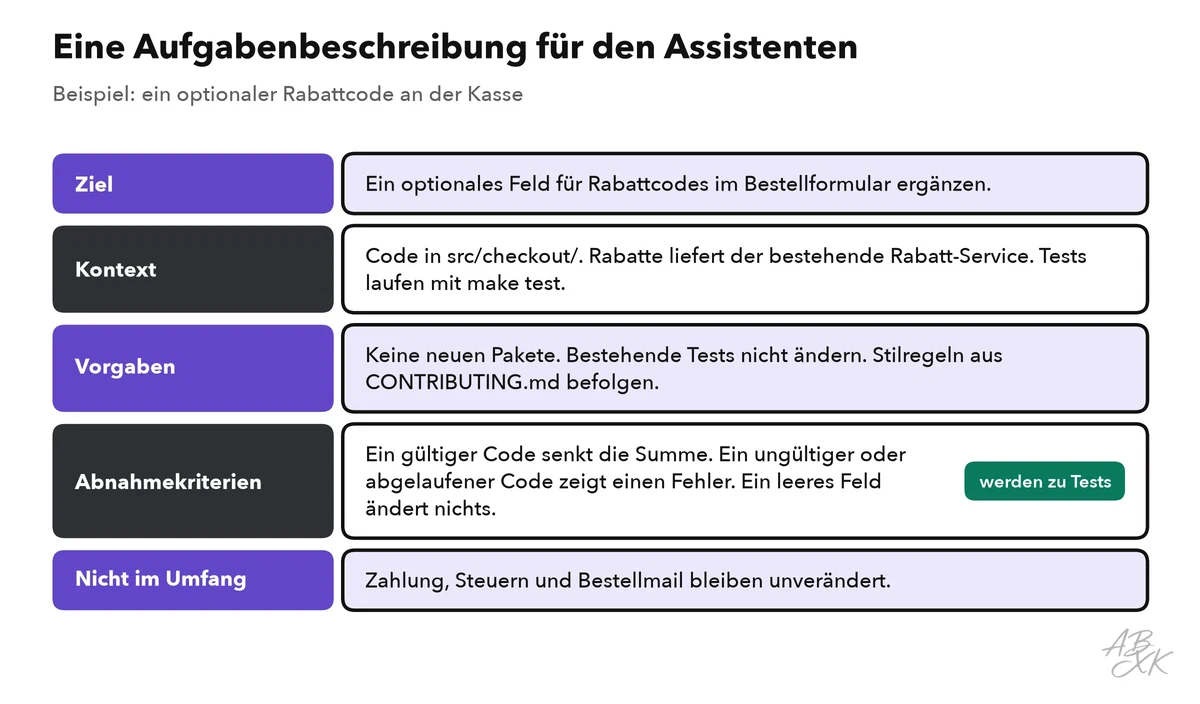
Fragen Sie dann nach einem Plan, bevor Code entsteht: „Nenne zuerst die Dateien, die sich ändern, und die Schritte. Warte dann auf meine Freigabe.“ Ein falscher Plan ist in einer Minute korrigiert. Derselbe Fehler in einem fertigen Diff kostet viel mehr Zeit.
Zwei weitere Gewohnheiten gehören zu diesem Schritt:
- Tests zuerst schreiben. Machen Sie aus den Abnahmekriterien Tests, oder lassen Sie den Assistenten sie schreiben, und prüfen Sie sie, bevor Code für die Funktion existiert. Bitten Sie dann um Code, der die Tests besteht, ohne sie zu ändern. Das heißt testgetriebene Entwicklung (Test-Driven Development, TDD) und liefert eine klare Definition von „fertig“.
- Feste Regeln ins Repository legen. Viele Coding-Agenten lesen eine Projektdatei mit Anweisungen, etwa AGENTS.md, ein offenes Format, das mehrere Tools unterstützen. Halten Sie dort Ihre Konventionen fest: wie die Tests laufen, den Code-Stil und was der Agent nie tun darf.
Erzeugen: kleine Diffs und begrenzte Rechte
Ein Diff ist die Liste der Zeilen, die eine Änderung hinzufügt, ändert oder löscht. Halten Sie ihn klein: eine Aufgabe, ein Branch, ein kleiner Diff. Googles Leitfaden für Code-Reviews nennt etwa 100 Zeilen eine vernünftige Größe für eine Änderung und 1.000 Zeilen meist zu groß (Quelle: Google Engineering Practices, „Small CLs“, google.github.io). Kleine Änderungen werden früher und sorgfältiger geprüft und lassen sich leicht rückgängig machen.
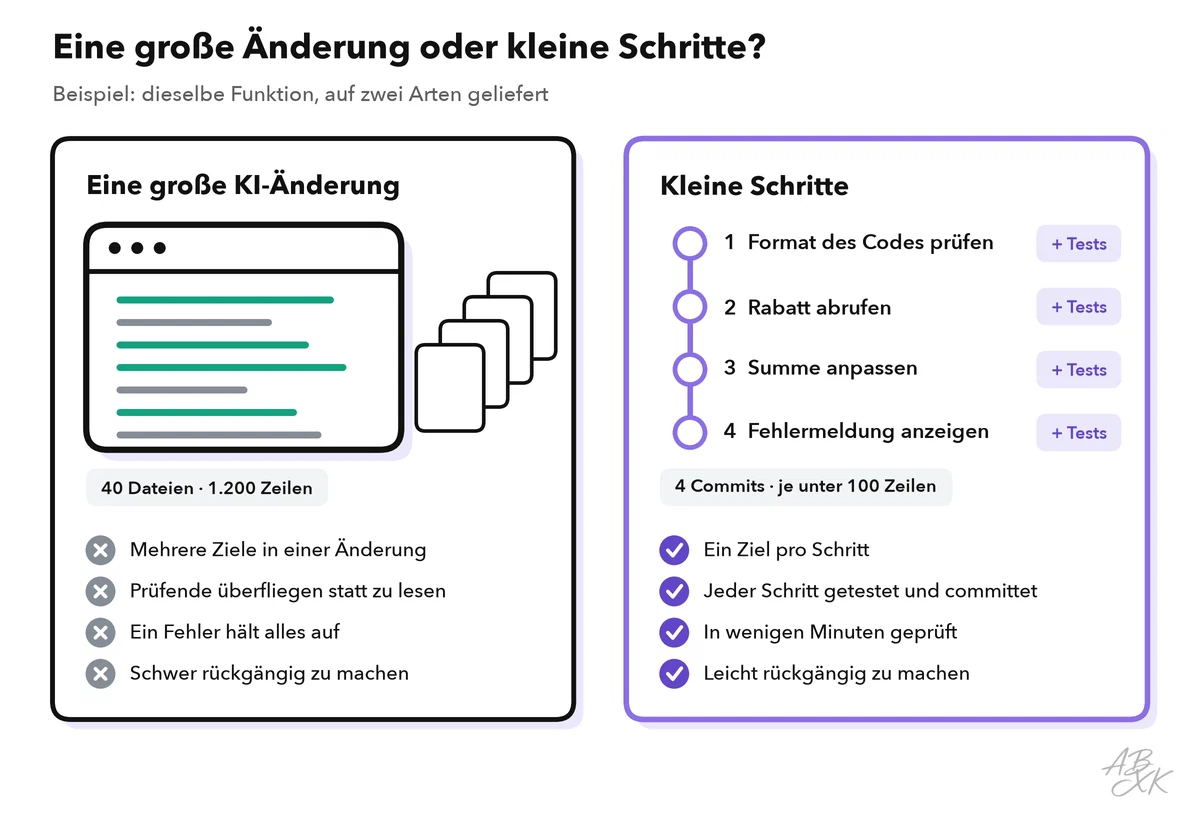
Committen Sie nach jedem funktionierenden Schritt, damit Sie zurückkehren können, wenn der nächste scheitert. Im Terminal kann ein Schritt so aussehen:
git switch -c feature/discount-code    # ein Branch pro Aufgabe
git diff                               # nach jeder KI-Änderung: jede Zeile lesen
make test                              # alle Tests, nicht nur die neuen
git add -p                             # die Änderung Stück für Stück übernehmen
git commit -m "Validate discount codes at checkout (#1234)"
Agenten brauchen Grenzen, denn sie handeln, statt nur vorzuschlagen:
- Lassen Sie sie in einer Sandbox oder einem Container laufen, mit Testdaten und ohne Zugangsdaten für Produktivsysteme.
- Lassen Sie sie nachfragen, bevor sie Befehle ausführen, Pakete installieren oder Code pushen.
- Brechen Sie ab, wenn der Diff Dateien außerhalb des Plans berührt, und lehnen Sie jede Änderung ab, die Tests anpasst, damit sie bestehen.
Prüfen und testen: Menschen und Tools finden Verschiedenes
Lesen Sie den Diff, nicht den Chat. Die Zusammenfassung des Assistenten kann falsch sein. Lassen Sie ihn riskante Stellen erklären und vergleichen Sie die Erklärung mit dem Code. Code für Anmeldungen, Zahlungen, Berechtigungen oder personenbezogene Daten bekommt eine zweite menschliche Prüfung.
Ein Pull Request mit einem großen KI-Diff und ohne Erklärung ist die Programmierfassung dessen, was Forschende Workslop nennen: Ergebnisse, die fertig aussehen, aber die eigentliche Arbeit auf andere abwälzen. BetterUp Labs und das Stanford Social Media Lab zählen Code ohne Kontext zu den typischen Formen (Quelle: BetterUp Labs, 2025). Jeder Pull Request sollte sagen, was sich geändert hat, warum und wie es getestet wurde – geschrieben von der Person, die ihn öffnet.
Dann laufen bei jedem Pull Request automatische Prüfungen. Jede findet eine andere Art von Problem, und keine findet alles:
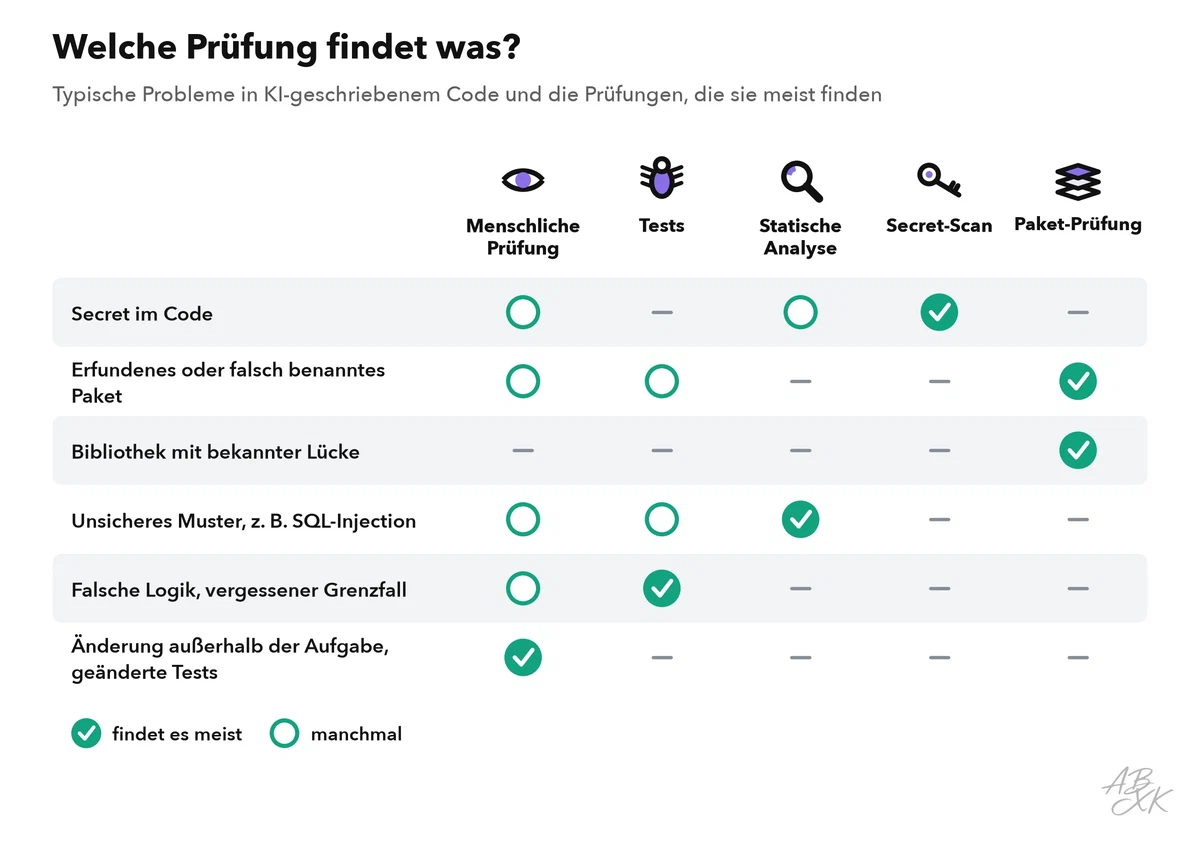
Drei dieser Prüfungen verdienen einen genaueren Blick:
- Secret-Scanning. Ein Scanner sucht nach Schlüsseln, Tokens und Passwörtern, bevor der Code Ihren Rechner verlässt, als Pre-Commit-Hook, und noch einmal in der CI. Viele Code-Hosting-Dienste können außerdem einen Push blockieren, der ein bekanntes Schlüsselformat enthält. Ist ein Secret trotzdem im Commit gelandet, widerrufen Sie es und erzeugen ein neues. Die Zeile zu löschen genügt nicht, denn die alte Version bleibt in der Historie.
- Prüfung der Abhängigkeiten. Prüfen Sie für jedes neue Paket, ob es existiert, ob der Name exakt stimmt und ob es gepflegt wird. Assistenten schlagen manchmal Pakete vor, die nie veröffentlicht wurden, und Angreifer können solche Namen registrieren. Fixieren Sie Versionen in einer Lock-Datei, lassen Sie einen Schwachstellenscanner sie mit Datenbanken bekannter Lücken abgleichen und prüfen Sie die Lizenz.
- Statische Analyse. Diese Tools lesen Code, ohne ihn auszuführen, und finden unsichere Muster, etwa Nutzereingaben, die direkt in eine Datenbankabfrage eingefügt werden. Modelle lernen aus öffentlichem Code, samt seiner Fehler. In einer frühen Studie zu GitHub Copilot enthielten etwa 40 Prozent von 1.689 Programmen, die für 89 sicherheitsrelevante Szenarien entstanden, eine Schwachstelle (Quelle: Pearce et al., „Asleep at the Keyboard?“, IEEE S&P 2022, arxiv.org). Die Modelle sind seither besser geworden, aber diese Prüfungen sind eine günstige Versicherung.
KI-gestützte Tools können einen ersten Prüfdurchgang übernehmen. Laut Anbieter führt TestDriver.ai Pull Requests in einer Desktop-Sandbox aus und meldet Regressionen, bevor eine Änderung gemergt wird. App-Builder wie Emergent und Devs.ai erzeugen ganze Anwendungen aus einer Beschreibung, was die Gates noch wichtiger macht. Wir haben diese Tools nicht getestet.
Kurzbeschreibungen aus unserem Tool-Vergleich, nach Angaben der Anbieter — nicht von ABXK getestet.
Betrifft Ihre Änderung eine KI-Funktion in Ihrem Produkt, gehören zum Test-Gate auch die Evals aus Teil 4.
Committen: klare Nachrichten, aktuelle Doku, geschützter Branch
Der Commit schließt den Kreis. Schreiben Sie eine Nachricht, die sagt, was sich geändert hat und warum, und verlinken Sie das Ticket. Legen Sie Aufgabenbeschreibung und Plan in die Beschreibung des Pull Requests, damit die Prüfenden Absicht und Ergebnis vergleichen können. Wenn Ihr Team es verlangt, vermerken Sie, dass ein Assistent geholfen hat.
Aktualisieren Sie die Dokumentation in derselben Änderung: die README für neue Einrichtungsschritte, das Changelog und Kommentare, die erklären, warum der Code so arbeitet. Assistenten schreiben Dokumentation schnell, aber prüfen Sie sie wie Code. Sie kann Verhalten beschreiben, das es nicht gibt.
Schützen Sie zuletzt den Hauptbranch: Änderungen gelangen nur über einen Pull Request hinein, mit grünen Prüfungen und einer Freigabe. Dann kann weder ein Mensch noch ein Agent die Gates überspringen.
Was Benchmark-Daten über KI-Codeänderungen sagen
Wie zuverlässig ändern Modelle vorhandenen Code? Genau das prüft der Benchmark Aider Polyglot. Wie Ihr Test-Gate gibt er dem Modell einen zweiten Versuch, nachdem es die Testausgabe gesehen hat. Das sind die Spitzenreiter in unseren LLM-Daten:
| # | Modell | Erschienen | Ergebnis |
|---|---|---|---|
| 1 | GPT-5 (high) OpenAI | 07.08.2025 | 88,0 % |
| 2 | o3-pro OpenAI | 10.06.2025 | 84,9 % |
| 3 | Gemini 2.5 Pro Preview (Jun 2025) Google DeepMind | 05.06.2025 | 83,1 % |
| 4 | o3 (high) OpenAI | 16.04.2025 | 81,3 % |
| 5 | Grok 4 xAI | 09.07.2025 | 79,6 % |


225 schwierige Programmieraufgaben in C++, Go, Java, JavaScript, Python und Rust. Misst, ob ein Modell vorhandenen Code korrekt ändern kann — mit einem zweiten Versuch nach Sicht der Testausgabe. Daten: Epoch AI, abgerufen am 17.10.2026, Lizenz CC BY 4.0. Alle Modelle: LLM-Datenbank.
Selbst die besten Ergebnisse lassen einen Teil der Aufgaben ungelöst, obwohl jede Aufgabe klare Tests hat und das Modell einen zweiten Versuch bekommt. Nicht jedes neue Modell wurde mit diesem Benchmark getestet, daher können die neuesten Modelle aus unserer LLM-Datenbank hier fehlen. Ein hoher Wert zeigt Ihnen, welche Modelle einen Versuch wert sind. Der echte Test ist Ihr eigenes Repository mit seinen Regeln und seiner Geschichte. Level 4 erklärt, wie Coding-Benchmarks funktionieren und wo sie in die Irre führen.
Checkliste vor dem Merge von KI-geschriebenem Code
Nutzen Sie diese Liste für jeden Pull Request mit KI-geschriebenem Code. Sie geht weiter als die schnellen Prüfungen aus Level 0:
| Bereich | Prüfung |
|---|---|
| Umfang | Berührt der Diff nur die Dateien, die der Plan nennt? |
| Tests | Decken neue Tests die Abnahmekriterien ab? Wurden bestehende Tests geändert oder gelöscht, und warum? |
| Korrektheit | Sind leere, fehlende und extreme Werte abgedeckt? Führen Fehler zu klaren Meldungen? |
| Sicherheit | Werden alle Eingaben geprüft, Datenbankabfragen parametrisiert und Berechtigungen kontrolliert? |
| Secrets | Ist die Änderung frei von Schlüsseln, Tokens und Passwörtern, in Code, Konfiguration, Tests und Logs? |
| Abhängigkeiten | Existiert jedes neue Paket, mit dem beabsichtigten Namen, fixierter Version und erlaubter Lizenz? |
| Personenbezogene Daten | Landen keine personenbezogenen Daten in Logs, Testdaten oder Prompts? |
| Dokumentation | Sind README, Changelog und Kommentare aktuell? |
| Rückgängig machen | Lässt sich die Änderung für sich zurücknehmen, ohne andere Änderungen zu brechen? |
| Verständnis | Können Sie jede Zeile einer Kollegin erklären? |